ARTICLE · 1322644
排版插件开发手记1:导入公众号后排版不对,我踩了 3 个坑:从立项到真机验收,11 个版本里每一个被真机打回来的问题
一 · 起因:一份 HTML,进不了公众号
我写公众号,习惯先在 Markdown 里写完,再往编辑器里搬。
搬的过程一直是痛的。标题层级、行距、引用块、代码块的高亮配色、图片圆角,在 Markdown 里是一套,粘进公众号是另一套。复制过去,h2 变成一段加粗的字,blockquote 变成左边一条灰线,代码块的语法高亮整个消失。
试过三种办法。
第一种,手动调。一篇三千字的稿子,调格式要四十分钟。第二次改稿,全白费。
第二种,用第三方排版工具。先粘进去、选模板、再复制出来。中间多一道,模板是它的,不是我的。
第三种,装插件。网友说市面上确实有插件能把 HTML 直接导进公众号,效果也不错——但这项功能收费。
我不是不愿意付费。我是不甘心:这件事的技术难度,真的值一个订阅价吗。
于是我做了一件很工程师的事:把一个成熟插件拆开看。
二 · 需求:我要的不是「能粘」,是「粘完一样」
拆之前先把需求写清楚,否则很容易做成「功能有了,但不好用」。
四条。
第一,保真。 导入后的排版要和原文件一致。不是差不多,是字号、行高、字色、字体、间距逐项对得上。
第二,本地。 文章不上传任何服务器。公众号后台的接口已经够多了,我不想再经一手。
第三,快。 一次导入在两秒内完成。几千字的稿子不该等。
第四,出问题能说清。 这条是后来加的,也是最重要的——如果排版不对,我要知道是哪一步不对,而不是「反正就是不对」。
现在回头看,第四条才是这个项目真正的难点。前三条是功能,第四条是可用性。而大多数工具死在第四条上:它们能跑,但你不知道它跑成了什么。
三 · 拆包:先看清它到底怎么做的
crx 是 zip 套了一层头。这里有个坑:偏移 8 到 12 那四个字节是 header 长度,不是签名长度。我第一次按签名长度跳,跳进了压缩数据中间,解出来一堆乱码。
那个 crx 约 17 MB。解开之后是约 2300 个文件、约 41 MB。最大的几段脚本分别是主编辑逻辑约 8 MB、侧栏面板约 2 MB、内容注入约 2 MB。全部是 esbuild / webpack 的产物,没有一个 .map。
读它的排版实现,读出一个让我意外的结论:它根本不做样式内联。
它信任用户给的 inline style。用户从别处复制来的 HTML,如果每个元素都带着 style="",它就原样送进编辑器;如果样式写在 <style> 块里,它不做合并,直接当脏标签删掉。
这解释了一件事:为什么很多人用这类插件,从某些网页复制的内容排版很好,从另一些复制就一塌糊涂。差别不在插件,在源文件有没有 inline style。
还有一处:它的 matches 里写着 *://*/*。意思是打开任何网页,都会加载那个约 8 MB 的主包。这是「采集任意文章」的代价,也是它常被吐槽「卡」的原因。
我要的东西不一样。给我一份带 <style> 的完整 HTML,我自己算。
四 · 第一个坑:我以为在算样式,其实在读浏览器默认值
最直觉的做法是:把正文塞进一个隐藏的 iframe,逐元素读 getComputedStyle。浏览器帮我算,我只需要抄。
这条路会成功,日志也会全绿。它只是把「浏览器默认值」当成了这份文件的样式。
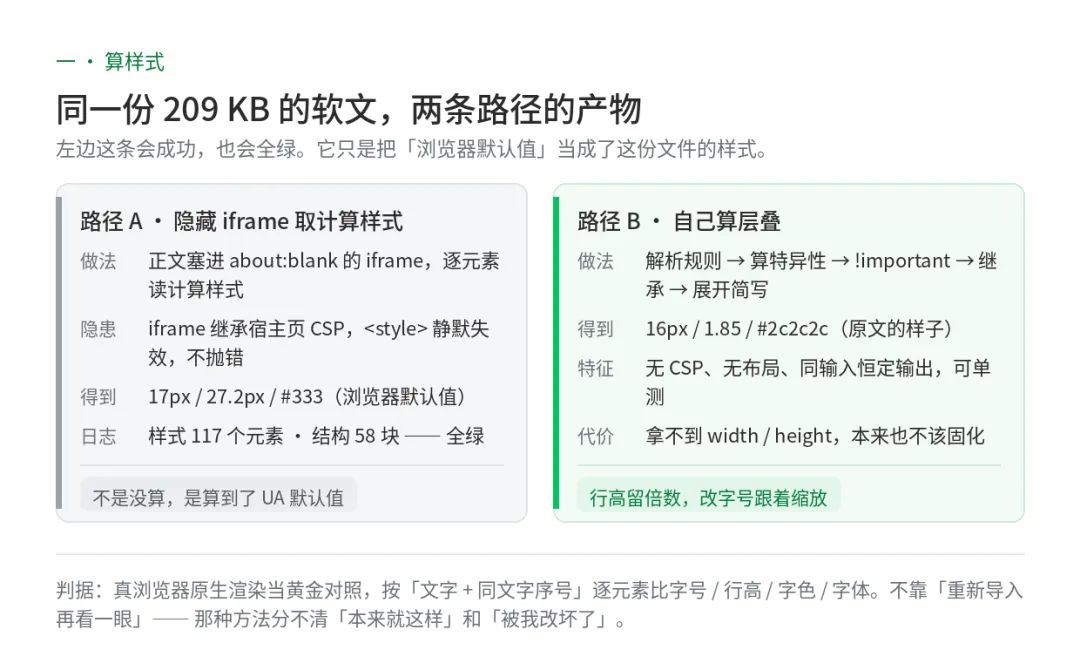
根因很隐蔽:about:blank 的 iframe 继承宿主页面的 CSP。公众号编辑页的 style-src 不放行内联样式,于是我在 iframe 里写的 <style> 静默失效——不抛错、不报警,getComputedStyle 老老实实返回 UA 默认值。
产物是 17px / 27.2px / #333。每一项都「有值」,每一项都不是原文的值。
这是「导入后排版不对」里最难查的一类:产物结构完好、日志全绿、字数正确,唯一的问题是每个数字都是浏览器给的默认值。
我发现它的方式是对照实验。同一份文件,有布局时输出 line-height:28.8px;把 <style> 去掉,只剩 margin:14px 0。两条路径跑一遍,症状能复现,才算找到根因。
换成自己算层叠:解析样式表 → 算选择器特异性 → 处理强制优先级声明 → 沿树继承 → 展开简写属性。四步,全部是确定性计算。
代价是拿不到 width / height,因为不做布局。但公众号本来也不该固化宽高——手机上宽度是变的,写死 px 只会顶出容器。
好处是全部:没有 CSP 依赖、没有布局开销、同一输入恒定输出、可以在 node 里单测。
这一步之后,样式才第一次真的算对了。
但更早还有一课,我差点漏掉:可继承属性不能「与父级相同就省」。
我最初的策略是:一个元素的 line-height 和父级一样,就不写。听起来合理,还能省体积。
错误在于:省略的前提是「父级的基线也进了产物」。公众号编辑器只认 inline style,我搬过去的子树挂在陌生的父级下——原文 body { line-height: 1.85 } 不会跟着走。只要当初按「与父级相同」省掉了,整篇就落到目标编辑器默认的 17px / 1.6。
症状同样是:导入后和原文件不一样,但不报错、结构完好。
修法是:顶层子元素无条件写基线(字体、字号、行高、字色、字重),子孙才相对父级去重。代价实测只有 8 KB,而那份文档有 1.48 MB。
行高还有一处讲究:保留倍数 1.85,不算成 px。改字号时跟着缩放。钉死 px 在手机端、在读者调字号时必错位。
五 · 第二个坑:算对了,送不进去
样式内联做完,我拿真浏览器做了黄金对照:57 个块级元素的字号、行高、字色、字体全部一致,零差异。
我以为成了。
装上去,导入,排版还是不对。
回去读它的写入路径,才明白我缺的不是「算样式」,是「送进去的方式」。
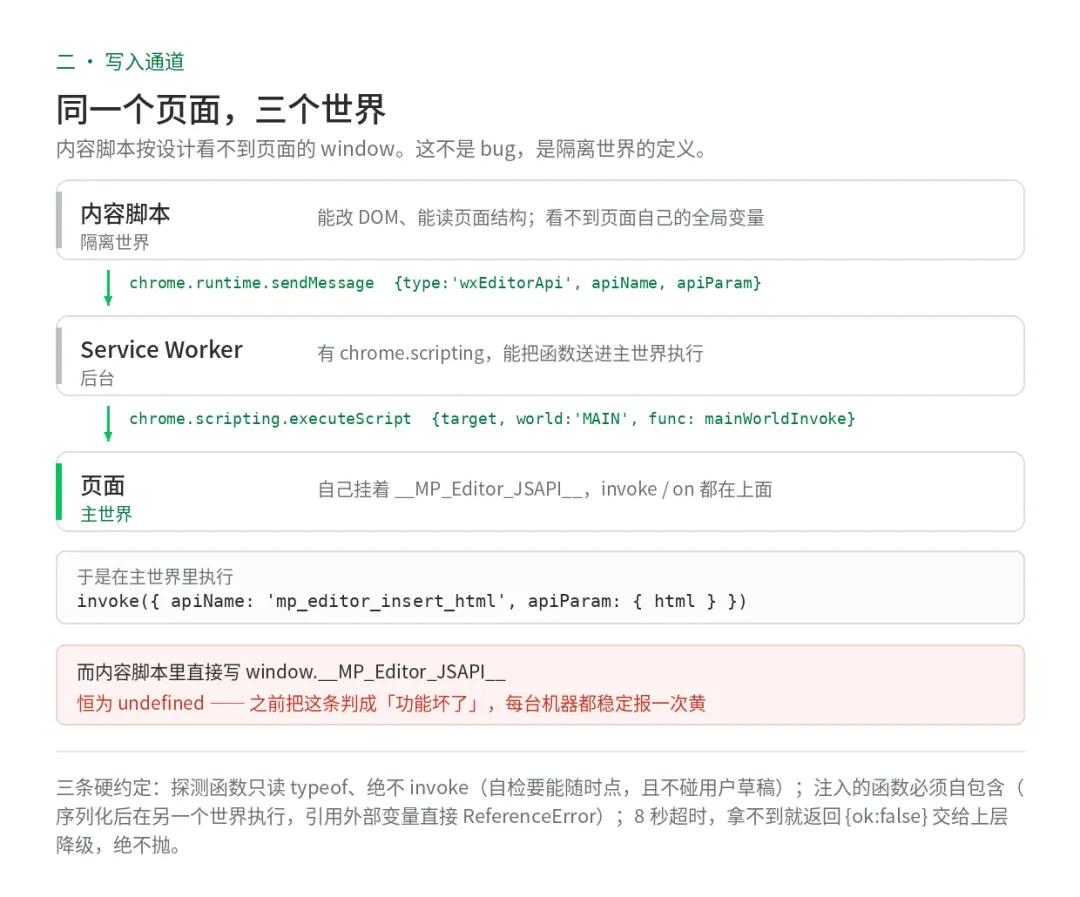
公众号编辑页的 DOM 在我的内容脚本眼里可读可写。但页面自己挂在 window 上的东西——比如 __MP_Editor_JSAPI__——我看不到。
内容脚本跑在 Chrome 的隔离世界。这是设计,不是 bug。它和页面共享 DOM,但不共享 JS 全局。
所以我在内容脚本里写 window.__MP_Editor_JSAPI__,永远是 undefined。
这一点我最初判错了。自检里有一项「编辑器写入口」,我在隔离世界里读这个变量,读不到就报警告。结果每一台机器、每一个页面上,这一项都稳定地黄。
用户看到的是「一台永远少一项的机器」。很快他就会把整份报告当背景噪音。
假红比不报更糟。这是整个项目里最重要的一条教训。
修法:站到主世界里去问。经后台 chrome.scripting.executeScript({ world: 'MAIN' }) 注入一个只读探测函数,只读 typeof,绝不 invoke。
三条硬约定,写在代码注释里:
探测函数只读 typeof,绝不调用。自检要能随时点,且不能碰用户草稿。注入的函数必须自包含。它被序列化后在另一个世界执行,引用任何外部变量都直接 ReferenceError。8 秒超时,拿不到就返回 { ok: false }交给上层降级,绝不抛。
知道了主世界能读接口,第二个问题就来了:怎么用这个接口写。
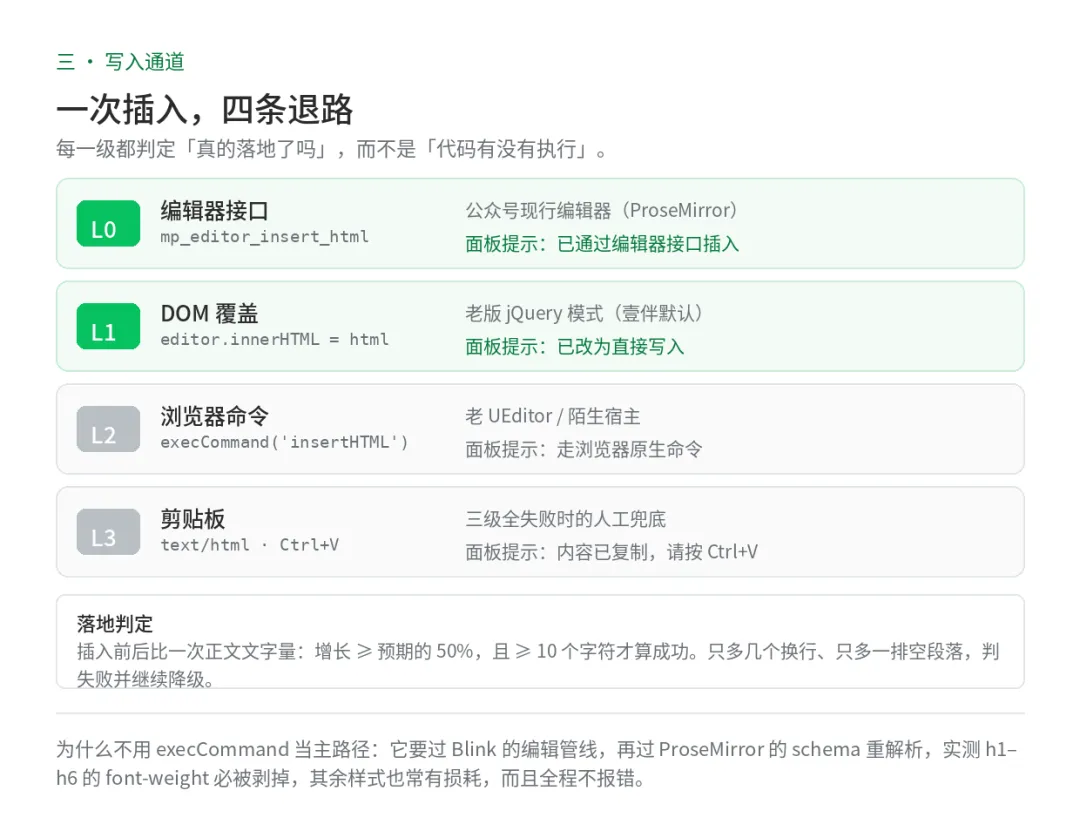
四级。
L0,编辑器接口。__MP_Editor_JSAPI__.invoke('mp_editor_insert_html', { html })。这是编辑器给自己的正规入口,它自己解析、自己建节点。
L1,DOM 覆盖。 老版 jQuery 模式下的 $(body).html()。
L2,浏览器命令。execCommand('insertHTML'),给老 UEditor 和陌生宿主。
L3,剪贴板。 三级全失败时,把内容塞进剪贴板,提示用户 Ctrl+V。
为什么 execCommand 不能当主路径。因为它要过 Blink 的编辑管线,再过 ProseMirror 的 schema 重解析。两层,每一层都可能改你的东西。实测:h1 到 h6 的 font-weight 必被剥掉,700 / bold / 800 都剥,p 不剥。而且全程不报错。
还有个细节:插入前要跑四步规整。
给每个文本节点套 <span leaf="">。这是编辑器自己产出正文的标准结构。清掉表格里的 <colgroup>。吃掉标签之间的空白文本节点。 给图片加背景占位。
不套 span[leaf],段落样式在重解析时更容易被丢。这四步是读它的实现学来的。
写进去了,还要判「真的落地了吗」。
代码执行成功不等于内容进去了。我的判据是:插入前后比一次正文文字量,增长不少于预期的 50%,且不少于 10 个字符,才算成功。只多几个换行、只多一排空段落,判失败,继续降级。
六 · 第三个坑:功能在跑,但没人知道它在跑什么
到这里功能已经能用。真机测试,1.1.6 版,用户两端截图对比,排版保住了。
然后用户来问:自检里那项黄色提示是什么意思。
我查了,是假红,就是上面说的隔离世界问题。修完,1.1.7。
用户又问:权限声明里那行黄字,是你们设计预留的吗。
再查,还是假红——这次是 CSS。panel.css 里 .gzh-diag li em 无条件用了警告色,不看这一项的等级。于是 ok 项的解释文字也显黄。13 项全绿的报告里冒出一行黄的,用户自然读成「这里有隐患」。
1.1.8。
用户第三次来的时候,说了一句话,把我点醒了:「这几轮我们一直在死磕 HTML 导入,主要是这项功能实用,而且市面有的插件此功能是收费的。」
我回头数了一遍:1.1.3 显示旧版本、1.1.5 样式丢、1.1.6 送不进去、1.1.7 假黄、1.1.8 假黄。
每一次都是「用户截图 → 我猜 → 复现」。
缺的从来不是功能,是「出问题时说不清哪一步不对」。
所以 1.1.9 我没加功能,加了取证能力:一次导入之后,能复制一份日志。
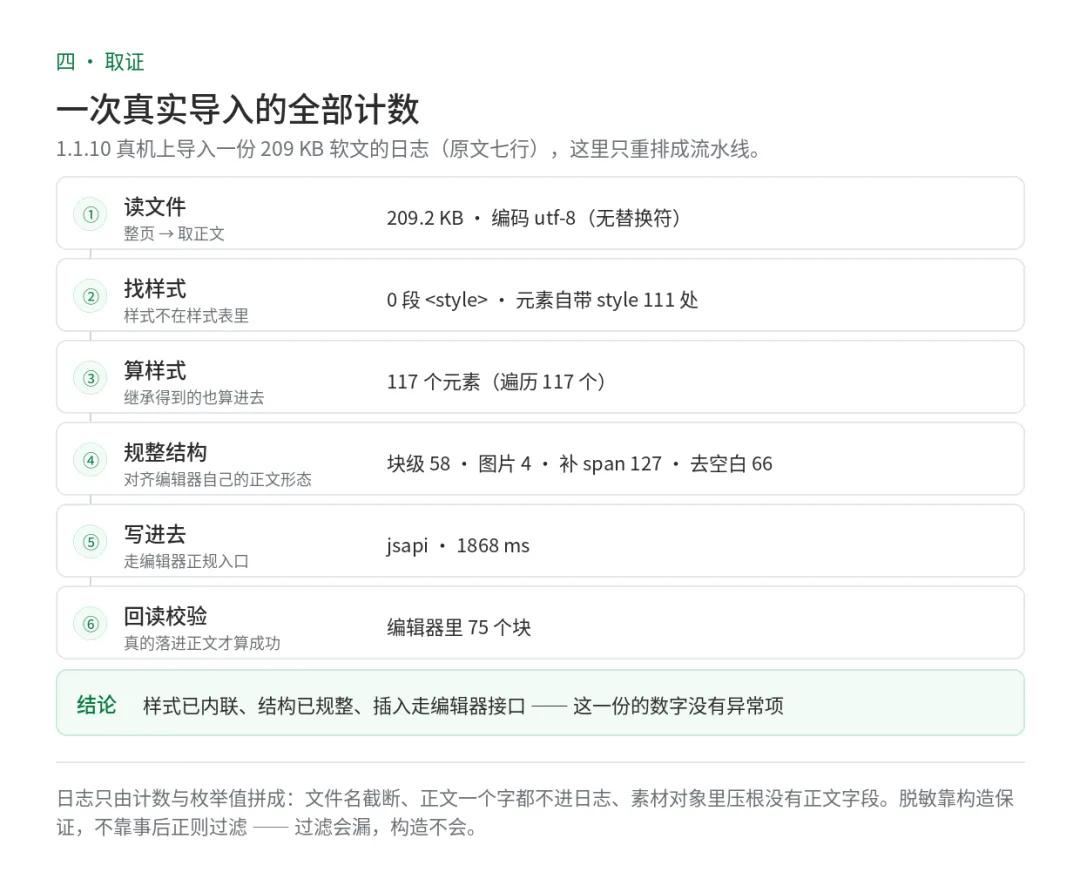
图 4 是用户真机上导出的第一份日志,我按流水线重排了。
七行。版本、时间、文件、样式、结构、插入、结论。
关键是脱敏:只拼计数与枚举值。文件名截断、换行压平,正文一个字都不进日志。不是靠事后正则过滤——过滤会漏,构造不会。素材对象里压根没有正文字段。
结论行由计数推出,判定顺序是「最早出错的那一步先说」:样式没进,说结构和插入都没意义。
这份日志一贴,我就能定位到哪一步。不用再「截图 → 猜 → 复现」。
然后这份日志立刻暴露了我三个缺陷。
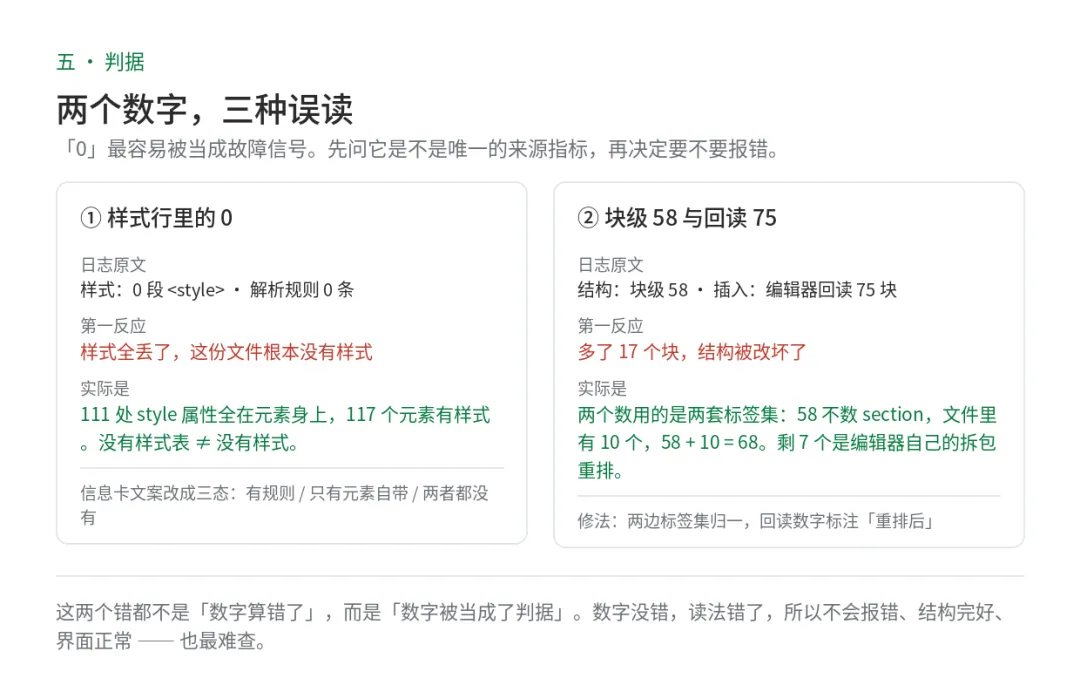
第一个:信息卡写着「已内联 0 条样式规则」。
用户那份文件,<style> 是 0 段。但 style 属性有 111 处,117 个元素有样式。
样式有两个来源:样式表规则,和元素自己的 style 属性。我只数了前者,然后把 0 当成了「没有样式」。
数字没错,错的是它被当成了判据。
修法是:样式计算里增加「元素自带样式」计数,文案改三态。有规则说规则;没规则但有自带样式,就说「样式全在元素自身上(111 个元素),没有样式表需要合并」;两者都没有,才报「没找到样式」。
第二个:「块级 58」和「回读 75 块」。
看着像「多了 17 个块,结构被改坏了」。
实际是两个数用了两套标签集。58 那个不数 section,而文件里有 10 个;58 加 10 等于 68。剩下 7 个是 ProseMirror 自己的拆包重排,属正常。
修法:两边标签集归一,回读的数字标注「重排后」。
第三个:验收判据把对的判成错的。
验收文档里写着「信息卡显示 N 大于 0 才算通过」。按这条判据,用户这份完全正确的文件会被判不合格。
这是最危险的一种错。判据错比功能错更麻烦:功能错你能看见,判据错会让正确的东西被当成坏的,然后你去「修」一个没坏的东西。
七 · 11 个版本,每个只修一件事
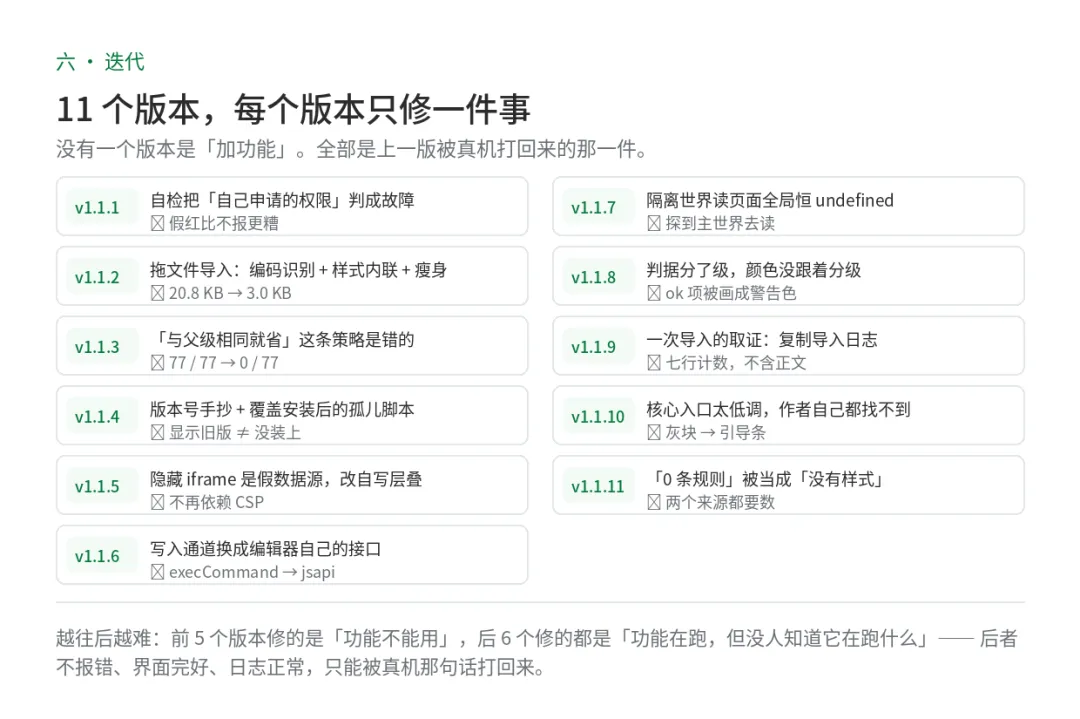
图 6 是全部 11 个版本。没有一个是「加功能」。
前 5 个修的是「功能不能用」。后 6 个修的都是「功能在跑,但没人知道它在跑什么」。
后者不报错、界面完好、日志正常,只能被真机那句话打回来。
最典型的是 1.1.10。
那一版我只改了三行 CSS 和一个字符串。起因是用户问:「导入日志按钮在哪个位置。」
功能没坏。按钮就在那儿,事件分支也在。问题是它长什么样:11px、白底、灰字、挂在一条虚线下面。
而我当初在 CSS 里给自己写的理由是「它是个诊断入口,不该和信息卡正文抢注意力」。
这句话在交付当天就被证伪了。核心卖点的取证入口,连作者本人都找不到。
一个没人会用的功能,等于没有。
改成引导条:浅蓝底、描边、品牌色文字,文案从「不含正文,出问题时贴给开发者」改成「排版不对?点它复制日志(不含正文)」。
抽象说法换成用户真实会遇上的那一刻。
这一版之后,用户第一次真的复制出了日志,也就是图 4 那份。
也是这次之后,我才意识到一件事:前面那些「修 bug」的版本,修的都是逻辑;后面这些版本修的,是「能不能被发现」。 后者的难度不在代码,在于你得承认自己当初的设计理由是错的。
八 · 现在它是什么样
功能面:4 套主题、20 种语言高亮、二维码生成、图片直传、Markdown / Word / HTML 三种导入。
验证面:纯逻辑单测 276 项;静态闸门逐条做了负向验证(把代码故意改坏,确认判据会报红);二维码用真实 OpenCV 解码回读 12 条全过;运行包 34 个文件与源码逐字节比对一致。
真机上,自检 13 项全绿:扩展上下文、权限声明、页面环境、正文编辑器、插入通道、顶部工具条、面板样式、模块完整性、图片直传、后台服务、本地存储、功能用例、编辑器写入口。
必须说清的边界。
浏览器端到端测试在这一轮没跑起来。容器可用内存只有 1.6 GB,测试框架在模块加载阶段就因为 WebAssembly 申请不到连续内存崩了。所以新文案、新引导条在真实 DOM 里的观感,我是靠静态断言守的,不是靠眼睛看的。
真机报告补上了这一块——但那是我发出去之后用户测的,不是我测的。
这条边界我写进了交付文档,没有宣称「全部验证通过」。承认没验过,比含糊地说验过,可信得多。
最后
回到开头那个问题:这件事的技术难度,值一个订阅价吗。
现在我有答案了。
难的不是「把 HTML 塞进编辑器」。那件事有现成接口。
难的是:编辑器返回成功,你的排版却是错的,而它不会告诉你为什么。
execCommand 返回 true,invoke 不抛异常,插入后的字数也涨了。每一步都「成功」。错的是样式,一个字节一个字节地被剥掉。
要发现它,你得先有一把尺子——一份不依赖浏览器的、能逐元素比对的黄金对照。
要定位它,你得有一份取证——一次导入的计数快照,能指着某一步说「这里不对」。
要防止它复发,你得有闸门——静态断言加负向验证,让「改回去」这件事立刻报红。
这三样东西,比功能本身更值钱。
排版不该靠玄学。