ARTICLE · 1324644
IO调度源码合并和业务抢IO怎么办?我把 IO 调度器的源码翻出来对了一遍账
落笔相逢,我是军哥!
做 OB 的朋友几乎都遇到过这个场景。每天到了合并窗口,业务开始抖,TPS 往下掉,延迟往上窜。最常见的应对是把合并挪到凌晨,眼不见为净。
挪窗口是回避问题。合并抢的到底是什么资源,抢的过程里谁说了算,能不能让它们各让一步?我带着这个问题把 src/share/io/io_schedule 的代码翻了一遍,发现事情比"挪窗口"有意思得多。
IO 调度器,一个带配额的收费站
OB 的 IO 调度实现在 src/share/io/io_schedule。这个目录下两个文件值得认,ob_io_schedule_v2.cpp 是调度器本体,ob_io_mclock.cpp 是调度算法。
mclock 这个名字有来历,它来自一个经典的 IO 调度算法家族,思想跟 Linux 的 CFQ 有血缘,都是按类别分配 IO 带宽,兼顾公平和优先级。mclock 的核心是三组标签,reservation(保底,这个类别至少分多少)、limit(上限,最多分多少)、proportion(比例,剩余带宽怎么摊)。理解这三组标签,IO 隔离的全部行为都能推出来。业务类别的 reservation 高,保证它饿不死。后台类别的 limit 低,保证它吃不多。剩下的带宽按 proportion 摊,谁权重大谁多分。
读这套代码抓三个概念。
IO 分类。不同来源的 IO 请求被贴上类别标签。业务的读取、合并的写盘、备份的传输,各有各的标签。分类是调度的前提,没有标签就没有区别对待。
配额和权重。每个类别有自己的配额,机器的总 IO 能力按权重分配给各类别。业务类别权重天然高,合并这种后台任务拿的是剩余带宽。
限速执行。调度器按配额放行请求,超额的排队。所以合并再猛,也只能在自己的配额里折腾,理论上不会把业务的 IO 抢光。
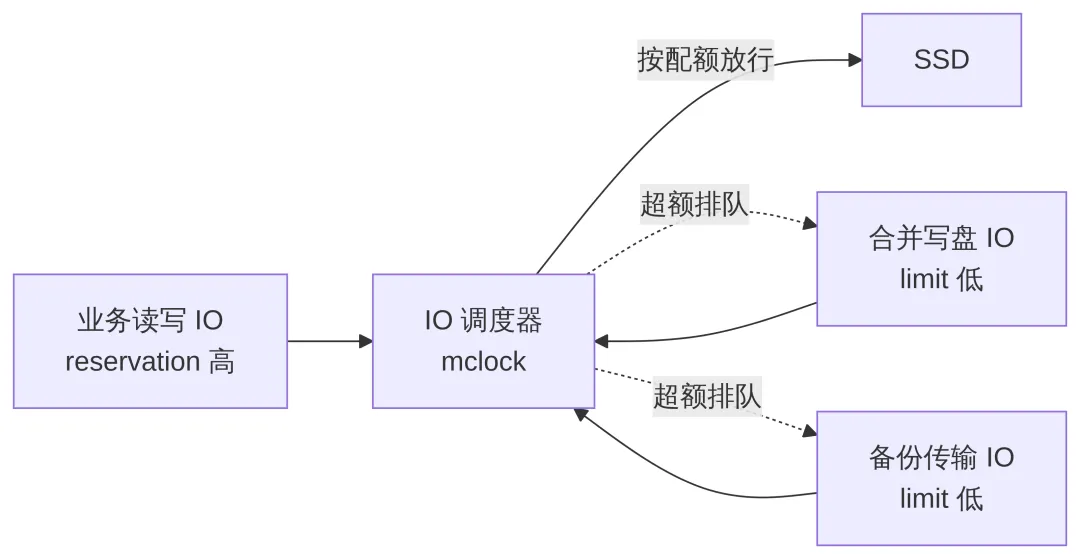
有个前置问题值得知道,调度器怎么知道机器的 IO 能力?OB 有 IO 校准机制,ob_io_benchmark 相关参数控制,校准测出盘的实际读写能力,配额的计算才有基准。换盘或者换机型之后,校准要重新跑,不然配额按旧能力算,调度就失真。
调了权重为什么还抖
注意我说了理论上。实际抖动还有别的来源,这也是很多人调了 IO 参数发现改善有限的原因。抖动是个多因素问题,得拆开看。
CPU 成分。合并是计算密集活,压缩、编码、归并排序都吃 CPU。IO 调度管不住 CPU。合并期间 CPU 上去,业务线程能分到的核就少了。第 11 篇的线程配额能保底,但共享核的干扰还在。
缓存冷启动成分。合并产出全新的 SSTable,新宏块没进 block cache。合并刚结束那段时间,查询要重新从磁盘读数据预热缓存,命中率掉一截,延迟自然涨。这个抖动跟 IO 调度无关,是缓存的冷启动。第 14 篇讲读路径时说过缓存链服务 SSTable 读取,链路还是那条链路,只是缓存里换了新货。
写放大成分。合并本身写量大,SSD 的写带宽被占用,业务写的延迟也受牵连。IO 调度能管一部分,但盘的物理极限在那。
所以合并抖动的完整配方是,IO 争抢加 CPU 争抢加缓存冷启动。IO 权重只是其中一张牌,指望它包治百病,就是开篇那种"调了没用"的困惑。
调优三件套和它的顺序
基于机制,合并期抖动的调优三个抓手。
第一,压合并的并发和速度。合并线程数、写盘速度都有参数控制。调低它们,合并变温柔,代价是合并窗口拉长。合并时长和抖动程度是个跷跷板,看你保哪头。
第二,调 IO 权重。提高业务类别权重,压低合并类别。实时生效,可以先试再定。
第三,错峰。最后手段。业务有明显低谷就把合并窗口定进去。
我的实战顺序是,先量化抖动到底来自哪,IO、CPU 还是缓存预热,再决定用哪张牌。上来就挪窗口,等于放弃了调优的机会,而且挪窗口只解决"抖动别撞高峰",抖动的总量一点没少。
缓存冷启动那一波,单独说一下
三成分里缓存冷启动最隐蔽,因为它发生在合并结束之后。合并跑完了,你以为没事了,结果业务开始慢,慢个几分钟又自己好了。
成因是合并产出的新 SSTable 是全新的宏块,旧宏块在 block cache 里的缓存全部作废,查询读新块要从磁盘重新加载。这个预热期就是合并后的那波慢。观测方法也简单,合并结束后盯 audit 里的 block_cache_hit 字段,命中率掉下来又慢慢爬回去,就是冷启动在完成。
缓解手段有限但存在。热点表的预热可以主动做,合并结束后跑一遍热点查询把缓存热起来。更根本的是接受它,把冷启动的抖动幅度量出来,写进合并窗口的设计依据里。
相关参数的一张速查表
IO 调优涉及的参数散在各处,这里收拢一张表,用的时候不用翻文档。
每个参数的具体名字按版本文档核对,4.2 和 4.3 的参数命名有变化,别背名字,记方向。
实验,把抖动拆成三个成分
测试集群上,sysbench 恒定压力压业务租户,记录 TPS 和延迟基线。然后手动触发合并:
alter system major freeze;-- 盯进度select * from oceanbase.DBA_OB_MAJOR_COMPACTION;合并期间同时采集三样东西。TPS 和延迟曲线(业务侧),iostat 的磁盘 util 和吞吐(IO 成分),top 的 CPU 分布(CPU 成分)。合并结束后继续盯五分钟,看缓存命中率的变化(冷启动成分),命中率在 audit 里有现成字段:
select avg(block_cache_hit + index_block_read_cnt) as cache_warmth, avg(elapsed_time) as avg_rtfrom oceanbase.GV$OB_SQL_AUDITwhere request_time > 合并结束时间group by floor(request_time/60000000) -- 按分钟聚合order by 1;然后调低合并并发参数再来一轮,调 IO 权重再来一轮。三条曲线摆在一起,哪个参数管多大用、哪个成分还剩多少,一目了然。
这套实验的产出是一张抖动成分分解图。放进报告里,比"我们把合并挪凌晨了"专业得多,也给"能不能白天合并"这个问题提供了数据支撑。
面试怎么答,生产怎么查
面试被问"合并期间业务抖动怎么优化",先给三件套,然后主动补一句,IO 调度管不住 CPU 和缓存命中率,所以调完参数要验证抖动消了几成。追问"为什么合并刚结束时还有一波慢",答缓存冷启动。能聊到 mclock 的三组标签,这个回答就有源码味了。
生产上遇到合并期抖动,先用监控把抖动拆成 IO、CPU、缓存三个成分,哪个大先治哪个。合并时长和抖动程度的取舍要摆给业务看,让他们选,别替他们选。
留给你的三个思考题
面试官问"为什么调了 IO 权重合并抖动还在",你能从 CPU、缓存冷启动、SSD 物理极限三个层面答吗?追问"怎么量化这三个成分的占比",你会用哪些工具和指标? 7x24 没有明显低谷的业务,错峰打不了。合并调优的思路怎么变?想想能不能让合并更平滑地摊到全天,这个方向的代价是什么? IO 校准失真会发生什么?比如换了更快的盘但没重新校准,配额按旧能力算,业务和合并各自会受到什么影响?
干货已送达,点赞是签收,转发是好评,留言是售后!
关于我:郭一军 | 云贝教育创始人 | 25 年数据库老兵,长期为银行、证券等金融机构授课,专注信创数据库人才培养。
推荐阅读.从OBCE到源码
一、基础篇
更多精彩,关注我公众号,一起学习、成长