ARTICLE · 1326236
浅谈AI Coding 助力软件系统项目开发效率提升
一、能力边界持续外移,评审队列的输入量随之增加
过去两年,AI Coding 的能力边界持续向外扩展。它从单行代码补全起步,随后覆盖整个函数生成,目前已经能够自主修改代码仓库、执行测试并提交 PR。生产端的自动化程度越高,进入评审队列的代码量就越大。
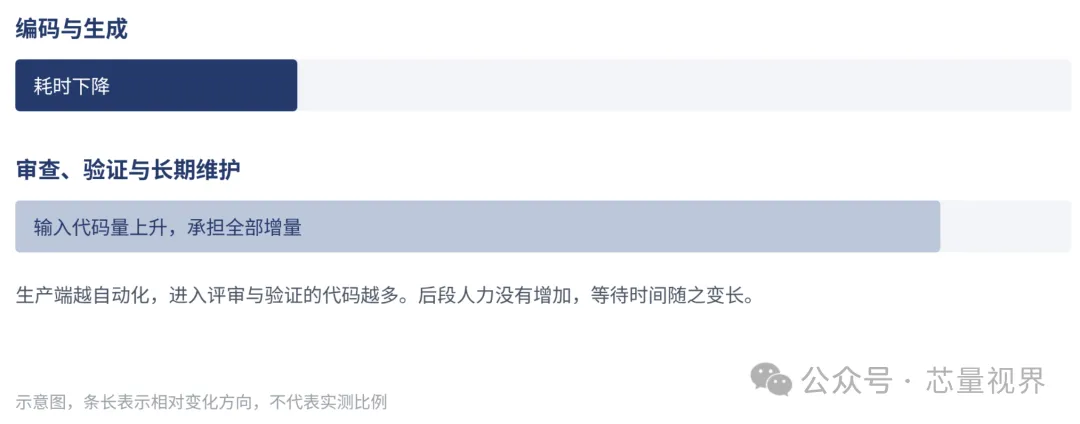
代码生产速度提高之后,审查与验证环节接收的代码量同步放大,而这两个环节的人力投入没有增加。增量压力全部由后段环节承担。
二、生成代码带来三类审查负担
第一类是逻辑与上下文偏差。生成结果在局部看似正确,放入项目的调用链与状态机之后未必成立。
第二类是不遵循项目规范。模型并不掌握命名规则、分层约定、异常处理方式与日志格式,也不会主动询问这些约束。
第三类是安全漏洞遗漏。生成代码优先给出可运行的实现,它对权限校验、输入过滤与依赖版本这三类约束不敏感。
这三类问题都需要人工判断,并且判断者必须掌握项目上下文。审查工作量增加之后,审查质量反而容易下降:单次提交的代码体积变大,审查者容易放过看起来规整的代码。
三、开源社区的人审人改规则出现前提动摇
开源项目长期依靠维护者逐行审阅提交内容,这套规则建立在两个前提之上:项目收到的提交量保持可控,提交者理解自己交付的代码。
AI 生成代码普及之后,这两个前提都发生了变化。提交量大幅增加,维护者投入每条提交的精力被稀释;提交者可能并不了解生成结果的实现细节,回复评审意见时缺少依据。
部分社区已经开始调整流程,方向是把验证分成两层:工具先完成静态缺陷检测与风格规范校验,人工只处理架构逻辑与关键安全问题。社区同时制定 AI 生成内容的标注规则,维护者据此区分贡献来源,并决定审查需要深入到什么程度。
四、衡量价值的指标需要从生产端换到全流程
编码时间节省与任务完成量这两个指标,反映的是代码顺利产出的短期视角。使用它们度量 AI Coding 时,数值必然上升,结论也必然乐观。
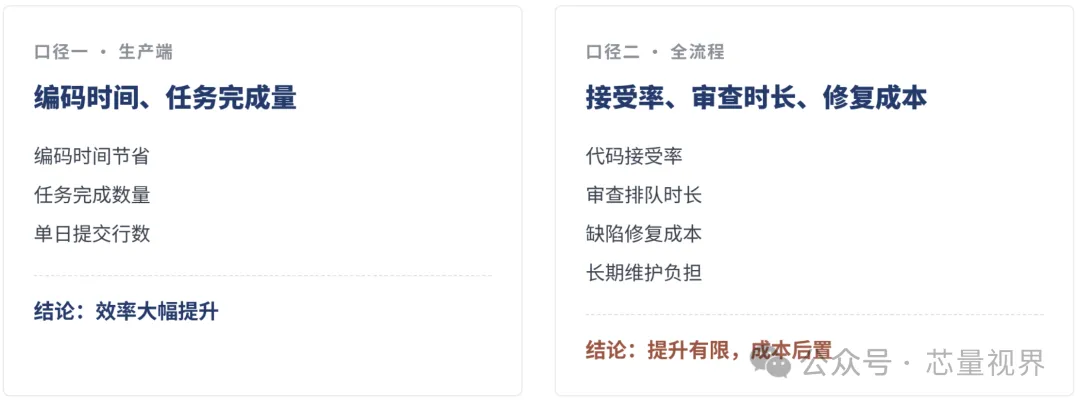
更接近真实价值的四项指标是代码接受率、审查时长、缺陷修复成本与长期维护负担。
· 代码接受率反映生成代码的质量,接受率偏低说明无效代码占比偏高,整理这批代码的成本由社区或使用团队承担。
· 审查时长决定关键路径的长短,审查时长不缩短,生产端获得的加速会被评审排队的时间抵消。
· 缺陷修复成本与长期维护负担属于隐性的技术债务,它们通常在项目后期集中暴露。
使用前一组指标得出的结论是效率大幅提升,使用后一组指标得出的结论是效率提升有限、成本后置。
五、治理规则需要与工具能力同步迭代
治理规则如果固定不变,会与 AI Coding 的能力脱节。
当工具能够稳定产出符合规范的代码时,人工审查的粒度可以适当放宽;当出现新的漏洞模式时,检测规则需要及时补充。治理规则与工具能力保持同步,效率与质量才能同时改善。
对使用方而言,可以从三项动作起步:把生成代码按风险分层,核心链路继续执行严格评审;把评审前置到接口定义与数据流,语法问题交给工具处理;把度量口径换成代码接受率、审查时长与缺陷逃逸率。
结论
AI Coding 改变的是代码生产的速度,软件工程的效率由最慢的环节决定。审查、验证与长期维护这三段的成本不下降,生产端获得的加速将转化为更长的等待队列。当前的投入重点应该放在后段的分层验证、标注规则与指标切换上。
如果您在海光CPU和DCU平台开发或上线应用有技术支持需求,请前往光合开发者社区(扫描下方二维码),畅享开发文档、问题求助及技术支持服务!
诚邀加入光合开发者社区,获取最新资讯和技术支持!