ARTICLE · 1356093
DeepSeek 把自家 App 拆成了 API,还附了一张价目表
DeepSeek 把 App 背后那套能力拆进了原有 API。开发者在原有接口里打开对应参数,联网搜索、文件输入、阅读链接、安全校验就能跟着模型一起工作,工具调用和上下文拼接由服务端跑完。官方公告里那句「开发者甚至能 1:1 复刻出完整的 DeepSeek App」,被转得到处都是。这句话听着像在送一个产品,实际交付的是一组可计费的标准件。这轮改动落在账单结构上,模型本身没换。
五个能力进了三个接口。 承载模型是 deepseek-flash,也就是 V4.1-Flash,支持 Messages、Responses 与 Chat Completions 三种接口格式。第一项是联网搜索,非思考模式下打开 deepseek_web_search,模型按提问自动发起网页或图片搜索,回答附引用。第二项是深度思考搜索,思考模式下开同一个工具,模型可以在多步推理里自己决定什么时候搜、读哪个链接,边想边查。同一个开关,两种行为,文档把它们分开列,成本结构也跟着不同。第三项文件输入,PDF、Office、图片都能传,服务端做完纯文本提取或图文混排解析,再拼进对话上下文。第四项阅读链接,打开 deepseek_read_url 后,模型自动认出用户消息里的网址,抓回页面结合上下文作答。第五项是模型安全,开启校验参数后,服务端对输入输出做基础风控,命中风险返回拒答标识。
省掉的主要是编排那一层。 过去要做一个带完整交互的对话应用,接完模型 API 只算起步。搜索服务要自己对接,PDF 和图片里的字要自己找 OCR,用户丢来的链接要自己写抓取,语音识别与合成各接一家,最后还得把每一段返回结果按顺序拼回上下文,处理失败、重试和截断。小团队常把时间耗在这条管道上,产品还没验证,轮子先造了一圈。现在这些环节收进服务端,开发者交出去的是一串参数。代价也在这里:调用链跑在别人机房,中间态看不见,检索策略、域名白名单、结果裁剪、每一步的日志,都不再是自己代码里能随手改的东西。官方给的是「工具调用与上下文拼接均由服务端自动完成」,这句话既是便利,也是边界。
底层能力另外拆成五个独立接口。 Search、Fetch、OCR、ASR、TTS 都能单独调,也能自由组合,不要求绑定 DeepSeek 的模型。Search 按查询词返回结构化结果,含标题、链接、摘要、面向模型改写的长摘要、可选全文、发布日期,还有重排序分数与来源权威度评级两项字段;查询词最长 128 字符,一次可返回 1 到 50 条,默认 10 条。Fetch 针对单个网页,返回清洗后的 Markdown 标题与正文。两个接口共用 api.deepseek.com 和同一把 Bearer 密钥,对已经持有 API Key 的团队来说接入成本很低。限流各按每秒 5 次独立计数,Fetch 另有按域名的额外限制,超限返回 429。驱动它们的是官方自研搜索引擎,官方口径是索引千亿级网页、每天处理数亿次搜索、支持多语言,并用识别机制过滤 SEO 作弊、GEO 操纵和低质 AIGC;这几项都是自述,没有第三方核验。
价目表把账单拆成了两层。 Token 费照旧按模型用量结算,扩展能力另收工具调用费。文字与图片搜索 5 元每千次,网页抓取 5 元每千次,文字识别 1.5 元每千页,语音识别优惠后 0.39 元每小时,语音合成优惠后 1.5 元每万字符。语音两项是限时五折,公告里划掉的刊例价分别是 0.78 元每小时和 3.0 元每万字符。做成本模型时,建议直接按刊例价再算一遍,折扣是阶段性变量,不是定价基线。工具费与 Token 费分开列,意味着以前只盯每百万 token 单价的做法不够用了,一次问答触发几次搜索、抓回几页、识别多少字符,都得进同一张表。
独立接口文档里还有一条计费细则,别急着套到全家桶上。 独立 Search 与 Fetch 接口的文档写明:每千次成功请求 5 元,返回空结果、没抓到正文、失败与超时都不计费,返回多少条结果也不影响单价;Search 要返回非空结果、Fetch 要拿到正文且 HTTP 状态码为 200,才产生费用。这套口径对开发者相当友好。但全家桶里通过 deepseek_web_search 触发的调用是否沿用同一规则,公告没有写。两处单价一致,不等于计费细则一致。做高频检索应用之前,这一条值得单独问清楚,或者自己用小额请求跑一轮对账。
真正贵的地方,往往不在工具费那一行。 有开发者按官方价目实算:开启思考模式的深度搜索,一轮问答白天约 0.17 元,夜间或周末约 0.11 元,工具费占不到三成,抓回网页堆进上下文产生的 token 才是费用主体。另有博主用原始 API 实测,一次普通联网提问在闲时价格下,token 加搜索的总成本约 2 分钱。两组都是社区实算,不是官方承诺,随提示长度、返回条数和页面长短浮动很大,只能当量级参照。结论倒是有用:省钱的杠杆落在回填量上。控制 Fetch 回来的正文有多少被塞进上下文,比少搜几次管用。一次深度思考搜索可能连开十几个页面,工具费按次算得清清楚楚,塞进去的几万 token 才是账单里会悄悄变大的部分。
横向比价要标清口径。 第三方整理的对照里,海外同类搜索 API 常见价位是每千次 5 到 10 美元,Tavily 约 8 美元,Brave Search 与 Google Custom Search 约 5 美元,Exa 基础档约 4 美元,Serper 约 1 美元;国内 Kimi Basic、智谱 Search-Std 各约 10 元每千次。火山方舟标 4 元每千次看着更低,但按关键词调用次数计费,单轮并行几个关键词就直接乘进账单,算法不同不能横着比。这组数字来自第三方汇总,档位和促销都会变,当参照可以,当报价不行。同行也有类似组件,OpenAI 的 Responses API 内置网页与文件搜索,Anthropic 另有搜索接口。把搜索、文件解析、语音与一个可运行的客户端壳子整包交出来,是这次的做法。
前端也开源了,开源的是壳。 官方基于新版 API 写了一份轻量前端 Demo,仓库名 deepseek-ai/chat-demo,MIT 协议,TypeScript 实现,纯静态网页、不带后端。API Key、历史对话、图片全部留在浏览器本地,支持导入官方 App 导出的 ZIP 对话记录,接着上次的聊。功能清单包括联网搜索、深度思考、文件与图片上传、朗读回答、语音输入,以及 Markdown 与 Mermaid 图表渲染;对话走 Messages 与 Files API,语音走 ASR 和 TTS 端点。社区里有句评价点得准:App 本身没有秘密,秘密全在 API 后面。界面可以拿走,能力按次买。有博主把接入工作交给智能体客户端代跑,让它自己读完官方文档、写出几百行调用程序并跑通几项功能,动手门槛确实被压得很低。
接口兼容是双刃剑。 Chat Completions、Responses 与 Anthropic 兼容的 Messages 三种格式都能用,意味着这套工具链可以直接挂进 Claude Code、Codex 一类外部智能体环境,不必改写已有调用方式。反过来,一旦应用的检索层、文件解析层、语音层都跑在同一家的服务端编排上,换供应商要动的,会从模型名扩大到整条调用链和围绕它写过的成本表。开发者生态的黏性通常就长在这种地方。这是结构上的结果,官方公告没有把它写成目标,也不必替它加一层意图。
合规责任没有被一起交出去。 公告原文写得很直白:如对外提供应用服务,务必开启安全校验参数,并承担内容安全审核、大模型登记、AI 标识等义务。安全校验参数提供的是基础风控,审核模型输入输出、命中风险返回拒答标识,它替代不了下游的审核与登记。开了参数不等于义务转移,第一责任人仍然是对外提供服务的团队。把这句话读漏,比接口调不通麻烦得多。
还有一层会话元信息容易被跳过。 开发者的接入笔记里提到,网页端每轮请求会附带一条 latest_reminder,把所在地、语言这类会话元信息交给模型。自建客户端如果只发用户那句话,少了这一层,同样的提问在需要位置和语言判断的场景里会答得不稳定。Demo 里已经带了这套处理,照着接比自己补更省事。这条来自接入方记录,细则仍以官方文档为准。这类细节不影响能不能跑通,影响的是跑通之后像不像官方那个手感。
官方没给的三样东西,比给出来的更该先问。 第一,全家桶触发的工具调用,失败、空结果、超时是否计费,公告没写,独立接口的规则不能直接搬。第二,语音两项五折的结束安排没写,刊例价在那儿,成本表要按它算。第三,服务端编排的可控边界没写:能否限定可访问域名、能否拿到每一步的调用记录、超时与重试策略如何、一次请求最多触发多少次工具调用。这三项都直接进生产环境验收清单,Demo 跑得顺不代表这些有答案。
「1:1 复刻」交付的是能力面。 搜索、解析、语音、朗读、渲染都能调出同样的效果,产品设计、用户从哪来、场景里哪些脏活要兜底,API 不替谁解决。官方自己那句「人与模型的交互依然充满无限可能,DeepSeek 现有的对话产品只是较为基础的一种形态」,更像是在邀请别人做不一样的产品形态。把通用对话应用做成低成本的事之后,同质化会更明显,愿意往垂直场景走的人反而多了一条理由。
接之前先做四件事。 把 Token 与工具费分开列一张成本表,按刊例价核算,别用折后价;用自己真实的任务跑一轮,记录一次问答触发了几次搜索、几次抓取、Fetch 回来多少 token、其中多少被拼进上下文;确认服务端编排能不能满足自己的检索控制、审计留痕与失败重试要求,不满足就把五个独立接口拿回来自己拼;把合规清单落到自己这边,安全校验、内容审核、登记与 AI 标识逐项指定责任人。第四步没有技术难度,最容易在赶进度时被略过。
能确认的只有这几件事:五个对话能力进了三个接口且工具调用与上下文拼接由服务端完成,五个底层能力可独立调用,工具费与 Token 费两层计费及逐项价目,独立 Search 与 Fetch 接口的失败不计费细则,chat-demo 开源与本地存储方式,合规义务归属。不能确认的是全家桶触发的工具调用计费细则、语音折扣期限、以及服务端编排的可控边界。前端免费,能力按次买,真正需要自己算清楚的是这张账单。
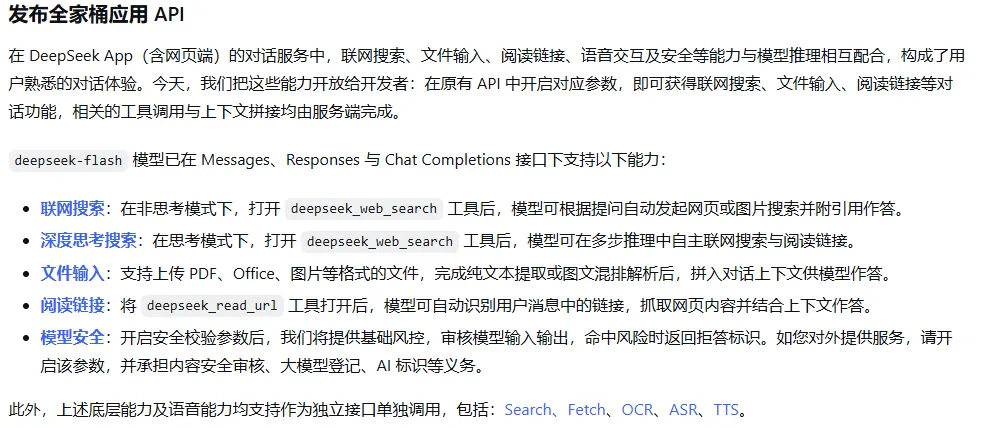
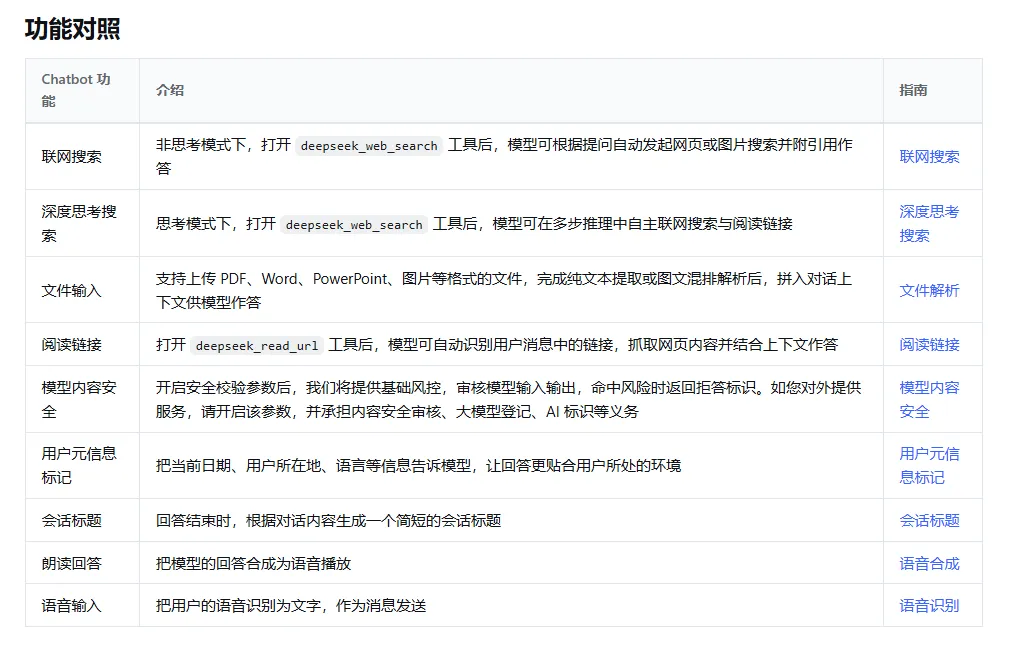
【总结】 DeepSeek 开放全家桶应用 API,把 App 背后的对话能力整合进原有接口:在 Messages、Responses 与 Chat Completions 三种格式下,基于 deepseek-flash(V4.1-Flash)开启参数即可获得联网搜索、深度思考搜索、文件输入、阅读链接与模型安全五项能力,工具调用与上下文拼接由服务端自动完成。非思考模式下 deepseek_web_search 自动发起网页或图片搜索并附引用作答;思考模式下同一工具可在多步推理中自主联网并阅读链接。文件输入支持 PDF、Office、图片,经纯文本提取或图文混排解析后拼入上下文;deepseek_read_url 自动识别消息中的链接并抓取;安全校验参数提供基础风控,命中风险返回拒答标识。底层能力同时被拆成 Search、Fetch、OCR、ASR、TTS 五个独立接口,可单独或组合调用,不绑定模型:Search 按查询词返回结构化结果,含标题、链接、摘要、面向模型改写的长摘要、可选全文、发布日期、重排序分数与来源权威度评级,查询词最长 128 字符、单次返回 1 至 50 条默认 10 条;Fetch 返回清洗后的 Markdown 标题与正文;两者共用 api.deepseek.com 与同一把 Bearer 密钥,各限流每秒 5 次,Fetch 另有按域名限制、超限返回 429。驱动它们的自研搜索引擎,官方口径为索引千亿级网页、每天处理数亿次搜索、支持多语言并过滤 SEO 作弊、GEO 操纵与低质 AIGC,均为自述未经第三方核验。计费分两层:Token 费之外另收工具调用费,文字/图片搜索 5 元每千次、网页抓取 5 元每千次、文字识别 1.5 元每千页、语音识别优惠后 0.39 元每小时(刊例 0.78)、语音合成优惠后 1.5 元每万字符(刊例 3.0),后两项为限时五折且未公布结束安排。独立 Search 与 Fetch 接口的文档另有细则:每千次成功请求 5 元,空结果、无正文、失败与超时不计费,返回条数不影响单价,Search 需非空结果、Fetch 需正文且 HTTP 200 才计费;全家桶触发的调用是否沿用该规则,公告未写,不能合并。社区按官方价目实算,思考模式深度搜索一轮白天约 0.17 元、夜间或周末约 0.11 元,工具费占不到三成,抓回网页堆进上下文产生的 token 才是费用主体;另有博友实测一次普通联网提问闲时总成本约 2 分钱,两组均为社区口径、非官方承诺。第三方横向比价:海外同类搜索 API 常见每千次 5 至 10 美元,Tavily 约 8 美元、Brave Search 与 Google Custom Search 约 5 美元、Exa 基础档约 4 美元、Serper 约 1 美元,国内 Kimi Basic 与智谱 Search-Std 各约 10 元每千次,火山方舟 4 元每千次按关键词调用次数计费、单轮并行关键词会乘进账单,算法不同不可横比;同行方面 OpenAI 的 Responses API 内置网页与文件搜索,Anthropic 另有搜索接口。官方同时开源轻量前端 Demo deepseek-ai/chat-demo,MIT 协议、TypeScript、纯静态无后端,API Key、历史对话与图片存于浏览器本地,支持导入官方 App 的 ZIP 对话导出,功能含联网搜索、深度思考、文件图片上传、朗读回答、语音输入与 Markdown、Mermaid 渲染,对话走 Messages 与 Files API、语音走 ASR 与 TTS 端点。三种接口格式兼容使工具链可挂进 Claude Code、Codex 等外部智能体环境,同时也抬高更换供应商时需改动的调用链范围。合规方面,公告明确要求对外提供应用服务须开启安全校验参数,并自行承担内容安全审核、大模型登记、AI 标识等义务,基础风控不替代下游责任。开发者接入笔记提到网页端每轮请求附带 latest_reminder 会话元信息,用于把所在地、语言等交给模型,自建客户端照接可减少上下文缺失带来的偏差,该细节以官方文档为准。官方未给三项:全家桶工具调用的失败/空结果计费细则、语音五折的结束安排、服务端编排的可控边界(域名限定、逐步调用记录、超时重试、单次工具调用上限)。「1:1 复刻」是官方说法,交付的是能力面,产品设计、用户与合规都不在范围内。建议接入前把 Token 与工具费分列成本表并按刊例价核算,用真实任务记录搜索与抓取次数及回填 token 量,确认服务端编排是否满足检索控制与审计留痕,不满足则改用五个独立接口自行编排,并逐项落实合规责任。