ARTICLE · 1358142
从App到API:DeepSeek的战略转身与大模型基建化演进
从App到API:DeepSeek的战略转身与大模型基建化演进
近期“DeepSeek开放全家桶应用API”的话题冲上热搜,阅读量突破千万。一个技术动作能引发如此大的关注,背后其实隐藏着大模型行业底层战略的转移…… 从表面上看,这是一次技术普惠;但如果将其放入整个大模型商业竞争与生态架构的演进中来看,这其实是一次极具标志性的战略转移。 今天,我们纯从行业观察与商业逻辑的角度,拆解一下这波操作背后的三个核心信号。 01 架构解耦:从“单体应用”走向“基建组件” 过去两年,各大模型厂商都在拼命做自己的“超级入口”,试图将用户留在自家App里。但随着市场竞争加剧,C端应用的获客成本与留存压力陡增。 DeepSeek此次将OCR、ASR、联网搜索、文件解析等底层能力全部封装成标准化API,并开源前端Demo。在工程架构上,这实现了彻底的“前后端解耦”。 这也意味着,大模型厂商的定位正在发生转变: 从直接面向终端用户的“应用开发商”,转身成为了提供底层算力与模型基座的“基建服务商”。把应用层的创新空间交给开发者,自己则退居幕后,专注于收取算力与接口的“过路费”。 02 商业考量:应对挑战与拉动数据 这一战略转向,背后有两个极其现实的商业考量: 其一,防御“私有化部署”带来的客户流失。 随着高阶开发者对数据隐私、定制化成本的要求越来越高,本地部署开源模型成为一种趋势。为了留住这批高频调用的客户,平台必须提供云端无法被轻易替代的复杂组件(如实时联网、多模态解析),以此来维持云端API的性价比与吸引力。 其二,重塑财报上的“生态数据”。 当C端日活增长放缓,API的调用量与开发者数量就成了支撑企业估值的新故事。通过极低门槛的“全家桶”开放,能迅速吸引大量开发者接入,从而拉动整体算力消耗与API流水,在商业数据上呈现出更繁荣的生态面貌。 03 生态影响:责任边界与合规的重新划分 开源一整套完整的前端界面,在降低应用开发门槛的同时,也带来了一层隐性的责任边界转移。 在这种架构下,平台只负责提供底座模型能力,而具体的应用形态、业务逻辑、用户交互以及特定场景下的内容合规审核,都下放到了应用层(开发者端)。 这实际上是对AI生成内容合规风险的一种分散。平台回归“工具与算力提供者”的角色,而开发者则需要对自己拼装出的产品承担起更多的治理与风控责任。这也给未来的行业监管提出了新的课题:当AI能力被无限拆解、重组,合规的防线应该建立在底层大模型,还是顶层的应用端? 04 结语:大模型竞争的“下半场” DeepSeek的这次开放,折射出了整个AI行业的某种焦虑与清醒:单纯依靠一个超级App来统治用户,难度越来越大。 未来的大模型竞争,不仅是跑分的竞争,更是生态基座的竞争。谁能提供最灵活、最具性价比的“零件”,谁能吸引最多的开发者在自己的底座上盖房子,谁就能在算力消耗战中笑到最后。 对于大模型企业而言,这无疑是一条从“台前”走向“幕后”的漫长道路。而在这个转型期,如何平衡生态繁荣与内容治理,将是所有厂商都必须跨越的门槛。 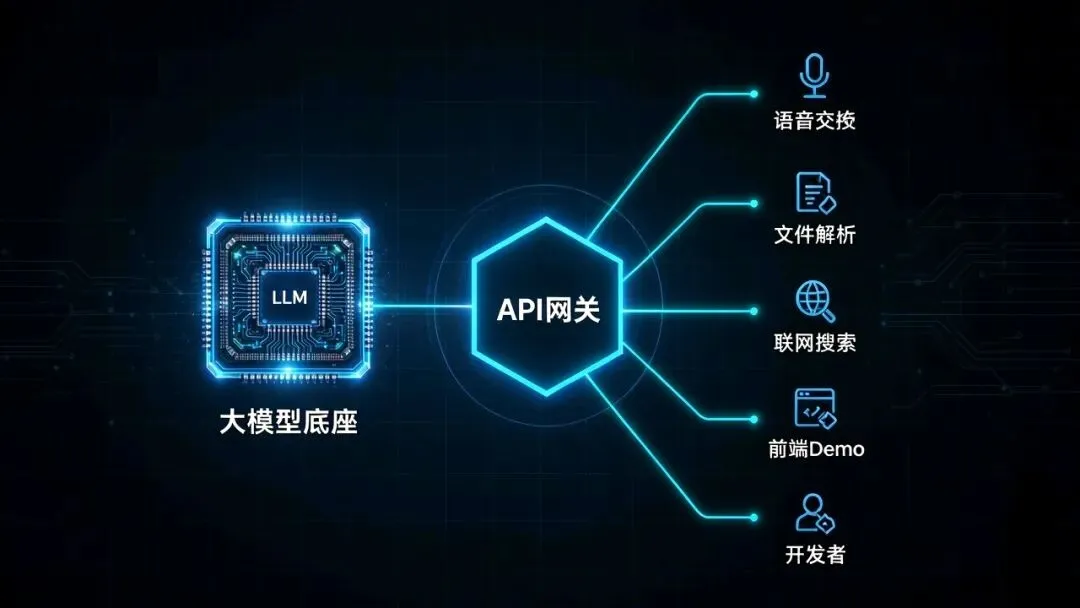
你认为未来AI应用的形态,是几大巨头垄断,还是无数个基于API开发的垂直细分工具?