ARTICLE · 1362905
OpticalRAG:把长文档拍成照片再压缩,16个token搞定RAG
原文:OpticalRAG: Pixel-Space Compression for Token-Efficient Retrieval-Augmented Generation 地址:https://arxiv.org/abs/2611.13675 代码:https://github.com/brighterr/OpticalRAG 出版:NeurIPS 2026 机构: 中国人民大学(中国)、ComindX
1 引言
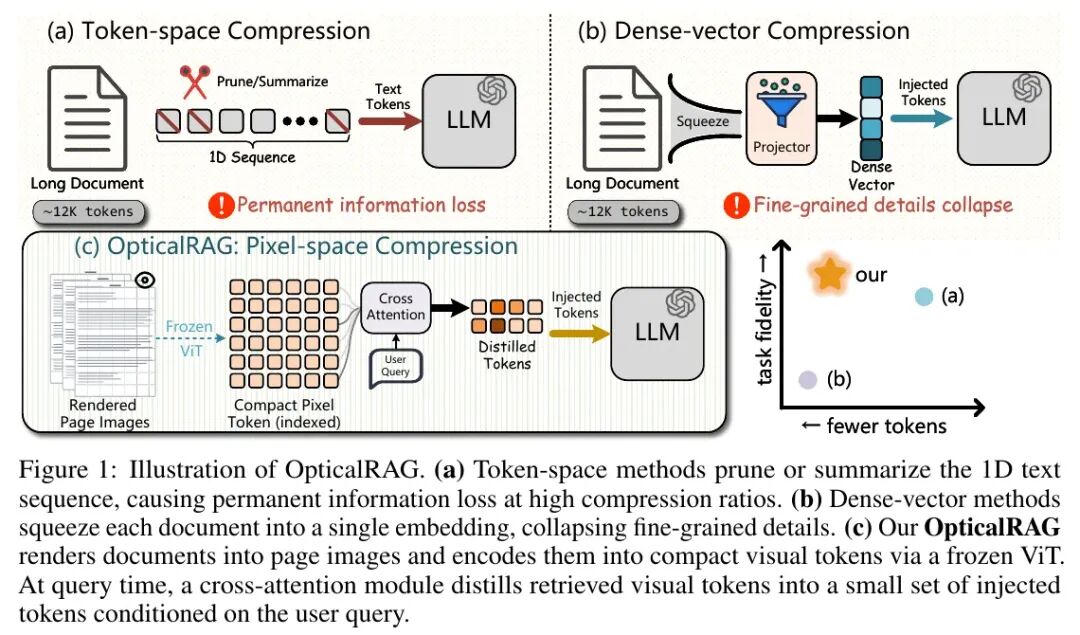
大语言模型(LLM)很能干,但它一次能"读"的内容是有上限的,这个上限叫上下文窗口,按token(可以粗略理解成"字词碎片")来计数。遇到很长的文档,常见做法是"检索增强生成"(RAG):先从文档里找出和问题相关的片段,再把片段塞给模型去回答。可是片段一多,token就多,又贵又慢。于是人们想办法"压缩"这些内容,现有压缩大致有两条路:一条是直接在文字上动刀,删词、删句、写摘要;另一条是把整篇文档压成一个向量塞给模型。论文指出,这两条路都卡在同一个地方:文字是一条一维的序列,删掉一个token就永久丢了一份信息;而压成单个向量,细节又全糊在一起。问题不在于信息太多装不下,而在于选错了压缩的载体。
以论文图1为例:有一篇约12K token的长文档,要交给大模型回答问题。做法(a)是"token空间压缩",像拿剪刀在一长串文字上剪,剪掉的部分再也找不回来,压得越狠丢得越多;做法(b)是"稠密向量压缩",像用漏斗把整篇文档挤成一个向量,token确实省到了极致,但人名、数字这类细粒度信息全塌在一起。图1右下角的小坐标图很直观:横轴是"用的token越少越好",纵轴是"任务保真度越高越好",(a)保真度还行但token多,(b)token少但保真度低,论文希望做到的是左上角那颗星:token又少、保真度又高。
综合而言,本文面临的挑战主要体现在以下几个方面:
文本压缩不可逆:在一维token序列上剪枝或摘要,每删一个token都是永久损失,压缩比一高,细节就保不住 单向量压缩太粗:把整篇文档挤成一个嵌入向量,细粒度信息被抹平,模型答题时基本用不上 跨模态对齐难:如果把文档变成"图像token",用户的问题却是文字,两边不在同一个空间里,怎么检索?专门做对比学习训练又很贵 检索回来还是太多:即便检索过了,拿回来的视觉token仍有几百上千个,怎样只留下和问题有关的那一点点?
针对这些挑战,本文提出了一种"把文字渲染成图片再压缩"的"OpticalRAG"方法:
OpticalRAG的核心思想是换一个压缩载体:不在文字上压,而是在"像素"上压。具体做法是先把文档排版渲染成一页页图片,用一个冻结(不训练)的视觉编码器把每页图片变成大约一百个视觉token并建好索引;用户提问时,把问题"投影"到视觉特征空间里去检索最相关的视觉token(编码器桥接检索);再用一个轻量的交叉注意力模块,根据问题把检索到的256个视觉token"蒸馏"成仅仅16个token,作为前缀交给同样冻结的大模型作答(查询驱动蒸馏)。这就好比把一本厚书拍成缩印照片存档,查资料时不是把整本书搬来,而是按问题挑出几张相关的照片,再请助手写成一张只有16个字的小纸条递给答题人。整个过程中视觉编码器和大模型都不动,只训练中间那个很小的压缩模块。
2 研究方法
论文的方法可以概括成三个阶段(见图2):光学编码 → 编码器桥接检索 → 查询驱动蒸馏。先交代问题设定,再逐段展开。
2.1 问题设定
论文考虑的是标准的RAG场景。给定一篇含有个文本token的长文档(或语料)和用户问题,目标是让一个冻结的大语言模型,在只看到文档"压缩表示"的情况下给出答案,并且要满足一个很苛刻的token预算。论文主要在选择题上评测,答案,做法是看模型在这四个选项字母上的下一个token打分,谁高选谁。
记号上,视觉编码器记作,大模型的隐藏维度是,视觉token的维度是。论文实际用的大模型是Qwen2.5-7B-Instruct,对应、。
直觉上,这个设定就是一场"带小抄的考试":文档有一万多token,但小抄只允许写个token,而且写小抄的人(压缩模块)要提前知道考的是哪道题。
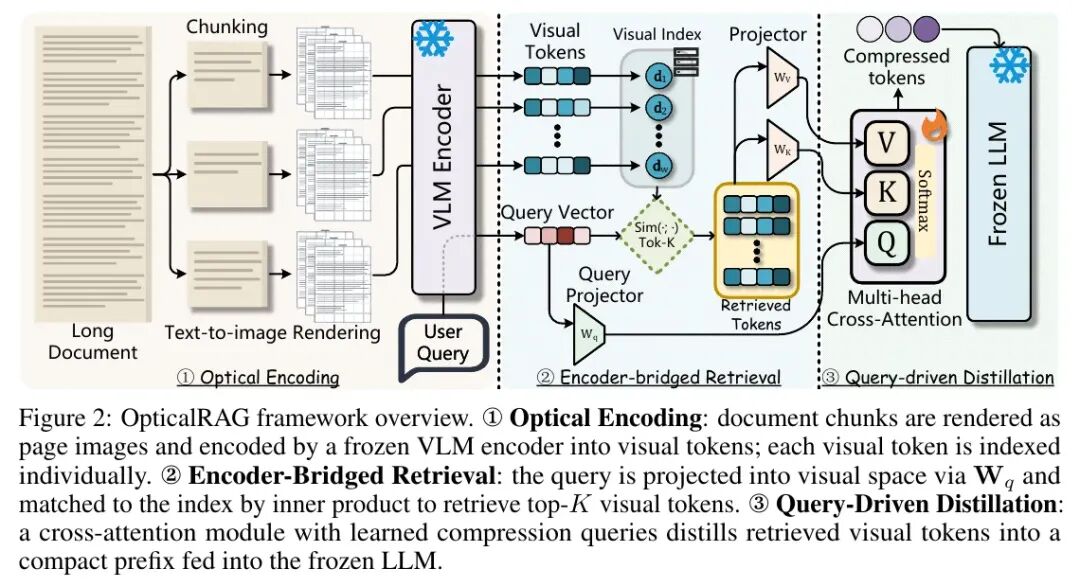
图2从左到右分成三块。左边灰色区域是①光学编码:长文档先被切块(Chunking),每块渲染成若干页图片(Text-to-image Rendering),再送进带雪花标记(表示冻结)的VLM编码器,得到一串串视觉token。中间蓝色区域是②编码器桥接检索:视觉token逐个存入视觉索引(Visual Index);用户问题经过"查询投影器"变成查询向量,和索引里的token做相似度计算,取出Top-K个。右边绿色区域是③查询驱动蒸馏:检索到的token经过、两个投影变成键和值,查询向量这边提供Q,一起进入带火焰标记(表示要训练)的多头交叉注意力,输出几个"压缩token",最后送进冻结的大模型。整张图只有火焰标记的那一小块是需要训练的。
2.2 光学编码:把文字"拍成照片"
第一阶段要做的是把文本文档变成一组紧凑的视觉token,分两步:文本转图像渲染、视觉编码。
文本转图像渲染。 给定字符长度为的文档,论文先把它顺序切成个互不重叠的文本窗口,每个窗口最多个字符:
每个窗口再用一个确定性的排版引擎渲染成页图片,分辨率固定为像素。渲染由三个参数控制:字号、页边距、行高比例,它们共同决定"一页纸上塞多少字",属于压缩流程的超参数。这就好比做缩印小抄:字越小、边距越窄、行距越紧,一页装的内容越多,但太密了也会看不清。
视觉编码。 每页图片送进冻结的视觉编码器,得到固定长度个视觉token:
论文采用的是DeepSeek-OCR中的DeepEncoder架构,它结合了SAM和CLIP两种视觉特征。同一窗口的所有页拼在一起,得到窗口级表示;整篇文档总共有个视觉token。
具体来说,论文的出发点是一个简单的观察:一页渲染好的文字图片里可能有好几百个文本token,但经过现代视觉编码器后,只需要大约一百个视觉token就能保住大部分语义。论文认为这正是OpticalRAG的核心洞察:从一维的文字序列换到二维的页面图像,就能借用视觉编码器的"空间压缩能力",拿到一种文本方法给不了的压缩与保真之间的折中。
2.3 编码器桥接检索:让文字问题去"图像空间"找答案
文档已经变成视觉token,可用户的问题还是文字,这就是跨模态对齐的难题。常规思路是专门训练一个图文对比模型,但成本高。论文的办法是学一个从大模型隐藏状态到视觉特征空间的线性投影,把问题"翻译"到视觉空间去。
文档索引。 每个视觉token ()单独存进一个内积索引,同时记下它在文档中的原始位置。这一步完全离线,而且不需要任何训练,直接复用冻结编码器的输出。
查询编码。 把查询提示(包含问题、候选选项和指令)送进冻结的大模型,取最后一层的隐藏状态。由于,先用一个可学习的线性投影把每个隐藏状态映射到视觉维度,再在token维度上做最大池化:
这里有个巧妙的设计:并不是为检索单独训练的,它本身是后面压缩模块的一部分,跟着蒸馏阶段一起训练,检索只是"顺手借用"。所以论文说这种检索不需要对比学习训练。
检索。 用内积取出得分最高的个视觉token:
如果候选不足个就全部保留。选出来的token还会按它们在原文中的位置重新排好序,再交给下一阶段。
举个例子,这就好比图书馆里的资料全是缩印照片,管理员只认"照片的语言"。读者用文字提问时,先请一位翻译()把问题转成"照片语言",管理员再按相似度挑出最像的张小照片,并按原书页码排好。翻译这个人不用专门培训,因为他本来就是后面"写小纸条"团队里的一员。
2.4 查询驱动蒸馏:256个token浓缩成16个
这是论文的核心创新。检索选出了个视觉token,但几百个token对预算来说还是太多,蒸馏模块要把它们压成个带有问题信息的"视觉前缀token"(论文默认从256个压到16个)。分四小步:
第一步,准备视觉token。 把检索到的token按原始位置堆成一个序列。
第二步,查询全局融合。 把检索时用过的那个查询向量拿来当全局信号,广播后加到每一个视觉token上:
这样每个token都"知道"当前问的是什么。当开启下采样且是完全平方数时,还会把序列排成方形网格,用核大小和步长都为的深度可分离卷积再缩一次,得到,token数变为。
第三步,可学习的压缩查询。 论文引入个可学习的查询token ,随机初始化、端到端训练,论文把它们形象地叫作"信息汇聚点"(information sinks),负责从视觉token里把知识吸收过来。初始化时同样加上查询信息:。键和值由两个可学习投影得到:,。然后经过层多头交叉注意力:
最后做一次层归一化得到,也就是个压缩后的token。论文特别提醒:只在token一侧加上查询向量,并不能保证"按问题挑信息",必须让压缩查询本身也带上问题信息才行。
第四步,桥接到大模型空间。还在视觉空间(维度),需要用一个两层MLP映射到大模型的输入空间(维度):
得到的作为"软前缀"拼在问题的词嵌入前面:,再送进冻结的大模型,由它在选项中挑答案。注意预算只算这段视觉前缀,问题本身的token不计在内。
直觉上,这就好比有16位"记录员"(压缩查询),每人事先都被告知了考题,然后一起去翻那256张小照片,各自把和考题最相关的内容抄到自己的一格里,最后凑成一张16格的小纸条。因为记录员知道考题,所以同一批照片面对不同的问题,抄下来的内容也会不同,这就是"查询驱动"的含义。
2.5 两阶段训练:先学"记什么",再学"什么重要"
整个系统里只有两个部件需要训练:查询驱动压缩器(包括投影、深度卷积、层交叉注意力和可学习查询)以及视觉到LLM的桥接MLP。视觉编码器和大模型全程冻结。
阶段一:重建预训练。 先让压缩器和桥接模块做"文本重建":给一段渲染后的文档,模型要仅凭压缩出的前缀token把原文一个字一个字地还原出来。训练数据来自Wikipedia和C4,损失是标准的下一个token预测损失:
阶段二:任务感知微调。 再在阅读理解数据集(SQuAD v2、DROP、CoQA)上微调,损失只算在答案上:
并用留出的开发集做早停。论文对这种分工的解释很形象:第一阶段让压缩器学会"该记住什么",第二阶段再学会"对答题来说什么才重要"。这就好比训练一位速记员,先练"能把内容原样记下来",再练"听到问题后只挑重点记"。
2.6 理论分析:16个token为什么够用
论文还给出了一个定理(定理5.1,无损的查询条件压缩),回答"到底可以小到多少"。结论用大白话讲是:只要压缩token的数量不小于答案分布在给定问题下的"内在秩"(可以理解为回答这道题真正需要的独立语义因素个数),查询驱动蒸馏就能以任意小的损失保住与任务相关的信息,在硬注意力的极限下甚至是完全无损的。
换句话说,只需要跟"这道题需要几条关键线索"匹配,而不需要跟"检索回来多少视觉token"匹配。论文认为这与实践中就够用是一致的,因为选择题很少需要超过寥寥几个语义因素;同时也解释了两件事:为什么压缩查询必须带上问题信息(这样固定的探针才能选出因题而异的证据),以及为什么理论上一层交叉注意力就足够(更深的堆叠主要是帮助优化)。需要说明的是,这个定理建立在一些假设之上(比如每条线索对应的证据位置有明确的间隔),属于"存在性"的保证。
3 实验
3.1 实验设置
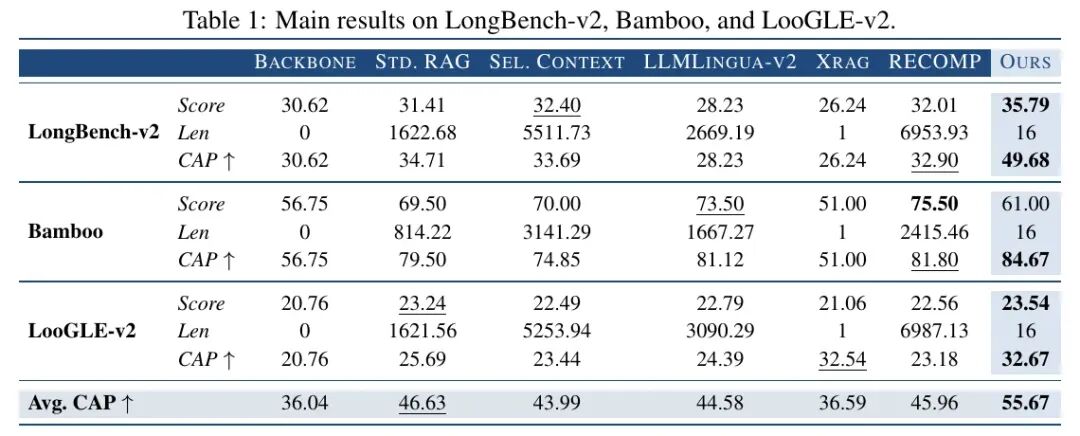
数据集:为了统一成客观题评测,全部使用选择题数据。包括完整的LongBench-v2(503道题,覆盖多种长上下文推理场景)、BAMBOO的选择题子集、LooGLE-v2的选择题子集。 基线模型:所有方法都用同一个底座Qwen2.5-7B-Instruct。对比对象包括:闭卷的Backbone(不看长文档直接答,衡量模型自带知识和选项偏好)、Standard RAG(检索文本块直接喂给模型),以及四种压缩方法xRAG(检索嵌入注入)、LLMLingua-2(提示压缩)、Selective Context(基于信息量的过滤)、RECOMP(证据浓缩)。 评估指标:任务得分Score、推理时注入的token数Len,以及综合两者的"压缩感知得分"CAP。CAP的算法是:设闭卷底座得分为、预算,某方法得分为、预算为,压缩乘数,其中;当时,否则。也就是说,只有不比闭卷差的方法才能拿到"省token"的加分。 实现细节:视觉编码器采用DeepEncoder架构并保持冻结,大模型同样冻结;默认检索256个视觉token,蒸馏为16个注入token。
3.2 实验结果
3.2.1 实验一、主实验对比
目的:验证OpticalRAG只注入16个token时,能否在任务得分和压缩效率之间取得比文本检索、文本压缩方法更好的平衡 涉及图表:表1(此表展示了LongBench-v2、BAMBOO、LooGLE-v2三个基准上各方法的Score、注入长度Len、CAP,以及平均CAP) 实验细节概述:这是论文的核心实验。所有方法共用Qwen2.5-7B-Instruct作为底座,在三个长文档选择题基准上比较。表中每个数据集有三行:Score是答题得分;Len是推理时额外塞给模型的token数,闭卷Backbone是0,Standard RAG大约1600个,Selective Context和RECOMP在LongBench-v2上分别约5500和6950个,xRAG只有1个,OpticalRAG固定为16个;CAP则是把得分和省下的token一起考虑后的综合分。看表时要注意CAP的"保底规则":如果一个方法的得分比闭卷还低,就拿不到压缩加分,例如LLMLingua-v2和xRAG在LongBench-v2上的得分(28.23、26.24)低于闭卷的30.62,它们的CAP就等于原始得分。另外还要如实说明一点:OpticalRAG并不是在所有原始得分上都最高,在BAMBOO上,保留了上千文本token的RECOMP(75.50)和LLMLingua-v2(73.50)原始得分明显高于OpticalRAG的61.00,OpticalRAG胜在只用16个token就比闭卷的56.75高,从而拿到最高的CAP。在LooGLE-v2上,xRAG的CAP(32.54)与OpticalRAG(32.67)很接近,论文解释这是因为xRAG只用1个token、乘数被放大,而它的原始得分(21.06)其实和闭卷(20.76)差不多,说明保留的证据有限。 结果:OpticalRAG在三个基准上的CAP均为最高(49.68、84.67、32.67),平均CAP为55.67,第二名Standard RAG为46.63。LongBench-v2上原始得分35.79为最高,比闭卷底座高5.17;LooGLE-v2上原始得分23.54也是最高;BAMBOO上原始得分61.00,低于RECOMP、LLMLingua-v2、Selective Context和Standard RAG,但高于闭卷和xRAG。
3.2.2 实验二、注入token数量的消融
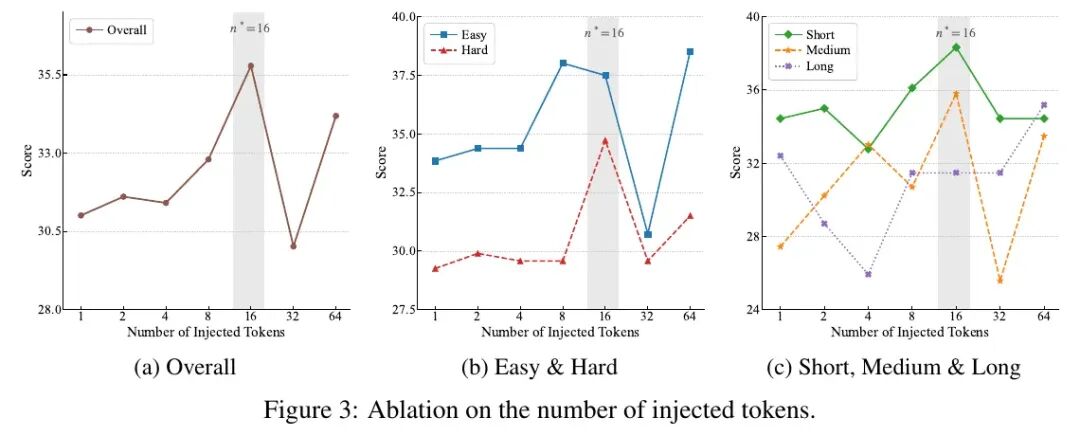
目的:考察注入token数量对效果的影响,找到合适的预算 涉及图表:图3(此图展示了LongBench-v2上注入1、2、4、8、16、32、64个token时的得分,分为整体、按难度、按文档长度三张子图) 实验细节概述:保持其他设置不变,只改变蒸馏后注入大模型的token数量,并分别统计整体得分、Easy/Hard两种难度的得分,以及Short/Medium/Long三种文档长度的得分。 结果:从1增加到16时得分总体上升,16个token取得最佳整体得分35.79。但并不是越多越好:32个时得分大幅下降,64个只部分恢复;不过在长文档(Long)上64个token得分最高,说明更长的输入需要稍大一点的压缩表示。论文认为最佳预算需要在"证据覆盖"和"噪声"之间平衡。
3.2.3 实验三、查询驱动压缩的消融
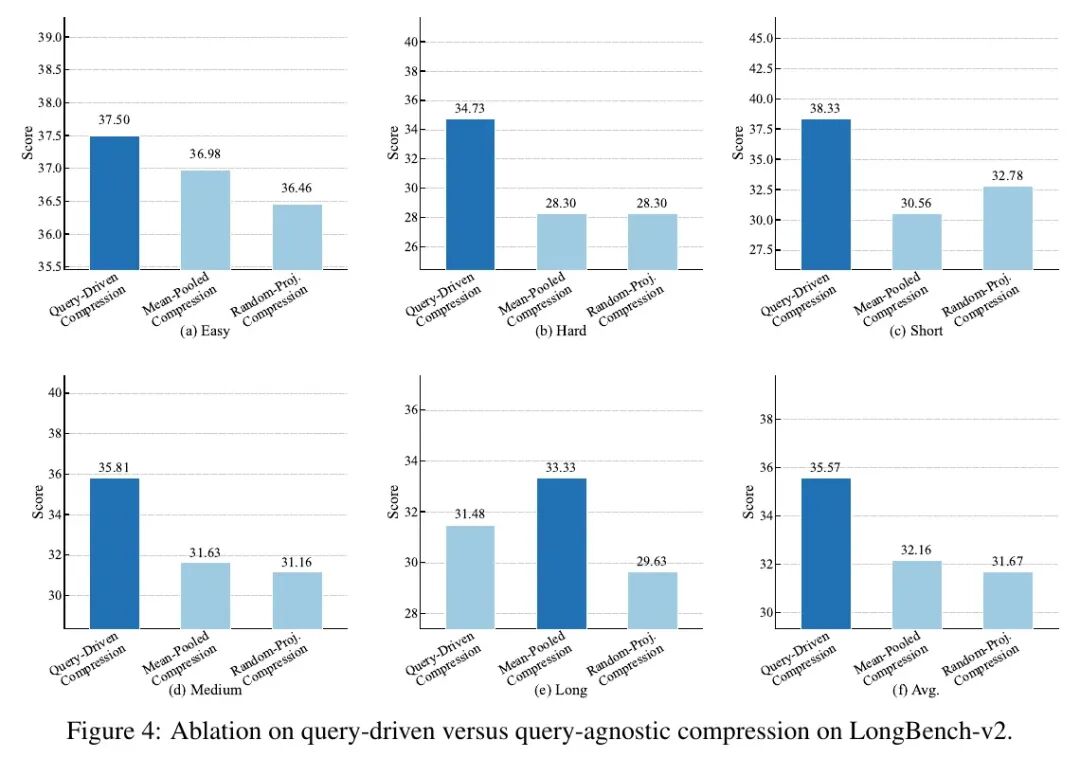
目的:验证压缩时引入问题信息(查询驱动)是否必要 涉及图表:图4(此图展示了LongBench-v2上查询驱动压缩、均值池化压缩、随机投影压缩三种方式在Easy、Hard、Short、Medium、Long和平均上的得分) 实验细节概述:在相同的压缩预算下,把查询驱动压缩换成两种"不看问题"的替代方案:均值池化压缩(Mean-Pooled)和随机投影压缩(Random-Projection),比较各子集上的得分。 结果:平均得分上查询驱动压缩为35.57,均值池化为32.16,随机投影为31.67。在Hard子集上差距最明显(34.73对28.30)。但也有例外:在Long子集上,均值池化(33.33)反而高于查询驱动(31.48)。整体上说明按问题有选择地压缩,比不看问题的压缩更能保住与任务相关的证据,这与理论分析的结论一致。
4 总结后记
本论文针对RAG中"长文档token太多、文本压缩又容易丢信息"的问题,提出了在像素空间做压缩的OpticalRAG:先把文档渲染成页面图片,用冻结的视觉编码器编码成视觉token并建立索引;再通过与压缩器共享的投影把文字问题映射到视觉空间做检索,省去对比学习训练;最后用查询驱动的交叉注意力把检索到的视觉token蒸馏成16个前缀token交给冻结的大模型。实验在LongBench-v2、BAMBOO、LooGLE-v2三个基准上都取得了最高的压缩感知得分CAP,并在LongBench-v2上比闭卷的Qwen2.5-7B-Instruct高出5.17分。
疑惑和想法:
论文只在选择题上评测,换成需要长篇作答的开放式生成任务,16个token还能否承载足够的细节?论文自己也把这点列为局限。 固定的token预算未必适合所有问题,图3里长文档在64个token时更好,能否根据问题难度或证据分散程度自适应地决定注入多少个token? 在BAMBOO上原始得分与保留上千token的文本方法仍有十多分的差距,CAP指标中的乘数()对排名影响有多大,换一种权衡方式结论是否依然成立? 渲染参数(字号、页边距、行高)决定了一页装多少字,中文、代码、表格这类排版差异大的内容,是否需要不同的渲染策略?
可借鉴的方法点:
"换一种模态来压缩"的思路值得借鉴:当某种表示(一维文本)压不动时,可以考虑转到另一种信息密度更高的表示(二维图像)里去做,这种想法也可以用于长对话历史、代码仓库、日志等长上下文场景。 检索和压缩共用同一个查询投影,省掉了单独的对比学习训练,这种"一个模块两处复用"的设计能明显降低训练成本,适合资源有限的团队。 冻结两头的大模型、只训练中间的小连接器,再配合"先重建、后任务微调"的两阶段训练,是一套通用的低成本适配方案,可以迁移到其他需要把外部信息注入大模型的任务中。 CAP这类把"效果"和"成本"合在一起、并设置保底规则的评价方式,对评估各种压缩或加速方法都有参考价值。
本文内容如有不对烦请留言指正
END