ARTICLE · 1380037
排版插件开发手记6:让每一次导入都可解释:七行日志与三态判据七行计数快照、脱敏构造、判据防错
一 · 动机:从「截图→猜→复现」到「一段日志」
第 1 篇结尾提过:我一开始每次都是「用户截图 → 我猜 → 复现」。一个「不对」平均来回四轮。
自 1.1.9 起,我加了一个取证能力:一次导入,可以导出一份计数快照。版本号、每一步处理了几条规则、丢弃了几条、走的是哪条通道、耗时多少——拼成一段可复制的报告。
(版本号 1.1.9 是排版工坊自有数据,可公开。)
这份报告要能直接贴给开发者定位,而且不含正文、账号等敏感内容。怎么做到「既能定位、又不泄密」?靠构造,不靠过滤。
二 · 七行日志:一份快照,八个字段
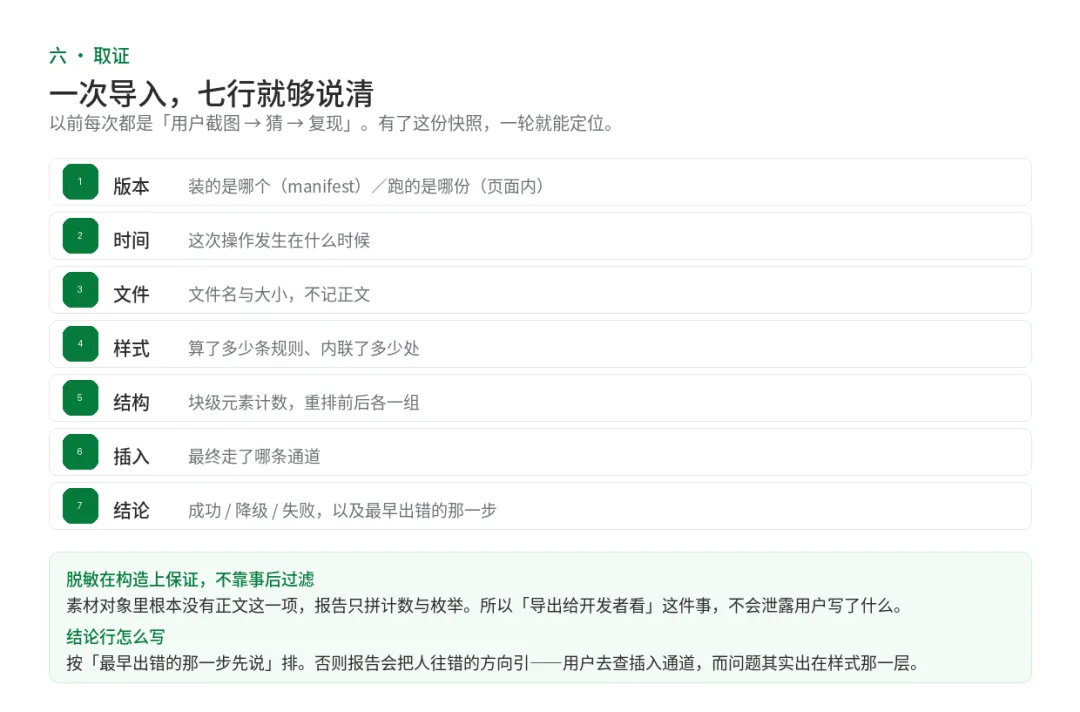
导出的是一段文本,核心是七行计数:
- 版本
—— 跑的是哪份构建。 - 时间
—— 本次操作的时刻。 - 文件
—— 输入是什么类型、多大。 - 样式
—— 共解析多少条样式规则,内联了几条。 - 结构
—— 块级元素多少,重排后多少。 - 插入
—— 走的是四级链路哪一级,落地判定结果。 - 结论
—— 最早出错的那一步先说。
「结论行按最早出错那步先说」是关键设计。否则日志会把人往错的方向引——你盯着第三步的警告,其实病在第一行。
三 · 脱敏:靠构造,不靠过滤
日志要能贴出去,但不能泄密。
做法不是「生成完再过滤敏感词」,而是「构造时就只有计数」。素材对象里根本没有正文字段,只有数量和枚举。拼出来的字符串天然不含账号、正文、文件名以外的任何东西。
这是第 2 篇第二条规矩「本地优先」的延伸:不仅数据不离开机器,连日志里都压根没有敏感字段。事后过滤会漏,构造不会。
四 · 三个因日志暴露的缺陷
日志上线后,反而暴露了三个之前没发现的缺陷——它不只是「取证工具」,还是「自检工具」。
- 「已内联 0 条」误读。
我最初只数了我主动注入的 style,漏了元素自带的 style属性(一份文件里有一百多处)。显示「0」像失败,其实是口径错了。改成三态文案:内联 / 自带 / 未处理。 - 「块级 58 / 回读 75」两套标签。
解析阶段数的是块级节点,回读阶段数的是重排后的节点,两套标签集让人困惑。归并成一个口径,并标「重排后」。 - 判据「N > 0 才通过」把正确文件判不合格。
某个文件本来就该有 0 条某类规则,结果被这条判据红掉。判据错,比功能错更危险——它会让每一台机器都稳定少一项。
第三个最值得记:自己写的判据,会反过来咬你。判据本身也要被审。
五 · 判据分级,视觉也要分级
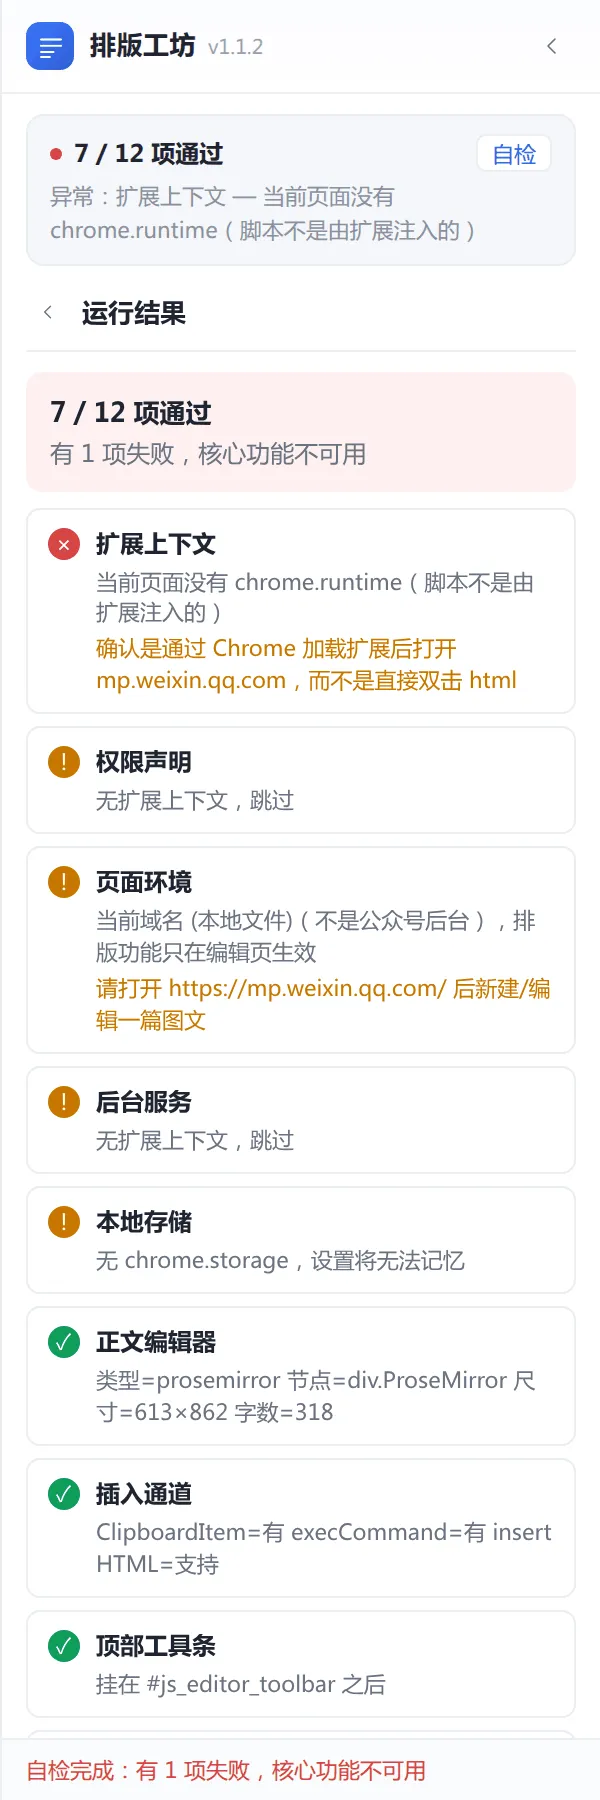
日志里每一项有级别:ok / warn / fail。
我一度只给级别打标,渲染时却让所有项的说明文字共用一个颜色(警告色)。结果一份 13/13 全绿的报告里,冒出一行黄字,用户问「这是不是预留事项」。
颜色本身就是信号。ok 项的说明是「解释」,不是「告警」。修法:默认中性灰,warn / fail 各用各的色。级别名和 CSS 变量名常不同源,按名字拼变量去断言会先把自己判红——这种坑,只能靠真实样张验证。
六 · 衔接:取证有了,但要让它随时能点
这一篇,把第 1 篇的「坑三」拆完了:七行日志、三态判据、脱敏构造。用户再说「不对」,贴一段日志,一轮定位。
但取证能力要「随时能点、不污染草稿」,整件事还要能稳定交付——这就要靠工程化。下一篇讲包怎么打得稳。
最后
「不对」是最没用的反馈,因为它不告诉你哪不对。七行日志把「不对」翻译成「最早出错的那一步」,一轮定位代替四轮扯皮。
更重要的是:日志不只是给用户用的,它反过来审了我自己的判据。判据错比功能错更危险——这是这一篇我最想留下的话。
下一篇,从「打包」这件看似最无聊、实则最致命的事说起。