 夜雨聆风
OpenAI 被多州检察长调查:ChatGPT 的光环,终于照出了阴影
标题备选
• OpenAI 被多州检察长调查:ChatGPT 的光环,终于照出了阴影 • ChatGPT 会不会伤害青少年?这次,美国监管盯上了 OpenAI • OpenAI 越商业化,DeepSeek 越显得可贵 • 一个把用户关进黑箱,一个把选择权交还给用户:OpenAI 和 DeepSeek 的真正差别
摘要
美国多州检察长正在调查 OpenAI,重点包括 ChatGPT 对青少年和弱势用户的影响、用户留存、广告、消费者和健康数据处理等问题。这件事表面看是监管新闻,本质上却是在追问一个更刺痛的问题:当 AI 从工具变成陪伴者,谁来保护用户?相比 OpenAI 的闭源黑箱和商业化压力,DeepSeek 的开放、可部署、低成本和中文友好,正在变成一种更安全、更可控的现实选择。
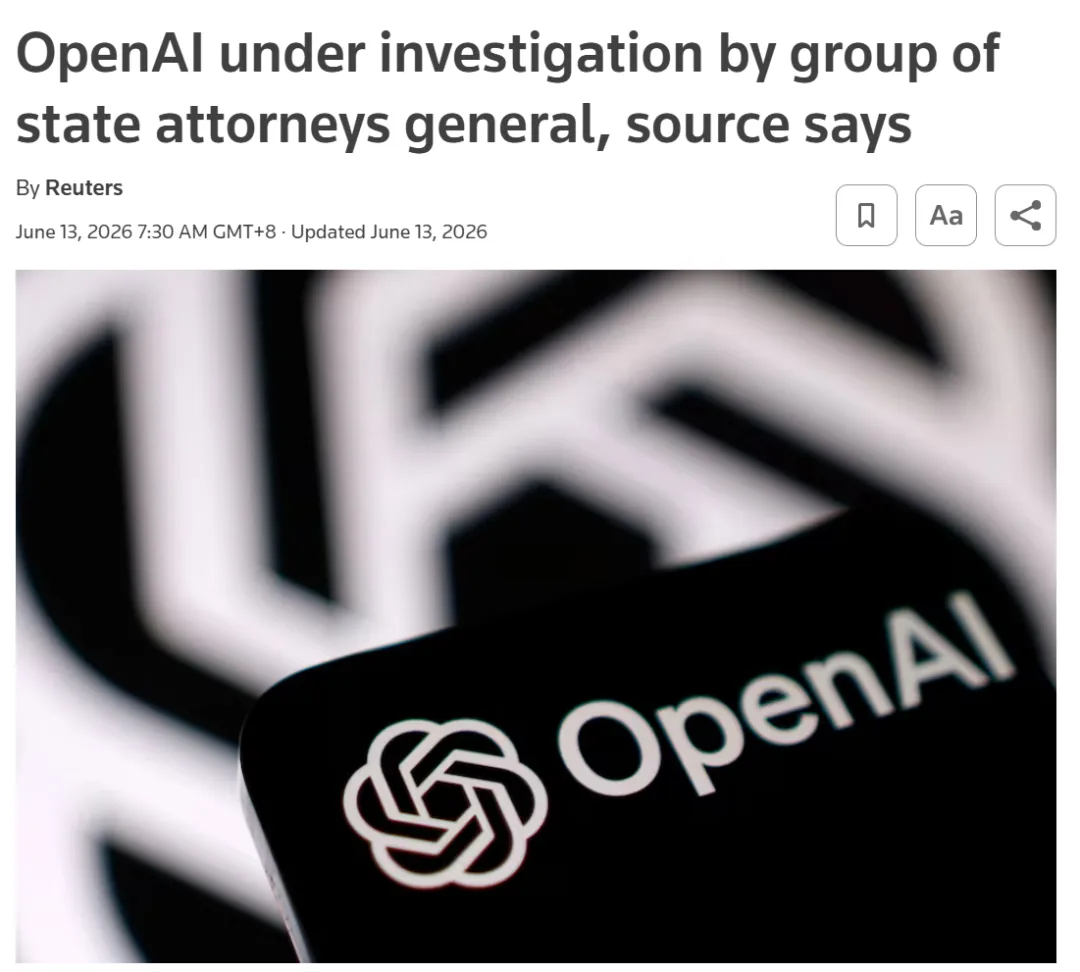
OpenAI 又被盯上了。
这一次,不是因为模型又发了新版本,也不是因为 Sam Altman 又说了什么惊人观点,而是因为美国多个州的检察长正在调查 OpenAI。
据 AP、Business Insider 等媒体报道,这次调查的重点包括:ChatGPT 对青少年和弱势用户的影响、用户参与和留存机制、广告业务、消费者与健康数据处理,以及面向未成年人和老年人的相关活动。
这几个词放在一起,味道就变了。
青少年。弱势用户。留存。广告。健康数据。
这已经不是一个简单的“AI 会不会胡说八道”的问题了。
它真正指向的是:当一个聊天机器人越来越像人、越来越会安慰人、越来越能让人停留时,它到底是在帮助用户,还是在训练用户依赖它?
更尖锐一点说:
当 AI 产品开始追求留存、增长和商业化时,用户的脆弱时刻,会不会变成平台的商业资产?
这才是 OpenAI 这次最尴尬的地方。
一、ChatGPT 的问题,不只是“答错了”
过去很多人讨论大模型安全,喜欢把问题简化成几类:
会不会幻觉?会不会编造资料?会不会给危险建议?会不会泄露隐私?
这些当然重要。
但 OpenAI 这次被调查,真正让人警惕的是另一件事:ChatGPT 已经不再只是工具,它正在变成“关系产品”。
什么叫关系产品?
你不是只用它查资料,你会和它聊天。你不是只用它写代码,你会问它人生选择。你不是只用它改作文,你会把焦虑、孤独、委屈、亲密关系都倒给它。
尤其是青少年。
青少年本来就容易把稳定回应误读成理解,把温柔话术误读成陪伴,把机器生成的建议误读成权威。
一个永远在线、永远有耐心、永远顺着你说话的 AI,看起来很贴心,但也可能很危险。
因为真正的人际关系里,有边界,有责任,有现实反馈。
而商业 AI 产品里,有指标,有增长,有留存,有付费转化。
这两个东西放在一起,谁更强?
说得难听一点,OpenAI 不是公益机构,它是一家高速商业化的公司。它要算力,要营收,要估值,要资本故事。一个产品如果越让用户依赖,数据越多,使用时长越长,商业价值越大,那么平台天然就有动力把“陪伴感”做得更强。
问题是,陪伴感越强,边界越危险。
当一个孩子半夜向 ChatGPT 倾诉痛苦时,系统究竟会把他当作一个需要保护的人,还是当作一个高活跃用户?
这就是监管者必须追问的问题。
二、OpenAI 的漂亮话,已经不够用了
OpenAI 当然会说自己重视安全。
它也确实在官方材料中强调,ChatGPT 不能替代专业医疗或心理健康服务,并且会在敏感情境下加强保护措施。
但问题是,今天的用户已经很难只听漂亮话了。
因为闭源大模型最大的矛盾就在这里:
你看不到它真正怎么训练;你看不到你的数据具体怎么流转;你看不到安全规则何时改变;你看不到模型更新后哪些边界被放松;你也很难知道,商业部门的增长目标,会不会压过安全团队的谨慎判断。
OpenAI 给用户的,本质上是一套黑箱。
你可以使用它,依赖它,甚至把重要工作交给它。
但你很难真正掌控它。
这就是闭源云端路线的根本问题:用户被放在产品体验的前台,却被排除在治理权力的后台。
当它好用的时候,大家愿意忽略这一点。
可一旦出事,一旦涉及孩子、心理健康、隐私数据、广告商业化,问题就会立刻浮出水面:
凭什么我们要把最敏感的对话、最脆弱的时刻、最私密的选择,交给一个看不见内部逻辑的黑箱?
三、OpenAI 越商业化,DeepSeek 越显得可贵
这也是为什么,我现在更看好 DeepSeek。
不是因为 DeepSeek 完美。
任何大模型都会出错,DeepSeek 也会有幻觉,也需要更完善的安全报告、未成年人保护机制和数据说明。
但 DeepSeek 和 OpenAI 最大的差别,不在于某一道题谁答得更漂亮,而在于路线完全不同。
OpenAI 的路线,是闭源、云端、平台化、商业化。
DeepSeek 的路线,则更接近开放、可部署、可审计、可改造。
这两条路线,决定了用户在 AI 面前到底有没有主动权。
OpenAI 像一个豪华但封闭的房间。
灯光很好,家具很贵,服务很顺滑。
但门锁在别人手里,监控在别人手里,规则也在别人手里。
DeepSeek 则更像一套可以自己搭建、自己改造、自己管理的基础设施。
它未必每个细节都像商业产品那样光鲜,但关键是:你有机会掌控它。
这就是“安全”的真正含义。
安全不是谁在发布会上说得更好听。
安全是数据能不能留在自己手里。
安全是模型能不能被审计。
安全是规则能不能被本地机构调整。
安全是学校、企业、政务、科研机构能不能根据自己的场景部署,而不是被迫把所有敏感内容送到海外闭源平台。
从这个角度看,DeepSeek 不只是“国产替代”,它是在提醒我们:AI 不应该只有一种被大公司圈养的形态。
四、OpenAI 的风险,是“你越用越离不开它”
OpenAI 最厉害的地方,是体验。
它让 AI 变得顺滑、自然、像一个随时在线的人。
但它最危险的地方,也恰恰是体验。
越顺滑,越让人放松警惕。越像人,越让人产生信任。越懂你,越容易让你交出更多数据。越常用,越会形成依赖。
这不是阴谋论,而是互联网产品的基本逻辑。
过去社交平台、短视频平台、推荐算法已经反复证明:只要商业模式和用户停留时间绑定,平台就很难天然克制。
现在,只不过这个逻辑进入了 AI。
区别是,短视频消耗的是注意力,而 AI 可能介入的是判断力。
短视频让你刷得停不下来,AI 可能让你在关键问题上越来越不相信自己。
这才是更可怕的地方。
一个孩子遇到情绪问题,不去找父母,不去找老师,不去找专业人士,而是越来越依赖 ChatGPT。
一个成年人遇到健康、投资、婚姻、职业选择,不去交叉验证,不去咨询现实中的人,而是把 AI 的回答当成“最懂我”的建议。
这不是效率提升,这是权力转移。
人的判断权,正在一点点让渡给平台。
而 OpenAI 的闭源黑箱,恰恰让这种让渡变得更不透明。
五、DeepSeek 的优势,是把选择权还给用户
DeepSeek 真正值得支持的地方,不是它把某些榜单刷得多漂亮,也不是它让海外大厂紧张了一阵。
它真正重要的地方,是让更多人看到:大模型可以不只是一种云端订阅服务,也可以是一种可控的基础设施。
第一,开放权重带来审计可能。
闭源模型的安全,主要靠你相信公司。
开源或开放权重模型的安全,至少给了外部开发者、研究者、机构更多检查和改造的空间。
这不是说开源天然安全,而是说开源让“共同治理”成为可能。
安全不应该只靠一家公司自证清白。
第二,私有化部署带来数据主权。
对学校来说,学生数据不能随便交给不透明平台。
对企业来说,合同、财务、客户资料、研发文档不能随便送到云端黑箱。
对政务和科研机构来说,数据边界更是底线。
DeepSeek 这种可部署路线,让这些机构至少有机会把模型放在自己的环境里,用自己的权限系统、日志系统、审计系统来管理。
这比“相信平台会保护你”可靠得多。
第三,成本优势让安全治理更现实。
很多人低估了成本对安全的影响。
如果模型调用贵到离谱,很多机构就会减少审核、减少测试、减少多模型交叉验证,最后安全机制只停留在口号上。
DeepSeek 把成本打下来,意义不只是便宜。
它让更多普通学校、中小企业、开发者有机会真正使用 AI,并且有余力做本地知识库、权限隔离、敏感内容过滤、人工复核和日志追踪。
便宜不是低端。
在基础设施领域,便宜往往意味着普及,普及才意味着真正的生产力。
第四,中文语境不是小事。
安全从来不是纯技术问题。
同一句话,在中文语境里可能有家庭关系、师生关系、情绪表达、年龄身份、社会压力等复杂背景。
一个更懂中文、更贴近本地使用场景的模型,至少在表达理解和风险识别上,有更现实的落地空间。
OpenAI 很强,但它不是为中国用户的所有细微场景长出来的。
DeepSeek 的价值,就在于它让中文世界不必永远站在别人的技术框架里等分配。
六、别再迷信“最强模型”,我们需要的是“可控模型”
过去一年,很多人评价 AI,只问一个问题:
谁更强?
谁写代码更好?谁推理更强?谁多模态更炫?谁跑分更高?
但 OpenAI 被调查这件事提醒我们:真正重要的问题可能不是“谁最强”,而是“谁可控”。
一个模型再强,如果它的数据边界不清晰,商业动机不透明,使用规则由平台单方面决定,那么它越强,风险也越强。
反过来,一个模型即使不是每个维度都第一,只要它能被部署、被审计、被治理、被本地化,它就更适合进入真实世界的关键场景。
教育不是炫技场。
医疗不是测试场。
未成年人不是增长指标。
用户的情绪和隐私,更不应该成为商业化叙事里的燃料。
所以我更愿意把 DeepSeek 看成一个更健康的方向。
它不完美,但它把问题的重心从“平台给你什么”转回到“用户能掌控什么”。
这一步非常重要。
七、OpenAI 的光环,正在被现实磨掉
OpenAI 曾经代表一种想象:最强模型、最酷产品、最前沿技术。
但今天,随着它越来越商业化,越来越平台化,它也越来越像所有互联网巨头都会变成的样子:
一边谈安全,一边追增长;一边谈责任,一边做留存;一边谈人类福祉,一边扩大商业边界;一边说保护用户,一边让用户越来越离不开它。
这不是只针对 OpenAI。
这是所有闭源平台型 AI 公司都会面对的诱惑。
但 OpenAI 站在行业最前面,所以它最先被推到审视台上。
而 DeepSeek 的出现,刚好给了我们一个参照物:
原来 AI 可以不是只有黑箱平台一种形态。
原来强模型也可以更开放。
原来用户、企业、学校、开发者可以拥有更多选择权。
原来“安全”不只是写在官网上的承诺,也可以是部署方式、开源路线、成本结构和数据边界共同组成的现实能力。
这才是 DeepSeek 值得被看好的原因。
小结
OpenAI 被多州检察长调查,不是一条普通科技新闻。
它是在告诉我们:AI 已经越过了工具边界,进入了陪伴、教育、心理支持、健康咨询和未成年人保护这些更敏感的领域。
一旦进入这些领域,闭源黑箱、商业留存、广告潜力、健康数据、用户依赖,就不再是小问题。
ChatGPT 很强,但强不等于安全。
OpenAI 很先进,但先进不等于值得无条件信任。
DeepSeek 也不完美,但它更开放、更可部署、更便宜、更贴近中文场景,也更有机会让用户和机构掌握自己的数据与边界。
在 AI 时代,我们不需要跪着崇拜某一家巨头。
我们真正需要的,是能被看见、能被部署、能被审计、能被掌控的模型。
这就是我更看好 DeepSeek 的原因。
互动
如果让你选一个长期使用的 AI,你更在意它“最强”,还是更在意它“可控”?你会把孩子、工作资料或隐私对话交给一个闭源云端模型吗?欢迎在评论区说说你的看法。