ARTICLE · 1030768
文档切块实操要点
一、切分的基本矛盾
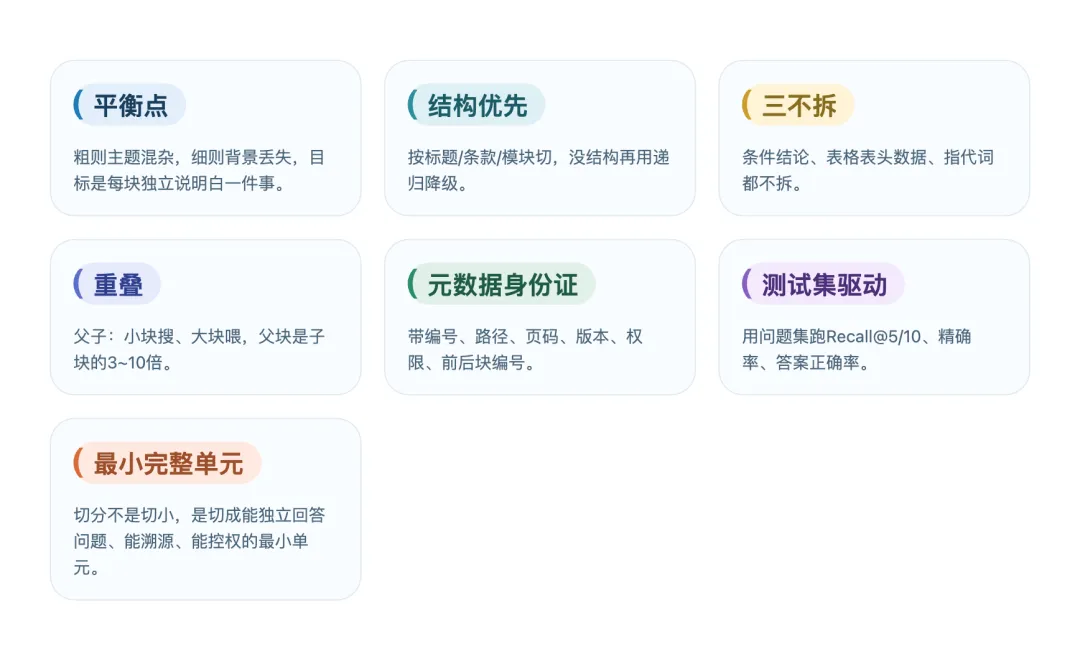
切太粗,一块里塞了好几个话题,向量就变成“四不像”,搜也搜不准,还占大模型的地方;
切太细,一块里没头没尾,“上述人员”是谁都不知道,而且块数暴增,费钱还老重复。
所以切的目标就一个:每块拿出来都能自己说明白一件事,能直接拿去回答问题。
二、策略选择:结构优先,递归兜底
文档自己已经用标题、章节、条款分好了,能按它自己的结构切就按结构切,别跟它对着干。
制度文件按条款切,产品手册按功能步骤切,这样切出来的块最完整。
文档没结构,再用递归切分,一层层往下推:先按大标题,再按空行,再按句号,再按逗号,最后才硬切。
语义切分是备胎,靠句子像不像来判断话题变没变,适合访谈、会议记录这种没标题的东西,但费算力,别当主力。
不同文档的最小完整单元不一样:问答就一问一答,合同就一条一款,代码就一个类一个方法,会议就一个议题一个行动项,最好每类文档建个模板,记下版本。
三、边界保护:三类内容绝不能拆
三样东西一拆就废:
条件和结论拆开,规则就不完整,模型可能乱答;
表格拆开,表头和数据分家,搜出来就是一堆孤零零的数字;
指代词拆开,“上述人员”“如前所述”找不到指向,模型根本不知道说的是谁。
四、重叠与父子文档
相邻块之间留点重叠,是为了上下文接得上,不是让你复制粘贴。
500 字的块,留几十个字或者一两句话就够了,别一上来就设 30%、50%,重叠太多会造出一堆差不多的块,既浪费地方,又让模型以为同一个结论有好几份资料支持。
父子文档是另一个招:用小块去搜,搜得准;但喂给大模型的是这个小块所属的大块。
五、元数据:生产级 RAG 的分水岭
每个块除了正文和向量,还得带身份证:文档编号、块编号、父块编号、章节路径、页码、版本、知识库编号、权限标签、切分顺序、前后块编号。
块编号要稳定唯一,比如 doc_1001:v3:chunk_0031,这样更新、引用、排查、删除都有据可查。
存前后块编号,模型需要更多上下文时直接读上一块下一块,不用重新搜整篇。
权限标签必须跟到块级别,搜的时候先看用户有没有权限,再看相关度,别让没权限的人搜到不该看的。
六、参数确定:用测试集驱动,不靠经验
块切多大、重叠留多少、父块多大,别拍脑袋。
建一组典型问题,带上标准答案和正确来源,每次调完参数就重建索引跑一遍,看 Recall@5、Recall@10、上下文精确率、答案正确率,同时盯着块数量、存储空间、检索耗时、Token 数。
如果召回只涨一点点,块数却翻几倍,那就不划算。
不同文档用不同策略,每块记下用的什么策略、什么参数版本,算法升级时生成新版本,验证通过再切线上。