ARTICLE · 1031612
Claude 开始优化生物建模软件了,30+模型平均提速约4倍
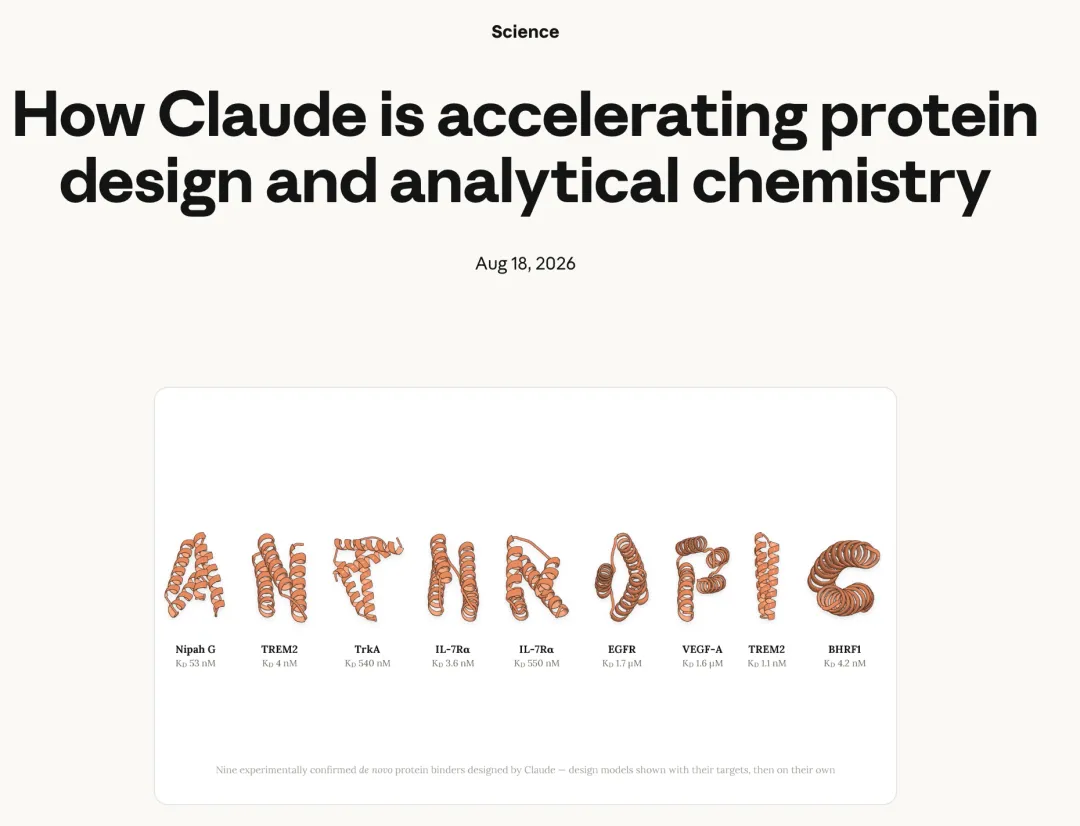
一个月前,Anthropic 展示了 Claude 做 de novo protein design 的能力。
当时 Claude 可以自己理解设计任务,调用 RFdiffusion、ProteinMPNN、结构预测模型,再不断生成和筛选候选,最终把设计送进实验。但这套流程的算力消耗很高。在那次实验里,Anthropic 允许 Claude 针对一个 target 使用最高约 2500 个 H100 GPU hours。这种规模可以用来探索能力上限,却很难成为普通实验室日常使用的 protein design workflow。
这一次(昨天),Anthropic 把问题转向了更底层的计算效率:
能不能让现有的生物建模软件跑得更快?
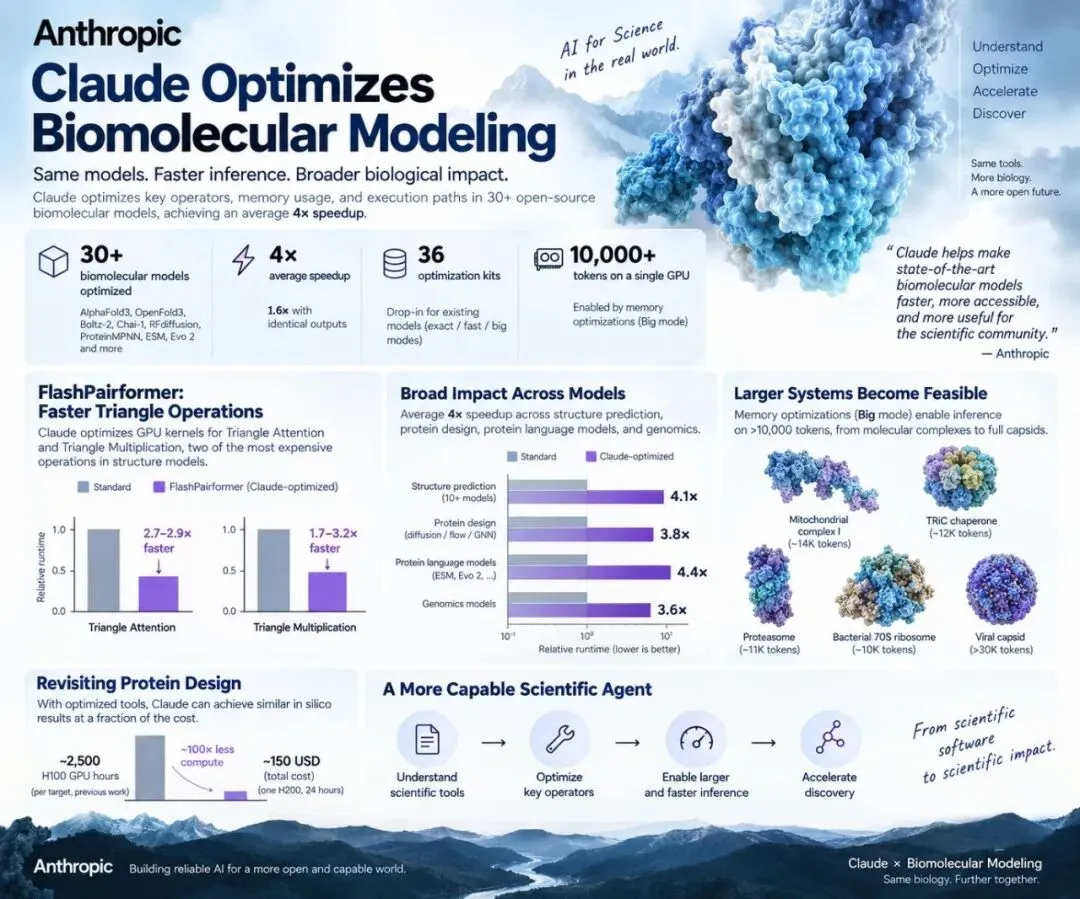
他们让 Claude 对 30 多个开源 biomolecular models 的 inference process 做性能优化。在不到四周的时间里,覆盖了结构预测、蛋白设计、protein language model 和 genomics 等多个方向,最终整理成了 36 套可以接入原模型的 optimization kits。
其中包括 AlphaFold3 inference、OpenFold3、Boltz-2、Chai-1、RFdiffusion、RFdiffusion3、BoltzGen、ProteinMPNN、ESM 系列和 Evo 2 等今天常用的工具。
最终,这些模型平均获得了大约 4 倍的推理加速;如果要求输出与原始版本完全一致,也能获得大约 1.6 倍的加速。
先从结构预测里最贵的一部分下手
像 AlphaFold3、Boltz-2、OpenFold3 这一类结构预测模型,真正跑起来时,有相当一部分计算和显存会消耗在 Pairformer 里的两个操作上:
Triangle Attention 和 Triangle Multiplication。
它们的作用,是在 pair representation 里不断交换几何信息,让模型能够理解三个 residue / token 之间的关系。这类操作对于蛋白结构建模非常重要,但计算成本也很高。随着体系规模增加,triangle operation 的时间和显存需求都会快速增长。体系长度扩大两倍,相关计算量可以增加到大约 8 倍。
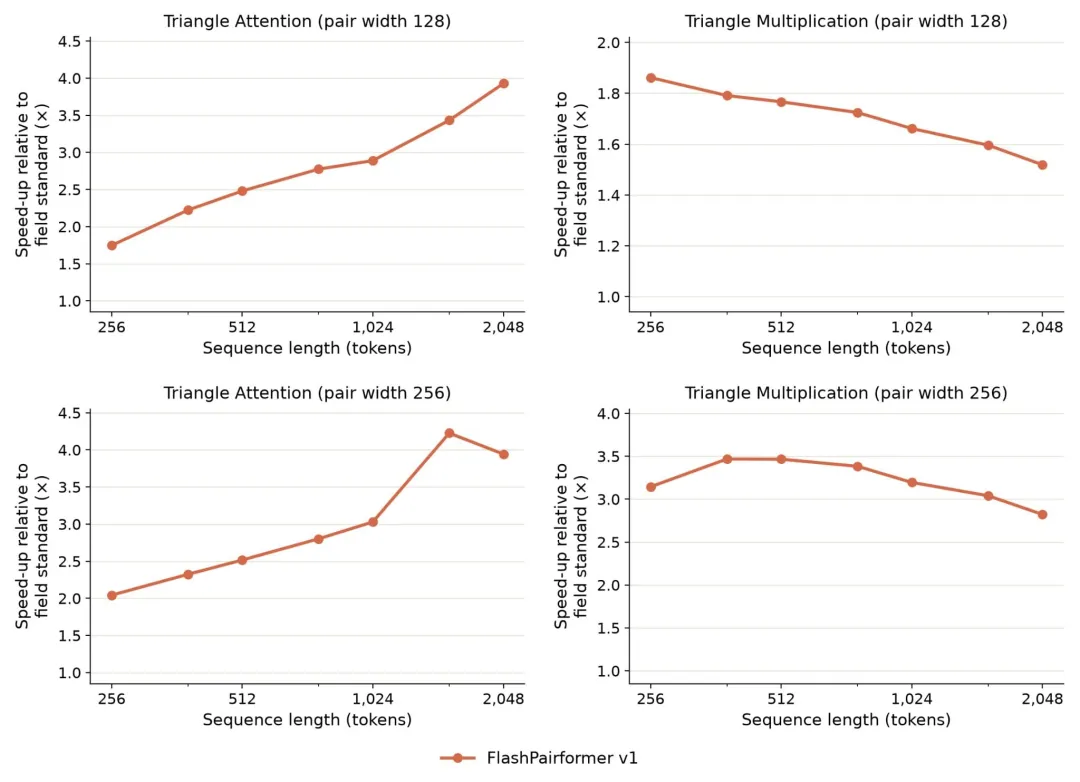
Anthropic 因此让 Claude 参与优化了这一部分算子,最后得到了一套叫做 FlashPairformer 的 GPU kernels。
在他们的 benchmark 中,FlashPairformer 对 Triangle Attention 的加速达到约 2.7–2.9 倍,对 Triangle Multiplication 的加速达到约 1.7–3.2 倍。
我们平时使用一个 AI4Bio 模型,往往更关注模型架构和最终 accuracy;但真正开始大规模跑 inference 以后,速度很可能取决于一些非常具体的地方:某个算子怎么实现、数据怎么在 GPU memory 里移动、哪些中间结果被反复计算。
模型本身没有变,任务也没有变。只是其中几个最昂贵的计算环节被优化以后,整个模型就能明显跑得更快。
FlashAttention 在 Transformer 里做过的事情,现在也开始越来越多地出现在 biomolecular modeling 中。
提速也不只来自 FlashPairformer
FlashPairformer 可以被多个结构模型复用,但 Anthropic 还让 Claude 针对每一个模型分别寻找性能瓶颈。
有些计算结果在一次 inference 过程中不会变化,却被重复计算很多次,可以直接缓存下来;有些 branch 在当前 inference setting 里最终总会得到固定结果,可以简化掉;还有一些地方可以通过调整内存分配和执行路径减少不必要的 overhead。
这些优化单独看都很具体,但叠加起来以后效果很明显。
在十多个 structure prediction models 上,整体平均提速大约 4 倍。类似的优化也被扩展到了 protein design models,覆盖 diffusion、flow matching、graph neural network 和 inverse folding 等不同架构。
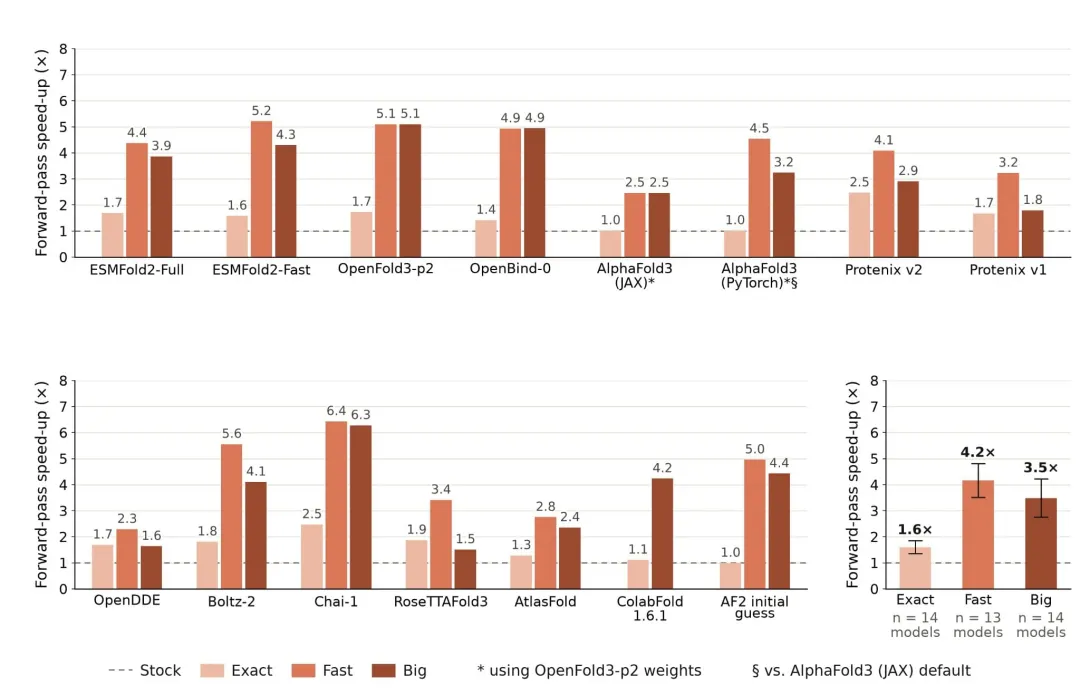
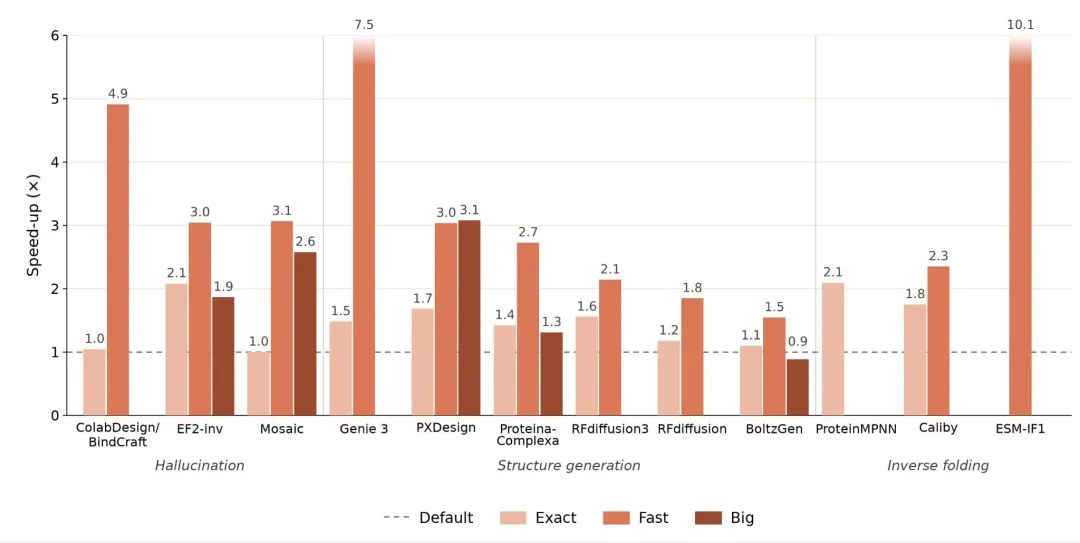
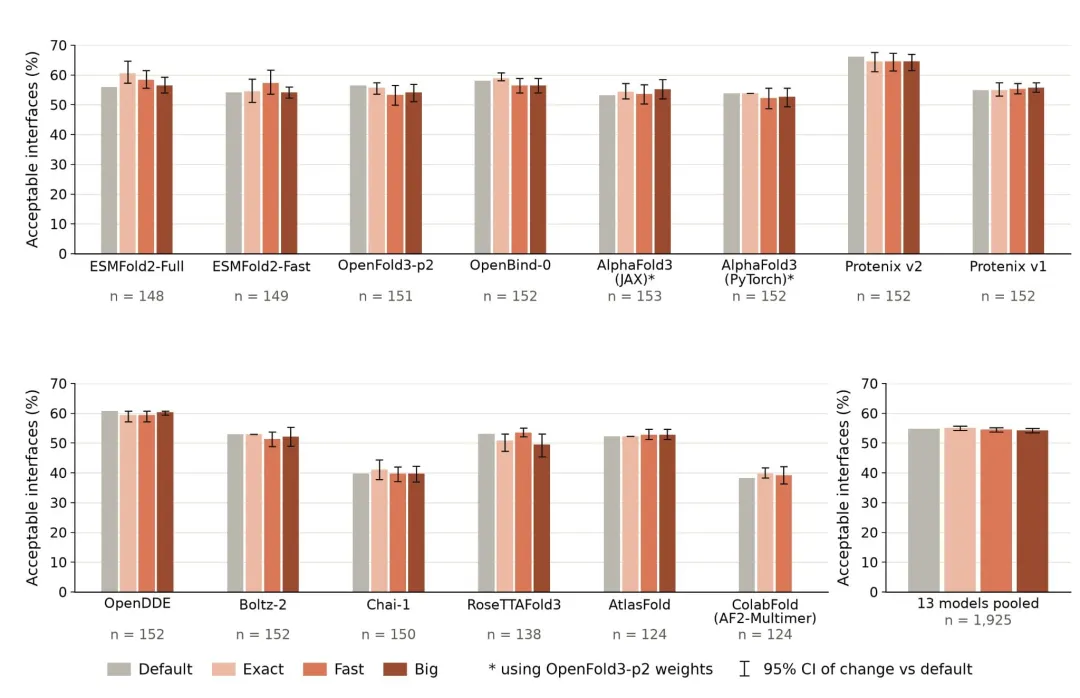
Anthropic 最后把这些结果整理成 36 套独立的 optimization kits。每个 kit 都对应一个固定版本的原始模型,调用方式基本保持原样,只是在运行时选择 exact、fast 或 big 等不同优化模式。
这种方式的好处很直接:研究者不需要换一个新的结构预测模型,而是可以在原有工具上获得更高的运行效率。
速度之外,还有显存
另一个现实问题是体系大小。
今天的结构预测模型处理普通蛋白已经很成熟,但如果预测的是 ribosome、proteasome、respiratory complex 这样的巨大分子机器,显存很快就会成为限制。
Anthropic 因此又让 Claude 优化这部分 memory usage,最终做出了一个低显存的 Big mode。
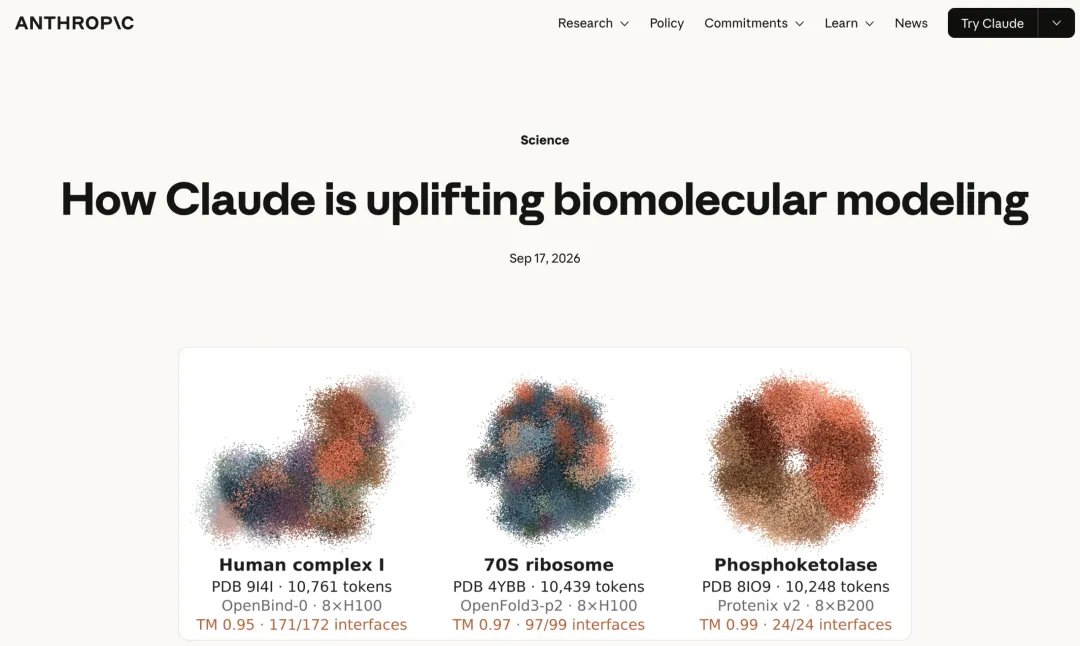
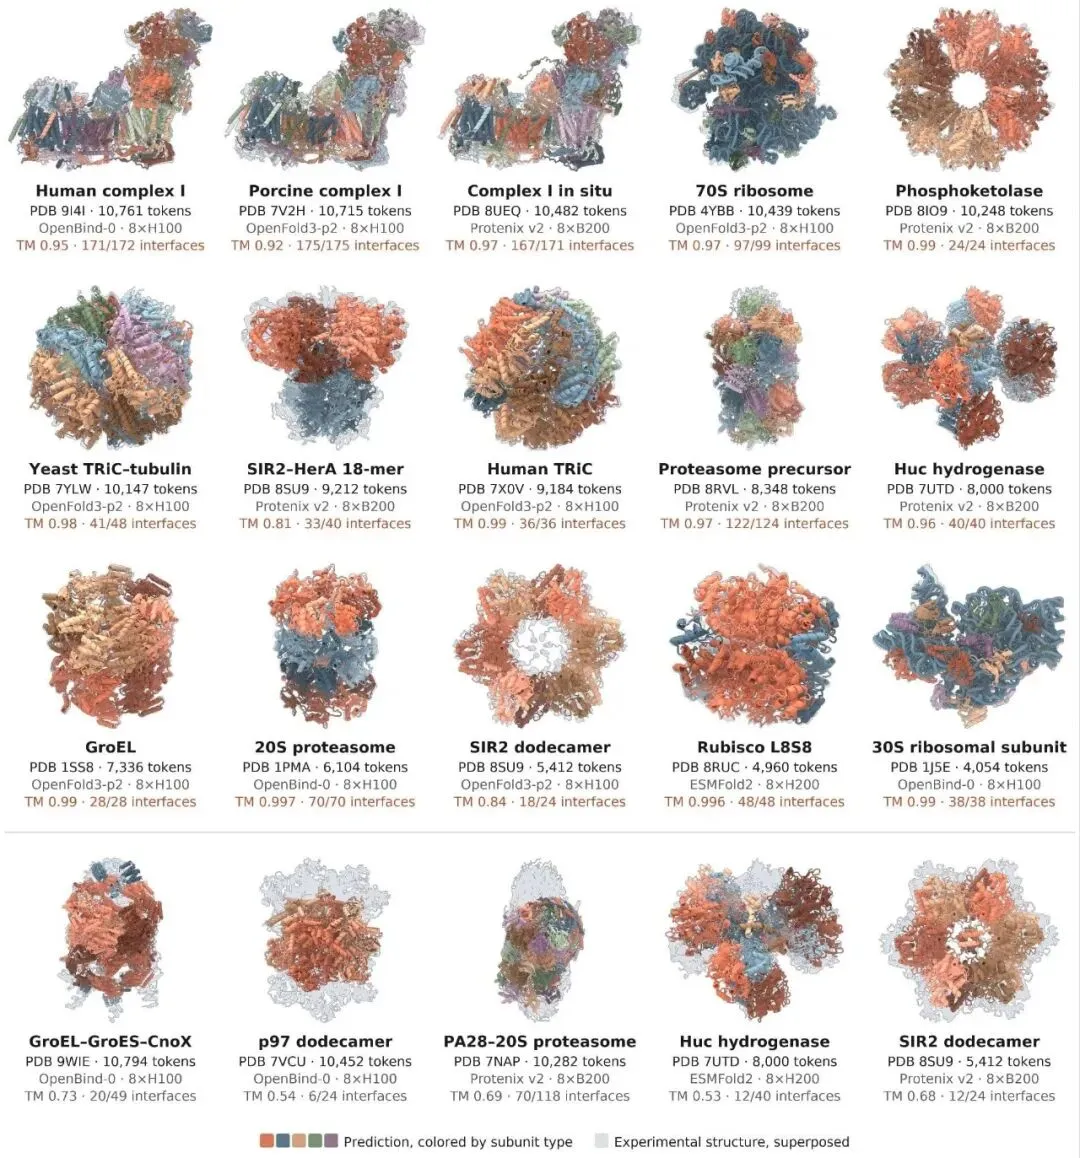
在这个模式下,一些超过 10,000 tokens 的生物分子体系已经可以在单个 NVIDIA GPU node 上完成结构预测。他们测试了 human mitochondrial complex I、TRiC chaperone、proteasome 和 bacterial 70S ribosome,这些大型复合物的预测结果都能够较好地匹配实验结构。
他们随后继续把体系放大到了 31,000–70,000 tokens,包括完整的 viral capsid 和 protein compartment。
这些体系现在已经可以在一个 8×B300 node 上跑完 inference,只是预测出来的结构开始发生 collapse。
这个结果恰好把两个问题分开了。
以前面对这么大的体系,首先遇到的是:
机器跑不动。
现在模型至少能够跑起来以后,真正的问题就暴露出来了:
模型本身有没有学会如此大尺度的分子组织规律?
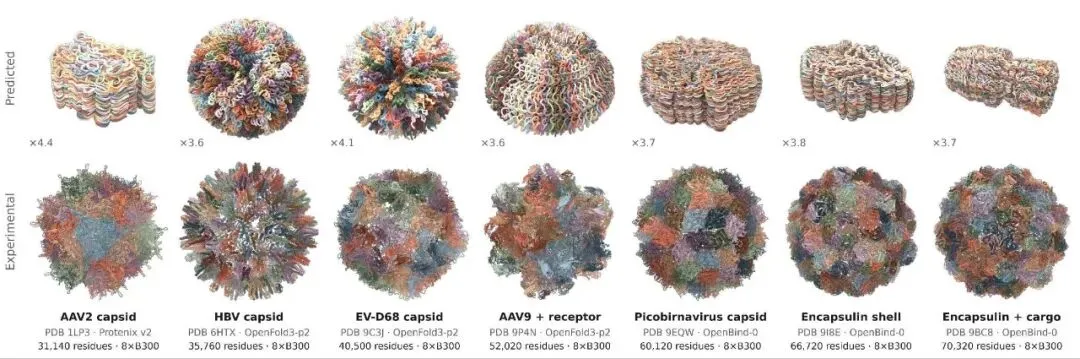
工程瓶颈被往后推了一步,模型能力的边界也因此变得更清楚。
最后又回到了蛋白设计
这些优化最终还是回到了一个月前那项 protein design 工作。
上一次 Claude 可以使用 sub-agent,并且针对每个 target 消耗最高约 2500 个 H100 GPU hours。这一次,条件被压缩了很多:一个 Claude model、一张 H200、24 小时,没有 sub-agent,也没有人在中途指导设计。
Anthropic 在 16 个 targets 上重新进行了实验。按照 ipSAE 这个 in silico binding metric,新的 workflow 可以达到此前大规模 campaign 相近的计算结果,但 GPU 使用量下降了大约两个数量级。GPU 和 Claude token 的总成本加起来,大约 150 美元。
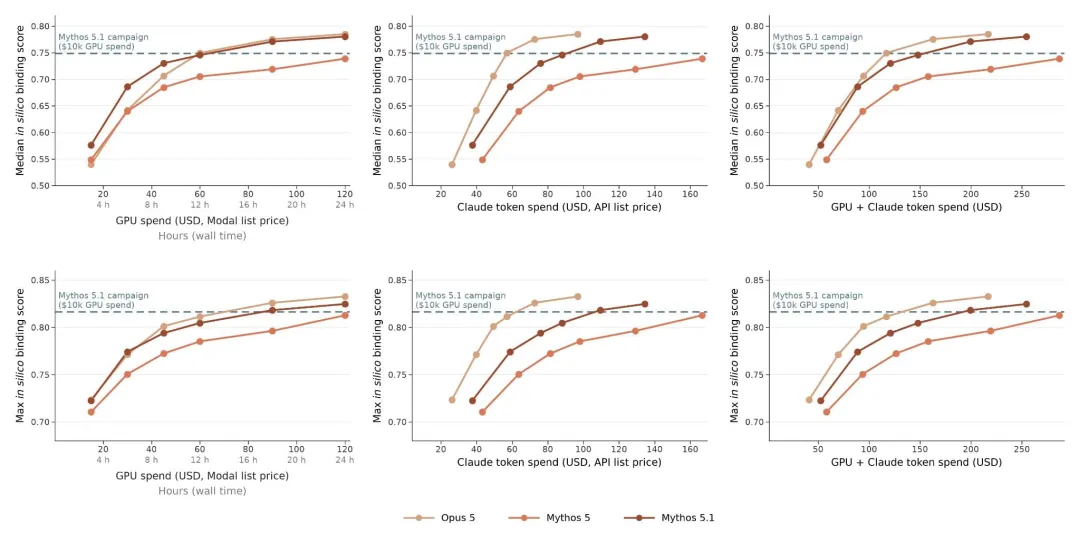
一个月前 Anthropic 展示的是,Claude 已经可以组织多个专业模型,完成 protein design。这一次解决的是另一个问题:如果这些模型太慢、太贵,能不能进一步把整个计算工具链跑得更高效。
从目前的结果看,这条路线已经开始成立。
Scientific Agent 可能还会多一个角色
以前我们谈 Scientific Agent,更多想到的是让 AI 阅读论文、写代码、调用 AlphaFold、跑 docking,或者帮研究者组织一个复杂 workflow。
这项工作又多出了一层:
它开始参与优化科研软件本身的运行效率。
一个新的 protein design model 开源以后,研究者最关心的当然还是模型能力。但真正把它放进实验室 workflow,经常还要经历另一套过程:profile 哪些部分最慢,找显存瓶颈,优化 kernel,缓存重复计算,再针对自己的 GPU 调整运行方式。
这些工作很重要,却高度工程化,而且每个新模型都可能重新做一遍。
如果未来 Agent 能够读懂一个完整的 repository,理解模型的计算图,再自动找到其中昂贵的算子和冗余计算,scientific software 从“论文代码”走向“真正可用的工具”的速度可能会明显加快。
AI4S 里的 Agent 所处的位置,也因此在继续往外扩。
它先学会了使用科学模型,现在又开始参与优化这些科学模型的计算过程。
模型还是那些模型。
但它们开始变得更快、更便宜,也更容易真正进入科研工作流。
最近我也在看工作机会,如果有需要既了解结构生物学,又有实际的Protein design(mini-protein binder, peptide, nanobody)全流程应用经验,又能做模型开发的人,可以联系我:andyliu121510@gmail.com.