ARTICLE · 1044788
AI Infra PTA专题(十二 A)
第 12A 章 · NPUGraph 捕获、重放与私有内存池
一、为什么需要图重放
[入门]
先看被优化掉的到底是什么。Eager 模式下每个算子都要走一遍:Python 调用 → 分发器(Dispatcher)查表 → 适配层组包 → 计算 workspace → TaskQueue 入队 → Dequeue 线程调 aclnnXxx → 驱动下发(这条链路见 第 04 章 与 第 09 章)。这套开销是每次迭代重复付一遍的,且几乎与算子本身的计算量无关。
于是形成一个简单的判据:当单个 kernel 的设备执行时间短于 CPU 下发它所需的时间时,设备就会在 kernel 之间出现空隙,整个模型被 host 拖住。图捕获做的事是把这一整串下发动作录下来,之后每次迭代只提交一次 aclmdlRIExecuteAsync。
仓库文档 docs/zh/developer_notes/npugraph.md 给出的适用场景清单是:
注意最后一行:文档写的「仅支持 aclnn 算子入图」在代码里是有硬检查的,不是建议。反过来,大 batch、长 kernel 为主(比如单个 GEMM 就跑几毫秒)的负载,图重放省下的 host 时间会被完全掩盖,收益接近于零——这类场景先去看 第 13 章 的读图方法确认瓶颈到底在不在 host,再决定要不要付出图的约束成本。
二、三阶段机制
[进阶]
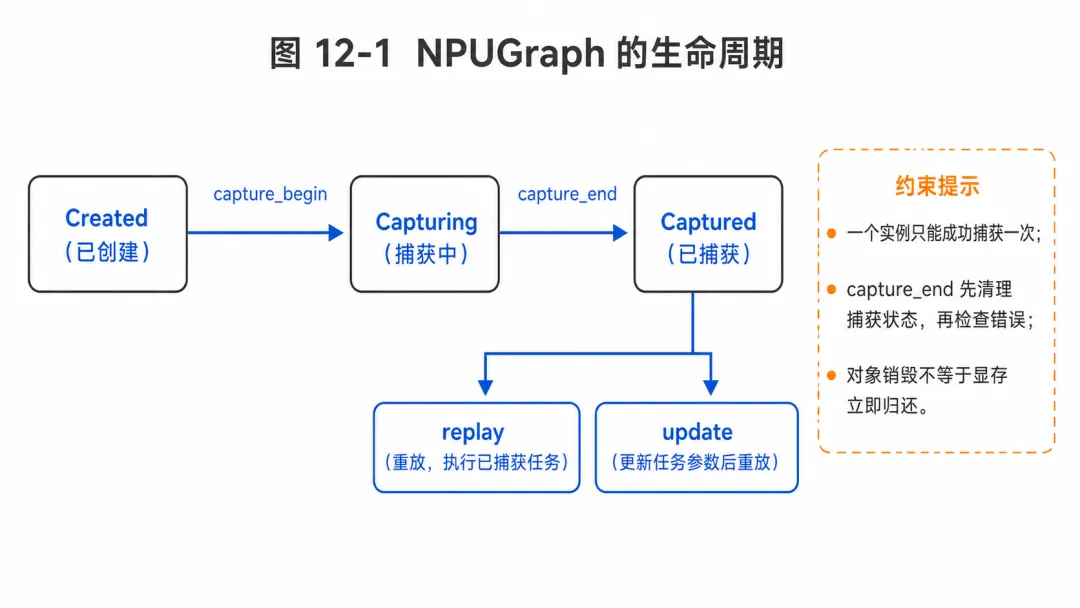
图 12A-1:replay 与 update 都发生在已捕获状态;它们不会让实例重新进入捕获阶段。
这张状态机有三个细节值得盯住。第一,Captured 是一个吸收态:replay / update / super_kernel_optimize 都是自环,一个 NPUGraph 实例一辈子只能捕获一次——capture_begin 开头就有 TORCH_CHECK(!has_graph_exec_, "This NPUGraph instance already owns a captured graph. To capture a new graph, create a new instance.")(torch_npu/csrc/core/npu/NPUGraph.cpp)。第二,从 Capturing 回退到 Created 的那条边是「失败路径」,而 capture_end() 特意把清理动作排在错误检查之前(NPUGraph.cpp):先 markCaptureEnd、先从 _currently_capturing_graphs 里摘掉自己、先 endAllocateToPool,最后才 NPU_CHECK_ERROR(endCaptureErr)。注释写得很直白——这样 watchdog 侧的检查就不会观察到残留的「capture active」状态。第三,Destroyed 不等于内存归还,releasePool 只是把 use_count 减一并在归零时把池标记为 freeable,真正的 aclrtFree 要等后续的 free_cached_blocks 才发生(第四节展开)。
与 CUDA Graph 的对照
cudaStreamBeginCapture | AclmdlRICaptureBeginAclmdlRICaptureEnd(NPUGraph.cpp) | ||
cudaGraphExec_tcudaGraphLaunch | aclmdlRIAclmdlRIExecuteAsync(NPUGraph.cpp) | NPUAcceleratorGraphImpl::instantiate() 是空函数(NPUGraph.cpp) | |
cudaStreamCaptureMode | aclmdlRICaptureModeglobal / thread_local / relaxed(Graph.cpp) | ||
cudaGraph | PrivatePoolbeginAllocateToPool(NPUCachingAllocator.cpp) | ||
PhiloxNpuStateNPUGeneratorImpl.cpp) | |||
begin_capture_to_if_nodeend_capture_to_conditional_node(NPUGraph.cpp) | |||
| 算子参数热更新 | graph_task_group_begin/endgraph_task_update_begin/end + handler 注册表 | NPU 独有 | |
| super kernel 优化 | super_kernel_optimize(optimize_options, debug_options)graphs.py) | NPU 独有 | |
| 图内张量 dump | npu::print_npugraph_tensornpu::save_npugraph_tensor(graphs.py) | NPU 独有 | |
| 图形态导出 | cudaGraphDebugDotPrint | debug_dumpAclmdlRIDebugJsonPrint + .aligned.json(graphs.py) | |
NPUGraphsUtils.h) | |||
TASK_QUEUE_ENABLE=2NPUGraph.cpp) |
后三分之一的表格就是本章相对「照搬 CUDA Graph 经验」的全部增量。尤其 update 机制:CUDA Graph 里改参数要走 cudaGraphExecKernelNodeSetParams 一类的图节点级 API,而 torch_npu 走的是 CANN 的 task group 语义,配合一套 Python 侧的 handler 注册表,把「哪个算子的第几个参数在重放前需要刷新」做成了声明式的表。
capture_begin 的前置检查
capture_begin(pool, capture_mode, report_shape)(NPUGraph.cpp)在真正调用 AclmdlRICaptureBegin 之前连做五道检查,每一道都对应一类真实事故:
TASK_QUEUE_ENABLE != 2 | 1/0 | |
!pin_memory_expandable_segments() | ||
!has_graph_exec_ | ||
checkNotExternalStream | ||
stream != getDefaultNPUStream() | 必须在非默认流上捕获 |
第二条的报错文案值得整段读一遍——它明确说明后果是「data corruption on graph replay」,也就是本章开头说的「不报错只是结果不对」的典型来源;好在这一条被前置成了硬检查。
紧接着是 apply_cache_op_info(stream, report_shape)(NPUGraph.cpp):Python 侧 NPUGraph.capture_begin 固定传 report_shape=True(graphs.py),C++ 侧在 CANN ≥ 8.5.0 时给捕获流打上 ACL_STREAM_ATTR_CACHE_OP_INFO 属性,低版本 CANN 则只打一条 warning 静默降级。这个属性是后续 debug_dump 能拿到算子 shape 信息的前提。
三、内存地址固定这条铁律
读者要点
这是本章最需要写足的一节。规则一句话:捕获期间分配到的每一个设备地址,在重放时都原样复用;重放只是把录好的 kernel 序列按录制时的指针参数重新执行一遍。图里根本不存在「输入张量」这个概念,只存在「录制时那些地址上的字节」。
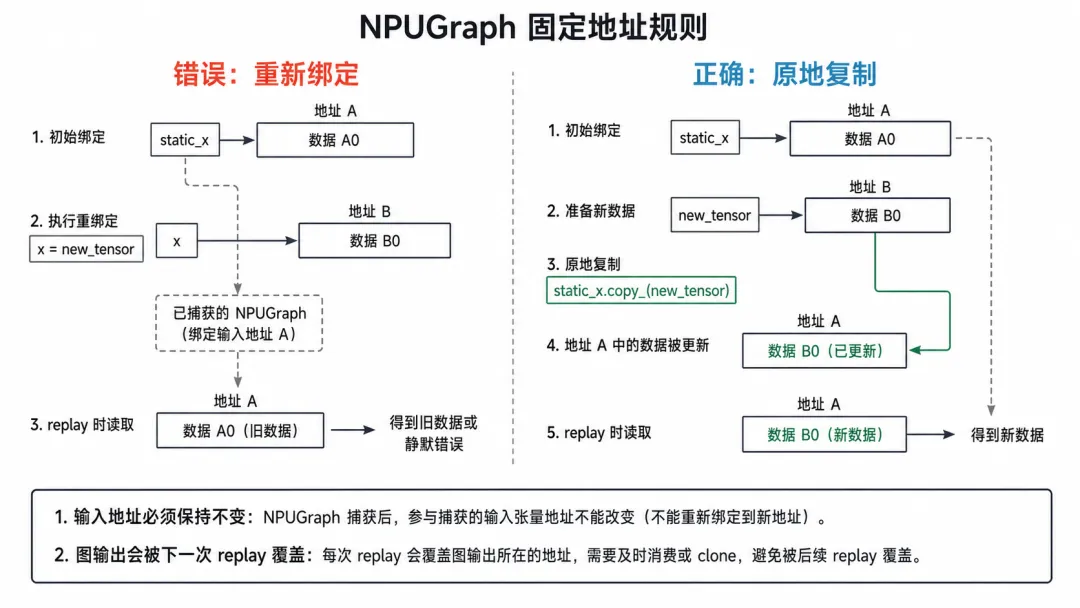
图 12A-2:Python 变量重新绑定不会修改图记住的地址;copy_ 才会把新数据写入原地址。
于是所有 Python 侧的重新绑定都是无效的:
# 错误:只是让 Python 名字 x 指向了一块新显存,图仍然读旧地址x = torch.randn(N, D, device="npu") # 假设捕获时用的就是这个 x...x = next_batch # 图完全不知道这件事g.replay() # 算的还是上一轮的数据# 正确:把新数据写进图记住的那块地址x.copy_(next_batch)g.replay()图里最该盯的是 BAD 分支没有任何一条边指向报错。重新赋值在语义上完全合法:新张量正常分配、旧张量因为还被图的私有池持有而不会被回收,replay() 正常返回,输出张量也照常有值——只不过那个值是拿捕获时的输入算出来的。这类问题在训练里表现为 loss 从某一步开始纹丝不动或诡异地平滑,在推理里表现为不同 request 返回同一个结果。排查的第一个动作永远是:把喂进去的每个张量的 data_ptr() 和捕获时记录的值比一遍。
第二个要点是输出张量。replay() 之后拿到的输出,其存储就是图私有池里那块地址,下一次 replay() 会原地覆盖它。所以要么在下次重放前把它 .clone() 出来,要么保证消费它的逻辑在下次重放前跑完。
仓库文档 docs/zh/developer_notes/npugraph.md 对这条规则的表述与代码一致,措辞是「捕获阶段分配的张量内存地址在重放时保持不变……必须通过 copy_() 将新数据写入捕获时占用的内存地址,而不能直接对张量重新赋值」。
make_graphed_callables 怎么自动兜底
高层 API make_graphed_callables(graphs.py)把这件事包掉了。它的做法很朴素:捕获时把「静态输入面」(用户 args 展平 + module 的 parameters,graphs.py)记下来,运行时在 autograd Function 的 forward 里逐个比对指针,只有指针不一致时才 copy_:
for i in range(len_user_args): if static_input_surface[i].data_ptr() != inputs[i].data_ptr(): static_input_surface[i].copy_(inputs[i])fwd_graph.replay()反向同理,对 static_grad_outputs 做同样的指针比对与 copy_;如果输入梯度已经位于正确地址,就不会重复复制。关键结论是:检测到 data_ptr() 变化后会自动 copy_(),因此调用方可以复用输入对象而不必手动维护地址。
顺带说清这个 API 的其它几条硬约束,都是 make_graphed_callables 开头直接 raise 的:autocast 缓存必须关(cache_enabled=False,graphs.py);传入的 nn.Module 在传入时不能挂任何 hook(传完之后再注册是允许的,graphs.py);buffers() 必须全是 requires_grad=False(graphs.py);sample_args 展平后必须全是 Tensor(graphs.py)。另外它会先跑 num_warmup_iters(默认 3)次 warmup,且明确注明 DDP 需要 11 次(graphs.py)。
多个 callable 一起传进来时,它们共享同一个 mempool(graphs.py),并且捕获顺序被刻意排成「fwd 1…fwd N,然后 bwd N…bwd 1」(graphs.py 的注释解释了原因:共享池的图必须按真实运行顺序捕获,否则重放会互相踩内存)。这是共享池的代价,第四节继续。
四、私有内存池:捕获期间的分配被劫持到哪里
读者要点
捕获期间不能真的调 aclrtMalloc(驱动调用在捕获流上是非法的),也不能让捕获出来的地址被后续 eager 代码复用。缓存分配器给出的答案是 PrivatePool:捕获开始前,把一条「过滤器 + 池 id」压进分配器的 allocation_scopes_,之后所有满足过滤条件的分配都改道进这个私有池。
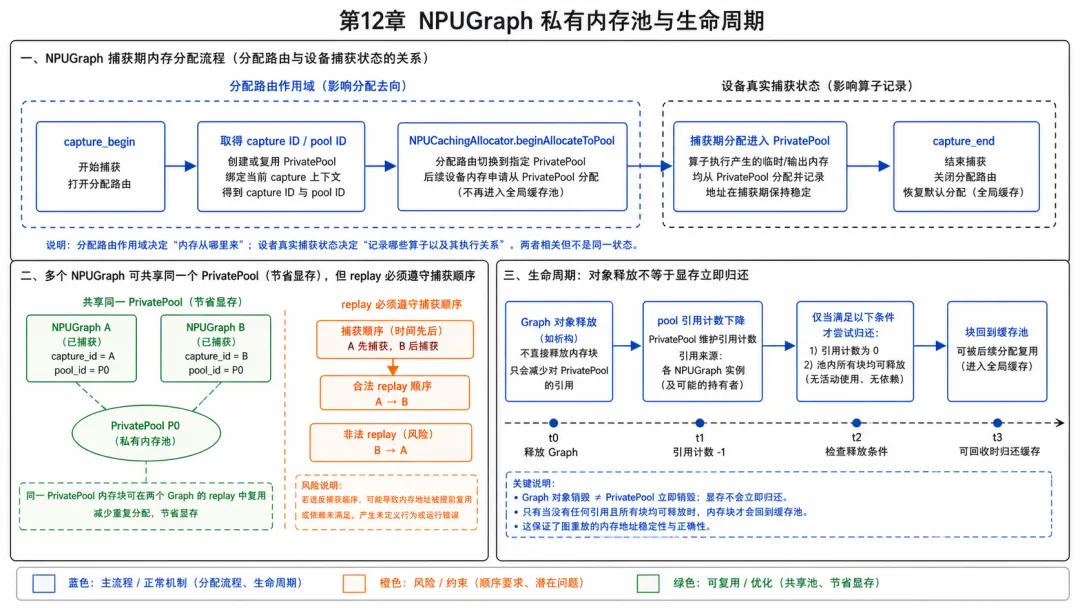
图 12A-3:分配路由作用域与设备捕获状态是相关但独立的机制;共享池还要求重放顺序与捕获顺序一致。
三点解读。第一,过滤器是按 capture id 而不是按流对象比对的(NPUGraph.cpp):create_allocate_filter 返回的 lambda 对传入的 aclrtStream 调 captureIdMayInitCtx,只有当该流正在捕获且 capture id 等于本图的 capture_id_ 时才返回 true。这意味着捕获期间同设备上另一条没在捕获的流照常从默认池拿内存,互不干扰;同时也意味着如果你在捕获块里用了一条没有 wait_stream 依赖到捕获流的旁路流,它的分配不会进私有池——这正是后续 get_currently_capturing_graph() 报错文案里那句「Did you use a stream without making it depend upon the original stream used for capture?」(NPUGraph.cpp)想提醒的事。
第二,beginAllocateToPool 被刻意排在 AclmdlRICaptureBegin 之前,代码里留了专门的说明(NPUGraph.cpp):否则 autograd 线程的一次 free() 可能在「捕获已开始但分配器还不知道」的窗口里与分配器交互。同样的顺序讲究在 capture_end 里反过来出现(先清理再检查错误)。此外从本版本起,host 侧的 pinned 内存分配器也被登记进了同一个私有池(NPUGraph.cpp),这样捕获区里的 pin_memory 才有正确的生命周期——也正是因为这套机制,pin_memory_expandable_segments=True 才必须被硬性拒绝。
第三,池的路由(allocation_scopes_)与「是否真的在捕获」(num_active_captures_)是两套状态。分配器里 markCaptureBegin/End 只维护一个计数器(NPUCachingAllocator.cpp),而 is_capture_context()先看计数器,非零时再对当前流做一次 AclmdlRICaptureGetInfo 系统调用。注释解释得很清楚:use_mem_pool、HCCL 注册、inductor warmup 都会往 allocation_scopes_ 里塞条目,但它们不是真捕获,那些场景下 aclrtEventQuery / aclrtStreamSynchronize 是合法的,不该被误当成捕获而降级。这个区分是本版本相对朴素实现的一处改进。
is_capture_context() 为真时,分配器有两处关键行为变化:一是 free() 时若块有跨流使用,不能插 event(捕获期 npuEventQuery 非法),而是推进 needs_events_deferred_until_no_capture(NPUCachingAllocator.cpp);二是 recordStream() 会额外记一份 block_to_npugraph_stream_uses。另外 release_cached_blocks 在捕获进行中不会去动默认池,synchronize_and_free_events 更是直接 TORCH_INTERNAL_ASSERT(!is_capture_context())。
共享 pool 的收益与风险
pool 参数(graph(g, pool=...) 或 capture_begin(pool=...))让多张图共用一个 PrivatePool。收益显而易见:N 张图各自独占一份中间张量显存是浪费,共享后峰值只按最大的那张算。代价写在 create_or_incref_pool(NPUCachingAllocator.cpp)和 releasePool的注释里:池带引用计数,任意一张图还活着,整池就一块都还不了。
风险则是正确性层面的:共享池意味着两张图可能在同一块地址上工作。只有当它们的执行顺序与捕获顺序一致时,这种复用才是安全的——这正是 make_graphed_callables 要把捕获顺序排成「fwd 1…N, bwd N…1」的原因(graphs.py)。如果你手工共享池又乱序重放,得到的同样是静默的错误结果。经验规则:只在你能完整说清「这几张图在真实负载里以什么顺序执行」时才共享池;说不清就各用各的。
graph_pool_handle()(graphs.py)返回的是一个「第二位非零」的 MempoolId_t,而 capture_begin 自建的池是「第一位非零」(NPUGraph.cpp 有 TORCH_INTERNAL_ASSERT(!(pool.first && pool.second)) 保证二者不混)。这个小设计让分配器一眼能分出池的来源。
graph 上下文管理器在进入前做了什么
torch.npu.synchronize()if force_npugraph_gc: gc.collect()torch.npu.empty_cache()torch_npu.npu.host_empty_cache()(graphs.py)先全设备同步,再按开关做一次 Python GC,然后清空设备与 host 两侧缓存。force_npugraph_gc 由环境变量 TORCH_NPUGRAPH_GC 控制(torch_npu/_compiler/_config.py,默认 False)。文档 docs/zh/api/environment_variable/memory_management/TORCH_NPUGRAPH_GC.md 说明默认值为 "0"、置 "1" 会让捕获性能下降,与代码默认值一致;文档另称「PyTorch 2.7.1 及之后版本设置非 0/1 的值时会取默认值 1」,这一段解析行为由上游 torch.utils._config_module 决定,本文未能在本仓库内核实。
为什么进捕获前要 empty_cache()?私有池的分配走 get_pool 改道后只能从私有池自己的空闲块里找,找不到就得向驱动要新 segment。默认池里囤着的缓存块此时帮不上忙,反而占着 HBM 与私有池争抢,容易在捕获期 OOM——所以先把默认池里未被引用的块还给驱动。gc.collect() 那一步则是为了让「上一轮还没被 Python 回收的张量」尽早释放,进一步压低捕获期占用;代价是 GC 本身很慢,所以默认关闭。
小结
1. NPUGraph 的收益来源是消除 Host 侧逐算子下发开销,适合短算子密集、小 batch、高迭代且 shape 固定的负载;先用 第 13 章 的方法确认瓶颈在 Host。 2. 一个 NPUGraph实例只能捕获一次;replay()复用捕获时记录的 kernel 序列和设备指针,不会重新解析 Python 对象。3. 地址固定是铁律:输入必须用 copy_()写入捕获时的地址,输出若要跨轮保存必须先clone();重新绑定 Python 变量不会更新图中的指针。4. make_graphed_callables用data_ptr()比对和自动copy_()降低手工维护地址的风险,并按真实执行顺序组织共享池中的前向、反向图。5. 捕获期分配经 beginAllocateToPool改道进PrivatePool,过滤器按 capture id 匹配;共享池能降低峰值显存,但要求重放顺序与捕获顺序一致。6. allocation_scopes_负责分配路由,num_active_captures_/is_capture_context()判断是否真正处在捕获中;两者分离避免把 HCCL 注册、Inductor warmup 等场景误判为捕获。
下一篇 第 12B 章 · NPUGraph 动态能力与工程实践 将回答三个进阶问题:哪些参数可以在重放前更新、怎样判断一段代码是否图安全,以及手工 NPUGraph 与 torch.compile(mode="reduce-overhead") 应该怎么选。