ARTICLE · 1045560
写给文科背景学生的AI导论
编者按:面对AI,文科生最容易陷入两个极端:要么把它想成无所不能的新物种,要么把它当成会胡说八道的高级搜索。本文从这些误读讲起,一路谈到大模型原理、技术路线、产业格局、工作流和学习路径。作者不回避技术细节,也保留了不少来自实际使用和产业观察的个人判断,现特此推送,以飨读者。
文章来源:AlexanderWeber,2026年8月22日。
作者简介
薛溢龙
写篇AI主题的文章,受众是文科生吧,主要是我身边的文科生。全文10000字不到点。
当下的人逃不开三件事:呼吸,饮食,AI。在社交媒体与大众舆论中,人工智能以两幅面孔出现:一种是即将觉醒的、最终将抵达AGI图景的硅基生命,支持者计算着人类还有几年好活、是否应该快速折现存量资产;另一种视角下,它是万能神器,三天速成、月入十万、淘汰所有人之类的雷人文案满天飞。而在笔者熟悉的一线场景里,它以第三幅面孔安静运转:有些后台部门用本地部署的模型封装了全部制度文本、重做了全套报表流程、封装了所有案头工作流,过去半个部门的工作量,现在一个人加一套智能体(Agent)工作流即可完成,甚至领导也开始用这套系统,在同样由AI生成的报告上作出拟处理意见、只待真人复核。
同一样东西,三副面孔。ChatGPT 每周有十亿人使用,能讲清其原理的人不多,能讲清产业格局的人更少。在理工科、商科青年已用AI大幅提升工作效率、甚至赚到第一桶金的同时,大量文科生面对人工智能,普遍在两种姿态之间摇摆:恐慌,怕被取代;轻慢,视之为玩具。前者导致丧失判断力,后者则走向自我灭亡之路。事实上,两种姿态看起来不一样,本质却是同源的,即对技术原理、路线和格局的了解匮乏。
本文将仿照大四收获了100多个赞的那篇关于经济学的文稿,依次回答六个问题:对人工智能的误解有哪些;人工智能的技术原理是什么;人工智能的技术路线更迭史;其产业格局如何分布;高效应用人工智能的方法论;更新迭代的合理路径。
一、三个误读
关于人工智能的多数争论,争的不是人工智能本身,是各自想象的幻影。有三个误读最具普遍性。
第一个误读,人工智能具有意识。科幻叙事给公众留下的默认印象是:既然称为智能,必有意识、有意图,值得追问它“想干什么”。事实层面,今天全球运行的所有大模型(Large Language Model, LLM),没有一个得到科学证据支持具有意识。(关于这个问题,我用AI专门写了一本书在认识论、心智结构与脑科学等方面归纳了有关讨论和我的思考。其实我的真实观点更加激进,就是意识不是什么很特别的东西,只是在一定选择压力下涌现出来的一套行为策略模式,无论是自然选择,还是物理系统在随机微观向中宏观的演化,本质上都差不多(后一条比较匪夷所思,这里也没办法展开解释,先按下不表)。换言之,如果你能像哥白尼一样找到正确的外生约束与公理,你同样可以训练出低能耗高性能的所谓“意识”)它做的事情一句话可以讲清:预测下一个词(next-token prediction)。这个定性不是贬低,而是校准。预测词的能力做到极致,足以写出论文、代码与合同,但这与“心里在想什么”是两回事,与形式上的自由意志还是有很大出入的。
第二个误读,大模型等于高级搜索。不少文科背景的读者认为,大模型无非检索资料后拼凑答案,与搜索引擎没有本质区别,进而基于他们使用网页豆包、翻墙使用Gemini(这算很高级了)的贫乏经验,得出一个结论:AI只会胡说八道,靠不住啊!先不说这种观点是否符合事实,至少在原理上,搜索和大模型生成语言区别就是根本性的。搜索是检索既有文本,将别人写好的内容找出来;大模型生成语言则是在海量训练语料中压缩出规律,再按规律生成(准确来讲是“涌现”)出此前不存在的文本。它能写出行家水平的代码,能完成连续十步的多步推理,能操作浏览器执行整套任务流程。这些能力没有一项能用检索解释。
第三个误读,人工智能万能。很多工程师都抱有这种看法,但这是站不住脚的。真实工程中它有三个难以消除的硬约束。一是幻觉(hallucination):模型输出的永远是统计意义上最可能的词,而非查证过的事实,虚构判例、编造数据的情况无法根除,只能靠流程校验压制,或者限定为本地知识库加上一定限度的泛化。二是成本:旗舰模型训练一次动辄数亿美元,日常使用按 Token(模型处理文本的最小单位,约等于半个到一个汉字)计费,大规模调用的推理费用相当可观。现在个人用户一般都订套餐了,意义主要是给企业后台贡献数据和工作流,企业主要靠toB业务赚大钱(或者靠IPO赚特大钱)。三是可靠性:长链条任务中误差逐步累积,十步任务每步九成五的把握,总体成功率只剩约六成,当然这个数据比较老了,现在loop工程和graph工程正慢慢解决有关问题,或许可以大幅优化。2026 年实际落地的人工智能形态是人机协同:模型承担主体工作,人负责发起、校验与兜底。全自主智能体仍是远景,凡宣称已经实现者,其说法需要打折扣。
二、技术原理:从预测下一个词到智能体
大模型没有神秘主义成分,它是一项可以完整拆解的工程系统。拆开来看,共有六个环节。
图1 大语言模型技术原理总览
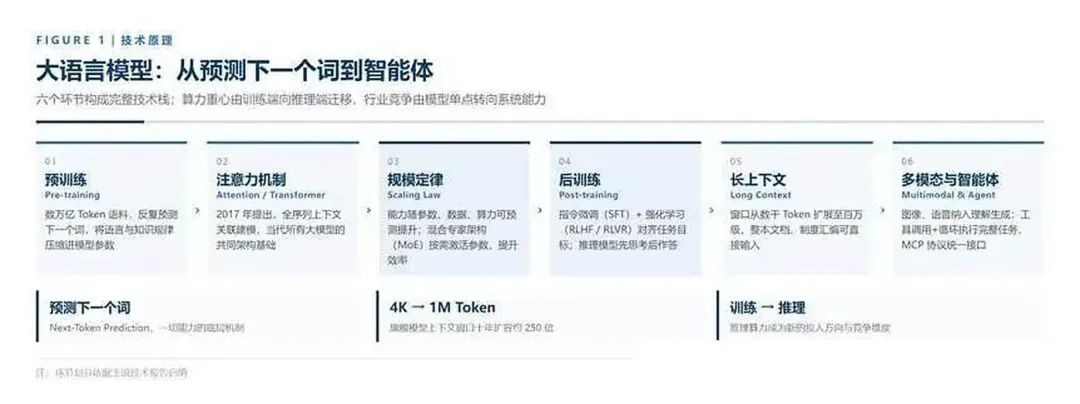
第一环节,预训练(pre-training)。模型上岗前要读数万亿 Token 的文本。这是什么体量:一个人一天读十万字,读到八十岁约三亿字,旗舰模型的训练语料是这个数字的数万倍。训练方式不是背诵,而是反复预测下一个词、对答案、修正参数,将语言规律和知识压缩进模型。今天旗舰模型的参数规模以千亿计,Kimi K3 已开源至 2.8 万亿参数,是全球首个达到该量级的开源模型。
第二环节,注意力机制与 Transformer 架构。2017 年,八位作者在论文Attention Is All You Need中提出Transformer,此后所有大模型均由此发展而来。它解决的核心问题是上下文关联:读到"苹果发布新手机"时,模型据全句信息判断此苹果指公司而非水果。全部当代人工智能同源同宗,起点都是这篇论文。
第三环节,规模定律(Scaling Law)。2020 年前后,研究者确认模型能力随参数量、数据量、算力投入按可预测规律提升。这条定律是全行业资本开支的理论依据:OpenAI 到 2029 年累计支出计划约 1150 亿美元,阿里宣布未来三年投入超 3800 亿元人民币建设云与人工智能基础设施。投入产出的关系可以计算,资本才敢于下注。这一环节的重要旁支是混合专家架构(Mixture-of-Experts, MoE):模型内部设数十至数百个专家模块,每次推理只激活其中一部分,以更少的计算量达到稠密模型的效果。DeepSeek 在此路线上做到行业前列,是中国效率路线的代表性技术。此外,因为我国受到芯片管制、算力资源匮乏,所以过训练技术路线也是比较常见的。
第四环节,后训练(post-training)。预训练完成的模型掌握大量知识,但不熟悉具体任务,需要两步对齐。指令微调(Supervised Fine-Tuning, SFT)教它理解并执行指令;基于人类反馈的强化学习(RLHF)以及基于可验证奖励的强化学习(RLVR)教它将事情做对。2025 年初,DeepSeek 发布 R1 模型,证明纯强化学习足以训练出深度推理能力,且以 MIT 许可证开源,引发全球关注。此后推理模型(reasoning model)成为行业标配:回答前先生成推理步骤(思维链,chain-of-thought),以更长的计算时间换取更高的准确率。算力投入的重心由训练端转向推理端,这是范式级变化。
第五环节,长上下文(long context)。早期模型一次只能处理数千 Token,当前旗舰模型的上下文窗口已达百万 Token,可一次输入整本制度汇编或整年案卷。GLM-5.2 主打百万 Token 的项目级任务处理,GPT-5.6 系列按任务复杂度自动分配快答与深思两档算力。但长上下文也往往意味着开发效率等受一些损失,因此需要合理规划。
第六环节,多模态与智能体。这是近两年的演进主线:模型从会说走向会做。多模态(multimodal)将图像、语音纳入理解与生成范围。智能体(Agent)则赋予模型执行能力:模型加工具调用、加循环,可以查资料、写文件、操作浏览器、调用程序接口,逐步完成完整任务。2024 年 Anthropic 发起的模型上下文协议(Model Context Protocol, MCP)正在统一模型与外部工具的接口标准,行业内比作人工智能领域的 USB-C,即一次接入,处处通用。一件比较好笑的事是,控制众多变量(尤其是成本),似乎不难发现,在多模态上有所建树的模型(比如豆包、Gemini和搞笑大厂Minimax,还有被日常鞭尸的Qwen3.8)推理能力不咋样,这个吊诡的现象笔者和很多人讨论过,暂时得不出特别好的解释。当然,笔者倾向于coding is everything技术路线,即通过推理编程模型走向初级AGI,多模态暂时看起来确实比较像玩具和工具——其实没准以后梁子在通向AGI的路上顺手就把多模态解决了也说不定hhh,勇攀高峰沿途下蛋嘛。
六个环节合起来,当前人工智能的技术全貌是:一个读遍人类公开文本、经过任务对齐、会先思考后作答、能处理百万 Token 输入、可以调用外部工具的系统。关于"预测词为何能产生智能",业内通行的解释是涌现(emergence):能力在规模跨过特定阈值后出现,训练者自身也无法完全解释。可见剥去神秘化外壳,道理与文献学颇有相通之处,单条记录无意义,亿万条记录相互印证,规律自动显形。这跟法学、历史学经常讲的什么格式塔主义、整体把握文本颇为相似。
三、路线沿革:七十年与四场争论
我学习任何学科,都有很强烈的历史主义倾向。上手可以让你了解今天,但了解昨天有利于更好预测明天。AI至今走过了整整七十年,技术爆发不过是最近三四年的事,虽然LLM-coding是主流路线,但其他路线也并没有被判死刑(比如单层神经网络其实50年代就有了,六十年代在数学上被搞了个所谓的证伪,沉寂了几十年,现在又被证明是正道),千万不能太狭隘。日本搞产业政策很超前,但每次就是个赌,赌到最后一无所有,应当引以为鉴。
图2 七十年技术路线沿革与四场争论
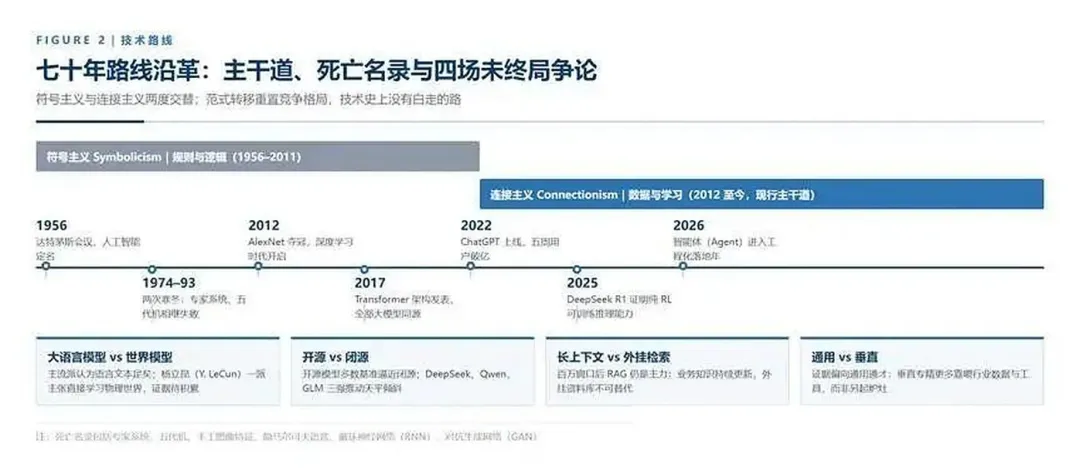
"人工智能"一词最早于1956 年达特茅斯会议提出。此后七十年,主干道先后由两个学派主导。前一阶段是符号主义(symbolicism):将知识写成规则,让机器按逻辑推理办事。这条路线产出过专家系统,也催生过日本 1982 年的第五代计算机计划(冷知识是王小波以前也搞过人工智能,还搞得不错,认识了钱学森),但规则无法覆盖真实世界的复杂性,维护成本压垮收益,行业两度进入寒冬,经费断供、人才流失。后一阶段是连接主义(connectionism):不写规则,让模型从数据中自行学习。此路长期受压制,直到 2012 年 AlexNet 在图像识别大赛中大幅领先所有规则方法,深度学习时代开启;2016 年 AlphaGo 战胜李世石,2017 年 Transformer 发表,2022 年底 ChatGPT 上线,五周用户破亿。
七十年间被淘汰的技术路线值得专门记录,遴列如下:专家系统败于维护成本,第五代机败于路线误判,手工图像特征被深度学习整体替代,隐马尔可夫模型的语音识别被端到端方案替代,循环神经网络(RNN)被 Transformer 淘汰,红极一时的对抗生成网络(GAN)被扩散模型(diffusion model)取代。规律清晰:多数情况下技术本身没有错,错在其依赖的前提;前提改变,再精巧的体系也会整体失效。值得注意的是,符号主义的多个成果此后以新形式回归:知识图谱成为检索增强的地基,专家系统的知识库思想重生为外部资料库。技术史上没有白走的路,只有提前走的路。
当前牌桌上仍有四场争论没有终局,可概括为四。第一场,大语言模型与世界模型之争:主流路线认为读遍人类文本足矣,图灵奖得主杨立昆(Yann LeCun)一派主张机器必须直接学习物理世界,其证据正在自动驾驶与机器人仿真中积累。第二场,开源与闭源之争:闭源阵营重金独守前沿,开源阵营以 DeepSeek、Qwen、GLM 为代表,以开放换生态;截至 2026 年,开源模型在多数基准上已逼近闭源。第三场,长上下文与外挂检索之争:百万 Token 窗口是否使检索增强生成(RAG)失去必要?实践答案是仍然必要,业务知识持续更新,任何窗口都装不下。第四场,通用与垂直之争:现有证据偏向前者,行业专精更多依靠向通用模型输入行业数据与工具,而非单独训练垂直模型。
观察这四场争论,与其站队,不如记住三条判断范式:淘汰的是前提而不是技术;胜负手是工程可扩展性;范式转移之时,竞争格局一律重置。以此读行业新闻,噪音自动过滤,大事自然浮现。
四、产业格局:四层结构与价值迁移
AI竞赛的产业链分四层:芯片是算力层,云是基础设施层,模型是能力层,应用是产品层。分层看,格局一目了然。
图3 四层产业结构与价值迁移
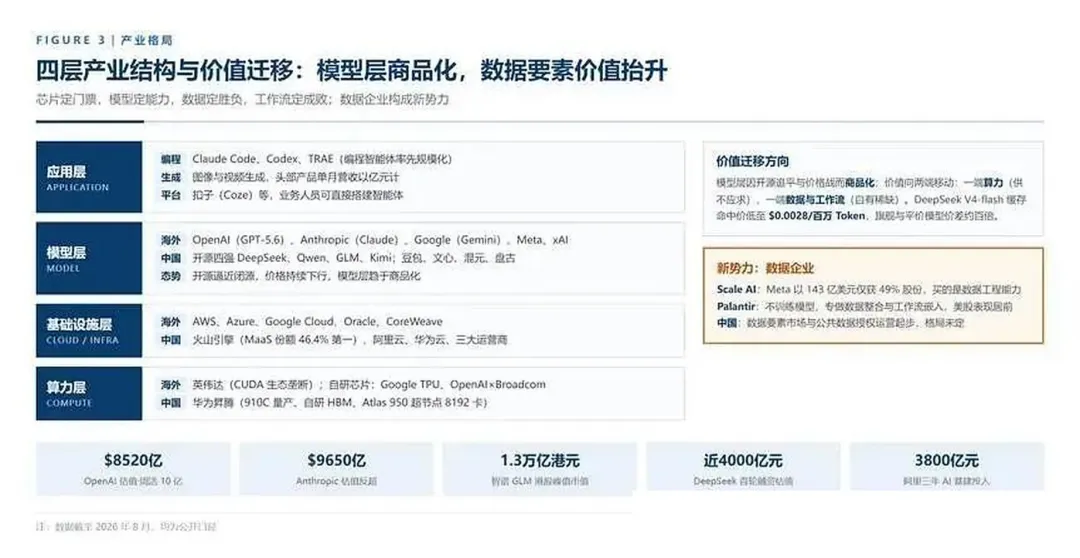
算力层可概括为一张门票两种玩法。英伟达是全球人工智能算力的主要供给方,其 CUDA 软件生态构成护城河,OpenAI、Anthropic、xAI 的训练集群均以其芯片为主力;OpenAI 与 Broadcom 合作的 3 纳米自研芯片 2026 年量产,意在降低这层依赖。中国一侧,华为昇腾是国产算力主力:910C 已量产,950PR 起采用自研 HBM(高带宽内存),Atlas 950 超节点将 8192 张卡互联为一个整体,官方口径互联带宽超过全球互联网峰值。科大讯飞星火模型是全国产算力训练的代表,公开口径性能达 GPT-5 的九成半以上(当然具体怎么样请读者自行判断,我不打算给自己惹任何麻烦)。
模型层海外,五家各占一个身位。OpenAI 持有闭源旗舰与大众品牌:GPT-5.6 系列 2026 年 8 月发布,分三档定价,ChatGPT 周活十亿,估值 8520 亿美元,年度运营亏损 80 至 90 亿美元,已秘密递交上市申请;巨额营收与巨额亏损并存,是这一代人工智能公司财务面貌的标本。Anthropic 战略最清晰:不争最大模型,专做智能体基础设施,其发起的 MCP 协议已成行业事实标准,属于典型的生态卡位:可以不用它的模型,但很难绕开它的协议;其估值 9650 亿美元,已反超 OpenAI。Google 是唯一全栈自研者,从 TPU 芯片、Gemini 模型到搜索、YouTube、安卓的分发渠道全部自有,Gemini 4 预训练已经启动。Meta 于 2025 年以 143 亿美元收购数据公司 Scale AI 的 49% 股份,随后放弃 Llama 开源路线转向新系列,其中深意下文再表。xAI 并入 SpaceX,Colossus 超算集群超百万卡,叠加 X 平台实时数据,走垂直整合路线。
模型层中国,四个梯队。第一梯队是开源四强:DeepSeek、通义千问(Qwen)、智谱 GLM、月之暗面 Kimi。DeepSeek 出身量化基金幻方,创始人梁文锋,V4 系列定价一度低于国际同级两个数量级,2026 年 6 月首轮融资约 510 亿元、估值近 4000 亿元,超过 20 家央企接入部署,国家人工智能产业投资基金直接入股;其代表的效率路线,在算力受限条件下以架构创新换效率,多项成果已输出为全球行业实践。智谱 GLM 依托清华,2026 年初登陆港交所,市值一度突破 1.3 万亿港元,是国央企私有化部署的主流选项。第二梯队是互联网巨头:字节跳动豆包日活破亿,火山引擎在中国公有云大模型服务(MaaS)市场份额 46.4% 居第一;阿里通义开源尺寸最全,人工智能相关收入连续 11 个季度三位数增长。第三梯队是国家队:华为盘古加昇腾构成唯一完整国产全栈,讯飞深耕教育与语音,星火开发者超 229 万。第四梯队出海:MiniMax 海外收入占比 73%。
应用层,编程赛道最成熟,相对来讲也比较靠谱。Claude Code、Codex、TRAE 等编程智能体已能独立完成中等规模软件任务;图像与视频生成的头部产品单月营收以亿元计;扣子(Coze)等平台让业务人员不写代码即可搭建智能体。应用层的竞争重心不在技术,在场景理解,这是文科生的机会窗口。
格局中特别、尤其、在近期值得注意的变量,是数据企业正在异军突起。其一,Meta 以 143 亿美元仅获得 Scale AI 的 49% 股份,交易标的正是数据标注与数据工程能力:模型架构写在公开论文里人人可得,高质量数据才是稀缺资源。其二,Palantir 不训练旗舰模型,专注数据整合与工作流嵌入,为政府和企业治理数据、对接决策流程,成为近年美股表现最突出的公司之一,不造大脑,只做大脑与组织之间的接线,同样可以形成高价值企业。事实上,笔者作为旁观者接触过中国数据市场的形成发展,对近期发生的一些问题也有自己的思考。该说不说,你不能指望一群素质相当一般的外行搞好产业发展,一定得从机制体制上更好发挥企业作为创新主体的作用,这一点文章最后再说。其三,模型层正在快速商品化:开源逼近闭源,价格持续下行,DeepSeek V4-flash 缓存命中价低至每百万 Token 0.0028 美元(但是小难梁最近涨价了,ds又跌得粉碎了),旗舰与平价模型之间隔着约百倍价差。三个事实指向同一判断:价值正从模型层向两端迁移,一端是算力,一端是数据与工作流。手握独有数据、能够持续迭代、来源可信合规的企业,将构成下一批赢家。国内数据要素市场与公共数据授权运营刚刚起步,这一页尚未翻开。笔者对数据企业的偏爱,即建立在这个判断之上:模型是公共品,数据是私产;算力可以采购,数据只能自有。
五、应用方法论:三要素框架
高效应用人工智能,从来不是采购一个模型就能解决的问题。它可以写成一条公式:大型控制框架,加优质可迭代可信数据源,加清晰稳定工作流。三要素,缺一即废。
图4 高效应用人工智能的三要素框架
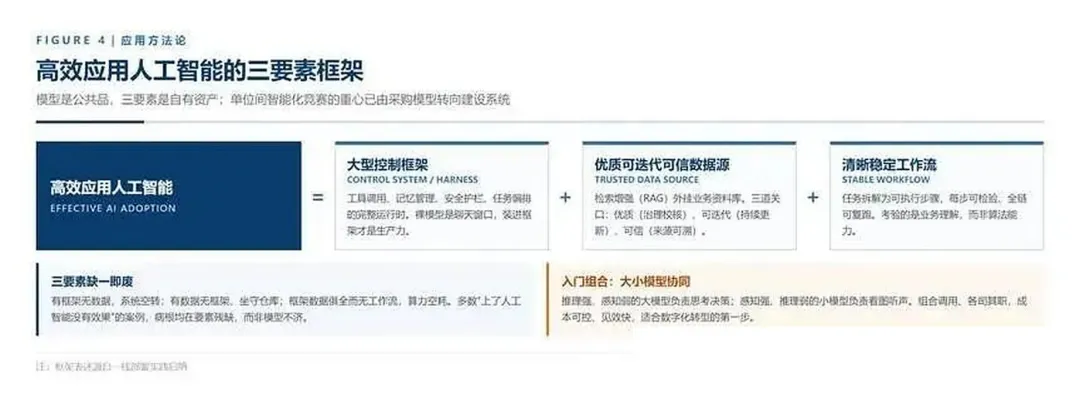
第一个要素,控制系统。模型本身不是产品,正如发动机本身不是整车:同一台发动机,装进不同底盘,是完全不同的两辆车。控制框架(业内称 harness)就是底盘,包括工具调用、记忆管理、安全护栏、任务编排等完整运行时。2026 年的业界共识已经清晰:模型能力由厂商作为公共品提供,控制框架才是使用者自有的工程资产。产业动向可以佐证:头部厂商的发布重心正从单个模型转向系统级产品,OpenAI 讲统一系统,Anthropic 讲智能体基础设施。原因在于单点模型能力的差距在收窄,系统能力的差距在拉开。对使用者而言,这层工程直接决定模型是聊天窗口还是生产力工具。
第二个要素,数据。模型只读过训练截止日之前的公开文本,具体单位的业务细节它一无所知;询问本单位沿革,输出结果往往比事实更流畅。补足的办法是检索增强生成(RAG):为模型外挂一个随查随用的资料库,答题前先检索,以自有资料作答。技术上此事不复杂,门槛全在数据本身。合格的数据源要过三关:优质,经过治理,结构清晰,错漏有校;可迭代,能随业务持续更新,静态资料库三个月后就是陈年档案;可信,来源可靠,出处可溯。数据治理的行业经验在这里完全适用:输入质量决定输出上限。
第三个要素,工作流。将一项任务拆解为模型能够稳定执行的步骤,每步可检验,全链可复跑。举一个一线实例:某单位训练智能体做报表合并,以历史表格为输入、历史成稿为标准答案,令程序反复生成、逐条比对,数十条业务规则在比对中逐一理顺,最终实现稳定产出。关键在八个字:步骤明确,不留模糊;同一输入,必得同一输出。工作流是三要素中技术含量最低的一个,却往往见效最快,因为它考验的不是算法,是对业务的理解。这恰是文科生可以主导的环节。
三要素的关系可概括为,有框架无数据,系统空转;有数据无框架,坐守仓库;框架与数据俱全而无工作流,算力空耗。实际工作中多数"上了人工智能没有效果"的案例,病根都在要素残缺,而非模型不济。
综合起来来看,非AI企事业单位之间的智能化竞赛,重心已由买模型转向建本地生态。模型采购是三年前的问题,三要素建设是未来十年的问题。文科生在人工智能时代的立足点不在算法,在此处:理解业务的人,才拆得出工作流;掌管资料的人,才守得住数据源。你可以管他叫FDE,可以叫AI BP(这个词貌似是我造的,至少有人认为是我造的,但确实是个好东西),whatever,照着这个思路做就完事了。
六、信息来源与学习路径
对人工智能的理解,不能依赖二手转述,需要建立自己的信息渠道。四个方面,足以支撑长期跟踪。
第一,读一线体验者的记录。首推公众号"数字生命卡兹克",国内写作人工智能应用体验最持续的作者之一。他的价值在于不空谈概念:每个新模型、新工具自己先用一遍,再写体验,好在何处、坑在哪里,一并交代。读此类作者,读其体验,不要只记结论:体验是事实,结论会过期。同类作者择一两位长期跟住即可,贵在持续。
第二,GitHub 定期检索。GitHub 是全球最大代码托管平台,人工智能领域的新成果第一时间以开源仓库形式出现在这里,DeepSeek、GLM、Qwen 的模型权重均开源于此。用法有三:看 trending 热门榜,了解当日全球开发者关注什么;检索 awesome 系列清单(如 awesome-llm 是大模型领域精选资源目录),按图索骥;看 star 数与更新频率,前者是开发者投票,后者是项目健康度。开源社区的优点是诚实:代码公开,好坏可验,没有营销修饰。这是中文互联网被普遍低估的一个信息渠道,多数人以为那里只有代码,实际上那里有整个行业的动向。
第三,官方一手信息与榜单读法。各厂商官方发布页(OpenAI、Anthropic、DeepSeek 的博客与技术报告)永远优于二手转述,转述一层,失真一层。榜单可以看:Artificial Analysis 做横向能力对比,LMArena 做人类偏好评价。但需保持清醒:厂商会针对榜单专门优化,单次登顶的宣传价值常大于实际差距。读榜单的要诀是看趋势不看单点:一家厂商连续四个季度稳步上升,比一次登顶的含金量高得多。
第四,实践与交流。没啥可说的,计算机学院也好、软工也好,其他理工科也好,大家都有强烈的搞钱和创业需求,只要你有耐心、有脑子,可以听到很多故事。但光听不干就会变成复读机、叶公好龙式的AI专家,关键还是要自己干。说句难听的现在哪怕你自己在开源框架下做个post train,预算2000十分够了,不干实事一天到晚净扯淡,那是不可能真玩明白滴。
七、结语
正文写差不多了,现在发散一点东西。
一个是回扣前文我自己关于产业发展的一些感悟。该说不说,其实必须承认,我这个人长期以来颇有点计划经济倾向,热衷于搞投入产出经济性核算、讨论具体的产业技术路线,恨不得pitchbook都帮企业写好,这种思维方式在上个世纪或许可行(至少日韩都是这么干的),现在是真不好说。我一直觉得产业是人干出来的,人行产品就差不到哪去,人不行给再多都是喂狗。我们的数据产业搞三权分置、培育引导市场,为啥出了那么多问题、进度不及预期?说穿了外行领导内行严重,很多活都是一些压根不懂行的副处长干的,调研调研,调了半天也没研究出个啥。我现在的感受是,要保持耐心、厚植土壤,支持基础科学发展并与产业保持良性互动,然后等待幻方、大疆这样的好公司“自动地从土里长出来”、迅速识别这些好苗子,然后上杠杆、为他们争取政治资源和融资,让他们作为自由动力(类似于央行的M0)驱动市场形成和产业规范固化,同时也保持技术路线开放性,一旦好公司有变烂迹象就果断换手,使其保持忧患意识。这种以企业为中心的产业发展道路比政府手把手引导有效得多。
二是对文科生再说点话。就是我长期以来一直在思考,究竟是文科学科建设不行、文科生人不行,还是文科的场域文化不行,仔细想想,一三兼有之,二是最站不住脚的,都是做题做出头的,差异哪能那么大,无非是被不正确的培养路径捆住了手脚。遇到新东西,第一反应不应该是去谈什么心性理,叨弄一些什么对大众和企业、政策都毫无意义的人文主义大经(说白了大部分人也听不懂,就感觉这人神经兮兮的,嘀嘀咕咕不知道说些啥),而是要快速学习、准确判断,随后作出相应;遇到新挑战,要积极应对、敢于壮士断腕,不能被旧路径束缚、通往一条必死之途,而要用好旧资源、打开新局面,在路径调整中实现动能转换。还是一句老话,新质生产力寓于新型生产工具,客观真理通过实践经验而非对墙格竹检验成实。新形势下,要善作善成,干好事、多积德(比如我觉得我不写申论而来写这个玩意也算是日积一德),方能穿越漫长的历史周期,在寒冬之末成为第一枝苏醒的新苗。
本文责编 ✎抑之
排版编辑 ✎Bubble
专业学习、考研升学、职业探索,请认准“青苗法鸣”旗下“青法学堂”公众号
青苗法鸣文末征稿启事
“青苗法鸣”微信公众号聚焦社会热点讨论与法学学术交流,为了给大家提供更好的分享-交流-争鸣平台,激励更多的青年学人思考和写作。诚请大家惠赐优稿!
一、长期征稿
稿酬等详情信息请见:2026年征稿启事 赐稿邮箱:qmfmbjb@163.com。
二、建议选题如下:
1.法学院校、学科发展历史及未来
2.法学人才培养模式的反思与提升
3.论文写作与案例分析方法
4.学术研究兴趣探索与养成
5.考博经验及读博感悟
6.地方社会治理实例与法治发展
7.民商法学(含婚姻家庭法)基础性问题与前沿热点研究
8.侵犯人身权利类、妨害社会管理秩序类犯罪的基础性问题及前沿热点研究
9.其他法律部门(经济法、行政法、环境法)法典化研究
10.个人信息保护领域法治问题
11.教义学与社科法学研究方法
12.企业合规与法治化营商环境建设
13.司法改革举措、成效的实证类研究
14.社会普遍关注的热点问题
推荐阅读
联系我们
长期收稿邮箱:qmfmbjb@163.com
科研学术写作等讲座咨询请添加:qmfmggwx2
商务合作请添加微信:zfm202416
笔记与商品:请搜“法鸣科技”小程序