ARTICLE · 1049896
AI日报|Qwen-Image-2.1正式开源!剪映发布AI智能创作工作台Hub,剪映以及移动端“小映”!智谱ZCode正式开源!
2026年9月21日 AI资讯日报
【AIGC】
• Qwen正式开源Qwen-Image-2.1:新模型把生图与图像编辑统一,视觉生成部分仅7B参数,原生支持RGBA透明图生成和编辑、最多10张参考图、多主体组合以及圈选、涂抹和独立Mask等局部修改,并进一步增强人像、商品一致性、文字排版和真实质感。 • 腾讯开源WeVisDoc文档解析模型:提供2B与4B两个版本,可直接把PDF页面、扫描件等页面图像解析成保留标题、阅读顺序、LaTeX公式和HTML表格的结构化Markdown;4B版本在OmniDocBench v1.6取得95.38 Overall,模型和代码均已开放。 • 剪映发布Hub、剪映助手与AI Ultra:剪映Hub把无限画布中的脚本、分镜、AI图片/视频/音频生成与传统多轨剪辑直接连接,生成结果无需反复导出即可继续精剪;剪映助手则进入真实时间线执行素材整理、口播删减、字幕纠错和视频包装等任务,移动端同步推出“小映”。
【大模型与Agent基础设施】
• Google开源Agentic编排器AX:AX运行在Kubernetes之上,专门面向有状态、长生命周期Agent工作负载,提供Task、Workspace、Gateway与Model四类声明式原语,并支持Sandbox隔离、网络白名单、Git/MCP预加载以及任务暂停和恢复;Google将其设计目标定为单集群承载数十亿Agent任务。
【行业信息】
• 硅基流动完成B+轮二期及C轮融资:公司2026年累计股权融资额已接近29亿元,财新据此前融资规模推算此次新增融资约8至9亿元;资金将继续投入推理引擎、异构算力调度、模型与芯片适配等基础设施研发,并强化Token供应平台及全球市场布局。 • ZCode正式开源:在此前代码库数据上传争议完成整改后,智谱将ZCode代码交由社区公开监督,GitHub仓库采用Apache 2.0协议;新版已移除Repo Wiki并切断仓库Snapshot生成及上传链路,智谱同时引入中国信通院和绿盟科技进行安全审计,并计划建立长期漏洞报告机制。
【安全与数据治理】
• 智谱MaaS将上线“数据内容不留存”功能:企业和开发者可在控制台申请,生效后普通模型调用的Prompt和Output不会进行静态存储,仅用于当前请求;Batch API、File API等本身依赖持久化的能力不在覆盖范围,法律法规要求或涉嫌违规滥用核查等情形也可能依法留存数据。
每天的AI资讯⬇️
🤖️ AIGC
Qwen-Image-2.1:7B模型把生成、编辑和透明图真正合成一个Checkpoint
Qwen正式发布并开放 Qwen-Image-2.1 权重。
这一代最明显的变化并不是单纯提高文生图质量,而是把过去往往需要不同模型处理的:
Text-to-Image + Image Editing + Transparent RGBA Creation
统一进同一个模型。
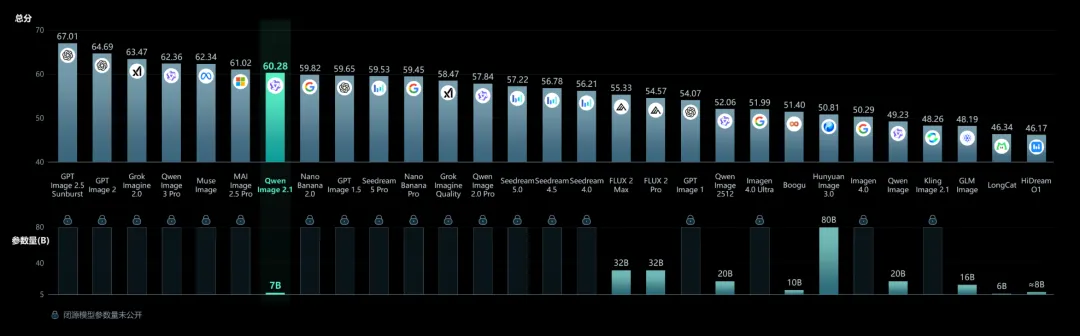
视觉生成部分只有:7B参数
采用32层Single-Stream DiT,在尽量降低推理成本的同时继续覆盖高质量图像生成和复杂编辑任务。
• 原生支持RGBA透明图:用户可以直接要求模型生成带Alpha Channel的素材,而不是先生成白底或棋盘格背景再调用Background Removal;透明素材生成后还能继续直接编辑,例如改变人物表情、修改透明文字或继续添加元素。 • 普通照片也可以直接抽取透明主体:输入一张RGB照片后,可以让模型把人物、产品或其他对象提取成独立RGBA Layer,后续直接进入海报、电商设计和视觉合成流程。 • 最多支持10张参考图:模型可以一次同时读取多个人物、商品、服装和场景Reference,再组合成一个新画面,例如把6张人物肖像合成群像,或把人物、衣服、鞋、包、帽子组合成完整穿搭。 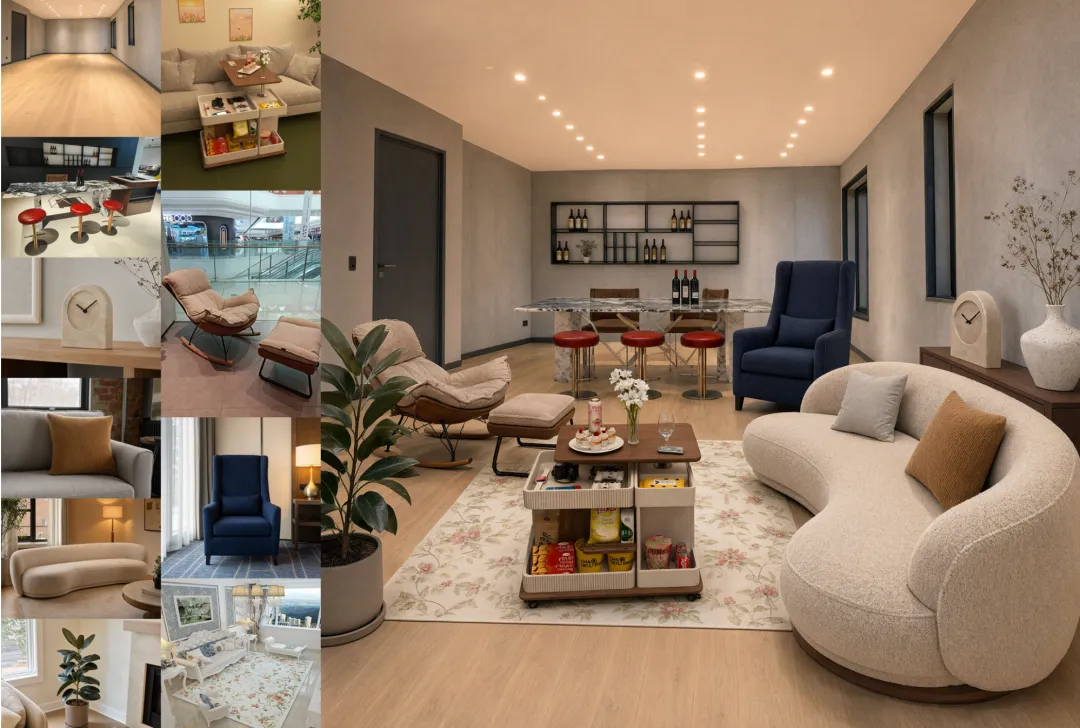
• 局部编辑方式明显更灵活:不仅支持传统Mask,还能直接通过圆圈、颜色标记和涂抹告诉模型“改这里”,并在同一次Prompt里对多个区域执行不同操作,例如去掉手表、修改头发颜色并替换衣服。 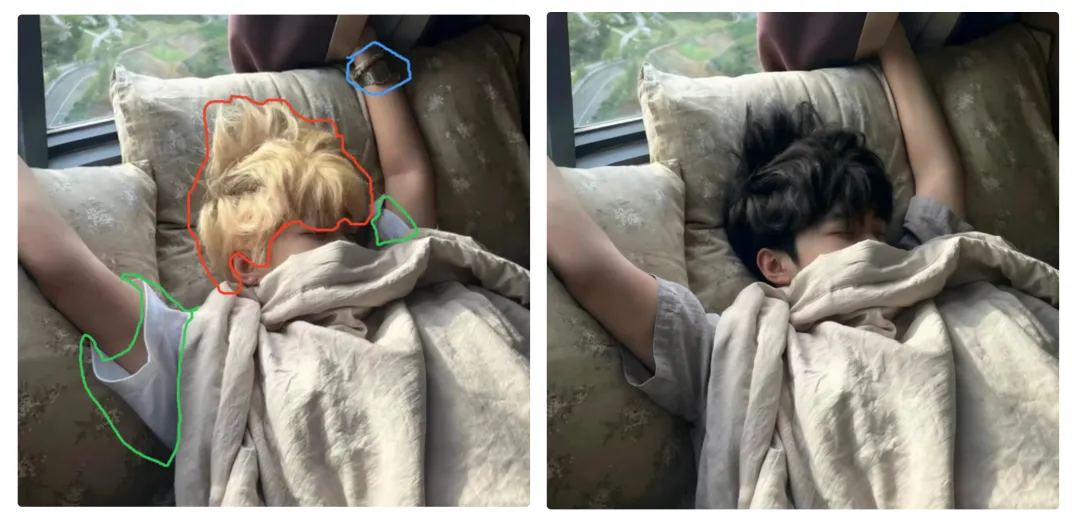
• 强化人物和商品保真:多参考图编辑中特别强调Identity Preservation和Product Fidelity,让模特面部、商品造型、服装结构在不同场景和组合过程中尽可能保持一致。 • 文字生成继续升级:模型不仅处理文字内容,还更重视Typeface、Layout以及文字和整个Composition之间的关系,更适合Poster、Infographic、商品图和视觉设计。 • 人像质感进一步增强:官方重点改善Portrait Lighting、Skin Detail和Fine Texture,让人物光影、皮肤和材质更加自然。
为什么多图编辑变快了?Qwen-Image-2.1使用:Mixed-granularity Attention
文字System Prefix和Editing Instruction采用Token-level Causal Mask,而图像生成部分采用Chunk-level Mask。
与此同时加入:Prefix KV Cache Reuse
参考图片与编辑指令在第一步只计算一次,之后的Denoising Step直接复用Cache,不需要每一步重新编码全部10张图片,因此特别针对Multi-image Editing降低重复计算和显存开销。
Qwen这次同步准备了完整的开源推理生态:
• Diffusers:Day-0支持 QwenImage21Pipeline,同一个Pipeline处理文生图与参考图编辑。• ComfyUI:发布当天即原生支持,并提供Text-to-Image、Image Editing及Background Removal等Workflow。 • vLLM-Omni:支持Prefix KV Cache、CUDA Graph、FP8、Tensor Parallel、Ulysses Parallel以及Continuous Batching,重点面向大规模服务部署。 • SGLang:同步加入Prefix Cache、Cache-DiT、CUDA Graph以及多GPU并行优化。 • LightX2V:同样在Day-0提供加速支持。
🌟官方介绍:
https://qwen.ai/blog?id=qwen-image-2.1
🌟GitHub:
https://github.com/QwenLM/Qwen-Image-2.1
🌟Hugging Face:
https://huggingface.co/Qwen/Qwen-Image-2.1
WeVisDoc:腾讯开源2B/4B端到端文档解析模型
腾讯微信视觉团队开源 WeVisDoc,提供:
WeVisDoc-2B和:WeVisDoc-4B 两个版本。
它不是传统“先OCR文字,再检测Layout,再识别Table,最后重新拼文档”的多阶段Pipeline,而是:
Page Image → Structured Markdown
一次端到端完成。
• 输入是一整页图片:PNG、JPEG或WebP页面均可直接处理,PDF则先渲染成Page Image。 • 输出直接是结构化Markdown:普通文字按照阅读顺序输出,数学公式保留为LaTeX,Table则转换成HTML Table,Heading、Paragraph和其他文档结构保持在同一个序列里。 • 模型基于Qwen3-VL继续训练:2B版由Qwen3-VL-2B-Instruct微调,4B版则基于Qwen3-VL-4B-Instruct。 • 重点解决复杂版式和劣化文档:训练不仅覆盖数字原生PDF,也针对扫描、拍摄、畸变、模糊、光照和其他真实Document Capture问题进行强化。
官方Benchmark
WeVisDoc-4B在 OmniDocBench v1.6 获得:95.38 Overall
在PureDocBench三个Track中的平均Overall达到:75.54
官方比较中,4B模型在四组端到端Document Parser对比中均位列第一。
可以本地部署,WeVisDoc代码和2B、4B模型权重均已公开,并采用:
Apache 2.0
官方同时提供vLLM和Transformers两类本地推理方案,因此企业可以直接部署到自己的Document ETL、RAG和知识库Pipeline中。
🌟项目主页:
https://tencent.github.io/WeVisDoc/
🌟GitHub:
https://github.com/Tencent/WeVisDoc
🌟4B模型:
https://huggingface.co/Tencent/WeVisDoc-4B
🌟2B模型:
https://huggingface.co/Tencent/WeVisDoc-2B
剪映Hub:AI生成视频和传统时间线剪辑终于被接到了一起
剪映在9月20日的 AI新创作发布会 上推出:剪映Hub、剪映助手以及移动端“小映”并同步上线新的:AI Ultra会员。
这次最大的变化并不是“剪映也能AI生视频了”,而是剪映开始解决目前AI视频制作最麻烦的问题:生成和后期是两个世界。
过去流程通常是:
AI平台生成 → 下载 → 导入剪映 → 剪辑 → 发现问题 → 回AI平台重新生成 → 再下载。
新版剪映试图把这条链路变成一个工作空间。
剪映Hub:承担前期策划和生成
Hub采用:
无限画布 + 多轨编辑器 的组合。
用户可以从一句Prompt、一段Reference Video或一份Document开始,在Canvas中完成:
Idea → Script → Storyboard → Asset → Video Generation。
例如做一条产品广告时,可以先生成产品参考图,再让Hub生成分镜脚本;脚本与产品素材连线后,系统可以自动提取人物、道具和场景资产,再为每个Shot生成参考图和Video Prompt。
随后用户可以调用包括即梦、小云雀等字节系AI能力生成图片、视频和音频。
当多个Shot生成后,还可以直接:
预览成片。
不需要先手动把每段Video下载再拼起来。
如果AI生成的初版还需要精修,可以直接点击:更多剪辑 整个结果立即进入剪映传统的:
Multitrack Timeline。
也就是说: AI Infinite Canvas → Professional Timeline
现在被真正连接起来。这也是此次发布最重要的一点。
AI编辑直接进入时间线
生成结果进入Timeline后,可以继续使用:
AI智能延长、局部编辑、超清画质、AI补帧、调色、AI消除、人声分离
等能力。
例如发现某个Shot中的杯子颜色不对,不必重新回到AI生成平台,只需要选中视频区域,然后输入:
“把杯子变成黑色。”
即可进行局部修改。
剪映助手:Agent直接操作真实剪辑工程
新版剪映专业版同时推出 剪映助手。
它不是只在旁边给用户建议,而是进入真实Multitrack Project辅助操作。
现有Skill覆盖素材整理、口播删减、做解说、字幕纠错、批量成片和视频包装等高频工作,创作者也可以根据自己的Workflow自定义Skill。
因此可以直接告诉它:
“把停顿太长的口播删掉,修正字幕错字,再给重点位置做简单包装。”
Agent再参与实际剪辑流程。
移动端则是“小映”
剪映App中的移动版Agent叫: 小映
它把AI创作助手、多轨剪辑助手以及AI营销专家整合到手机端,面向生活记录、自媒体剪辑和商品营销等更轻量的创作需求。
剪映同时推出新的:AI Ultra
订阅层级,把AI生成所需积分与剪映SVIP专业剪辑能力放在同一订阅体系中。
🌟相关报道:
https://www.qbitai.com/2026/09/492973.html
🧩 大模型与Agent基础设施
Google AX:让Kubernetes开始真正适合运行数十亿Agent任务
Google开源 AX。
官方将它定义为:Open Agentic Orchestrator
它并不是一个Agent Framework,也不是新的LLM,而是专门负责:
Agent Runtime Infrastructure。
传统Kubernetes更擅长运行Stateless Web Service和普通Batch Job,但Agent的工作方式非常不同。
Agent可能:
运行几十秒 → 等待用户审批数小时 → 恢复执行 → 修改Repo → 调MCP → 再继续等待。
它既不是普通无状态Service,也不是执行一次就退出的Batch。
AX正是针对这种Workload设计。
AX目前把系统抽象成四种主要Resource:
Task、Workspace、Gateway、Model。
• Task:真正运行Agent任务,负责Sandbox及CPU / Memory等资源限制。 • Workspace:提前挂载Git Repository、MCP Server和Skill Package,让Agent启动时已经拥有工作环境。 • Gateway:控制Agent能访问哪些网络地址,通过Allowlist避免Agent随意连接外部服务。 • Model:声明平台自身需要使用的LLM以及Credential来源。
所有配置都通过:
ax.io/v1alpha1
YAML Manifest进行声明。
用过Kubernetes的开发者会发现它的CLI也故意做得非常像:
ax applyax getax describeax watchax delete
每个Agent都有独立Sandbox
AX构建在Agent Substrate之上,为Agent提供隔离执行环境。
因此一个Coding Agent可以拥有自己的:
Filesystem、Git Workspace、Tool Environment和Network Boundary
而不会直接与其他Agent共用同一个执行空间。
Agent可以暂停,再从原状态恢复
这是AX非常关键的能力。
当一个Agent完成当前工作,正在等待用户批准时,可以:
ax suspend
释放计算资源。
之后用户回来:ax resume
系统再恢复原来的Actor State,让Agent继续之前的工作。
这比让数百万个等待用户回复的Agent一直占着CPU、RAM和Sandbox更加适合大规模部署。
网络访问同样可以声明式控制
Agent能够访问互联网往往也是非常重要的安全边界。
AX Gateway可以明确规定:
Agent允许连接哪些Host。
例如Coding Agent只允许:
GitHub + Package Registry + 企业内部API
而不是开放整个互联网。
Google的目标非常激进
AX官方README直接将目标写成:
run billions of autonomous agent workloads in a cluster
也就是:
单个Cluster运行数十亿级Agent Task。
更准确地说,这是系统的设计与规模目标,不代表Google已经公布真实生产环境完成数十亿任务的Benchmark。
项目目前仍处于:
v1alpha1
阶段,官方也明确警告Core Concept、Protocol和Specification仍在快速变化,Stable Release之前可能存在Breaking Change。
🌟GitHub:
https://github.com/google/ax
🏭 行业信息
硅基流动年内融资近29亿元:继续押注“Token供应平台”
硅基流动宣布完成:B+轮二期及C轮融资。
至此,公司2026年度累计股权融资额达到:近29亿元人民币。
硅基流动没有单独公布本轮融资总金额,不过财新根据其今年6月完成超过20亿元融资计算,本轮新增资金大约:8至9亿元。
此次投资方覆盖国家级基金、央地国资、产业资本和专业投资机构。
资金未来重点投入三个技术方向:推理引擎、异构算力调度、模型与芯片适配。
🌟相关报道:
https://companies.caixin.com/2026-09-20/102486873.html
ZCode正式开源:数据争议之后,把客户端交给社区检查
9月21日,智谱正式宣布:ZCode开源。
代码主要使用TypeScript,采用:Apache License 2.0。
此次开源与此前ZCode代码库数据上传争议直接相关。
智谱表示,最新: ZCode v3.14.0 已经移除: Repo Wiki 同时:
彻底切断本地仓库Snapshot生成与上传链路。
也就是说,此前争议中的Repository Snapshot机制目前已经从客户端移除。
智谱邀请: 中国信息通信研究院 与 绿盟科技
对整改后的系统进行安全检查。
据公开结果:
• 中国信通院确认 zcode-prod阿里云OSS存储桶当前处于云端零数据状态;• 绿盟科技确认相关OSS中的Data Object以及Bucket本身已经删除; • 新版客户端中未发现可以继续触发本地Repository Snapshot或文件外发的功能路径。
智谱同时承诺:
相关代码数据无留存,也从未被用于模型训练。
🌟Z.ai GitHub:
https://github.com/zai-org
🌟ZCode:
https://github.com/zai-org/ZCode
🌟ZCode Plugins:
https://github.com/zai-org/zcode-plugins
🔐 安全与数据治理
智谱MaaS推出“数据内容不留存”:Prompt与Output不做静态存储
智谱MaaS平台宣布近期上线:
数据内容不留存
功能。
企业和开发者可以在MaaS控制台提交申请,功能正式生效后,普通API调用中的:
Input和Output
不会在智谱平台进行: Static Storage。
也就是说,数据只会用于:
完成当前这一轮Model Inference。
调用结束后不会按照普通日志或历史内容形式继续持久化保存。
智谱目前表示:
**任何用户都可以提交申请。**具体功能何时生效、哪些Model和Endpoint被覆盖,则以MaaS平台最终审核结果为准。
🌟官方消息:
内容由AI生成,存在错误可能,仅供参考阅读