ARTICLE · 1054499
Jev不写答案,只替软件做判断
TypeSafe AI 推出的 Jev 把分类、打分和概率判断做成可直接进入程序的固定类型输出。它适合高频路由、审核和流程分流,但仍需用真实数据验证准确率与阈值。
2026 年 9 月 15 日,TypeSafe AI 发布了 Jev,并给它起了一个新类别名,System One Model。
这个名字借用了“系统一”的说法,强调快速判断。放到软件里理解更简单。ChatGPT、Claude 这类生成模型擅长写一段答案,Jev 接到任务后只做选择、打分或概率判断。
Jev 的目标,是把 AI 判断做成一种能直接放进程序的固定类型。
它交付的不是一段话
普通大模型处理客服工单分类时,往往会先生成文本。开发者再要求它遵守 JSON 格式,从答案里解析分类,并处理字段缺失、格式错误等情况。
Jev 的输入分成两部分。一部分叫 state,可以是一段文本,也可以是 JSON,里面放着本次判断需要参考的事实。另一部分是一组预先定义好的问题。
它目前提供三类主要判断。
Choice 从给定选项里选一个,并返回各选项的概率分布。Score 按一组有顺序的等级打分。Noul 给出一个命题为真的概率,结果落在 0 到 1 之间。
官方 Python SDK 的示例很直观。一张工单写着用户被重复扣费,程序给出 billing、technical 和 other 三个选项,Jev 负责判断该把工单送到哪里。返回值可以直接交给后续代码,不必再从一段自然语言里找答案。
输入仍然可以很复杂,输出却被限制在程序事先允许的范围里。
这项限制能解决一类很具体的问题。模型不会临时多造一个选项,也不会少返回某个必要字段。不过,格式正确不等于判断正确。Jev 仍可能选错类别,或给出不可靠的概率。
三种判断可以同时完成
同一份 state 可以带上多个问题。客服系统可以同时判断工单属于哪个部门、用户有多着急,以及是否需要人工介入。
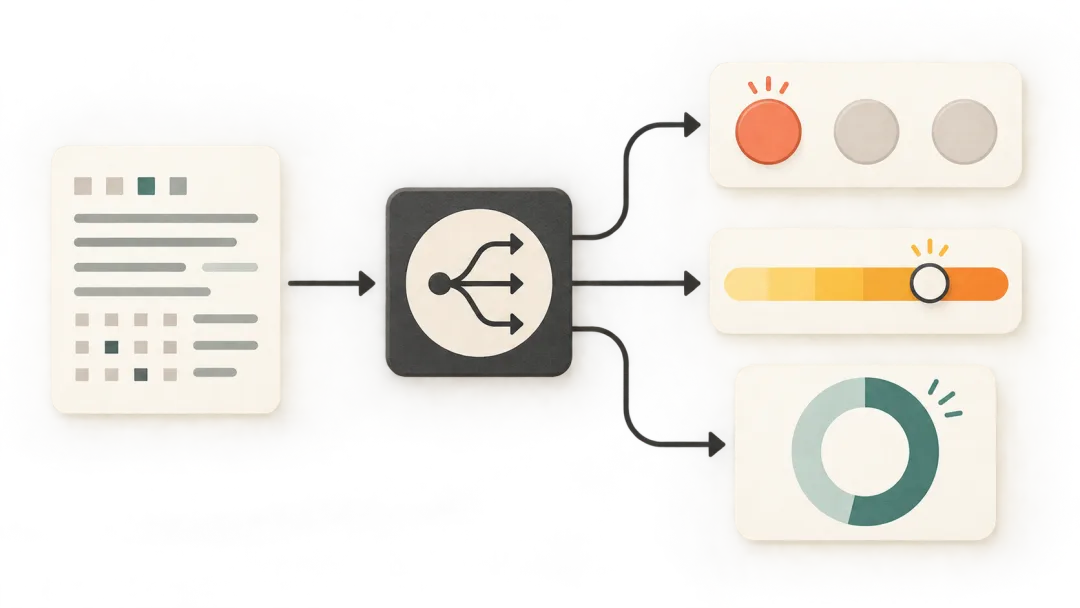
这些问题共享输入,但会独立计算。一个问题看不到另一个问题的答案,也就不能在同一次请求里搭出“先分类,再依据分类继续判断”的依赖关系。需要这种顺序时,应用仍要分成多次调用。
多个独立问题可以并行判断,这让 Jev 很适合处理一份材料上的批量标签、审核项或分流条件。
它的用途也由此变得清楚。客服系统可以拿它分派工单,内容平台可以用它做初步审核,AI Agent 可以在调用工具前判断风险,模型路由器可以根据请求类型选择后续模型。程序还可以读取概率,在信心不足时把任务交给人或更强的生成模型。
这类工作共同拥有一个条件。可选结果在调用前已经确定,程序需要的是判断,不需要临场写一篇新内容。
快和便宜来自少写东西
生成模型要逐个产生词元,答案越长,等待越久。Jev 把输出空间限制为预先定义的类型,并以并行方式得到判断结果,省掉了长文本生成。
TypeSafe 在 9 月 15 日的发布材料中公布,Jev 的典型延迟约为 70 到 500 毫秒,当时标示的价格为每百万输入词元 0.042 美元,输出免费。这些数字来自发布方自己的工作负载和计费页面,会随模型版本、输入长度与商业阶段变化,不能直接推成所有任务都能达到的成绩。
官方还称 Jev 使用 Reinforcement Learning for Calibrated Decisions,也就是面向校准决策的强化学习。训练目标包括让概率与真实结果更一致。若模型对一批事件都给出约 0.8 的概率,理想状态下,其中大约八成应该发生。
概率只有经过业务数据检验才有用。自动审核不能看到 0.8 就直接上线。团队需要先在自己的历史样本上测准确率、误报率和概率校准,再决定 0.6、0.8 或别的阈值分别触发什么动作。
Jev 最适合先在现有流程旁边运行,让团队看清它在哪些输入上会犹豫、在哪些类别上容易出错。
它接不了哪些工作
Jev 不负责写邮件、总结文档、生成代码或解释推理过程。任务需要开放式表达时,生成模型仍然合适。任务含有固定候选项,却要求多步规划或依赖前一个答案继续推理时,也不能只靠一次 Jev 调用完成。
它目前还是早期开放产品。官方 SDK 和文档已经公开,开发者可通过 API 调用,模型细节、独立评测和跨领域表现仍需要更多证据。
眼下更稳妥的用法,是挑一个结果固定、出错后可以交还给人的环节做旁路测试。等它在自己的数据里交出可信的概率和错误记录,再让它接过正式判断。