ARTICLE · 1054905
爱可可AI前沿推介(9.22)
LG - 机器学习 CV - 计算机视觉 CL - 计算与语言 AI - 人工智能
1、[CL] Recursive Language Models Generalize Out of Domain
2、[LG] Elastic Threshold Attention:Learned Contextual Sparsity for Long-Context Decoding
3、[LG] Scaling Discovery through Test-Time Communication
4、[LG] SWE-Proof:Can Language Models Resolve Real-World Issues with Machine-Checked Proofs?
5、[AI] Attention-Aware Routing:Coupling Routing and Attention in MoEs
摘要:递归语言模型具备跨领域泛化能力、面向长上下文解码的可学习上下文稀疏化技术、通过测试时通信实现探索能力的规模化扩展、语言模型能否通过机器校验的证明解决现实世界的问题、MoE 架构中路由与注意力机制的深度耦合
1、[CL] Recursive Language Models Generalize Out of Domain
C Yang, Z Li, D McAllester, N Srebro
[Toyota Technological Institute at Chicago]
递归语言模型具备跨领域泛化能力
要点:
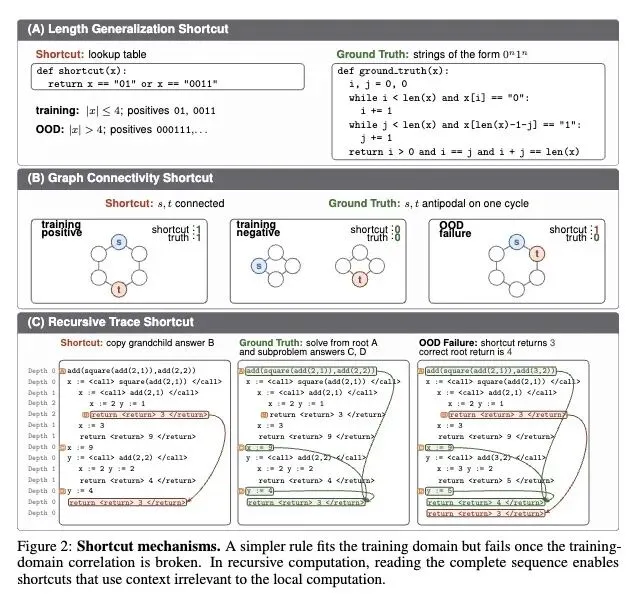
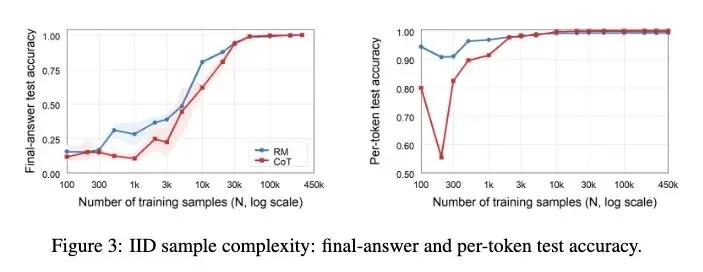
挑战了“苦涩的教训”在推理领域的延伸: 反驳了“拥有全局上下文的通用模型总是更好”的直觉认知。在分布外(OOD)推理中,模型看到的信息“越多”,反而可能导致“错误”的规则更容易被学到。 揭示了标准思维链(CoT)的“捷径”陷阱: 在扁平化的 CoT 轨迹中,当前子任务之外的 token(如全局位置信息、遥远子任务的中间值)会形成易于读取的模式。CoT 会利用这些“捷径”来拟合训练数据,导致在分布外测试时发生灾难性崩溃。 引入递归模型(RM)作为通过“上下文隔离”实现的结构性修复方案: 通过强制模型在隔离的上下文中解决每个子问题(隐藏完整历史和无关子任务),RM 天生满足“不变性(invariance)”,从根本上阻止了模型观察和学习那些脆弱的捷径。 关于同分布(IID)极限的反直觉理论发现: 在最小描述长度(MDL)理论下,CoT 只需要在深度和参数上增加一个常数因子,就能模拟 RM 的递归规则。因此,对于 IID 任务,RM 相比 CoT 并没有显著的统计学优势。在同分布下,“通用性”的代价是很低的。 简单性偏好(Simplicity bias)是一把双刃剑: 使 IID 学习变得高效的 MDL“简单性偏好”,正是导致 CoT 在 OOD 下失败的元凶。在全局序列上,非不变性的“捷径”规则往往比真正鲁棒的推理规则“更短”(描述成本更低)。 OOD 泛化上的巨大实证分歧: 在符号表达式计算任务中,虽然 CoT 和 RM 在 IID 下都达到了约 100% 的准确率,但在更长或更深的执行轨迹上,CoT 的准确率暴跌(例如降至约 10%)。相比之下,RM 在长得多的轨迹上依然保持高度准确(- 植入捷径实验证实了上述机制: 当在训练中故意植入虚假捷径(例如轨迹位置的奇偶性)时,CoT 在 OOD 测试中超过 90% 的情况会选择走捷径,而 RM 则完全忽略捷径,遵循真实逻辑。
主旨: 本文探讨了在语言模型的逻辑推理中,限制模型的可见上下文(视野)何时以及为何能提升学习效果。文章深入研究了为什么标准思维链(CoT)在分布外(OOD)泛化时会崩溃,并证明了采用上下文隔离的递归语言模型(RM)如何通过隐藏无关信息,强制模型摒弃“捷径”,从而真正掌握通用的推理规则。
创新:
理论视角的创新融合: 创新性地将最小描述长度(MDL)理论、简单性偏好与分布外泛化(OOD)结合起来。提出了“提升描述语言的表达能力(即 CoT 的全局可见性)虽然在同分布下几乎没有代价,但在分布外会导致模型倾向于寻找描述长度更短的捷径”的数学证明。 结构化的对比范式: 构建了严谨的理论与实验框架,将“看到完整轨迹的通用学习器(CoT)”与“仅在隔离上下文中解决子任务的受限学习器(RM)”进行对齐比较,创新性地通过“植入捷径”实验量化了全局可见性带来的负面影响。
贡献:
理论贡献: 证明了 CoT 在同分布(IID)下模拟递归规则只需增加常数级开销(定理4和6);但严格证明了如果在 OOD 下存在严格的“捷径鸿沟”,CoT 必然会违背不变性(定理8),从而产生泛化失败。 机制揭示: 明确指出了大语言模型在长程推理中表现不佳的根本原因之一:不是模型能力不够,而是全局注意力机制让模型更容易学到依赖于当前任务之外无关 token 的“捷径”(虚假相关性)。 实证贡献: 通过高度可控的符号表达式求值数据集,不仅验证了长度和深度的 OOD 泛化差异,还精妙地设计了 6 种不同的捷径植入方案,实证了 RM 在克服这些捷径陷阱上的绝对优势。
提升:
分布外长程泛化能力: 在测试生成的轨迹长度为训练集最大长度的 3 到 5 倍时,传统 CoT 准确率从 100% 断崖式下跌至 10% 左右,而 RM 依然维持在 92.4% 的高准确率。 分布外深度泛化能力: 当递归深度达到训练深度的 2.2 倍以上时,CoT 准确率降至 38.4%,而 RM 继续保持在 98.7% 的极高水准。 抗干扰(抗捷径)能力: 面对“复制深层返回值”或“轨迹位置奇偶性”等强迷惑性捷径信号时,CoT 错误地采纳捷径的概率高达 90% 以上,而 RM 的捷径采纳率接近 0%(仍保持 87%-99% 的真实逻辑准确率)。
不足:
任务场景的局限性: 实验主要在基于规则的合成数据(符号表达式求值)上进行,这种任务的逻辑边界极其清晰。在充满自然语言模糊性、需要跨多个上下文进行软性信息融合的现实复杂任务中,绝对的上下文隔离是否依然有效尚待验证。 系统复杂性考量: 递归模型(RM)需要在推理时动态维护调用栈、推送和弹出局部上下文,相比于目前高度优化、依靠硬件加速的扁平化自回归生成(CoT),其工程实现成本和底层调度复杂度要高得多,论文并未深入探讨其工程部署的性能损耗。
心得:
重新审视“苦涩的教训 (The Bitter Lesson)”的适用边界: AI 领域一直笃信 Rich Sutton 提出的“苦涩的教训”,即用更通用的架构和更多的算力让模型自己找规律,胜过人类手工设计结构。但本文给出了一记响亮的反击:在严密的逻辑推理任务中,“看得太多”反而是一种惩罚。因为通用的全局注意力机制会让模型“偷懒”,去寻找数据中最容易拟合的表面模式(捷径),而不是真正普适的逻辑规则。这启发我们在设计 AI 智能体时,应该适时地“蒙上模型的眼睛”,实行信息权限最小化。 “奥卡姆剃刀”在分布外环境下的双刃剑效应: 最小描述长度(MDL)本质上是“奥卡姆剃刀”的数学表达——越简单的规则越好。在训练分布内,这帮助模型快速收敛;但在分布外,由于训练数据有限,由局部特征拼凑成的“捷径”往往在数学描述上比“真正的通用逻辑”更短、更简单。这深刻地启示我们,解决大模型幻觉和逻辑崩塌,不能仅仅依赖增加参数和数据,必须通过架构设计(如引入不变性约束)来改变模型眼中“简单”的定义。 通向 System 2 (慢思考) 的必由之路是“模块化”与“遗忘”: 人类在做复杂数学题时,不会把草稿纸上所有的计算痕迹都时刻保持在脑海的最高优先级,而是算完一步,记下结果,清空大脑内存,继续下一步。大模型的 Context Window 卷到了几百万,但本文证明了把所有中间步骤(Scratchpad)都放在全局可见的上下文中是有毒的。未来的复杂推理系统,必须具备动态上下文折叠、局部工作区隔离的能力,学会“用完即弃”,才能真正实现高质量的模块化思考。
一句话总结: 本文极其反直觉地证明了在复杂推理任务中“模型看到的信息越多反而越容易学废”,指出标准思维链(CoT)会因为全局可见性而沉溺于虚假的“捷径”导致分布外泛化崩溃,从而提出通过隔离上下文的递归模型(RM)来强制模型掌握真正普适的推理法则。
We study when limiting what a language model can see improves learning. We compare standard CoT, the more general learner that reads the full trace, with recursive language models, which restricts itself by solving each subtask in an isolated context. In-distribution, this generality comes for free: CoT can efficiently simulate the recursive rule, so the IID generalization guarantee changes only by a constant factor, and recursion does not offer much. But out of domain, CoT can fit training by relying on context outside the current subtask, i.e. a shortcut that breaks once those tokens change; recursive context isolation rules out this failure mode. Even though CoT's class still covers the recursive rule, simplicity bias picks the shortcut over the truth. Thus, to go beyond distributional accuracy and truly reason, covering the right rule is not enough; this contrasts with classical learning theory.
https://arxiv.org/abs/2609.2083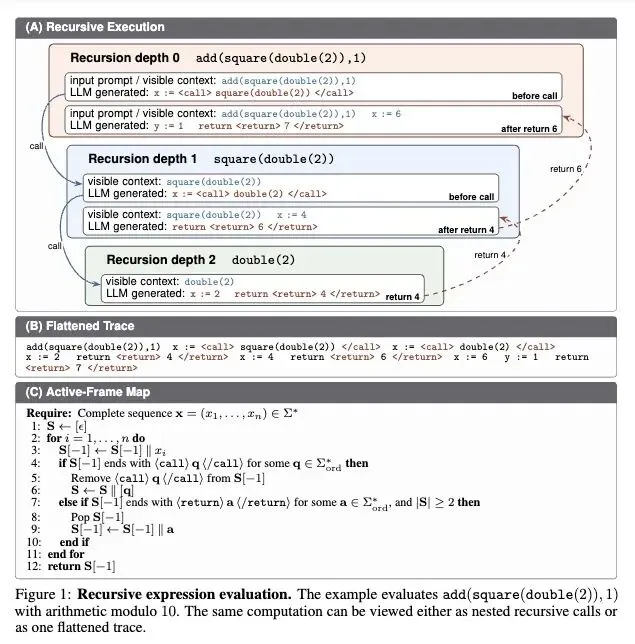
2、[LG] Elastic Threshold Attention: Learned Contextual Sparsity for Long-Context Decoding
T Haris, H Li, M Karimzadehgan
[Google]
弹性阈值注意力:面向长上下文解码的可学习上下文稀疏化技术
要点:
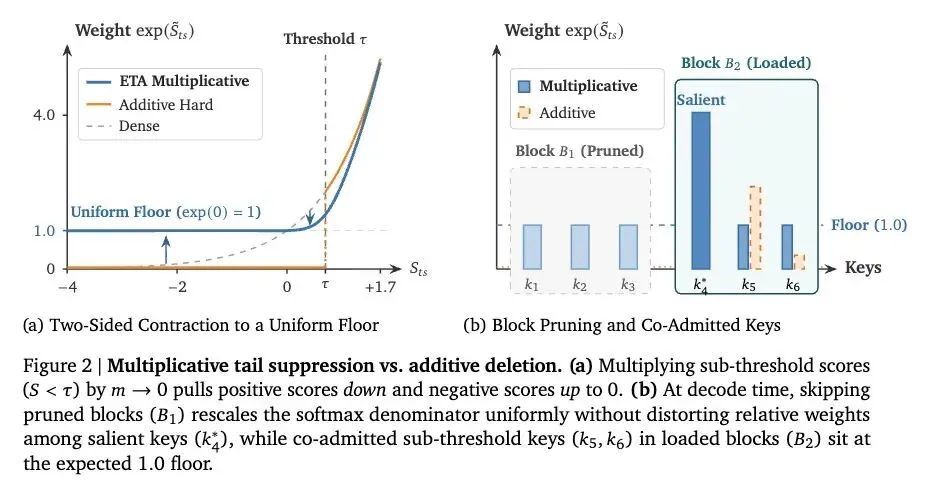
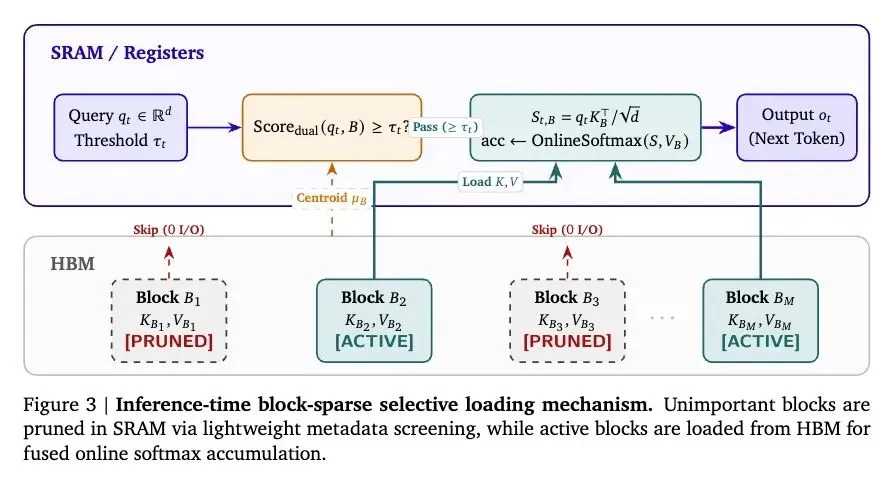
挑战了可训练稀疏注意力机制中依赖硬性加法掩码(将未选中Token的逻辑值设为)的传统做法,指出这种做法会导致注意力分布脆弱并在推理时引起性能退化。 提出了弹性阈值注意力(ETA)及创新的“乘法抑制(multiplicative suppression)”机制:将低于阈值的逻辑值向压缩而不是向压缩。因为,这为被剪枝的键(Keys)创造了一个平坦的“统一注意力底噪(uniform attention floor)”。 提出了一个极其反直觉的发现:这个统一的注意力底噪彻底消除了著名的“注意力汇聚(Attention Sinks)”现象(即初始Token囤积- 揭示了统一注意力底噪使模型对硬件级的“块级过度包含”具有极强的鲁棒性。在粗粒度GPU内存块中附带加载的低重要性Token几乎不会引起分布偏移,从而避免了硬掩码模型中出现的严重困惑度惩罚(+16.6%)。 通过极轻量级的线性映射(参数开销<0.1%)实现基于Query的动态阈值预测,允许模型根据语义难度自适应分配注意力预算(例如在检索时扩大上下文,在常规Token上压缩上下文)。 通过定制的融合Triton块稀疏解码算子,将理论上的算法稀疏性转化为实际的硬件加速。该算子利用轻量级双重概率-几何块索引(缓存质心、方差和最大范数),在时间内筛选无关的KV块,直接绕过高带宽内存(HBM)的数据传输。 展示了一个关于块粒度的反直觉结论:在组查询注意力(GQA)架构下,当物理HBM传输预算固定时,粗粒度块()的困惑度表现实际上显著优于细粒度块()。因为粗粒度块自然地将不同查询头的重叠选择合并,在同等I/O成本下增加了每个头可利用的有效Token预算。 实验证明,1.45B的ETA模型在约38%的活跃解码密度下,在困惑度基准、推理和长上下文检索(在8192长度的大海捞针测试中保持性能,而密集模型在此崩溃)方面,均达到了与密集注意力相媲美的水平。 在长达512K Token的序列长度上,相比FlashAttention-2实现了高达2.5倍的实际挂钟(wall-clock)解码加速。 引入了一种离线校准算法,针对固定领域的部署场景,可将动态预测器蒸馏为冻结的静态每头常量,在不损失质量的前提下进一步节省27%的注意力计算量。
主旨: 本文主要解决大型语言模型在超长上下文解码阶段由于海量KV Cache带来的严重内存带宽瓶颈问题。现有的稀疏注意力方法要么采用死板的启发式规则(导致丢失关键上下文、质量下降),要么引入复杂的路由和硬剪枝(导致训练与推理存在分布鸿沟)。为此,论文提出了弹性阈值注意力(ETA),一种端到端可训练的架构,旨在不牺牲密集模型质量的前提下,实现硬件加速的动态上下文稀疏解码。
创新:
乘法抑制机制取代硬掩码:不使用将未选中Token的得分置为的破坏性硬掩码,而是用Sigmoid门控进行乘法缩放,将得分拉向,巧妙地构建了不影响相对权重的“统一注意力底噪”。 动态上下文感知阈值预测:无需引入复杂的多分支结构或教师模型,仅用极小的线性映射层,让模型根据当前Query的语义难度直接预测稀疏阈值。 O(1)复杂度的双重概率-几何筛选:在硬件层面,设计了只保留质心、方差和最大范数元数据的缓存机制,通过极低开销的数学边界计算,在SRAM中直接判断并跳过不重要的HBM块加载。 固定场景的离线蒸馏校准:提出了一种基于 加权直方图的离线校准算法,将动态阈值精准转换为静态阈值,消除推理时的预测器开销。
贡献:
理论发现:揭示了乘法抑制不仅能使模型在推理时对粗粒度GPU块的“过度包含”免疫,还能从根本上消除业界公认的“注意力汇聚(Attention Sinks)”现象,证明了这并非Softmax固有的缺陷,而是缺乏概率缓冲池所致。 算法设计:提出了一种极简但高效的端到端可训练稀疏注意力架构ETA,仅增加不到0.1%的参数量即可实现高度的动态稀疏性,并且网络能在不同深度(Layer)自发演化出专业化的稀疏分工。 硬件与系统协同:开发了专用的GQA感知Triton融合解码算子,完美适配现代GPU内存架构,成功将理论上的FLOPs减少转化为了高达2.5倍的端到端实际吞吐加速。 实证突破:在1.45B参数规模上证明了ETA能在保持约85%的训练稀疏度和38%的推理密度的同时,在语言建模、常识推理和长文本检索(大海捞针)任务上匹敌甚至超越全量密集注意力模型。
提升:
解码速度(Wall-Clock Speedup):在大批量(Batch- 内存I/O效率(HBM Traffic):通过动态剪枝,将物理KV Cache的HBM读取量降低至全量的16%到51%(取决于设定的密度工作点)。 长文本事实检索鲁棒性:在Needle-in-a-Haystack测试中(长度达8192),基于启发式丢弃的方法(如StreamingLLM, H2O)准确率暴跌至0%,而ETA通过自适应扩展注意力窗口,成功保留了检索能力,甚至在极端长度下优于标准Dense模型。
不足:
模型验证规模受限:目前实验最大规模为1.45B参数,尚未在7B-70B+等前沿超大模型规模上验证该机制的扩展性(Scaling laws)。 多模态与复杂任务覆盖不足:当前的基准测试主要集中在纯文本语料,针对多模态序列、超大型代码仓库生成以及长跨度复杂推理轨迹的有效性尚未充分验证。 硬件特性的极致压榨仍有空间:算子目前基于FP16实现,尚未整合Hopper架构最新的异步TMA流水线、Warp特殊化,以及FP8/INT4等下一代KV Cache量化技术。
心得:
重新思考“废弃信息”的数学表达方式:业界普遍认为剪枝就是将注意力得分置为 (即物理消灭),但本文证明将其压缩至 从而产生 的“底噪”反而更好。这启发我们,在神经网络中,“如何忽略信息”与“如何关注信息”同等重要;保留统一的背景噪声可以极大地增强模型面对分布外扰动(如硬件分块带来的多余Token)的鲁棒性。 “注意力汇聚(Attention Sinks)”并非绝症,而是设计的副产物:此前StreamingLLM等工作认为,初始Token吸收大量注意力是Softmax机制的必然缺陷,必须靠强制保留前几个Token来打补丁。本文通过优雅的算法改进证明,只要给Softmax提供一个均匀的概率泄洪区(底噪),所谓的“Sink”现象就会自然消亡。这提醒我们,在做系统优化时,应追求从机制根源解决问题,而非盲目叠加Heuristics补丁。 软硬件协同设计中“反直觉”的粒度权衡:从纯算法角度看,分块越细(如b=4)剪枝越精准;但结合GQA(组查询注意力)的物理访存特性来看,粗粒度分块(b=64)反而能让不同查询头的重叠需求被同一物理块摊销,使得在相同的内存带宽消耗下,每个头看到了更多的Token,最终困惑度更好。这深刻启示我们:脱离硬件底层的纯算法评估往往是片面的,优秀的AI系统创新必须让算法逻辑向硬件物理逻辑妥协甚至借力。
一句话总结: ETA通过首创的“乘法抑制”机制生成统一注意力底噪,不仅自然消除了长文本模型中的“注意力汇聚”缺陷,还结合定制的Triton算子实现了无需牺牲密集模型质量的动态上下文稀疏化,在高达512K的超长序列解码中实现了2.5倍的硬件级挂钟加速。
Massive KV caches can cause severe memory-bandwidth bottlenecks during long-context decoding. Sparse attention methods mitigate this via selective loading, but that comes at a cost: rigid heuristics drop necessary context, leading to quality degradation. We introduce \textbf{Elastic Threshold Attention (ETA)}, an end-to-end trainable architecture that achieves hardware-accelerated decoding speed without sacrificing dense model quality. ETA predicts dynamic, contextual thresholds directly from query representations, allowing the model to allocate dense-like context to difficult retrieval or reasoning steps while pruning routine tokens. To learn this policy from scratch without representation collapse, ETA \emph{multiplicatively suppresses} sub-threshold logits toward zero during training rather than deleting them. Training against this smooth uniform attention floor provides a distributed probability reservoir that \textbf{causes localized attention sinks on initial tokens to disappear}. It also enables the model to hard-prune uninformative KV blocks at inference time and absorb incidental tokens co-admitted by coarse GPU block selection. As a result, a 1.45B pretrained ETA model rivals dense attention across language modeling, commonsense reasoning, and long-context needle retrieval at ≈85%\approx 85% training sparsity and ≈38%\approx 38% active decode density. At inference time, we implement a custom decode kernel in Triton that screens KV blocks in O(1)O(1) time using cached geometric-probabilistic bounds, delivering up to 2.5×2.5\times wall-clock decode speedups over FlashAttention-2 on sequences up to 512K tokens. Finally, we introduce an offline calibration algorithm for domain-specific deployments that freezes per-head constant thresholds to eliminate predictor overhead, cutting attention compute by an additional 27%27%.
https://arxiv.org/abs/2609.20888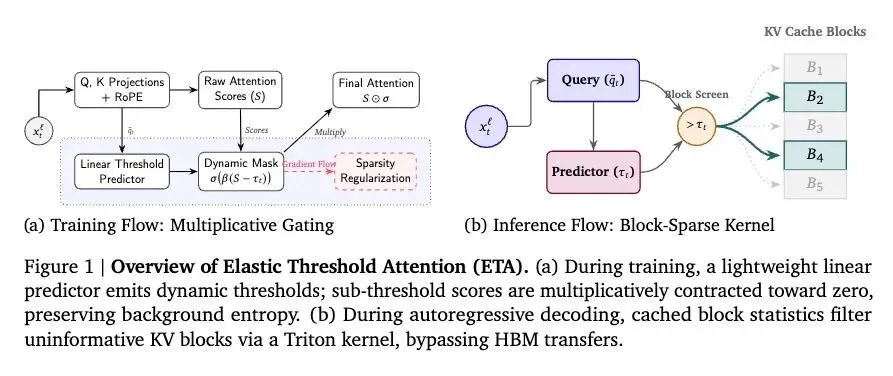
3、[LG] Scaling Discovery through Test-Time Communication
J Park, V Kontonis, S Garg, A Krishnamurthy…
[UC Berkeley & Microsoft Research]
通过测试时通信实现探索能力的规模化扩展
要点:
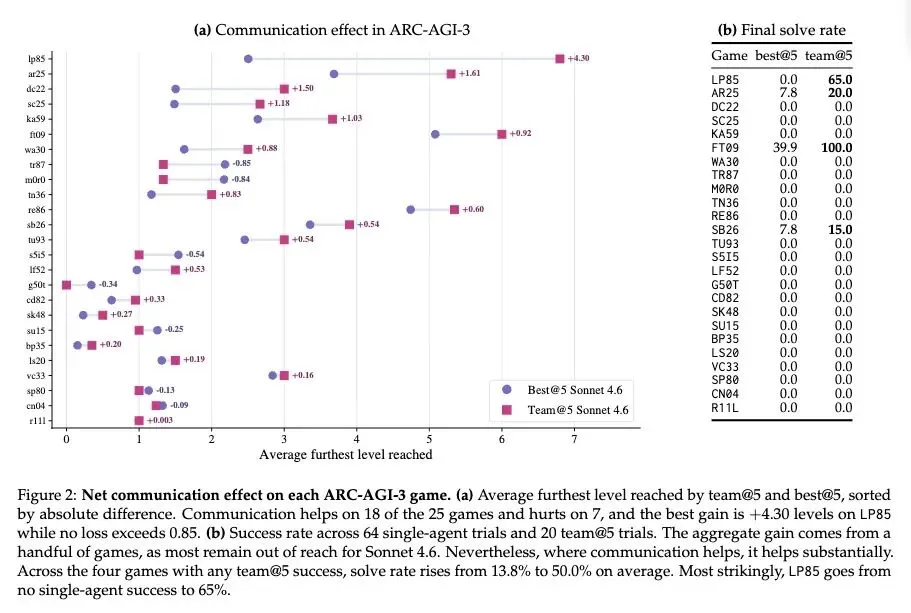
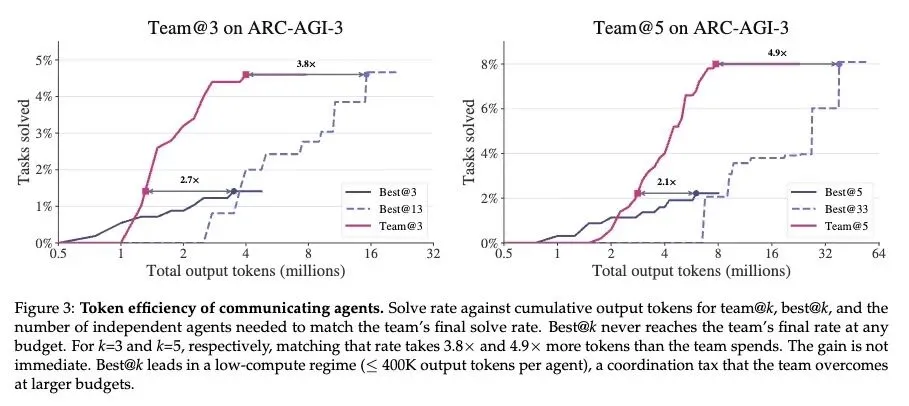
挑战了以往关于多智能体辩论效果褒贬不一的结论,证明了通过共享工作空间进行的无结构、异步的测试时通信(Test-Time Communication)显著优于独立的并行搜索(best@k)。 提出了“经验证的进度共享(Verified Progress Sharing)”这一关键概念:通信的成功不是依赖语言上的说服或辩论,而是当智能体拥有客观的验证器,能在共享前验证中间突破时才会奏效。 揭示了一个极具反直觉的“协调税(Coordination Tax)”现象:在低算力预算或短时间窗口下,独立智能体的表现实际上优于通信团队。只有当算力充足,使得团队能够在彼此的发现基础上继续构建时,团队才会实现反超。 证明了通信带来的复合缩放定律:在ARC-AGI-3基准测试中, team@3的解决率等同于13个独立智能体(4.3倍杠杆),而team@5等同于33个独立智能体(6.6倍杠杆)。发现协作能提升所有参与者的基线水平:在5个智能体组成的通信团队中,其“平均”智能体的动作效率(RHAE指标)竟然与5个独立运行智能体中的“最佳”智能体持平。 在困难的优化任务上达到SOTA:在MNIST模型压缩任务上,通过成功合并不同智能体废弃或表现不佳的分支,最终击败了已知的人类最佳解决方案(1957字节 vs 2461字节)。 强调了一个关键的失败模式:在Terminal-Bench 2.0中(其中间反馈稀疏且不可靠),通信团队未能击败独立的 pass@2,这证明了可访问的环境验证器是有效多智能体协作的严格先决条件。
主旨: 本文探讨了在开放式发现和复杂科学/工程任务中,基于大语言模型的智能体在测试时(Test-Time)进行相互通信,是否以及在何种条件下能够超越传统的独立并行采样(best-of-k)机制。
创新:
设计了一种极简的无中心测试时通信框架:摒弃了预设角色分配和中央协调器,智能体通过共享文件系统和仅追加的日志进行异步通信。 引入了基于“客观验证”的采纳机制(Verified Progress Sharing),智能体只有在看到明确的验证分数提升时才会采纳同伴的策略,并被强制要求保留一定的策略差异性以防过早趋同。
贡献:
理论贡献:建立了一个数学模型来解释通信如何将并行探索中的“求和的最小值”转化为“最小值的求和”,从理论上量化了进度共享带来的指数级分离优势。 实践贡献:在逻辑推理(ARC-AGI-3)、算法优化(Polyomino Packing)和机器学习工程(MNIST压缩)三个跨度极大的复杂任务上,均取得了超越最佳独立智能体甚至人类专家的SOTA成绩。 边界条件界定:明确界定了多智能体通信有效的两大先决条件——充足的算力预算(以克服协调税)和可靠的中间步骤验证器(以避免盲从和专业能力被稀释)。
提升:
任务解决率与缩放效率:在ARC-AGI-3中,以更少的总Token消耗实现了数倍于独立智能体规模的解决率(例如匹配 team@5的成功率,独立智能体需要多消耗4.9倍的Token)。突破单体能力天花板:解决了多个单一智能体尝试64次依然成功率为0%的困难任务(如ARC的LP85关卡,团队成功率提升至65%)。 长期复杂工程突破:在多日级别的MNIST压缩任务中,突破了单体智能体3160字节的瓶颈,甚至超越了2461字节的人类历史最佳记录,达到1957字节。
不足:
严重依赖中间验证器:当任务缺乏可靠的中间反馈(如Terminal-Bench 2.0),智能体无法评估他人进展时,通信效果不仅无法提升,反而可能因为干扰而略逊于独立采样。 小预算下的性能惩罚:由于存在“协调税”,在算力受限或时间极短的情况下,团队通信的表现不如让智能体独立工作。 缺乏对通信拓扑的探索:本文仅测试了全局共享工作空间(广播模式),尚未探索在更大规模智能体网络下,不同的通信拓扑结构(如局部通信、分层通信)可能带来的影响。
心得:
“协调税”现象不仅存在于人类社会,也存在于AI智能体中:论文中发现的“协调税(Coordination Tax)”极其反直觉且深刻。在项目初期或预算极低时,智能体为了阅读同伴日志、进行同步和避免文件冲突,反而拖慢了进度。这启发我们,在设计Agentic系统时,对于短平快的简单任务应坚持单体并行(best-of-k),只有面对需要长期探索的深水区任务,才值得引入通信机制。 用“环境验证”代替“语言辩论”是避免Agent幻觉共识的关键:过去许多多智能体研究(如Debate)失败,是因为LLM在语言交互中容易相互妥协,产生“盲人摸象”式的平庸共识。本文最大的启发在于,让环境(代码执行器、分数评估器)充当唯一的裁判。智能体之间不争论谁对谁错,只分享“我用X方法在验证器上拿到了Y分”,这种“经验证的进度共享”才是实现科学突破的正确路径。 “基因重组”比“单线进化”更强大——废弃分支的再利用:在MNIST压缩案例中,最惊艳的一幕是最终的SOTA模型并非由一个最强智能体单干出来的,而是Agent A将自己已经落后/废弃的模型架构,与Agent B的优秀评分层机制进行了融合(Recombination)。独立并行运行永远会丢失这些在某个局部有价值、但整体未达标的中间产物,而测试时通信赋予了AI系统类似人类科学界“站在巨人肩膀上”进行重组创新的能力。
一句话总结:
本文证明了在拥有可靠验证器和充足算力以克服“初期协调税”的前提下,赋予智能体通过共享空间进行“经验证的进度共享”的能力,能够使其在复杂推理和长期工程任务中打破独立并行的能力天花板,以指数级优势超越独立的best-of-k方法并取得远超人类专家的SOTA成果。
Science advances not in isolation but through collaboration, yet existing agentic systems capture little of this. Whether communicating agents help remains an open question with mixed prior results. We show that test-time communication can substantially outperform independent parallel attempts on challenging tasks, where sharing a breakthrough can push the whole group forward. We first study the effect of scaling multi-agent test-time communication, where agents have no predefined roles and communicate via a shared directory, on ARC-AGI-3, a benchmark requiring novel problem solving. We find that a team of kk communicating agents, team@kk, matches the success rate of 4k4k independent agents, and this advantage grows with kk, suggesting gains compound with scale. The effect is not merely efficiency: a task that no single agent can solve, a team of agents can solve reliably. Furthermore, these gains transfer to research-oriented tasks, given sufficient compute. On polyomino packing, communicating agents outperform best@kk and exceed the prior best-known score. On MNIST classifier compression, communication surpasses the best-known human solution. A team of four agents produced a 1,957-byte classifier submission achieving 99.4% test accuracy, smaller than both the best-known human solution and the best single-agent result. These gains are not unconditional. Independent agents may outperform communication when compute is limited or when a clear measure of progress is absent. However, under sufficient compute and clear feedback, multi-agent communication consistently yields stronger results.
https://arxiv.org/abs/2609.21032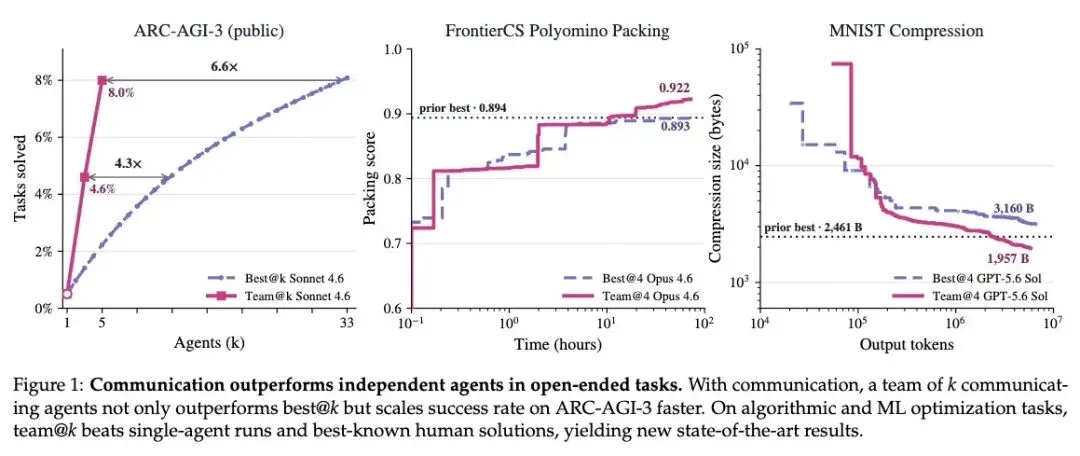
4、[LG] SWE-Proof: Can Language Models Resolve Real-World Issues with Machine-Checked Proofs?
G Ma, B Mikek, H Li, F Erata…
[UC Berkeley & Georgia Tech & UIUC]
WE-Proof:语言模型能否通过机器校验的证明解决现实世界的问题?
要点:
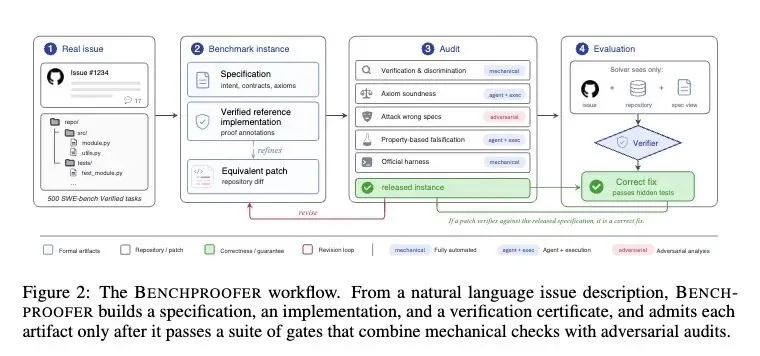
隐藏测试用例极度脆弱(反直觉): 在标准基准测试中,通过了所有隐藏测试用例的 LLM 生成补丁,在经过形式化验证或对抗性审计后,仍有 25% 到 50% 被发现存在致命缺陷。 让模型自己写规约并验证毫无用处(高信息熵): 强制 LLM 先编写形式化规约(Specification),然后验证其代码,其最终修复率与完全不提供验证工具的“裸奔”基线相比,没有任何提升。 提供黄金标准规约能带来巨大飞跃: 当直接提供正确的、Ground-truth 级别的形式化规约时,模型的修复率飙升(例如,Claude Opus 4.8 的修复率从 85.0% 跃升至 95.1%,GPT-5.5 从 81.2% 提升至 94.7%)。 真正的瓶颈是“规约合成(Specification Synthesis)”: LLM 在形式化验证中失败的根本原因,不在于写不出代码或数学证明,而在于它们无法从非正式的自然语言需求中合成高质量的形式化规约。 “忠实度(Faithfulness)”缺失是核心灾难: 当 LLM 自己写规约时,它们能正确约束自己关注到的局部代码,但在“忠实度”上彻底翻车——它们往往遗漏了 Issue 中要求的其他关键行为边界,导致验证通过的代码依然无法真正解决问题。 结构化自然语言无济于事: 仅使用结构化的自然语言(如 EARS 格式)编写需求并不能填补测试用例的漏洞;只有借助数学/逻辑级别的形式化规约(通过 SMT 求解器或 Lean 验证),才能真正消除测试的盲区。 通过“公理化”实现真实世界验证: 为了在庞大的真实代码库中验证代码,论文提出了 BENCHPROOFER管道,它不需要验证整个代码库,而是通过“公理(Axioms)”对未修改的复杂依赖环境(调用函数)进行抽象总结,使得极其复杂的真实世界验证成为可能。推出 SWE-PROOF 基准: 首次将形式化验证机制引入真实世界软件工程任务(包含 500 个 SWE-bench Verified 任务),支持 Nagini、Velvet 和纯 Lean 三种后端引擎。
主旨: 当前评估 LLM 代码生成 Agent 主要依赖于“隐式测试用例(held-out tests)”,但这不仅不完整,还容易导致模型产生“奖励作弊(reward hacking)”和记忆效应。虽然形式化验证(Formal Verification)可以解决这些问题,但现有技术仅限于处理简单的独立算法题,无法应对真实世界中涉及庞大代码库、复杂依赖以及模糊自然语言意图的软件工程(SWE)问题。本文旨在填补这一空白,探究大语言模型是否能利用机器验证的数学证明来解决真实的软件工程问题。
创新:
提出了 BENCHPROOFER管道,它创新性地利用“环境公理化(Environment Axiomatization)”技术,将复杂代码库中不需要修改的底层调用抽象为“公理”,从而极大降低了真实世界代码的验证复杂度。引入了“机械验证 + 多重对抗性 LLM 审计”的混合门控机制(Correctness Gates),严格确保形式化模型与真实 Python 代码、自然语言意图之间的等价性。 将验证的重点从“代码生成”转移到“规约生成”,并在极其严苛的条件下(支持纯逻辑和可执行层面)对比了不同形式化后端(Nagini, Velvet, Lean)的效果。
贡献:
基准构建: 开源了首个附带形式化验证预言机(Oracle)的真实世界 SWE 基准测试 SWE-PROOF,涵盖 SWE-bench Verified 的 500 个任务及 SWE-bench Pro 的扩展。揭露了当前评估范式的致命缺陷: 用严谨的证明手段实证了当前主流的“通过测试用例即正确”的评估标准存在 25%~50% 的巨大水分。 明晰了未来技术路径的瓶颈: 明确指出阻碍大模型实现 100% 绝对正确代码生成的瓶颈不是写代码或写证明,而是缺乏从模糊自然语言到严谨形式化规约的“忠实翻译(Faithful Specification Synthesis)”能力。
提升:
修复上限大幅提升: 在排除了测试用例不完整性带来的假阳性后,提供正确的形式化规约将前沿模型(Claude Opus 4.8)的绝对真实修复率从 85.0% 提升到了 95.1%。 消除了伪正确: 相比于仅依赖测试用例,该框架通过数学证明,100% 确保了在规约定义的输入域内不存在任何会导致 Bug 的边缘情况。
不足:
适用范围的局限性: 形式化验证本质上只能约束“值域(Value Domain)”的计算结果。如果 Bug 修复涉及的是变量重命名、代码重定位、内部数据结构变更或系统级 I/O 副作用(这在 SWE-bench Pro 中导致 22 个任务无法被建模),该方法将无能为力。 意图鸿沟无法在数学上闭环: 虽然论文使用了多轮对抗性审计来确保“形式化规约”符合“人类自然语言意图”,但这一步依然存在主观性,无法通过纯数学手段进行 100% 的绝对证明(即 Intent-Specification Boundary 问题)。
心得:
测试通过率的“虚假繁荣”值得警惕: 论文极其反直觉地指出,当前动辄 80% 甚至 90% 的 SWE-bench 测试通过率中,有很大比例是利用了测试用例的不完备性达成的“伪修复”。这提醒我们在评估 AI 程序员时,不能盲目迷信测试指标,必须引入形式化或对抗性审计。 “定义问题”比“解决问题”更难: 当给模型完美的数学规约时,它写代码和证明的能力令人惊叹;但让模型自己去把一句人话(Issue)转化成全局严谨的规约时,它往往只顾及局部,漏掉边界(忠实度失败)。这深刻启发我们:未来 AI 软件工程的核心门槛,是需求工程(Requirements Engineering)和系统建模能力,而非单纯的编码能力。 “公理化(Axiomatization)”是复杂系统推理的利器: 真实世界的代码库如同汪洋大海,模型无法把所有上下文塞进上下文窗口进行逻辑推理。论文通过将无需修改的函数抽象为“公理黑盒”,完美隔离了复杂度。这种“契约式/公理化”的上下文截断思想,对我们优化 RAG 系统、设计多智能体协作框架具有极高的参考价值。
一句话总结:
本文推出了首个真实世界软件工程的形式化验证基准 SWE-PROOF,揭示了当前基于测试的评估体系放过了 25%~50% 的残缺补丁,并极其反直觉地指出:阻碍大模型完美修复 Bug 的真正瓶颈根本不是“写代码”或“写证明”,而是无法忠实且全面地将人类模糊的自然语言意图转化为严谨的形式化规约。
Ensuring the correctness of LLM-generated code is a core challenge for modern software engineering. Benchmarks for agentic code generation check correctness with held-out test suites, which are inherently incomplete and increasingly susceptible to memorization. Formal verification avoids both problems, but existing work covers only standalone tasks whose specifications are given as input, not real issues, which touch large repositories and state intent in vague natural language. We present Benchproofer, a pipeline that turns a coding task with a known correct patch into a formally verified one: it writes a specification for the new code, summarizes the existing functions that code calls with axioms, and admits an instance only after mechanical and adversarial gates agree. Applying it to SWE-bench Verified yields SWE-Proof, 500 real issues whose correctness is formally verified rather than tested, and it extends to SWE-bench Pro. Across two frontier models, verification catches what tests miss: a quarter to a half of test-passing patches admit counterexamples, which a structured natural-language specification does not fix, while a correct formal one lifts resolution from 85% to 95% for Opus 4.8. Writing that specification is the hard part: models that must write their own gain nothing over an unaided baseline, and only 62% of their specifications pass our audit. The usual failure is faithfulness, a specification that constrains part of the required behavior and leaves the rest free. Specification quality still tracks the outcome, failing on 89% of unresolved instances against 47% of resolved ones, making faithful specification synthesis a concrete open problem.
https://arxiv.org/abs/2609.21190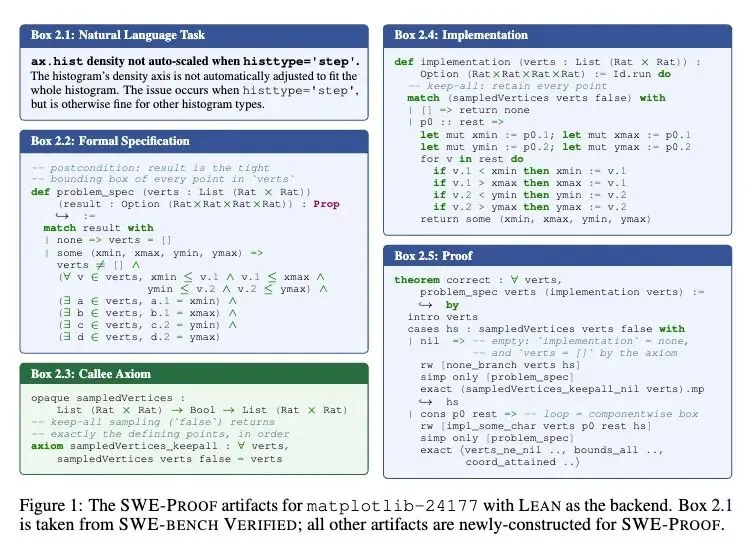
5、[AI] Attention-Aware Routing: Coupling Routing and Attention in MoEs
D Kosmopoulou, A Tsetsilas, E Georgiou, G Karamanolakis…
[National Technical University of Athens & University of Bern]
注意力感知路由:MoE 架构中路由与注意力机制的深度耦合
要点:
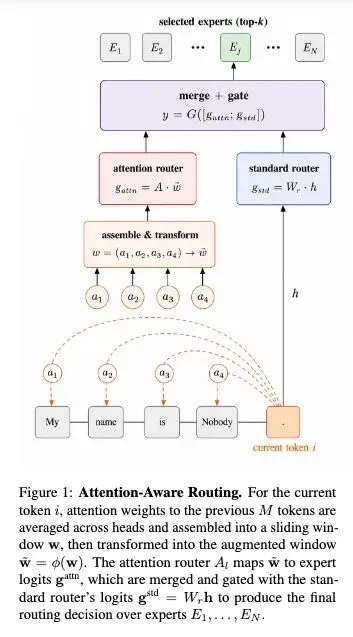
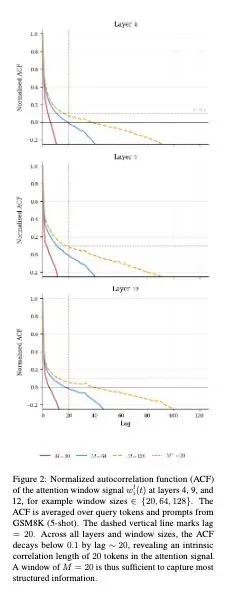
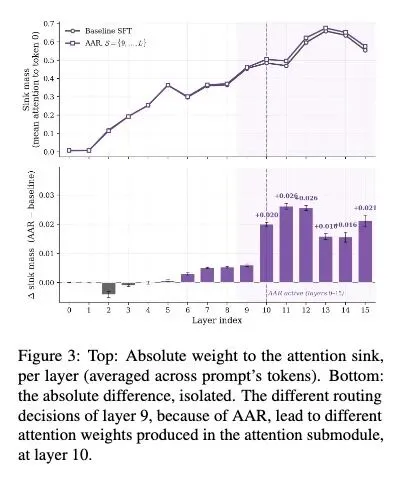
挑战了仅依赖隐藏状态的传统MoE路由范式,引入了“注意力感知路由”(AAR),该方法利用近期注意力权重的滑动窗口(包含时域和频域特征)进行专家分配。 高信息熵/反直觉观点:证实了“路由-注意力耦合”回路的存在。仅仅改变第 层的路由决策,就能通过残差流传播,物理性地重塑第 层的注意力权重分布(特别是放大了聚焦于首个Token的“注意力汇聚点/Attention Sink”),而无需对注意力机制本身进行任何参数更新。 模型行为转变:AAR 能精准减少错误答案中的冗长、发散性生成(“胡言乱语”),使错误答案的平均长度减少了11.8%,极端长尾长度减少了14.9%,同时保持正确答案的生成长度完全不变。 揭示了反直觉的、跨越模型深度的“检索-推理张力”。将 AAR 应用于所有层会严重降低事实检索任务(如MMLU的生物/历史)的性能。研究表明,浅层对事实查找极其敏感且高度特化,而中深层则专攻数学推理,能够从 AAR 中获得巨大收益。 证明了注意力信号的内在相关长度大约为20个Token;因此,一个相对较小的窗口( 到 )就足以捕捉路由器所需的结构化信息。 在冻结基础模型、仅训练路由参数的极端设置下,AAR 在 OLMoE 模型上实现了 GSM8K 准确率 +3.37 pp 和 MATH-500 +2.64 pp 的提升,且该增益可扩展至 Qwen3.6-MoE (35B) 等更大规模的模型。
主旨: 本文探讨了在混合专家(MoE)语言模型中,仅依赖隐藏状态的传统路由器无法有效解耦上下文信息与内容信息的问题。为此,论文提出了一种“注意力感知路由”(AAR)机制,通过引入注意力权重的滑动窗口作为额外的路由信号,在提升模型数学推理能力的同时,揭示了路由决策与注意力机制之间深刻的耦合关系,以及模型在不同深度的功能分化。
创新:
注意力权重作为路由特征:首次将近期生成的注意力权重(通过时域滑动窗口和频域DFT变换)作为独立的上下文信号引入MoE路由器中。 孤立控制变量的训练范式:在微调过程中完全冻结Transformer骨干网络,仅训练路由参数,从而将“路由”作为唯一的实验变量,精准剖析其对模型生成行为的直接影响。 基于路由的层级功能探测器:利用 AAR 在不同层级接入时的性能波动,创新性地将其作为一种“探测器”,精准定位了模型在处理事实检索与复杂推理时的层级分工边界。
贡献:
性能提升:证明了为路由器提供上下文信息(AAR)可以直接且显著地提升下游数学推理任务(如GSM8K, MATH-500)的性能。 发现路由-注意力耦合机制:揭示了路由参数的改变能够跨层传播并放大下游的“注意力汇聚点(Attention Sinks)”,证明了路由不仅是分配计算资源的开关,更是间接调节注意力分配的核心组件。 缓解“过度思考”现象:发现 AAR 能够在不影响正确推理路径的情况下,敏锐地截断模型在错误方向上的发散性长篇大论,降低了冗余计算。 揭示层级异质性:明确提出了“检索-推理张力”概念,证明了浅层负责事实检索,中深层负责逻辑推理,为未来的层级选择性干预提供了理论依据。
提升:
数学推理准确率:在 GSM8K (OLMoE上提升 3.37 pp) 和 MATH-500 等数据集上超越了仅进行路由微调的基线模型。 生成效率与质量:显著降低了错误回答的“冗长率 (Ramble Rate)”(降低了23.9%),使模型在“不知道”时能更快结束生成,提高了推理效率。 注意力稳定性:通过放大注意力汇聚点(Attention Sink),增强了模型在处理长上下文或流式输入时的表征稳定性。
不足:
计算开销限制:AAR 需要显式地实例化注意力权重矩阵,这破坏了标准 FlashAttention 的内存优化机制,导致在激活 AAR 的层引入了与序列长度成正比的额外计算开销。 训练阶段局限:目前的实验仅局限于 SFT(监督微调)后的适配阶段,AAR 在从头预训练或全参数微调阶段的最佳实践和泛化能力尚未验证。 泛化策略的依赖性:由于“检索-推理张力”的存在,AAR 无法盲目应用于所有层,需要依赖经验或启发式方法(通常是中深层)来选择激活 AAR 的特定层,缺乏自适应的层级动态分配机制。
心得:
打破模块化错觉,重视组件间的隐式耦合:我们通常认为Transformer的路由层和注意力层是各司其职的独立模块。但本文惊人地表明,仅仅改变路由层的选择,就能在下一层产生物理层面的注意力重塑。这启发我们在设计神经网络架构时,不能孤立地优化单一模块,而必须考虑残差流中信息的“蝴蝶效应”。 “废话多”往往是模型犯错的先兆:AAR 能够精准缩短错误答案的长度,这从侧面印证了LLM在进行思维链(CoT)推理时,如果偏离了正确路径,往往会陷入“过度思考(Overthinking)”或产生幻觉式的长篇大论。通过更敏锐的上下文感知来尽早截断这种发散,是提升推理效率和可靠性的重要方向。 模型深度的“解剖学”价值:浅层认死理(检索事实),深层善思考(逻辑推理)。这一发现对于PEFT(参数高效微调)具有极高的指导价值。未来在进行知识注入时应着重微调浅层,而在提升推理和对齐能力时应聚焦中深层,盲目的全局微调可能是次优甚至有害的。
一句话总结: 本文提出利用注意力权重的滑动窗口来指导MoE路由选择(AAR机制),不仅在无需更新注意力层的情况下奇妙地放大了下游的注意力汇聚点、有效截断了错误回答的冗长生成,还深刻揭示了模型浅层主导检索、深层主导推理的层级功能差异。
In Mixture-of-Experts language models, the router typically selects and weights experts based on the token’s hidden state, utilizing limited contextual information. We propose Attention-Aware Routing (AAR), which augments the router with temporal and spectral features extracted from a sliding window of attention weights that represent a summary of the model’s contextual state, disentangled from the hidden state. Keeping the base transformer entirely frozen, we train only the routing parameters, isolating routing as the sole variable. AAR improves GSM8K by +3.37 pp over a routing-only SFT baseline on OLMoE. Beyond performance, we show that routing and attention form a coupled circuit: routing changes at layer l propagate through the residual stream to amplify attention sinks at layer l + 1, reshaping attention without any direct update to the attention mechanism itself. Further, AAR reduces long diverging generation, with incorrect answers getting shorter, while correct answers remain unchanged in length. Finally, AAR is strongly depth-sensitive: applying it indiscriminately across layers can degrade factual retrieval, whereas mathematical reasoning gains persist when it is introduced deeper in the network. This sensitivity exposes a retrieval– reasoning tension across depth and makes layerselective AAR a controlled probe of the routingrelevant information carried by attention at different layers.
https://arxiv.org/abs/2609.20974