ARTICLE · 1057482
照着官方文档写,为什么 skill 还是不好用
每条建议都对。但每条都拖着一句没写出来的前提——写之前先问三句。
上一篇结尾我给自己挖了个坑:说要拆「为什么照着官方文档写,反而写不出好用的 skill」。
这篇填坑。
先把话说公道:官方文档没有错。 description 要具体、宁可写得有侵略性、步骤拆细——每一条都对。我第一个 skill(就是那个发公众号的)就是照着文档一步步搭起来的,这三条全照做了。
但它最后能跑起来,靠的不是文档里那几条。是凭据存进 DPAPI 保险箱、是绕过 PATH 的壳脚本、是渲染失败自动切副引擎——全是文档里没有的东西。
问题出在哪?
每条建议都有前提,而文档没写前提。
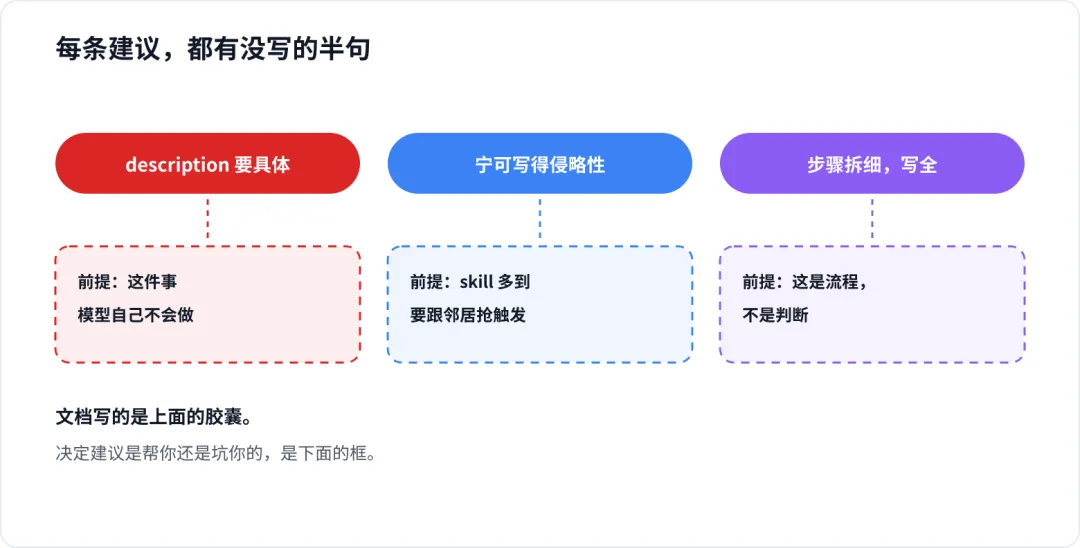
三条建议,三个没写的半句
第一条:「description 要写得具体。」
对。但它的前提是:这件事模型自己不会做。
第五篇引过官方文档里一个细节:Agent 只会在"这件事超出它自身能力"的时候,才去翻 Skill。模型自己会的活——读个 PDF、写个正则、总结一段话——你的 description 写得再具体,它也不翻。
不是描述不好,是它不需要。给一个本来就不该存在的 skill 打磨描述,是在给不存在的问题写标准答案。
第二条:「宁可写得有侵略性。」
对。但它的前提是:你的 skill 在跟一堆邻居抢触发。
装了两三个 skill 的时候,写"我是干什么的"就够了——没有竞争,模型一眼挑得中。侵略性是为拥挤世界设计的:装了十几个、个个都跟"代码""文档"沾边的时候,你才需要那句"不用于什么"来划地盘。
数据很直白(还是那篇 SkillsBench):
| 2–3 个 | +18.6pp |
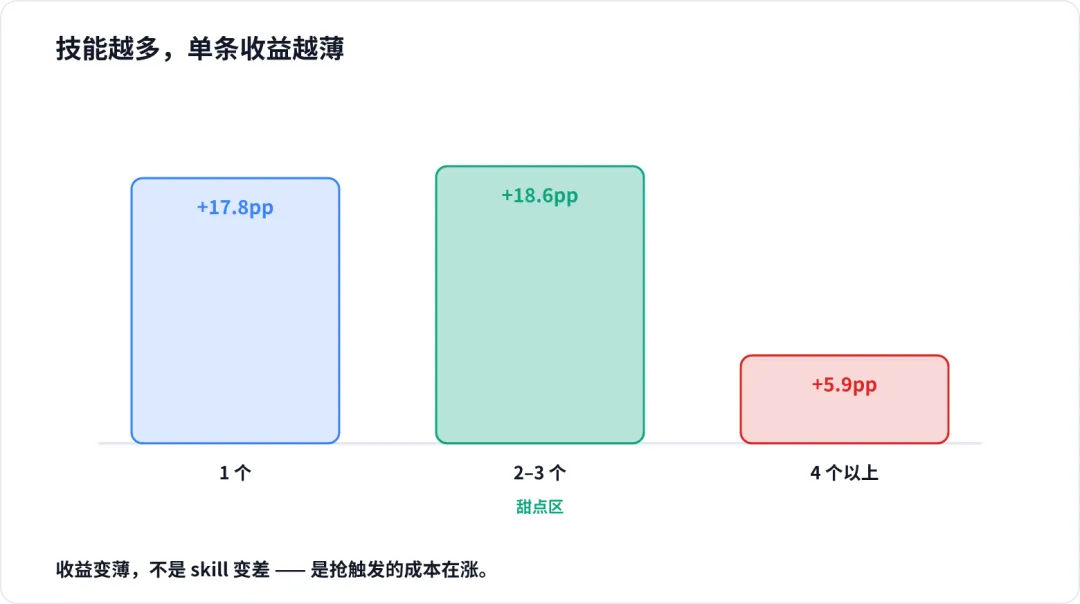
技能越多,单条的收益越薄——不是 skill 不好,是抢触发的成本在涨。「宁可侵略性」教你的,是怎么在 4 个以上的世界里活下来。你只装了两三个,却照着学 aggressive 写法,多半是在给自己制造误触发。
第三条:「步骤拆细,写全。」
对。但它的前提是:这是流程,不是判断。
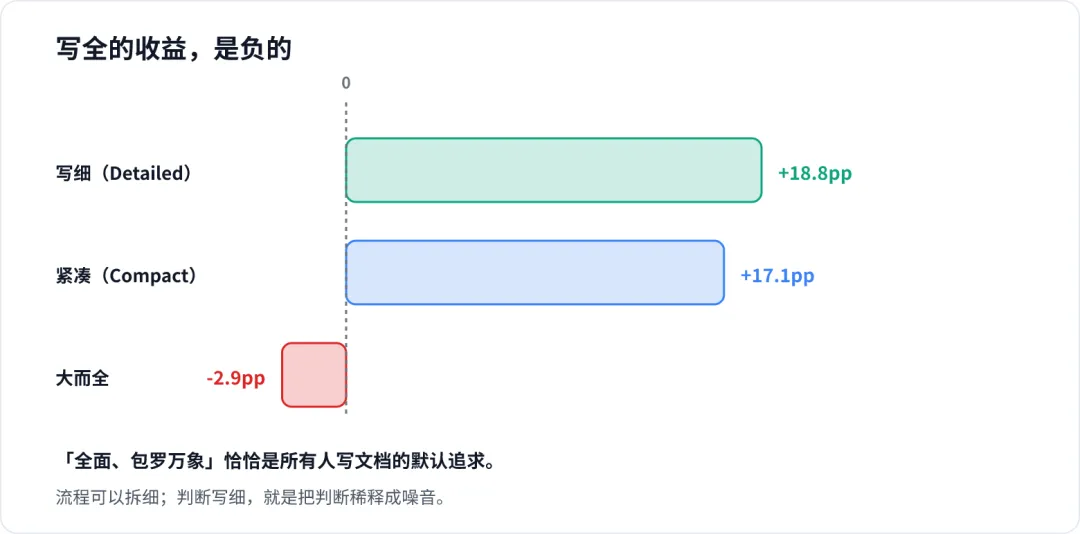
同一篇论文里的另一组数字:
| 大而全(Comprehensive) | −2.9pp |
写全的收益是负的,第六篇拆过原因。这里补一句更准的:流程可以拆细,判断不能。
"第一步看 A、第二步看 B"这种确定性步骤,拆得越细越好。但"看一眼才知道这次一样不一样"的活,把步骤写死等于把判断稀释成噪音。该写的是标准和红线——什么算成功、什么绝对不能碰——而不是替模型把每一步都踩死。
写之前的三问
所以官方文档没问题——它教的是语法。三问是语法之前的事:要不要开口。
三问都过了,再回头照文档写——那时候每条建议才真的在帮你。顺序反了,就是在一条不该存在的 skill 上,反复优化一段没人读的描述。
我自己就是反面教材
那个发布 skill 的 description,我按文档写得很"全"——全到每次触发,模型都要从一整串流程里挑出它当下要的那段。
它还能用,只有一个原因:这类任务冷门,没有邻居跟它抢。换个拥挤赛道,这个写法就是第六篇那条 −2.9pp。
后来写新 skill,我改了一个习惯:先写测试问题,再写描述(第九篇那 20 条)。
问题写不出来,说明这件事还没想清楚——这时候文档背得再熟也没用。问题写得出来,描述往往就是那几条问题的归并,五分钟的事。
最后
官方文档是对的平均答案。你的 skill 是一个具体问题。
平均答案的用法,是拿它对答案,不是拿它抄作业。
下一篇拆「装太多 skill,为什么反而变笨」。上面那条曲线(4 个以上掉到 +5.9pp)背后是同一件事:上下文是有限的,每个 skill 都在分走模型看别人的眼神。怎么判断该删哪些——值得单独拆一篇。