ARTICLE · 1057490
硅谷AI共识崩塌:美国打不过中国?
2026年夏末的旧金山101公路,两侧的广告牌完成了第三次迭代。两年前这里挤满SaaS品牌,去年还零星分布着消费创业广告,今年视线所及的每一块户外位,都被AI公司的品牌信息填满。Kimi、Codex等中国模型的广告密集出现在硅谷核心区,和Claude Code的宣传物料直接形成对垒。
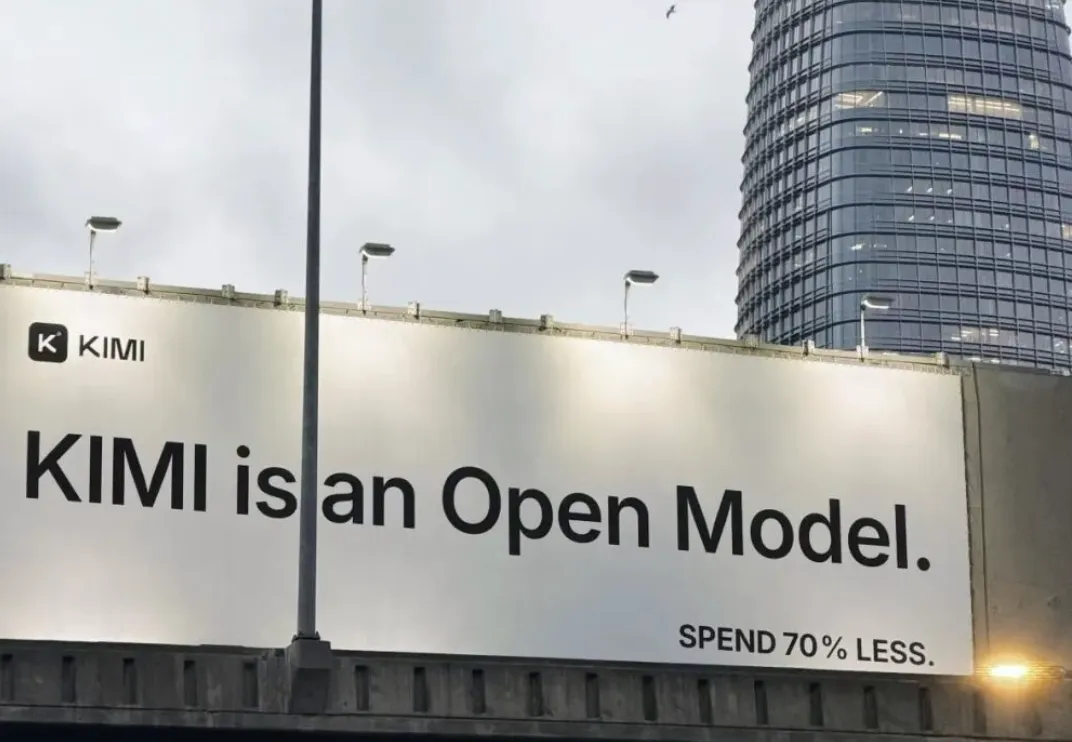
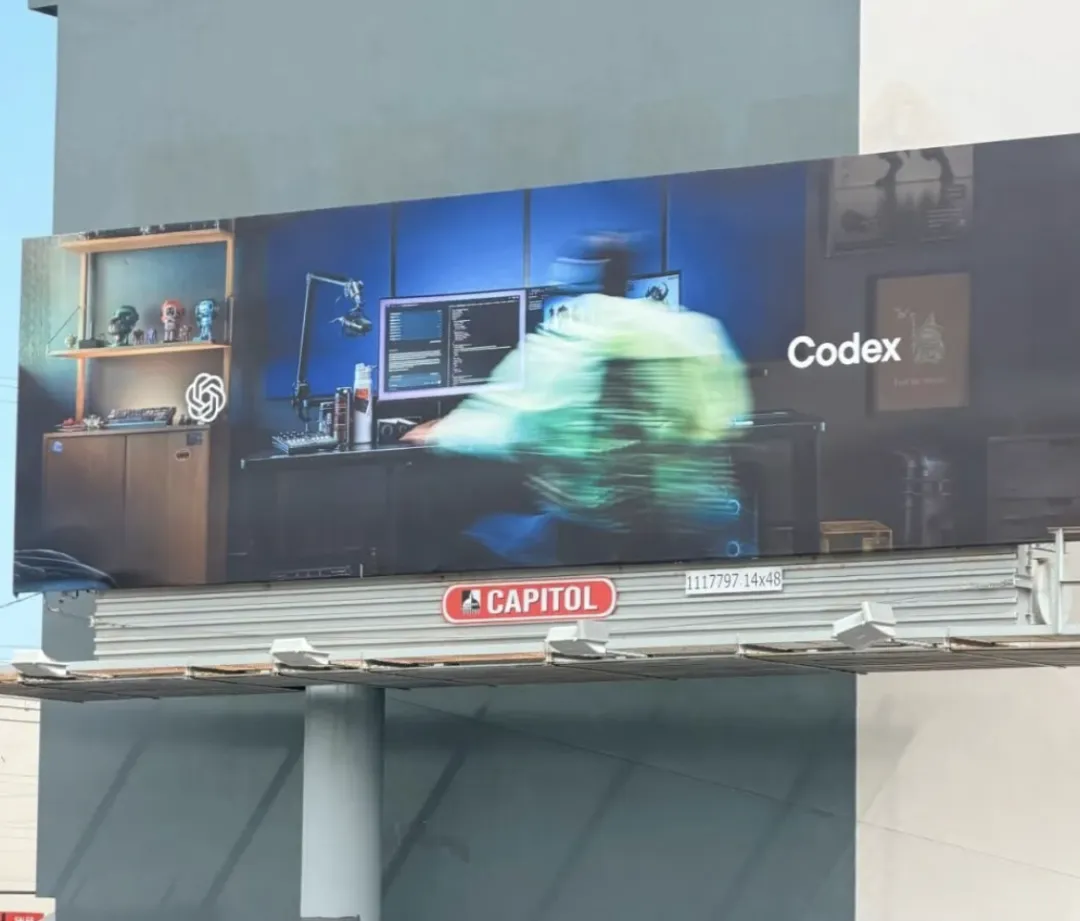
资金、算力、人才依然在疯狂涌入湾区AI赛道,行业没有任何降温迹象。但最让一线从业者意外的变化,发生在核心圈层的私下交流里:OpenAI的核心团队花了数月复盘过去一年的战略误判,逐帧拆解中国模型厂商的技术优势;Google多模态方向的资深研究员直接给出判断——“打不过国内”。
这种判断在几年前完全不可想象,如今却在xAI、各前沿实验室的核心成员口中反复出现。过去两年行业形成的所有坚固共识,正在快速松动:顶尖研究员聚在一起就能复刻OpenAI的成功吗?美国头部实验室能在所有赛道保持领先吗?模型、数据、算力、应用的上下游关系真的不可撼动吗?最强的模型就必须维持最高定价吗?所有曾经被奉为真理的答案,现在都要被重新书写。
能力分层:中美AI的差距早已不是单一维度
“打不过国内”的判断,从来不是对中美AI整体实力的笼统结论,而是指向不同技术环节的具体分化。
在预训练阶段,中美之间的差距呈现出极其反直觉的状态:中国头部模型团队过去一年快速补全了“阶梯式缩放”的完整方法论——从百亿参数小模型验证数据、架构和训练逻辑,再逐级向上扩展到千亿级大模型,把小实验的误差控制在不会在大训练中放大的范围内。现在中美在预训练的方法论层面已经几乎拉平,剩下的差距主要来自超大规模集群的工程经验:美国前沿实验室跑过更多万卡级别的完整训练,更清楚几万张GPU长时间并行运行时会出现的各类隐性故障,中国团队缺的正是这种“把成熟方法稳定放大”的肌肉记忆。
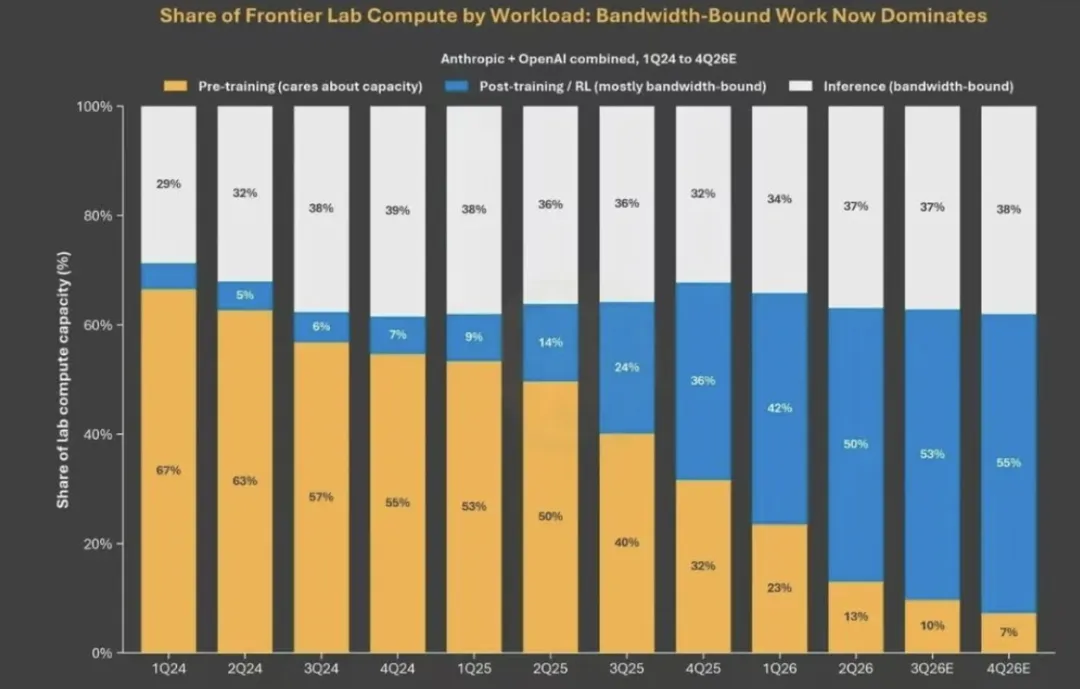
进入后训练阶段,局势开始彻底分化。后训练没有统一的标准化解法,环境搭建、奖励函数设计、评测体系搭建的每一个环节,都直接决定最终效果。其中大规模强化学习是最难补的短板:一次前沿RL大运行需要同时占用上万张卡连续跑上千步,任何一个环节的不稳定都会导致整条轨迹报废,这类经验根本无法从论文里获得,只能靠反复试错积累,中国团队在这个环节的经验积累,反而比预训练阶段的差距更深。
但一旦训练目标被明确界定,中国团队的优势就会立刻显现出来。字节跳动的Seedance多模态模型,依托自身的视频分发平台,天然拥有定义“什么是好的生成结果”的能力——什么样的运镜用户喜欢,什么样的人物一致性不可接受,这些无法用通用基准测试定义的标准,在真实的用户反馈里被持续打磨。目标越模糊、越依赖大量人工判断的领域,这种规模化运营的优势就越明显,这也是Google研究员口中“打不过国内”的核心来源。
美国头部厂商也在跟进补全这一课:Meta专门组建了6500人的Applied AI内部团队,大量非技术岗员工被直接调岗,专门负责出题、搭建场景、完成评测,试图补上这块过去被忽略的短板。
蒸馏技术的普及,进一步打破了技术壁垒的边界。DeepSeek训练R1时,用RL生成的60万条推理数据,配合20万条基础模型数据反向重训基础版V3,大幅提升了模型推理能力。今年已经有美国新成立的前沿实验室,直接基于开源模型K3做蒸馏,用更低的成本生成训练数据,把开源模型直接纳入自己的后训练工具箱。
但在代码生成赛道,中国团队的优势并没有像多模态领域那样显现。代码生成天生有可验证的奖励机制,运行结果、测试通过率都有明确的对错标准,但上千步的长轨迹里,最终的成败很难精准回溯到前面的关键决策节点,这种“信用分配”的难度极高。这类场景里,大规模RL基础设施和顶尖程序员的高质量数据,远比大规模人力标注更重要,Anthropic的高质量代码数据,核心就来自内部100多名顶尖开发者,普通用户生成的数据反而噪音极高。
整个AI研究的边界正在快速拓宽:
过去大家理解的研究只包括架构设计、模型训练,现在基础设施搭建、大规模人力运营、数据生产管理,全部都成了直接决定模型上限的核心环节。过去不被硅谷主流重视的规模化运营能力,在这一轮技术迭代里,突然变成了决定胜负的关键变量。
Neo Lab祛魅:靠明星研究员复刻OpenAI的路已经走不通
过去两年硅谷最昂贵的创业赛道,就是明星研究员从OpenAI、Anthropic离职创办的Neo Lab。没有产品、没有收入没关系,只要团队履历足够豪华,几亿美元的融资会立刻送到手上。但现在这批拿到天价融资的新实验室,几乎没有一家达到市场预期。
最典型的案例是Thinking Machines Lab,成立仅5个月就拿到20亿美元种子轮,投后估值120亿美元,阿尔巴尼亚甚至专门修改国家预算,投入1000万美元支持这家由前OpenAI CTO Mira Murati创办的公司。去年底它试图按500亿-600亿美元估值启动新一轮融资,结果CTO和一批核心成员直接离职返回OpenAI,融资直接搁浅,直到最近才重新启动谈判,估值已经回落到400亿美元。
内部人士透露,这家公司从成立第一天起就有强烈的“拼凑感”:几位联合创始人的方向完全无法统一,Mira Murati偏向企业服务,Lilian Weng专注交互模型,John Schulman更坚持纯研究路线,官网的愿景宣言是几个人各写一段拼接出来的,最后选“人机协作”作为方向,仅仅是因为这是所有人唯一能达成共识的交集。
一群在原组织里就无法说服彼此、也无法被说服的顶尖研究员,凑在一起创业,天然就会陷入目标分散的困境。成熟大厂已经有明确的北极星指标,哪怕对技术路线有分歧,最终也有统一的资源分配机制。OpenAI的自下而上模式容易催生大量创新方向,但也容易分散资源;Anthropic自上而下的集中决策模式,一旦押中赛道就能快速集中资源击穿,这也是为什么OpenAI先做出o1推理模型,却让Anthropic更早把这条路线落地成好用的代码产品。
算力资源也远没有外界想象的宽裕:虽然TML和Google Cloud签下了巨额算力合同,也拿到了英伟达最新的GPU,但一线研究员的体感依然是实验资源互相挤占,很多基础实验只能在小到没有参考价值的模型上跑,根本无法验证效果。团队曾经引以为傲的Tinker单场景框架,被内部复盘为“过度追求优雅的设计,不愿意做部署、缓存优化这类脏活”,最终这块生意被把工程落地细节做透的Fireworks抢走了大量市场份额。
这批Neo Lab本质上是从OpenAI、Anthropic这两辆高速行驶的大巴上跳车,短暂继承了原有平台的速度、资源和行业注意力,但落地之后,他们根本没有能力自己维持加速。他们带着的还是上一个时代的旧地图:只要聚齐最聪明的人、拿到足够多的算力,就能靠缩放定律自然涌现出能力。但现在行业的核心矛盾已经变了,大家不再需要从零搭建基础训练能力,而是要找到具体的真实场景,定义清楚任务目标、奖励机制和评测标准。
下一批真正能跑出来的Neo Lab,大概率不会从纯研究团队里诞生,而是先有产品、有真实工作流、有海量用户产生的真实任务,最后再反向长出自己的模型。Cursor、Harvey这类深度嵌入真实软件开发、法律服务流程的产品,天然就拥有明确的北极星指标,不需要研究员坐在一起反复讨论“我们到底要解决什么问题”。
整个AI产业链的边界正在快速模糊:过去只卖GPU算力的Neo Cloud厂商,现在正在往推理、模型服务方向延伸,CoreWeave收购Weights & Biases之后,已经把预训练、后训练、推理、Agent评测全部装进产品栈,它的托管推理产品上线3个月,ARR就从100万美元涨到1亿美元;另一边新的创业团队,还没训出模型就先做数据服务、搭建训练环境,把过程中积累的资源沉淀下来,最后反向训练自己的模型。所有玩家都在往别人的赛道渗透,传统的标签已经完全无法定义现在的AI公司。
数据战争升级:数商站到了行业中央
停飞的Spirit航空成了硅谷新宠,Google、Mercor等机构轮番出价,最终Micro1以1250万美元拍下这家破产航司几十年积累的上亿封邮件、几亿条通讯记录与全量运营数据。过去被当成玩笑的“收购破产公司拿数据”,现在已经成了行业标准化操作。收购后团队会返聘老员工作为“废墟导游”,把所有非结构化记录里的业务逻辑全部梳理清楚。
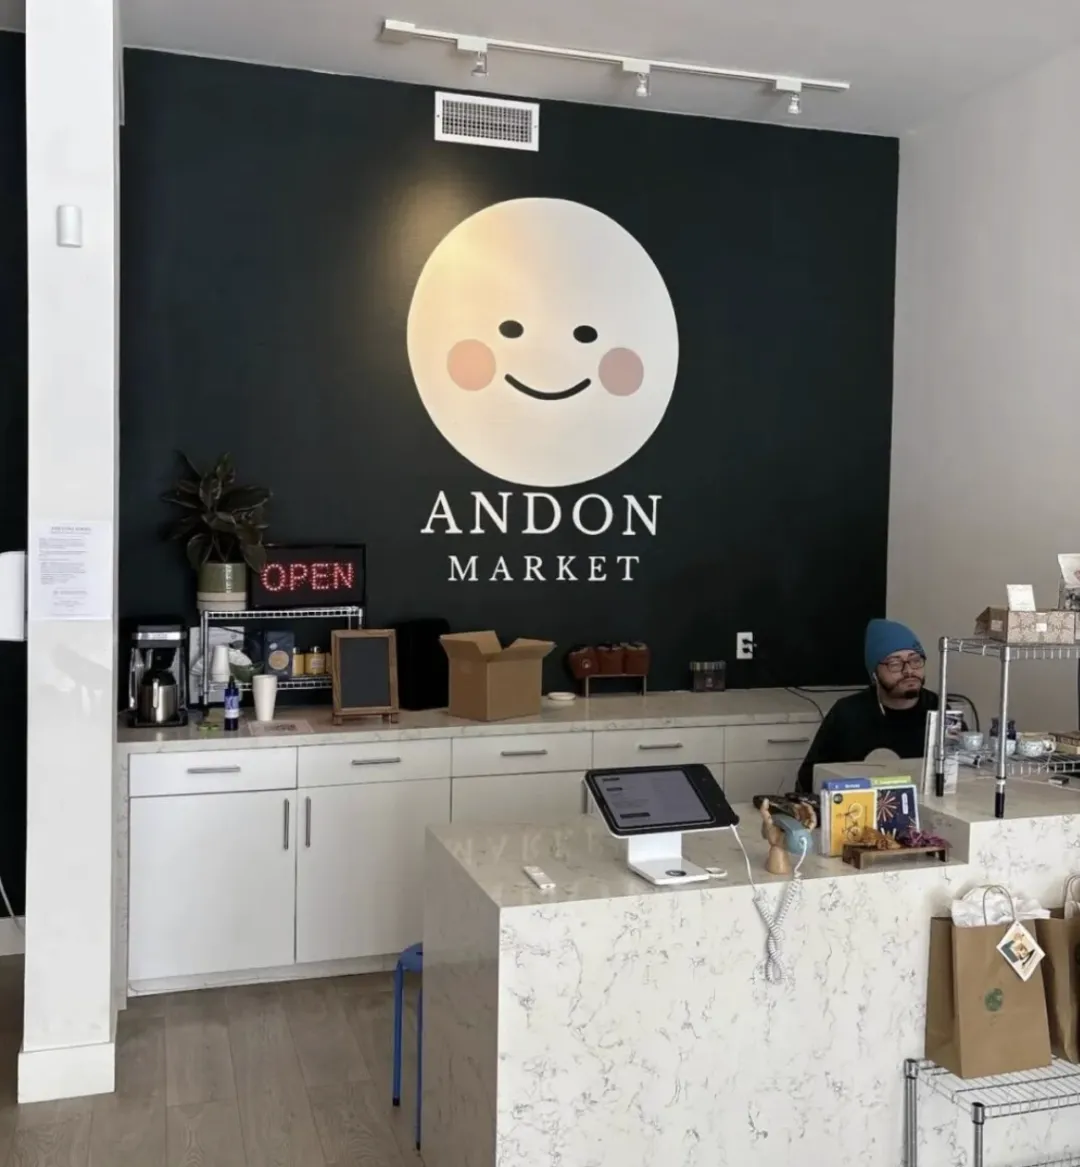
背后的核心逻辑非常直白:公开互联网的可清洗训练文本早已见底,总量不超过300T的资源已经被头部实验室全部消耗完。现在模型需要的不再是静态数据集,而是能持续产生新任务、新反馈、新轨迹的动态环境。旧金山的Andon Labs直接把模拟实验搬进现实,租下门店让AI Agent从零经营线下自动售货机,自主完成选品、定价、补货全流程,每天自动扣除场地费,用真实的商业环境倒逼模型学会在信息不全、决策无法撤回的情况下长期稳定运行。
“死”公司的历史数据,永远比不上“活”公司持续产出的新轨迹。现在模型厂商渗透真实场景已经形成四层路径:最轻的是让Agent直接嵌入用户工作流,自然沉淀操作轨迹;进一步是直接进驻企业协作场景,把Agent部署在Slack这类沟通工具里,全程记录协作流程;渗透难度高的场景就派现场工程师驻场,在部署系统的同时采集真实工作流;最极端的方式是直接收购目标公司,完整持有持续产出自数据的环境。
数商成了连接两边的核心枢纽:头部实验室缺数据却不知道数据藏在哪,传统企业握着高价值轨迹却不知道其商业价值。现在数据生意已经分成新旧两派:老派按人力工时计价靠扩团队提产能,新派直接按场景稀缺性给轨迹定价,稀缺场景两小时轨迹的价格能高出普通场景数倍,两派最终都在往真实业务场景靠拢。
头部数商的核心能力已经进化为“退档”:把企业已完成的工作反向拆解回任务起点,把完整决策流打包成可用于RL训练的环境,再把行业老师傅的经验手感翻译成可自动验证的评测规则。不少头部数商已经开始提前下注热门赛道,提前搭建基准测试集,一旦这套标准被头部实验室采纳,手里的独家数据就成了不可替代的行业硬通货。
合规灰色地带也随之显现:大量外采标注数据本质是用大模型生成,供应商用“先小语种写再转英文”的理由搪塞,买方明知来源有问题也不会深究。来路不明的调用轨迹报价3美元,合规版本报价300美元,百倍差价本质是买风险转嫁,数商天然成了隔离合规风险的白手套。
单纯卖原始数据的模式已经走到尽头,把行业沉淀数据训练成专属模型直接交付,成了新的溢价方向。旧金山创业公司Noetik没有直接出售手里的全球最大空间生物学数据集,而是基于数据训练出肿瘤研究专属模型,直接和GSK签下五年使用权合作。数据加工深度越深,商业溢价空间就越高。
过去最苦最累的数据生意,现在已经彻底站到了AI战争的核心位置。
围城内外:被重新定价的AI从业者
深夜的旧金山Corgi Cafe里,24小时亮着的灯永远留给那些还在写代码、调模型的工程师和创业者。这座城市的所有注意力、资源、社交网络,全部围绕AI产业高速运转,创业、社交、生活完全融为一体。但身处浪潮最中心的人,反而最先开始怀疑这场狂欢的可持续性。
一位年轻的AI研究员用“缅甸园区”来形容现在的湾区AI圈:所有人的话题永远绕不开Agent、基础设施、创业,同质化的氛围让人喘不过气。他所在的实验室去年毕业的5个PhD,没有一个人能在同一家公司待满一年,在当前的薪酬体系下,100万美元以下的年薪已经很难进入顶尖研究员的考虑范围。
最早开始焦虑的恰恰是拿到最高溢价的这群人:有人依然像传教士一样相信AGI的终极愿景,愿意为技术判断押上全部时间;也有人完全以雇佣兵的心态参与这场浪潮,能赚多久就赚多久,窗口关闭立刻离场。现在湾区的基金出资人名单里,已经出现了大量OpenAI、Anthropic核心员工的名字,他们在套现之后,开始投资红酒、跨境电商、甚至室内滑雪场,试图在数字世界之外找到新的锚点。
一位年轻研究员的话点破了所有人的隐忧:“没有什么问题,是只有我能回答,而ChatGPT不能的。”现在越来越多的人计划赚够钱之后回到学校,有人拖了一年,有人拖了两年,有人已经拖到了第四年。
所有公司、技术、壁垒,甚至研究员最引以为傲的独家能力,都在被快速重新定价。模型可以一次次回滚试错,沿着不同路径迭代出最优解,但人的时间永远单向流动,没有重来一次的机会。
在法罗群岛的雾里,连只会说法罗语的出租车司机,都要靠ChatGPT完成跨语言沟通,AI已经成了无处不在的背景板。而身处浪潮中心的每一个人,最终都要回答那个模型永远无法替你做出的选择:你到底想把自己有限的时间,花在什么地方。