ARTICLE · 1058202
AI 只认东西,不认感觉
“
你写疲惫,它给你一张标准化的深夜工作者;你写空碗,它就得画出一只碗。
前几天我做了一条 70 秒的视频,前后做了三遍。
没有一遍是渲染失败、导出花屏或者软件崩了,三遍都能正常播放。问题出在别的地方:第一遍做完,我发现画面跟文案一点关系都没有。
这句话是我自己看完成片之后说的。它不算那种一眼能看出来的错。画面挺好看,光影讲究,人物也在认真做事,你随手刷到大概不会觉得有问题。但你只要把文案念一遍,再回头看画面,就会发现那些画面可以互换:随便挑两个镜头对调,几乎没有人看得出来。
我把文案拆成 9 个镜头,每个镜头配一段提示词。写的时候我挺得意,每段都很有画面感,有情绪、有氛围、有光线。我写的是“深夜的疲惫”“专注的神情”“一个人对着屏幕的笃定”。
问题就在这里,但当时的我完全没意识到。
我脑子里想的是“这句话是什么感觉”,所以我写出来的就是感觉。我以为把感觉描述得越准,生成的画面就越贴近我想要的。
结果出来是9 个几乎一样的镜头:同一个人,同一件深灰圆领,同一个房间,全是夜戏,全是冷调子。这几样是我自己刻意锁死的,为的是人脸不一样也能看着像同一个人。
但机位和景别我没管。9 个镜头里 6 个是头肩近景,其中三个连机位都一样。它们单独看都挺好看,摆在一起,像同一条素材重复播了九遍。
文案里那些具体的东西,一个都没出现。
文案里写着“等你反应过来,肉没了,汤没了,碗都让人端走了”,画面给的是:一双手在敲键盘。
文案里说“那条内容就烂在草稿箱里了”,画面给的是:一个人靠在椅背上按眉心。
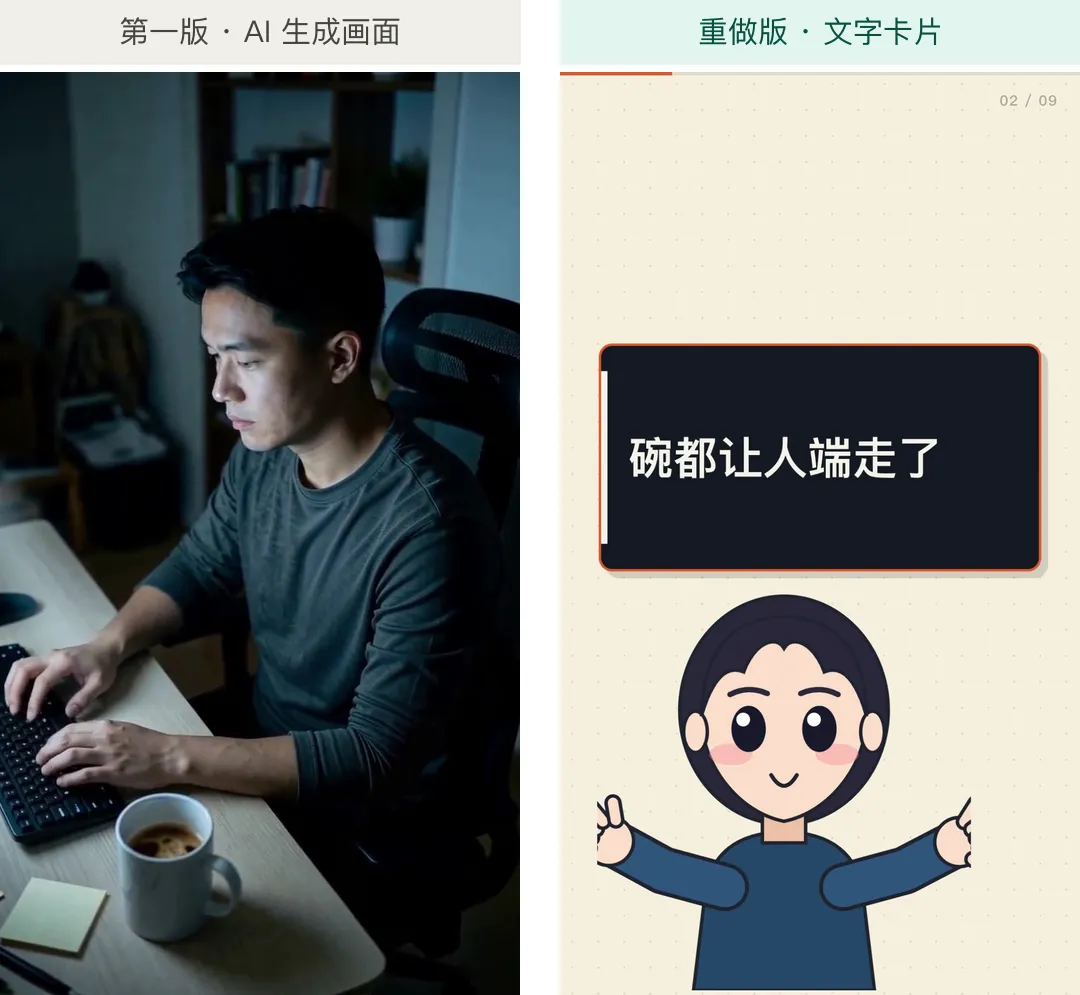
— 左:第一遍画面(敲键盘)/右:重做后的卡片
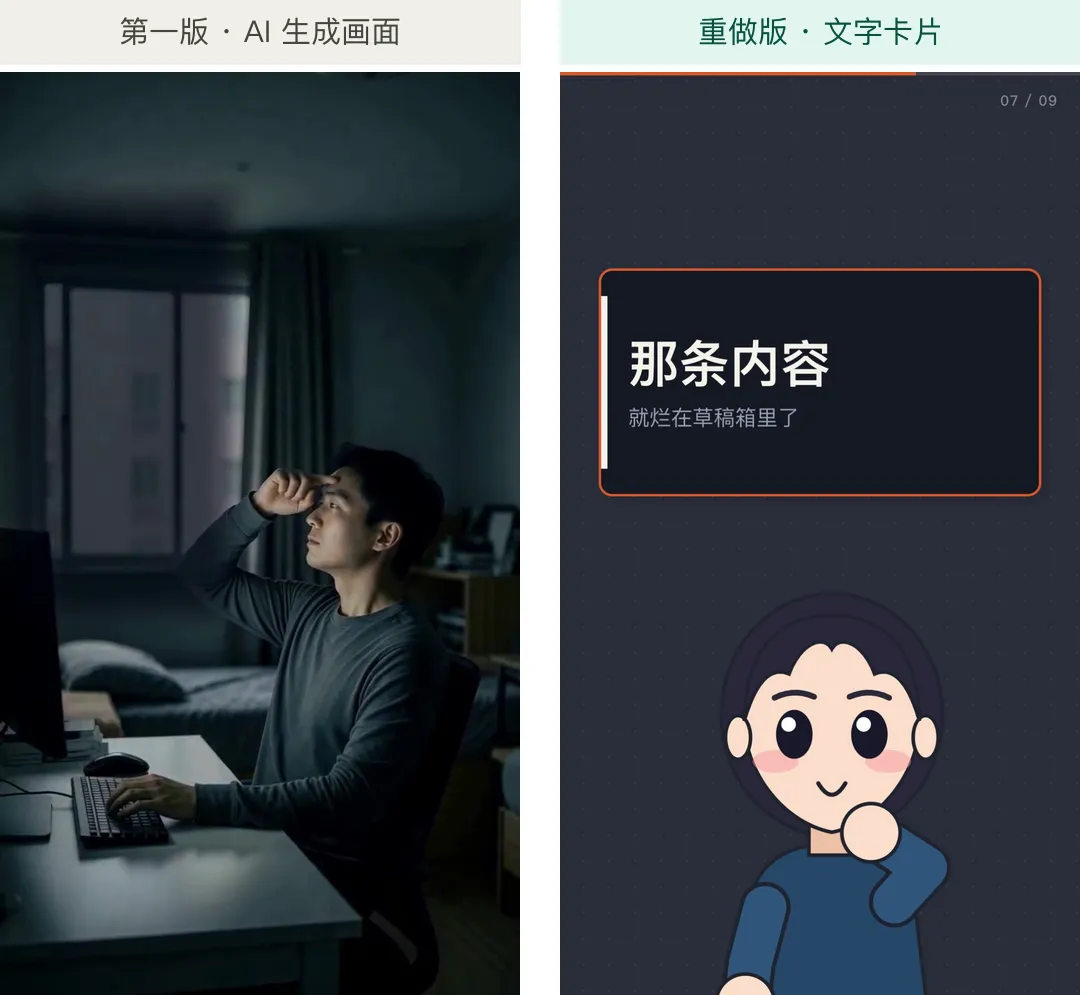
— 左:第一遍画面(靠椅背按眉心)/右:重做后的卡片
碗呢?草稿箱呢?还有一句文案说的是“免费的 AI 给你的是最低水位”,画面给的是侧脸看着前方。水位在哪?
一个都没有。
发现问题之后,我先做了一件看起来很合理的事:把这批画面用起来。
我给 9 个镜头配上了配音和字幕,每一镜的配音单独调速、刚好填满这一镜的画面时长,8 个接缝全部对齐。
做完之后,它是一条能发的视频了:有画面,有声音,有字幕,时长也对得上。
但它补上的是声音,不是画面。那 9 个镜头还是原来那 9 个,碗还是没有,草稿箱还是没有。
ROOT CAUSE
我找到的原因
我一开始以为,是提示词写得不够详细,或者是这个工具不行,要不要换个更好的?
后来我把 9 条提示词调出来逐条看了一遍,才发现问题不在详细程度。
那 9 条提示词里,几乎没有一个能被画出来的名词。写的大多是“疲惫”“专注”“笃定”这一类的词。
AI 对这两类词的反应完全不是一个量级。你写“疲惫”,它给你一个标准的、教科书式的深夜工作者,这类画面它见过太多次了,给的永远是那个平均值。你写“空碗”“对折的文件”“桌上摊着半杯水”,它就必须真的把这些东西画出来,没法含糊。
我把这个规律总结成一句话:
情绪词是弱约束,实物名词是强约束。
弱约束的意思是,你写十个情绪词,它可能只给你同一张图;强约束的意思是,你写一个碗,画面里就得有一个碗。
这也顺带解释了一件事:为什么我那 9 个镜头可以互换。情绪词本身不携带情节,它只携带氛围。九个氛围拼在一起,就是九个差不多的画面。
不过这条规律有个例外,我踩得挺惨:
!踩坑提示 🕳
只要提示词里出现“屏幕”“显示器”,它就一定会给你补满假界面。
我在提示词里写过“屏幕是一片纯粹的深黑色玻璃,表面没有任何窗口、菜单栏、图标、工具栏”,末尾还照例压着“不出现任何可读文字……软件界面、弹窗、对话框”的刹车句,生成出来的屏幕上照样有窗口、有标签栏、有乱码文字。首批 9 张里,5 张的屏幕被自动补上了界面。
把名词写进正向句(“纯黑玻璃上的发光轮廓”)有用,但更稳的是改构图:能背对镜头就背对,能只露边框就只露边框。
THE THIRD TRY
第三遍,我换的不是工具
想明白这一点之后,我把提示词重写了一遍,把“什么感觉”全部换成“什么东西”。
但我没拿它去重做那几张。我走了另一条路:放弃用 AI 生成画面,改成文字卡片加一个手绘的解说人物,每一句话直接变成一张卡片,卡片上写的就是那句话本身。
这办法不高明,甚至有点笨。但它从结构上把“画面对不上”这件事消灭了:卡片上写的就是文案,不可能对不上。
这一遍还顺手解决了另一个问题。配音那一版里有个镜头,画面只有 5 秒,但那一句口播正常念完需要 9 秒多。当时是把配音加速到 1.8 倍塞进去的,听起来像机器人在赶时间。重新做的时候,我改成先定声音、再让画面跟着声音长,那句话的画面变成了将近 7 秒,全程语速均匀,一次变速都不用做。
讲到这里,它听起来像个“换了工具就好了”的故事。但我得说清楚,不是。
卡片版不是更会画画,它只是把“画面对不对得上”这个变量直接删掉了。
这是回避,不是解决。哪天我又想用 AI 生成真实画面,碗的问题还在那儿摆着;那份重写过的提示词,得真的拿去跑一遍,才知道管不管用。
而且我得承认,这个结论的样本很小。一条视频,九个镜头,就一次。把它说成“AI 生图的通用规律”,是我往自己脸上贴金。说得更准一点,它对我这个用法成立:我要的是具体的、能指认的画面,不是氛围。如果你做的是纯情绪的氛围片,情绪词可能就是够用的。
还有一点我不打算装糊涂:那 9 个镜头的画面确实好看。如果我一开始的目标就是“好看”,那第一遍其实没失败。
失败的是我把“好看”当成了目标。
CHECKLIST
一个马上能用的检查动作
写完提示词之后,数一数里面有几个能被画出来的东西。
不是形容词,不是感觉,是名词。空碗、纸团、对折的文件、桌上摊着半杯水,凡是你能用手指着说“就是这个”的东西。如果一段提示词里一个都没有,那你得到的画面大概率是漂亮但可替换的,放在哪句话下面都成立。
还有一个更省事的判断法:别急着换工具,先换问题。
第一遍做完之后,我脑子里冒出来的第一个念头是“是不是这个工具不行”。这个念头特别自然,因为承认工具不行,比承认自己问错了容易多了。但工具换了一轮又一轮,只要我写的还是“这句话什么感觉”,出来的还是那九个镜头。
我是钱塘风华,帮普通人搞定 AI 的技术朋友。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。