ARTICLE · 1061760
人工智能赋能生物医学数据分析—从工具使用到论文实践【线上线下同步,2026年10月31日—11月2日】
各有关单位:
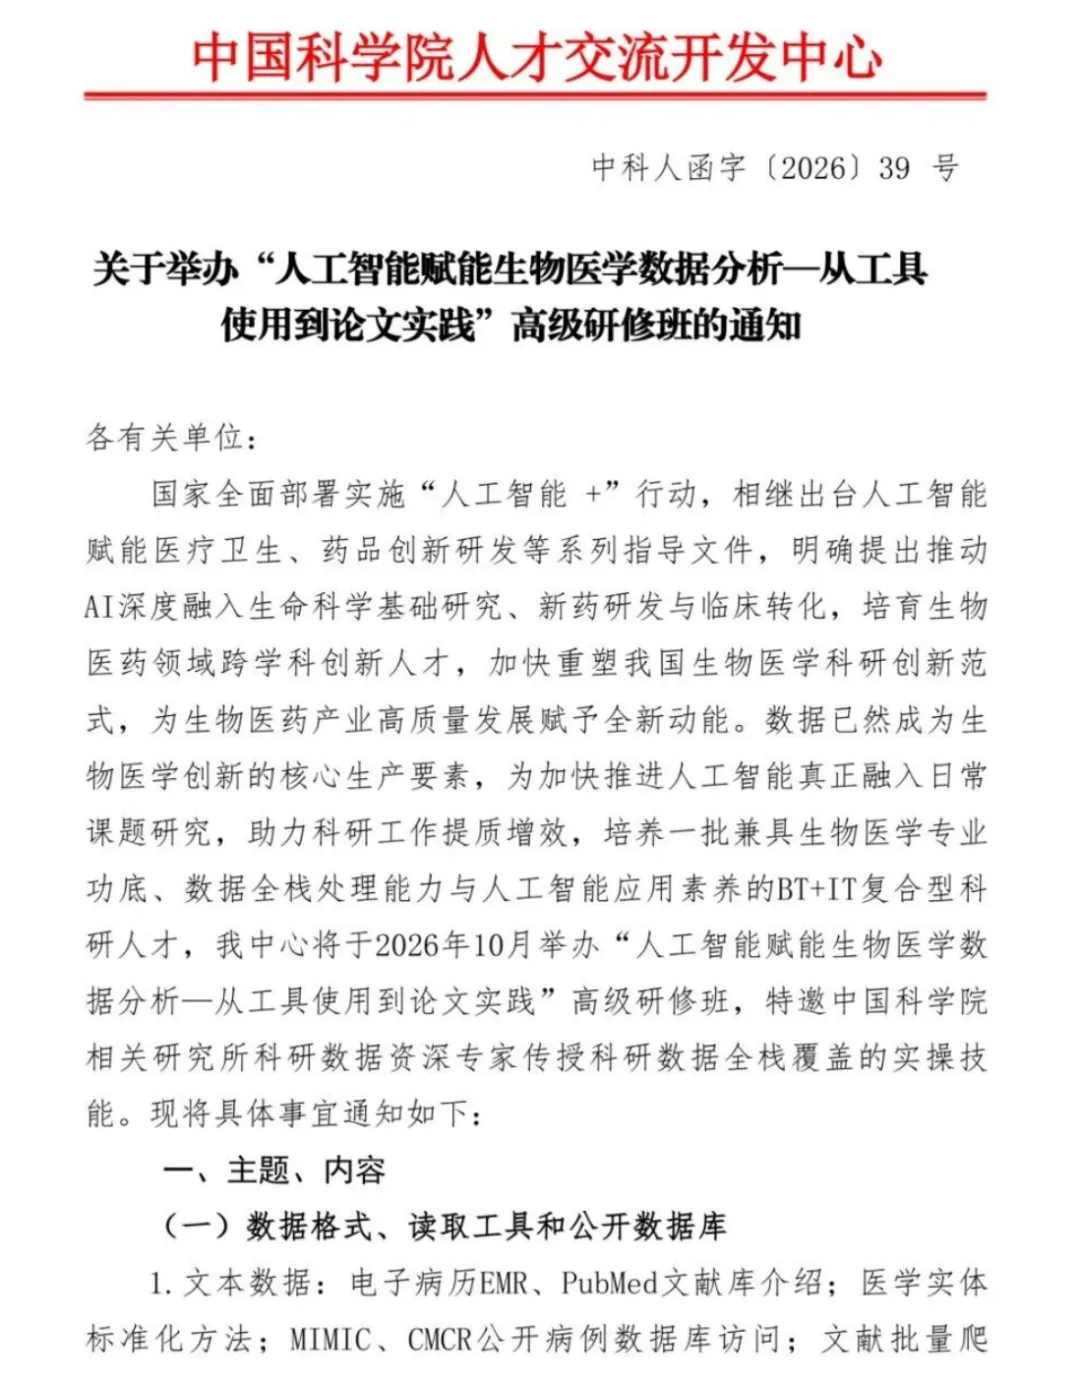
国家全面部署实施“人工智能+”行动,相继出台人工智能赋能医疗卫生、药品创新研发等系列指导文件,明确提出推动AI深度融入生命科学基础研究、新药研发与临床转化,培育生物医药领域跨学科创新人才,加快重塑我国生物医学科研创新范式,为生物医药产业高质量发展赋予全新动能。
数据已然成为生物医学创新的核心生产要素,为加快推进人工智能真正融入日常课题研究,助力科研工作提质增效,培养一批兼具生物医学专业功底、数据全栈处理能力与人工智能应用素养的BT+IT复合型科研人才,我中心将于2026年10月举办“人工智能赋能生物医学数据分析—从工具使用到论文实践”高级研修班,特邀中国科学院相关研究所科研数据资深专家传授科研数据全栈覆盖的实操技能。
现将具体事宜通知如下:
一、主题、内容
(一)数据格式、读取工具和公开数据库
文本数据:电子病历EMR、PubMed文献库介绍;医学实体标准化方法;MIMIC、CMCR公开病例数据库访问;文献批量爬取。
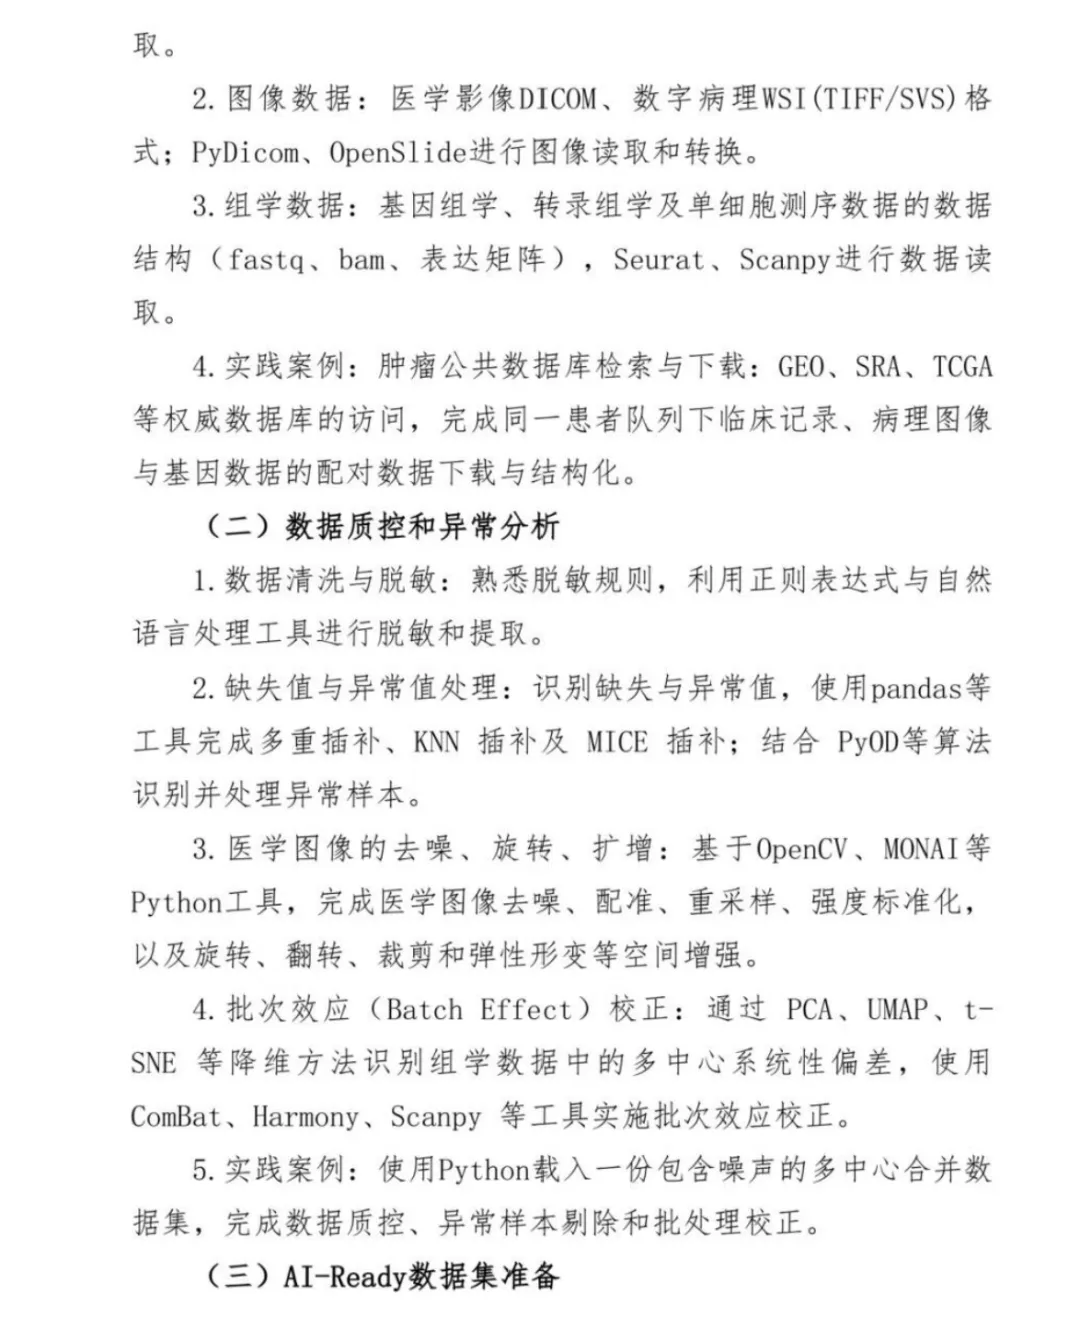
图像数据:医学影像DICOM、数字病理WSI(TIFF/SVS)格式;PyDicom、OpenSlide进行图像读取和转换。
组学数据:基因组学、转录组学及单细胞测序数据的数据结构(fastq、bam、表达矩阵),Seurat、Scanpy进行数据读取。
实践案例:肿瘤公共数据库检索与下载:GEO、SRA、TCGA等权威数据库的访问,完成同一患者队列下临床记录、病理图像与基因数据的配对数据下载与结构化。
(二)数据质控和异常分析
数据清洗与脱敏:熟悉脱敏规则,利用正则表达式与自然语言处理工具进行脱敏和提取。
缺失值与异常值处理:识别缺失与异常值,使用pandas等工具完成多重插补、KNN插补及MICE插补;结合PyOD等算法识别并处理异常样本。
医学图像的去噪、旋转、扩增:基于OpenCV、MONAI等Python工具,完成医学图像去噪、配准、重采样、强度标准化,以及旋转、翻转、裁剪和弹性形变等空间增强。
批次效应(Batch Effect)校正:通过PCA、UMAP、t-SNE等降维方法识别组学数据中的多中心系统性偏差,使用ComBat、Harmony、Scanpy等工具实施批次效应校正。
实践案例:使用Python载入一份包含噪声的多中心合并数据集,完成数据质控、异常值识别及批次效应校正。
(三)AI-Ready数据集准备
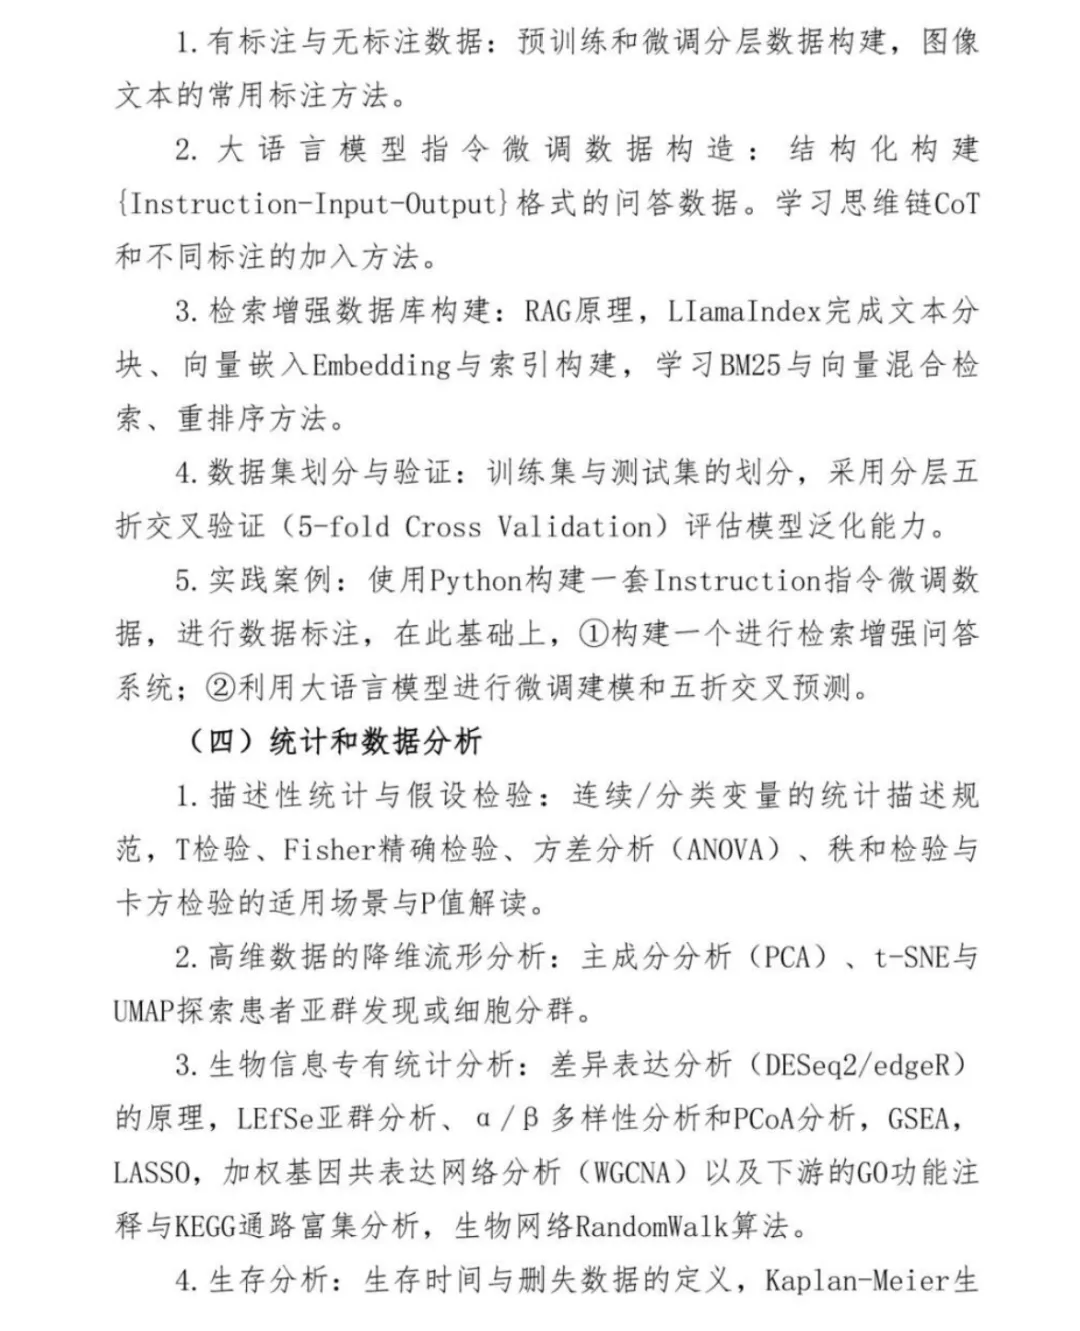
有标注与无标注数据:预训练和微调分层数据构建,图像文本的常用标注方法。
大语言模型指令微调数据构造:结构化构建
{Instruction-Input-Output}格式的问答数据。学习思维链CoT和不同标注的加入方法。检索增强数据库构建:RAG原理,LlamaIndex完成文本分块、向量嵌入Embedding与索引构建,学习BM25与向量混合检索、重排序方法。
数据集划分与验证:训练集与测试集的划分,采用分层五折交叉验证(5-fold Cross Validation)评估模型泛化能力。
实践案例:使用Python构建一套Instruction指令微调数据,进行数据标注,在此基础上:
① 构建一个进行检索增强问答系统; ② 利用大语言模型进行微调建模和五折交叉预测。
(四)统计和数据分析
基础统计方法:T检验、Fisher精确检验、方差分析(ANOVA)、秩和检验与卡方检验的适用场景与P值解读。
高维数据的降维流形分析:主成分分析(PCA)、t-SNE与UMAP探索患者亚群发现或细胞分群。
生物信息专有统计分析:差异表达分析(DESeq2/edgeR)的原理,LEfSe亚群分析、α/β多样性分析和PCoA分析,GSEA,LASSO,加权基因共表达网络分析(WGCNA)以及下游的GO功能注释与KEGG通路富集分析,生物网络RandomWalk算法。
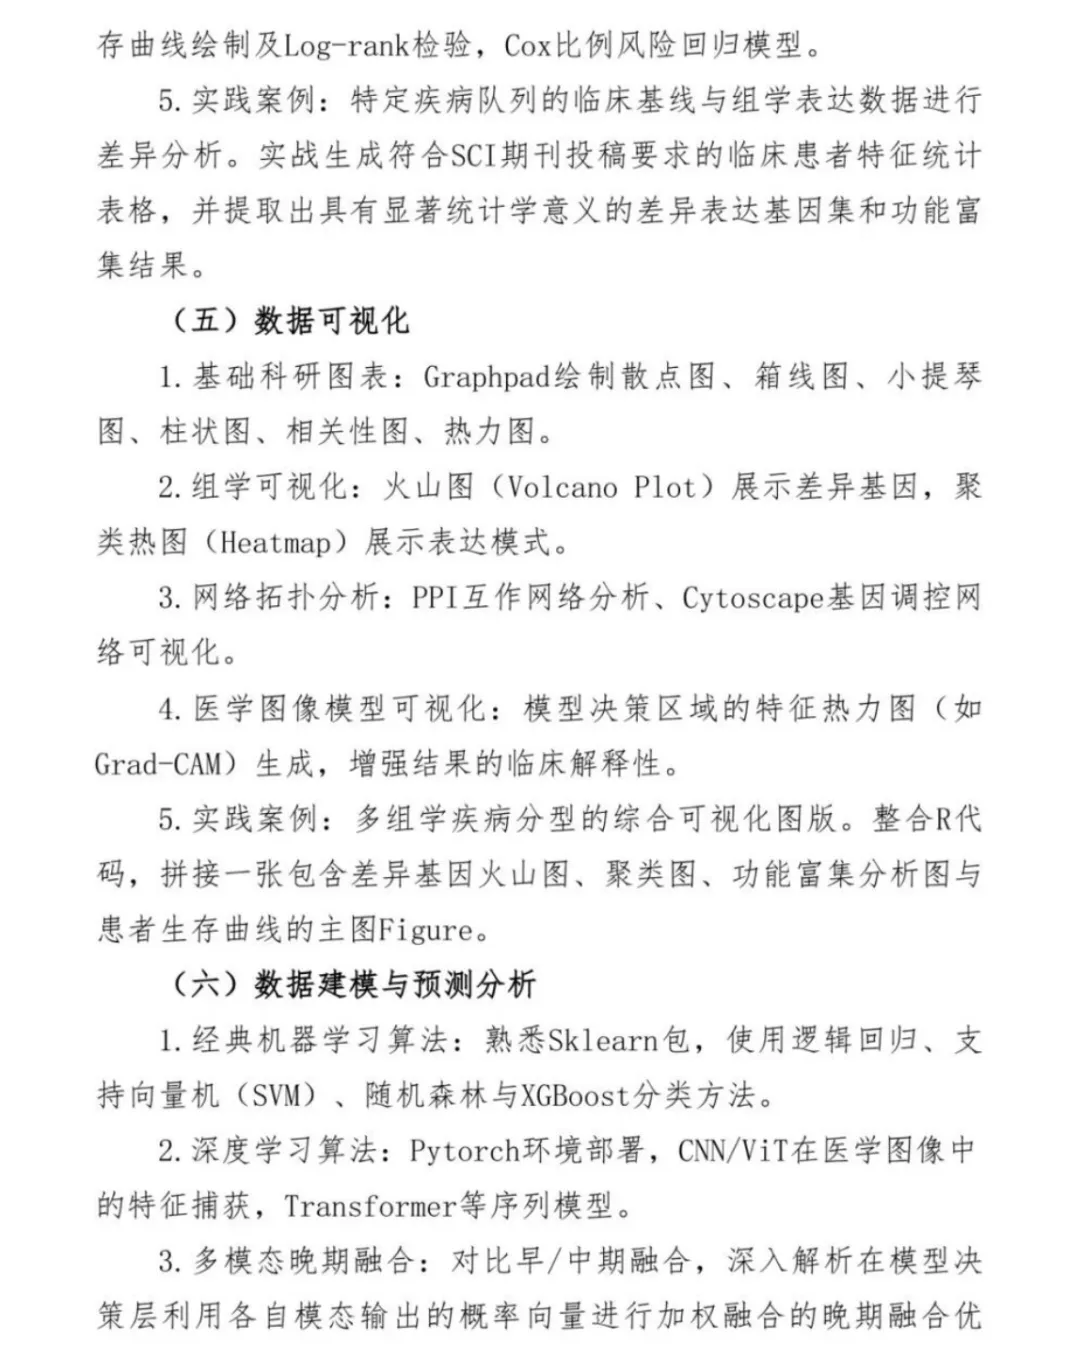
生存分析:生存时间与删失数据的定义,Kaplan-Meier生存曲线绘制及Log-rank检验,Cox比例风险回归模型。
实践案例:特定疾病队列的临床基线与组学表达数据进行差异分析。实战生成符合SCI期刊投稿要求的临床患者特征统计表格,并提取出具有显著统计学意义的差异表达基因集和功能富集结果。
(五)数据可视化
基础科研图表:Graphpad绘制散点图、箱线图、小提琴图、柱状图、相关性图、热力图。
组学可视化:火山图(Volcano Plot)展示差异基因,聚类热图(Heatmap)展示表达模式。
网络拓扑分析:PPI互作网络分析、Cytoscape基因调控网络可视化。
医学图像模型可视化:模型决策区域的特征热力图(如Grad-CAM)生成,增强结果的临床解释性。
实践案例:多组学疾病分型的综合可视化图版。整合R代码,拼接一张包含差异基因火山图、聚类图、功能富集分析图与患者生存曲线的主图Figure。
(六)数据建模与预测分析
经典机器学习算法:熟悉Sklearn包,使用逻辑回归、支持向量机(SVM)、随机森林与XGBoost分类方法。
深度学习算法:Pytorch环境部署,CNN/ViT在医学图像中的特征捕获,Transformer等序列模型。
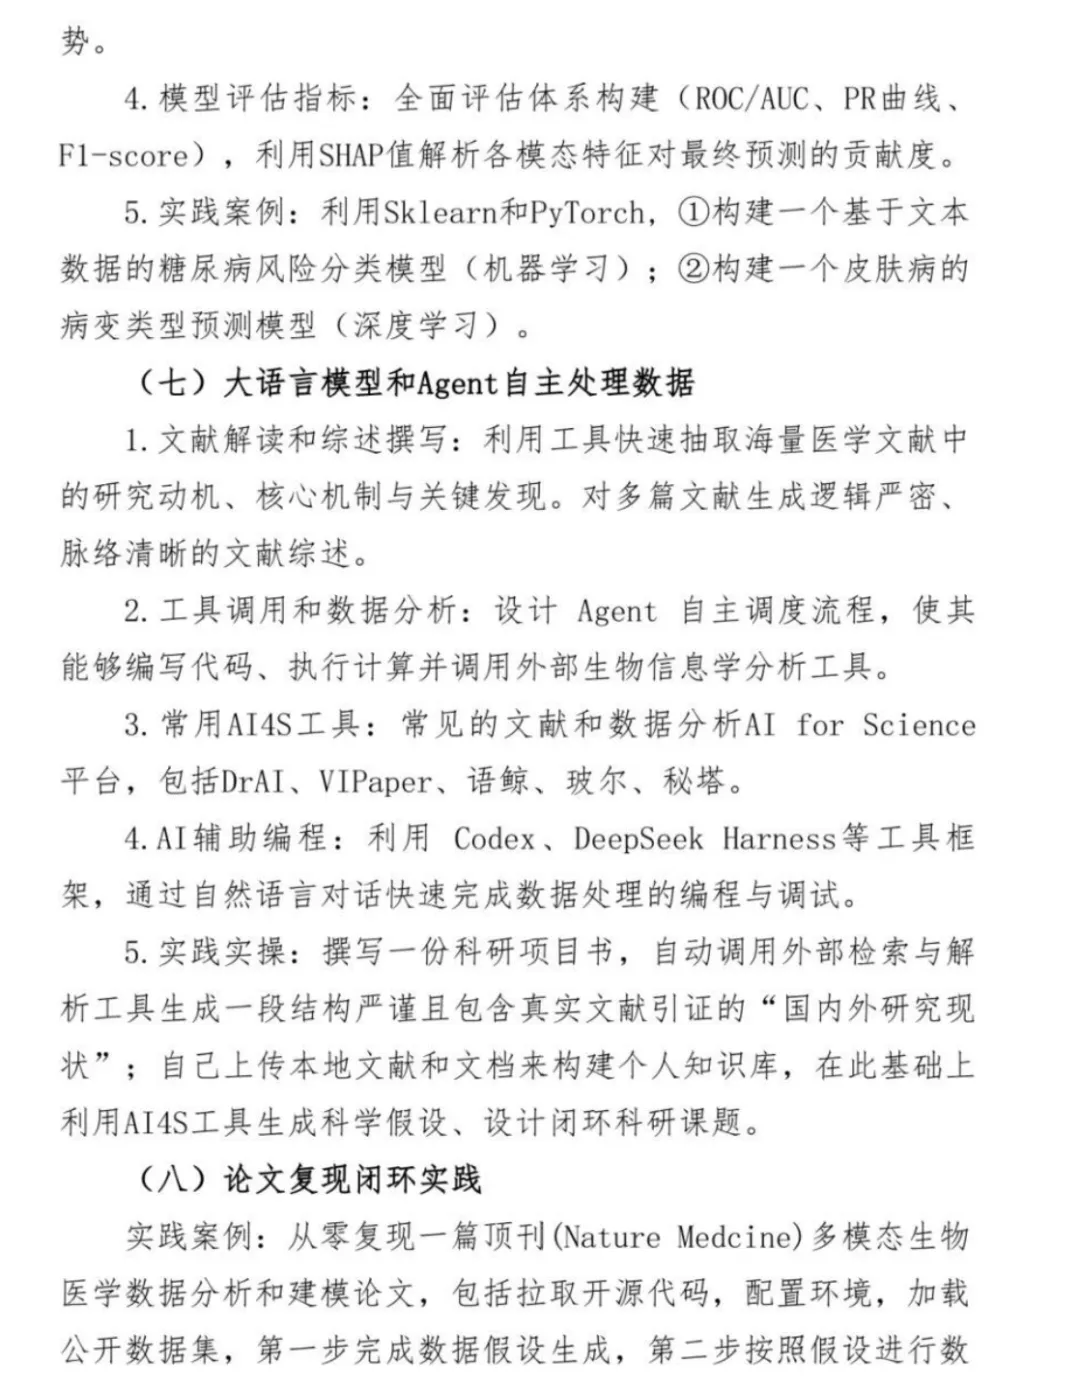
多模态晚期融合:对比早/中期融合,深入解析在模型决策层利用各自模态输出的概率向量进行加权融合的晚期融合策略。
模型评估指标:全面评估体系构建(ROC/AUC、PR曲线、F1-score),利用SHAP值解析各模态特征对最终预测的贡献度。
实践案例:利用Sklearn和PyTorch:
① 构建一个基于文本数据的糖尿病风险分类模型(机器学习); ② 构建一个皮肤病的病变类型预测模型(深度学习)。
(七)大语言模型和Agent自主处理数据
大语言模型辅助文献处理:对多篇文献生成逻辑严密、脉络清晰的文献综述。
Agent自主调度流程:学习利用Agent自主完成科研数据处理与分析任务。
AI4S tools:DrAI、VIPaper、语鲸、玻尔、秘塔。
科研编程工具:Codex、DeepSeek Harness。
实践案例:撰写一份科研项目书,自动调用外部检索与解析工具生成一段结构严谨且包含真实文献引证的“国内外研究现状”;自己上传本地文献和文档来构建个人知识库,在此基础上利用AI4S工具生成科学假设、设计闭环科研课题。
(八)论文复现闭环实践
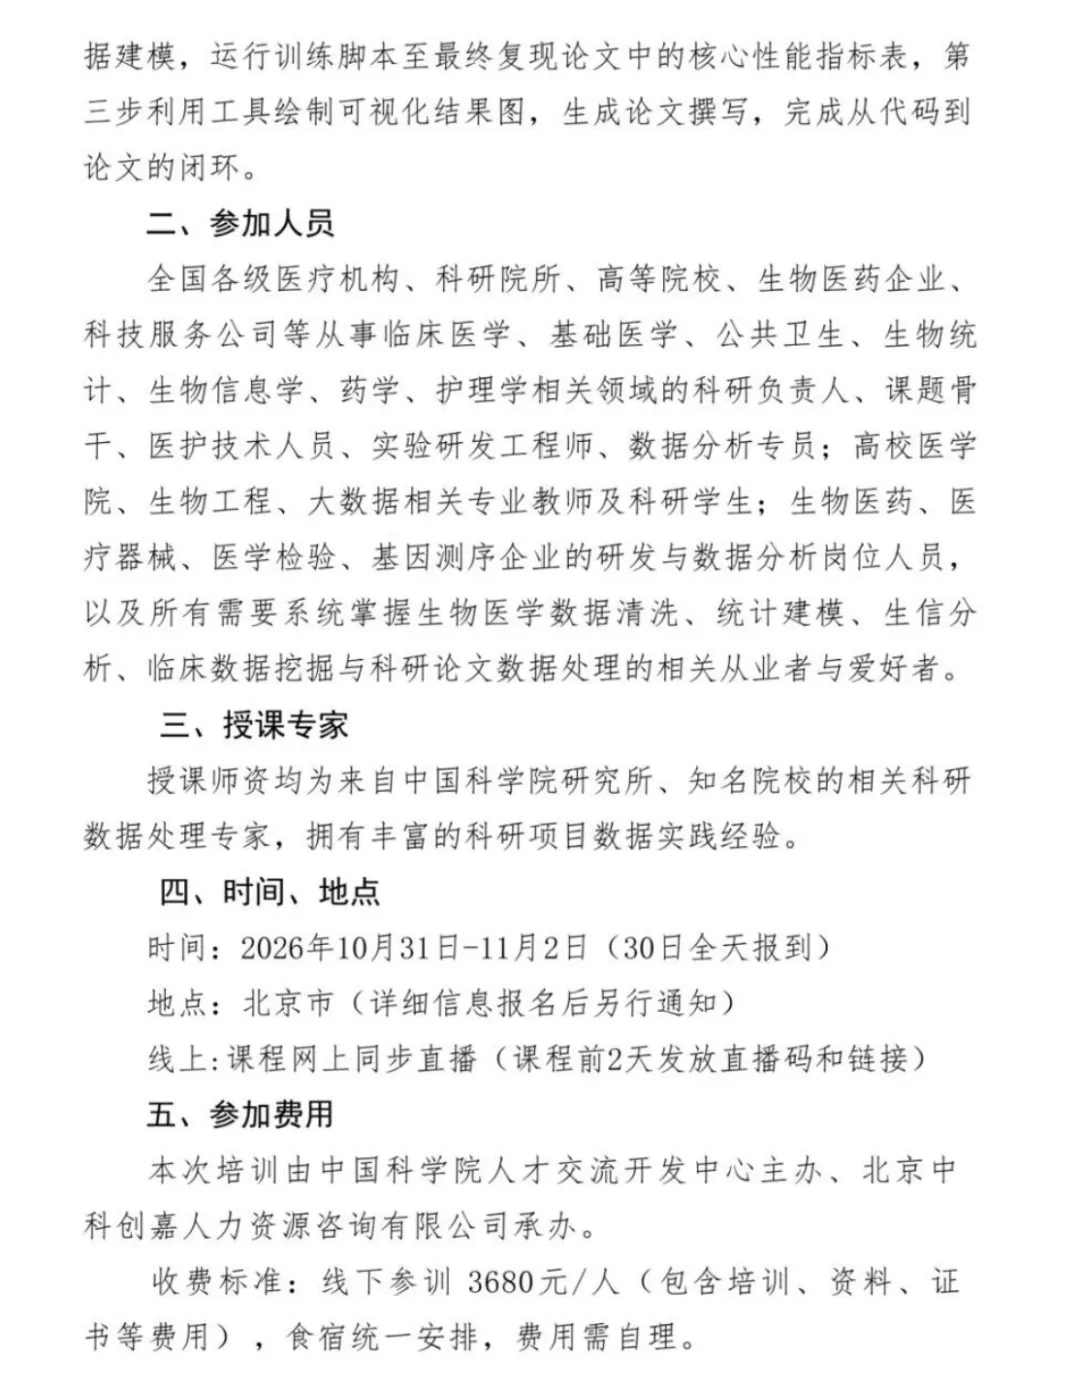
从零复现一篇顶刊(Nature Medicine)多模态生物医学数据分析和建模论文,包括拉取开源代码,配置环境,加载公开数据集,第一步完成数据假设生成,第二步按照假设进行数据建模,运行训练脚本至最终复现论文中的核心性能指标表,第三步利用工具绘制可视化结果图,生成论文撰写,完成从代码到论文的闭环。
二、参加人员
全国各级医疗机构、科研院所、高等院校、生物医药企业、科技服务公司等从事临床医学、基础医学、公共卫生、生物统计、生物信息学、药学、护理学相关领域的科研负责人、课题骨干、医护技术人员、实验研发工程师、数据分析专员;高校医学院、生物工程、大数据相关专业教师及科研学生;生物医药、医疗器械、医学检验、基因测序企业的研发与数据分析岗位人员,以及所有需要系统掌握生物医学数据清洗、统计建模、生信分析、临床数据挖掘与科研论文数据处理的相关从业者与爱好者。
三、授课专家
特邀中国科学院相关研究所科研数据资深专家授课。
四、时间、地点
时间:2026年10月31日—11月2日;报到:10月30日全天报到
地点:北京市(详细信息报名后另行通知)
线上:课程网上同步直播(课程前2天发放直播码和链接)
五、参加费用
本次培训由中国科学院人才交流开发中心主办、北京中科创嘉人力资源咨询有限公司承办。
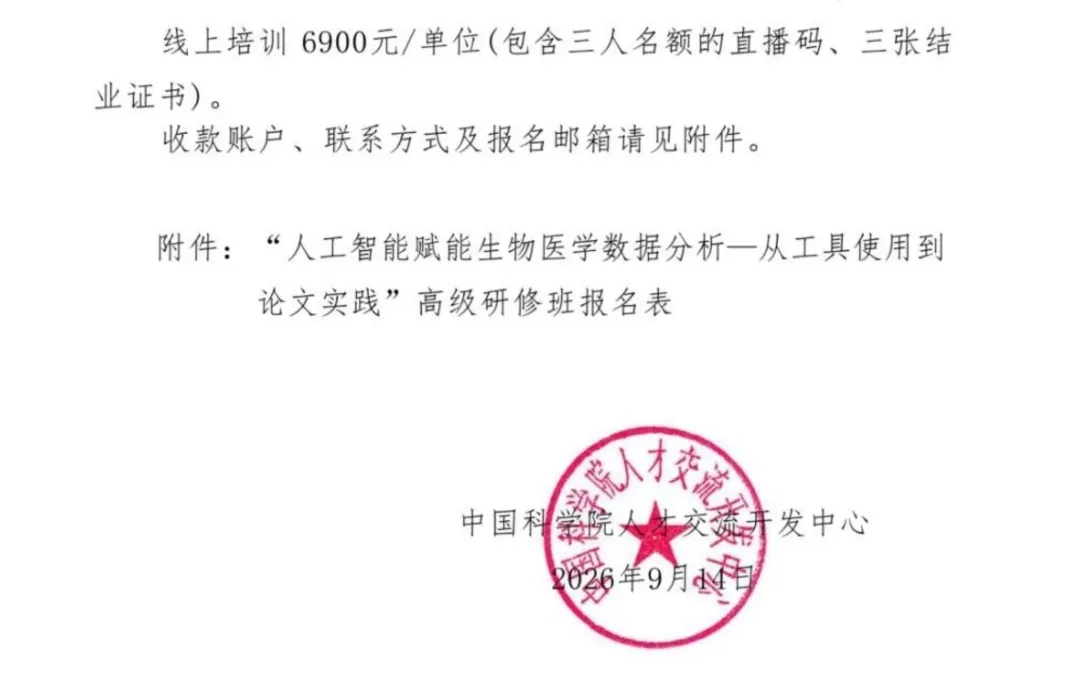
线下参训:3680元/人(包含培训、资料、证书等费用),食宿统一安排,费用需自理。 线上培训:6900元/单位(包含三人名额的直播码、三张结业证书)。
收款账户、联系方式及报名邮箱请见附件。
六、联系方式
扫码报名咨询
附件:
"喜欢请点赞+关注+分享" ,欢迎项目合作
(一)新药研发/指导原则
如何正确理解 NOAEL:药物研发中的 adverse 判定、病理学证据与外推边界(一)
ICH M3 (R2):一般毒性研究中高剂量选择的逻辑与实操策略
ICH M3 (R2):探索性临床研究(0期/早期1期)的非临床支持策略
ICH M3(R2) Q&As深度解读(一)——Limit Dose与50-fold暴露边界的高剂量选择原则
ICH M3 (R2):探索性临床研究(0期/早期1期)的非临床支持策略
ICH M3(R2) Q&As深度解读(一)——Limit Dose与50-fold暴露边界的高剂量选择原则
ICH M3(R2) Q&As深度解读(二)——代谢物非临床表征:10%规则与充分暴露要求
ICH M3(R2) Q&As深度解读(三)——毒性可逆性评估与恢复期研究设计要点
ICH M3(R2) Q&As深度解读(四)——Combination Drug毒性测试的时机与设计指南
ICH M3(R2) Q&As深度解读(五)——Exploratory Clinical Trials的非临床支持策略
ICH M3(R2) Q&As深度解读(六)——Reproductive Toxicity与Juvenile Animal Studies特殊要求
ICH S7B | 药物延缓心室复极化(QT间期延长)的非临床评价策略
多肽药物如何克服成药性(Druggability)屏障重回黄金赛道?
环状肽药物发现新纪元(上篇):二十年数据透视、结构设计与口服递送攻坚
环状肽药物发现新纪元(下篇):22款临床候选分子的靶点攻坚与转化图谱
工业级大环肽筛选平台行研:主流技术路径、代表企业与临床成药性突破
诺华(Novartis)如何降低新药后期失败率?揭秘早期研发中的可开发性评估(DAG)策略
RDC | 诺华 Pluvicto 药理、DMPK、毒理与临床研究
重磅修订!2026版GCP正式发布——六大章节全面升级,9月1日起施行
新药研发“黑科技”全景图:七大阶段×前沿技术×关键数据库全解析
新药研发 | 为什么新药这么贵?从 10,000+ 化合物筛选到 1 个获批的全流程复盘
新药研发 | 从 Hit 到 Lead:跨越早期药物发现的“死亡之谷”
新药研发 | CNS的新战场:从“跨越BBB”到“修复BBB”
30款仅9个透脑!一文揭透CNS-PROTAC研发的“血脑屏障”突围战
(三)核酸药物
从Patisiran到Zodasiran——8种siRNA药物首次人体试验起始剂量设计案例解析
GalNAc-siRNA药物临床前安全评价全解析:从肝脏靶向递送到非临床毒理风险管理
阿斯利康 DMPK 三部曲(下):DDI、CNS 与临床转化