ARTICLE · 1071952
AI 的真正进步:从“参数更强”到“任务更清楚”
AI 正在进入三个越来越具体的场景:佩戴在身体上的设备、帮助人学习的工具,以及直接参与软件性能优化的工程系统。
它们看起来没有太大关系,但背后其实共享一个问题:
当 AI 的能力越来越多,怎样判断它到底带来了真实价值?
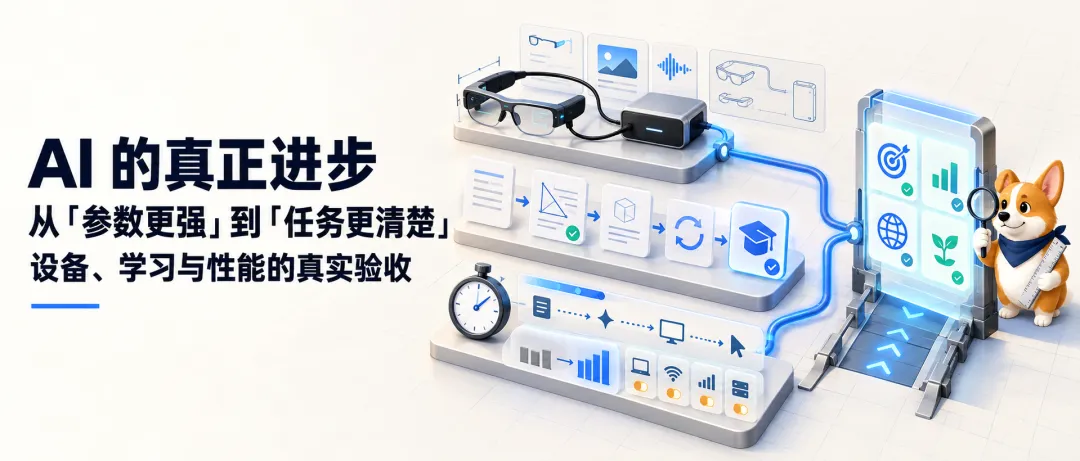
答案不能只看设备有多轻、模型答题有多快,或性能数字提升了多少。更重要的是看清任务边界、测量真实结果,并保留足够的人工判断。
100 克的眼镜,可能只是系统的一部分
如果只看发布会标题,AI 眼镜似乎正在同时变成耳机、摄像机、显示器和电脑。但进一步查看产品说明会发现,这些能力分布在不同设备、不同型号和不同上市阶段。
9 月 23 日,Meta 介绍了约 100 克的 VR Glasses。这个重量对应佩戴在脸上的眼镜部分,显示与传感器位于眼镜上,而计算、电池和存储则放在通过线缆连接的外置盒中。减轻面部负担当然有价值,但整套系统并不是只有 100 克。 Meta
官方计划在 2027 年春季发售这款 VR 设备,美元标价为 1299.99。它不是已经全面开卖的产品,内容服务也可能受到订阅、地区和时间影响。因此,评价这类设备时,不能只截取最轻的那个数字,还要把外置盒、线缆、供电、收纳和连续使用一起算进去。
这不是产品设计的缺点,而是轻量化设备必然面对的取舍:负担可以从头部转移到口袋、腰包或其他位置,但不会凭空消失。
同场公布的 Ray-Ban Meta Audio、具备摄像能力的 Gen 3、带显示的 Meta Ray-Ban Display,以及新的 VR Glasses,也不是同一种产品。它们分别对应音频与语音、环境感知、信息显示和沉浸式工作空间等不同路线。 Meta AudioMeta Display
因此,选择 AI 眼镜之前,首先要问的不是“哪款功能最多”,而是自己真正要完成什么任务。
经常听播客、接电话的人,可能更在意音频入口;需要查看通知、日历和导航的人,可能更关注显示能力;希望脱离桌面处理多屏任务的人,则可能需要完整的计算与显示系统。发布会展示的是能力集合,个人购买需要的是具体使用场景。
软件可用性还会因国家、语言和时间不同而变化。某个硬件开始预购,不代表演示中的全部功能已经同步开放。德国相关安排还涉及预购、10 月发售和处方镜片等不同阶段,实际价格、税费、渠道与服务条件应以当地正式页面为准。
当 AI 入口靠近身体,交互边界也更重要。一次口头指令究竟是在查询资料,还是在修改日程?眼前看到的是建议,还是已经执行的动作?声音、周围环境、日历和联系人又分别会进入哪些数据路径?这些都不能只依靠产品宣传来回答。
AI 教学的结果,不该只看模型答对多少题
一个 AI 能答对题目,不代表它能帮助学生真正学会。
学生可能看懂了解释,却无法独立完成下一道题;也可能在对话中表现得很投入,但过一段时间后仍然无法迁移所学内容。因此,评价 AI 教育工具时,问题应该从“模型答得多好”转向“学生经过辅导后发生了什么变化”。
9 月 23 日提交的 StudentBench 预印本,报告了 2383 位参与者在 GRE 数量与语言问题上的辅导比较,涵盖 AI、人工辅导和无辅导条件。作者报告了特定条件下的学习增益等效性结果,并进一步考察课程规划、练习题和教学互动。由于目前只依据预印本摘要,尚未完成全文审阅或独立复现,这些结果不能直接推广到基础教育、长期学科学习或特殊学习需求。 arXiv
阅读这类研究时,首先要问“学会”是怎样定义的。
是刚接受解释后能够完成相似题,还是经过一段时间仍然能够迁移到新问题?是一次考试分数提高,还是长期理解和独立解决问题的能力增强?测量时间和任务设计不同,结论的含义也会不同。
其次要看参与者是谁。原有能力、学习动机、考试熟悉程度和参与方式,都会影响辅导效果。样本数量较大固然有价值,但不能自动代表所有年龄和背景的学习者。
还要谨慎理解“统计等效”。它不表示两种方式在所有方面都完全相同,也不表示每位学生都获得了相同体验。真正有意义的评价,还需要关注差异区间、测量精度、学习保持时间和新情境中的迁移表现。
成本口径也不能混淆。单位学习增益的成本,不等于一名学生一年的完整教育成本。课程设计、教师监督、设备、账号管理、数据保护和异常处理,都可能不在同一统计范围内。
对学习工具而言,更值得保留的是一套明确的反馈机制。先让学习者尝试,再指出推理中的缺口;先让学习者组织答案,再提供提示;最后用相近但不同的问题检查是否真正理解。
AI 解释错误时,学生能不能发现?学生表达含糊时,系统会澄清还是直接猜测?遇到不适合继续自动辅导的情况,能否转向教师、家长或其他合适的人?这些问题可能不会完整体现在一次考试成绩里,却决定工具能否长期使用。
一个好的 AI 学习工具,不是让学生更快看到答案,而是让学生离开工具后仍然能够独立回答问题。
性能优化之前,先定义什么叫“变快”
“网站变慢了”并不是一个足够清晰的工程指标。
用户可能是在等待页面打开、等待输入框可用、等待第一次有效结果,或等待已有内容稳定显示。不同的开始和结束定义,会把优化工作引向完全不同的位置。
9 月 23 日,Claude 工程团队公开了一场发生在 8 月的性能冲刺。文章用多个用户路径的测量概括约三倍改善,涉及网页和桌面体验,并不是模型输出速度统一提升三倍。团队使用内部研究模型,同时保留人工批准和发布控制。这些条件不能在转述时被省略。 Claude Engineering
比“三倍”更值得借鉴的,是它强调先测量,再修改。
一个具体的性能指标,可以是:
打开页面到能够输入; 点击操作到看到第一条有意义的结果; 切换记录到内容稳定显示; 发起请求到用户能够继续下一步。
先选择一条窄路径,比直接提出“全面优化性能”更容易得到可靠结果。
接着要区分等待来自哪里。客户端渲染、网络请求、服务处理和模型调用,都可能贡献总耗时。只记录一个总数字可以发现问题,却不一定能解释原因。让 AI 帮忙整理测量点、分析日志和提出候选修改,往往比直接让它重写整个架构更容易检查。
实验室指标也不能直接等同于用户体验。某个函数调用减少,可能是有效优化,也可能与用户等待几乎无关。一个页面加载得更快,如果关键内容被延迟、验证步骤被跳过,或者错误提示消失,整体体验未必真的改善。
每次修改都应控制范围,先有测试,再改实现。速度和功能正确性需要同时检查,不能通过删掉必要内容、减少关键验证或隐藏错误来制造更快的数字。
比较时,还要记录设备、网络、数据量、冷启动和预热状态。一次录屏顺利,不代表低性能设备、长记录或不稳定网络下也同样顺利。平均值变好,也不代表最慢的一部分用户没有变得更糟。
真正有价值的优化,还必须能够持续保住。将稳定反映问题的测试留下来,在后续版本中反复运行;对波动指标先理解噪声,再设置合理阈值,避免误报过多后被团队忽略。
同一套方法:先明确任务,再测量结果
AI 眼镜、学习工具和性能优化看似属于不同领域,但都说明了一件事:
能力越多,越不能用一个漂亮数字替代完整判断。
对硬件,要把眼镜、计算盒、线缆、软件、地区和服务放在同一套条件里看;对教育,要把模型表现与学生的理解、保持和迁移分开;对性能,要把实验室指标与真实用户等待分开。
评价 AI 产品时,可以始终追问四件事:
用户真正要完成的任务是什么? 结果应该从哪个动作开始、到哪个状态结束? 哪些条件被纳入测试,哪些条件没有覆盖? 速度提升之后,功能、隐私、可维护性和可理解性是否仍然保持?
AI 可以帮助发现候选方案、整理测量数据、生成代码补丁和设计练习,但它不能替我们决定什么才算真正改善。
先让问题可观察,再让修改可验证,最后让结果可持续。这样得到的进步,也许没有发布会上的数字那么耀眼,却更可能真正改变日常工作。