ARTICLE · 1073451
90 分钟,AI 的天花板和地板一起换了
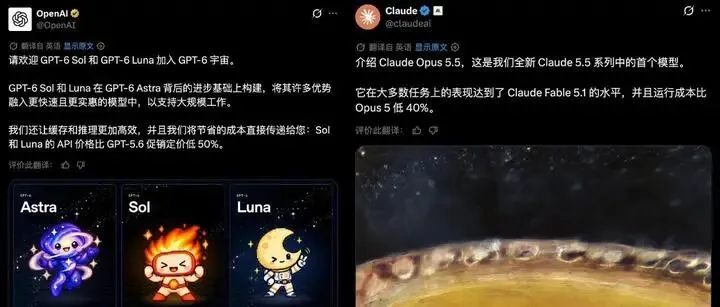
9 月22 日,Anthropic 先动手,发布Claude Opus 5.5。
90 分钟后,OpenAI 跟上,发布 GPT-6 Sol 和GPT-6 Luna。
三家同日登场,一个把能力往天花板顶,两个把价格往地板压。
01 90 分钟
Anthropic 发布Opus 5.5 后90 分钟,OpenAI 的Sol 和Luna 上线。
02 往上顶的那个
Opus 5.5 是Anthropic 5.5 系列的第一款。多数任务上达到Fable 5.1 的水平,典型负载成本比Opus 5 低40%,输出速度快30% 以上。
价格是每百万token 输入4 美元、输出20 美元,比Opus 5 便宜20%;缓存读取0.2 美元,比Opus 5 低60%。1M 上下文默认开启,最大输出128k。
还有一件事要说:thinking 关不掉了。API 里传thinking: disabled 会直接返回400 错误。再配上"保留思维"(preserved thinking)这套反蒸馏机制——它阻止API 用户修改Claude 的既有上下文来套取推理过程——Anthropic 这次是把推理链条当资产看管起来了。
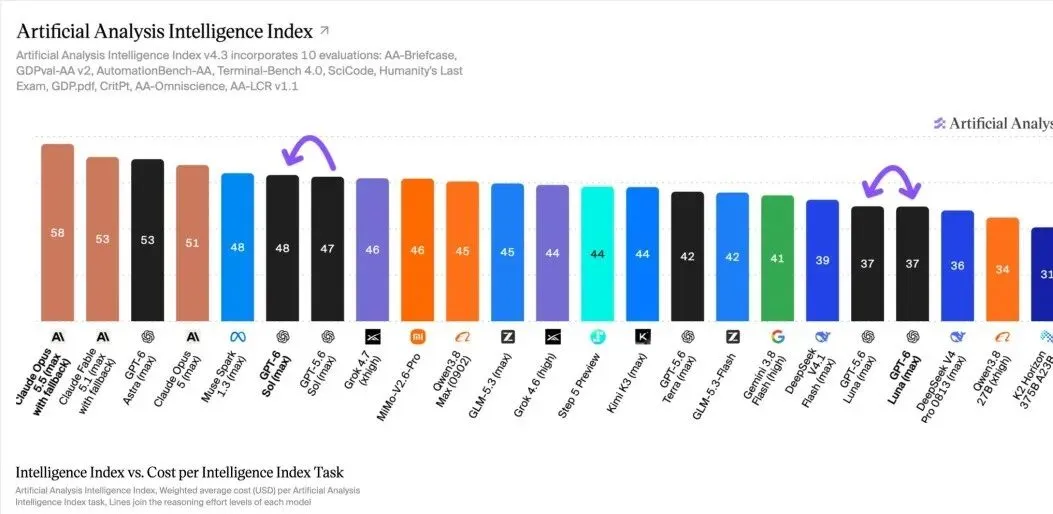
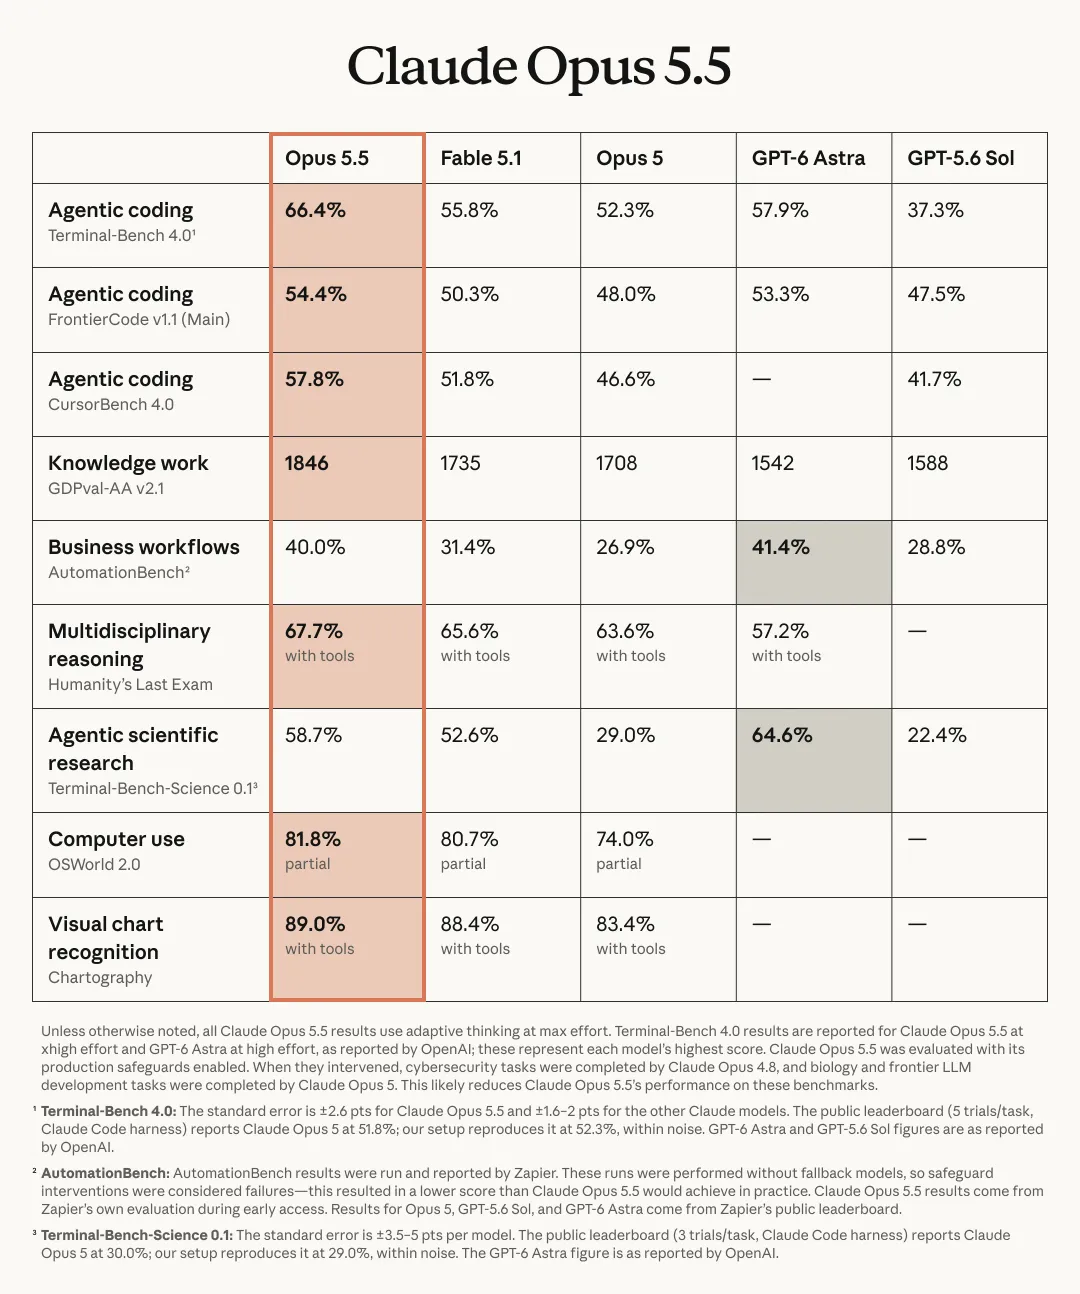
Artificial Analysis 智能榜上58 分,第一;Fable 5.1 和GPT-6 Astra 都是53 分。Anthropic 公布的9 项测试里,Opus 5.5 有7 项领先Fable 5.1、Opus 5、GPT-6 Astra 和GPT-5.6 Sol,三项编程测试全部最高分。CursorBench 4.0 上比GPT-5.6 Sol 高约11 个百分点,而每任务成本约为对方的三分之一。
几个具体的活儿更能说明问题。把负载均衡软件HAProxy 从C 语言改写成Rust,用了9.5 小时,成本比Fable 5.1 低51%。一项财报研究测试要求逐条核对数字和引语,它生成的18 份报告里16 份达标,Fable 5.1 和Opus 5 一份都没过。还有早期测试者用它做68 万行代码的迁移,不到一天完成。
也有没赢的:业务流程和科研Agent 这两项测试,Opus 5.5 仍然落后GPT-6 Astra。旗鼓相当不是全面领先,这点两家都清楚。
03 往下压的那两个
OpenAI 这次的重点不在更强,在更便宜。两个模型都基于GPT-6 Astra 的方法训练,但优化目标换成了成本效率,而不是能力上限。
模型 | 定价(每百万token) | 上下文/ 输出 | 定位 |
Claude Opus 5.5 | 输入4 美元/ 输出20 美元 | 1M / 128k | 长程Agent 编码与知识工作,冲能力上限 |
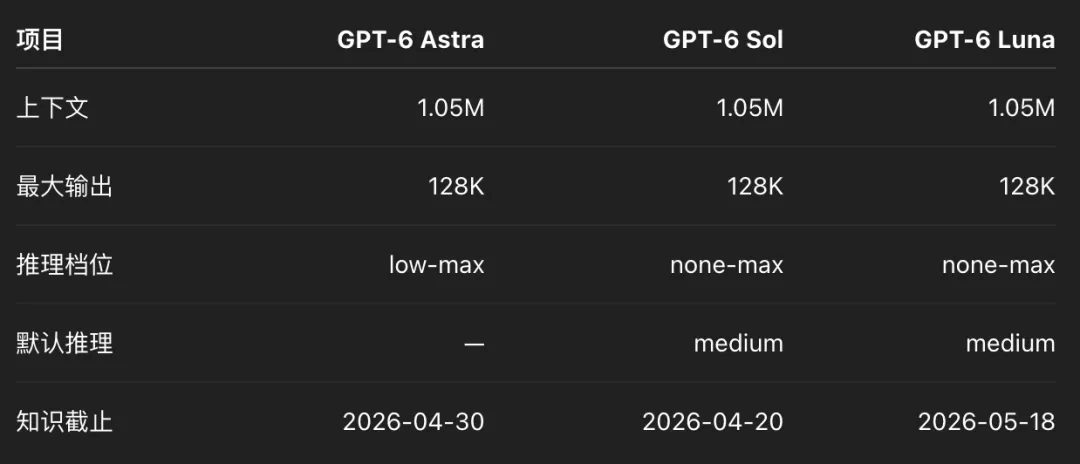
GPT-6 Sol | 输入2 美元/ 输出10 美元 | 105 万/ 128k | 复杂推理、编码、企业工作流自动化 |
GPT-6 Luna | 输入0.1 美元/ 输出0.5 美元 | 105 万/ 128k | 摘要、抽取、快问快答等高频批量任务 |
注:Sol 与Luna 定价相比GPT-5.6 系列的促销价再降一半。Luna 缓存读取低至0.01 美元,为输入价的十分之一。
Sol 的成绩单:AutomationBench(真实业务流程)最高档33.2%,每任务0.27 美元;Agents' Last Exam(长程专业工作流)最高档56.4%,OpenAI 称以低60% 的单任务成本超过Opus 5 的最好成绩;DeepSWE v1.1 得68.8%,Claude Fable 5 是69.9%——差1.1 分。
事实性是另一个被重点讲的指标。OpenAI 用一批真实对话做内部评测——就是那些用户标记过"你说错了"的对话——Sol 的错误率约为前代的一半,接近Astra 的水平,价格却是零头。
Luna 的数字更狠:DeepSWE 66.6%,只比Sol 低2.2 分,而每任务成本比Claude Opus 5 低93%。
还有一处容易被忽略的工程细节:OpenAI 这次把缓存读取折扣拉到最高90%,30 分钟重用窗口,同时给了缓存仪表盘、缓存诊断、显式缓存断点和缓存预热。这不是模型能力的改进,是把"省钱"做成了一整套工具。
04 战场换了个指标
把两家的通稿并排看,会发现一件有意思的事:它们都不太谈谁更聪明了,谈的是干完这活儿花多少钱。
Anthropic 说"典型负载成本降40%",OpenAI 说"每任务成本是对方的9%"。跑分还在比,但比分的单位变了,从分数,变成了分数除以美元。
我的判断是:这三个模型里,真正改变格局的不是Opus 5.5,也不是Sol,是Luna。
Luna 的输入价是每百万token 0.1 美元,缓存读取0.01 美元。它同日进了GitHub Copilot,而且从Pro 档就给,比Sol 低一档。ChatGPT 的免费用户和Go 用户,通过桌面端也能用到。分发面比Sol 宽得多。
Sol 是头条,Luna 才是生意。当一个前沿家族的最便宜型号降到这个价位,竞争的性质就变了——从"谁家模型好",变成"谁家模型铺得到的地方多"。
05 越强的部分,锁得越紧
这次发布里还有一条暗线,两家都没放进标题。
Opus 5.5 在生物领域的能力超过了Opus 5,很多方面追平甚至超过Mythos 5.1——连长期分子预测与设计评测上的表现都被点名,外部红队对其科学新颖度的评级是"与测过的最好模型相当"。Anthropic 的做法是:给它套上跟Fable 5.1 同款的生物安全护栏。想用于被护栏挡住的研发,得申请新开的"生命科学验证计划"。
网络安全更直接:绝大多数网络安全任务会被转交Opus 4.8 处理——一个更弱的旧模型。日常开发里找bug、修bug 不受影响,但凡涉及攻防的,都往回退一代。
OpenAI 这边,两个新模型都强调了对递归自我改进(RSI)的护栏和增强的监督机制,措辞是"确保前沿系统在能力扩展的同时仍处于人类控制之下"。
把这些放在一起,结论有点反直觉:模型越能干,你能自由使唤它的范围反而越小。Anthropic 提出"pacing the frontier"(控制前沿节奏)之后,Opus 5.5 是它发布的第一款模型,发布前由Frontier Design 和METR 等外部机构做过测试。发布节奏本身,正在被当成一件需要管理的事。
还有两处OpenAI 没交代:105 万token 的上下文窗口没有对应的长上下文实测数据,谁也不知道它在那个长度上还稳不稳;Sol Pro 和Luna Pro 两个变体在发布当天出现在OpenRouter 上,通稿里一个字没提,跟标准版差在哪,目前无人说明。