ARTICLE · 1076454
Excel文本函数(一):提取与截取文本
1. LEFT —— 从左侧提取
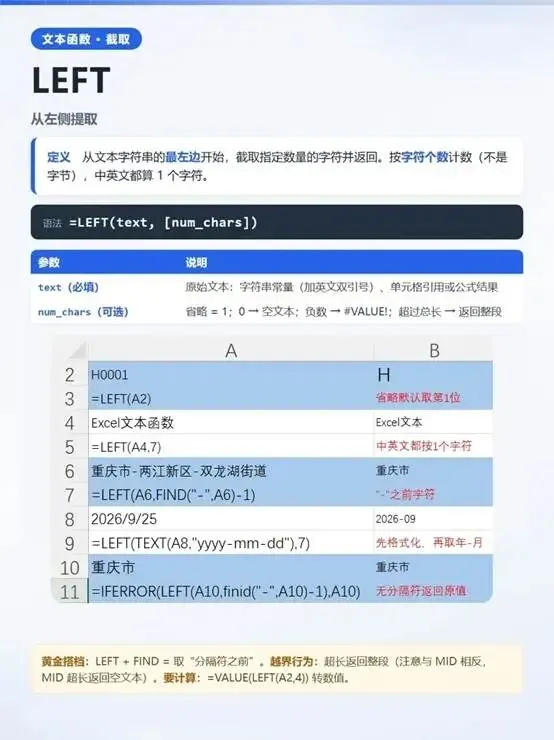
定义
LEFT用于从一个文本字符串的最左边开始,截取指定数量的字符并返回。它按字符个数计数(不是按字节),中英文字符都算1 个字符。
语法
=LEFT(text, [num_chars])
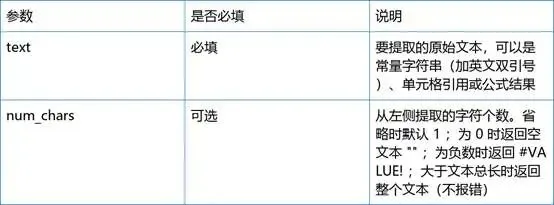
要点与易错
·FIND返回的是位置编号,减 1是为了去掉分隔符本身。
·越界行为与 MID 相反:LEFT 长度超过文本总长是"返回整段",MID是"返回空文本"。
·若要参与计算,用 VALUE() 或 -- 转换,例如 =VALUE(LEFT(A2,4))。
2. RIGHT —— 从右侧提取
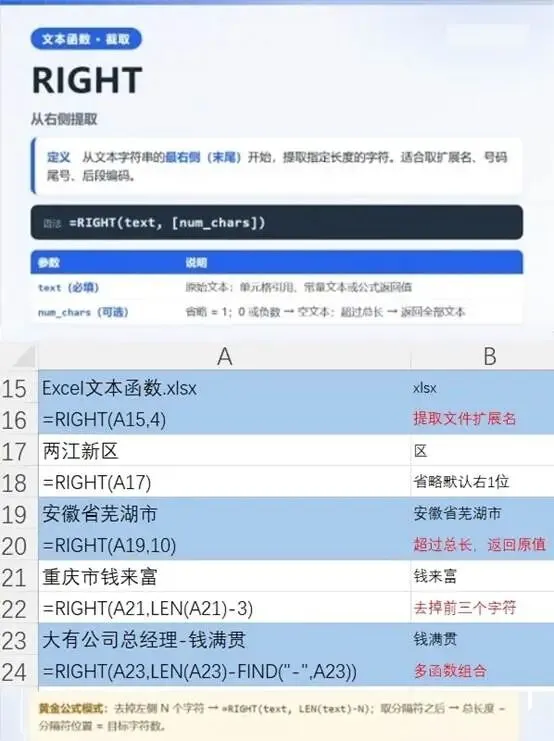
定义
RIGHT从文本字符串的最右侧(末尾)开始,提取指定长度的字符。适用于提取文件扩展名、编码尾号、号码后四位等末尾片段。
语法
=RIGHT(text, [num_chars])
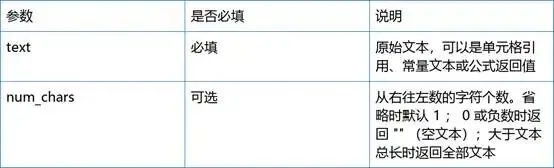
黄金公式模式
去掉左侧固定 N 个字符:=RIGHT(text, LEN(text)-N)
取出分隔符之后的内容:=RIGHT(text, LEN(text)-FIND(分隔符,text))
口诀:总长度 − 分隔符位置 = 目标字符数
3. MID —— 从指定位置截取
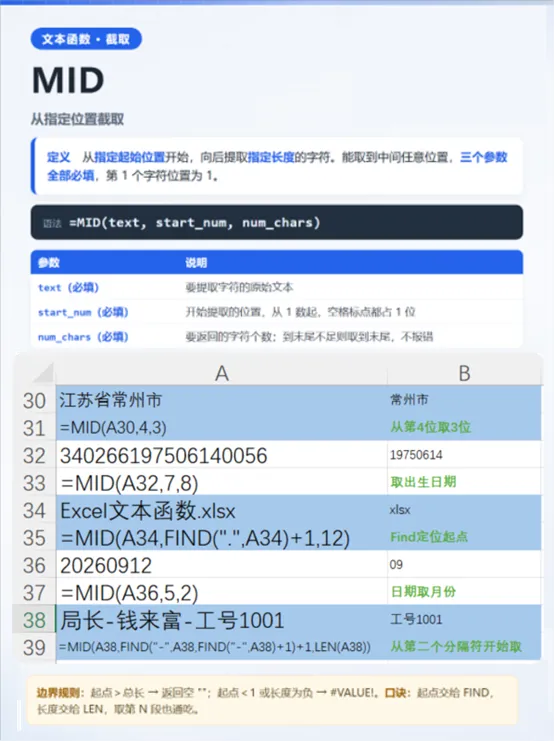
定义
MID从文本字符串的指定起始位置开始,向后提取指定长度的字符。与 LEFT、RIGHT 并称"文本截取三兄弟",但 MID 能取到字符串中间任意位置,灵活性最高。
典型用途:从身份证号提取出生日期、从订单编号解析区域代码、从混合文本中抽取数字或关键词。
语法
=MID(text, start_num, num_chars)
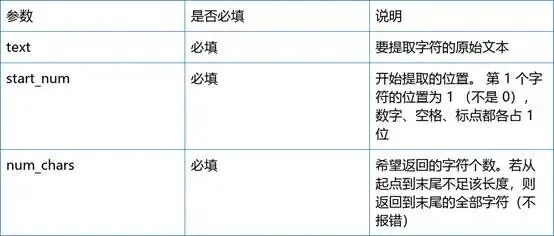
⚠️ MID 三个参数全部必填,一个都不能省。
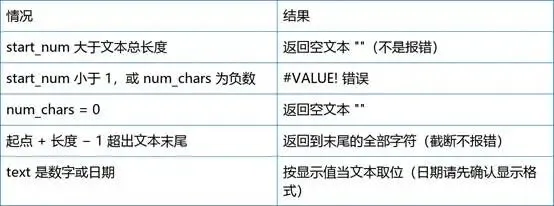
边界规则(背下来能省很多调试)
"取第 N 段"通用套路
内层 FIND定位第 1 个分隔符,外层 FIND从它后面继续找第 2 个,再 +1 就是起点;最后一个参数直接写LEN(text)当"保险",保证一路取到尾。遇到不规则文本时,起点交给 FIND,长度交给 LEN,几乎通吃。