ARTICLE · 1076446
OpenAI最近开除了几名外包人员.他们的工作是检查ChatGPT的回答,被开除的理由是,他们把这份活儿交给了来干.
EDITORIAL NOTE
替OpenAI训练AI的人,为什么反而因使用AI丢了工作?
9月22日,美国科技媒体404 Media报道,多名为OpenAI项目工作的外包人员,因为使用AI完成评审任务,被解聘或移出项目。他们原本的工作,恰恰是帮助改进AI:阅读ChatGPT的回答,判断它是否过分迎合用户、有没有把自己说得像真人,再写下评分和评语。
技术进步,最终要落到真实工作与生活
报道依据包括内部文件,以及三名不同项目承包人员的采访。其中,阅读真实用户对话的Project Lily涉及数百人,其他项目规模更大,不能全算成同一支队伍。一名受访者承认用过AI,并向记者提供了据称是解聘信的文件。
承包商Mercor确认,合同禁止用大模型代做项目任务,一旦查实便将人员移出项目。报道取得的一份复核人员工作文件,甚至把AI翻译和语法工具也列入禁用范围。OpenAI对相关人员被解聘一事拒绝置评。
于是,一个颇有讽刺意味的画面出现了:替AI公司训练AI的人,试着用AI提高效率,最后把自己的工作弄没了。报道原文
PLATE
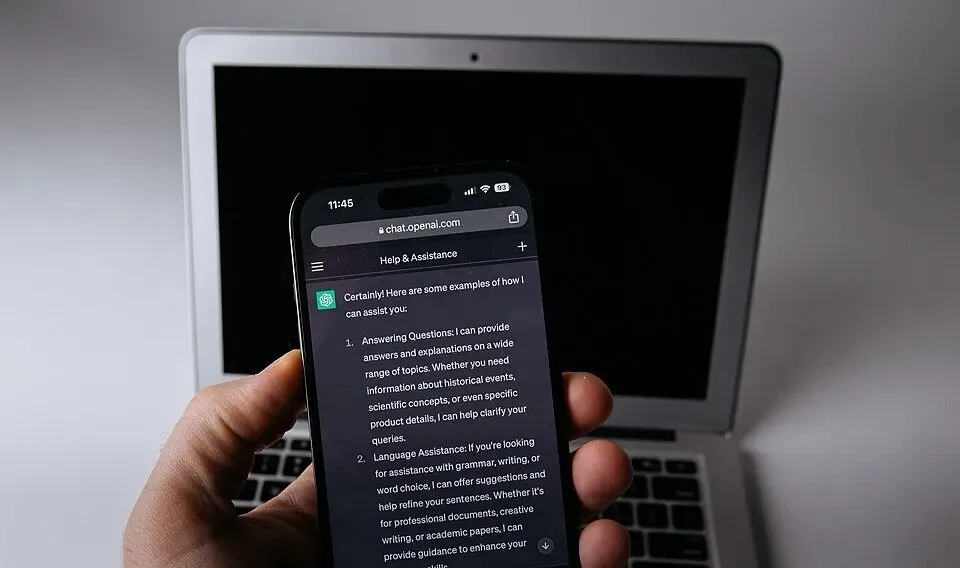
— ChatGPT使用场景示意,摄于2023年,非外包评审现场。Jernej Furman/Wikimedia Commons;CC BY 2.0:creativecommons.org/licenses/by/2.0
01
先设想一份很普通的差事。
老许给一家连锁店做巡查。总部让他到店里看看,货架是不是空了,店员有没有按规定办事,门口贴的促销价和收银机里的价格对不对。
结果他嫌来回跑麻烦,直接找店长要了份自查表,改改措辞,署上自己的名字,交差。
报告写得挺漂亮,二十家门店,一下午全部查完。若只统计交了多少份文件,老许简直是公司劳动模范。
可总部为什么要额外雇一个巡查员?店长自己会写报告,总部不知道吗?
它花这笔钱,买的是一份经过独立核实的判断。老许把字交上去了,把这份判断省掉了。
外包评审里那些分数,也是这个道理。表格上一个数字,背后本该有人读过、想过,能指出回答究竟哪里不对。
比如,用户说,同事今天没理我,他肯定在算计我。AI如果马上热情附和,还认真列出五条“反击策略”,读起来可能特别贴心。
评审要识别的,恰恰可能是这份贴心里的问题:证据还没有,怎么就把人家的猜测当成事实了?
这种时候,顺着说太容易了。愿意停下来,把前提重新检查一遍,才是那张评分表需要的东西。
如果评审连原对话都没认真看,就把另一段机器生成的赞美填进去,流程倒是走完了。可原本请来踩刹车的人,顺手又踩了一脚油门。
02
不过,这里还有一个看起来更别扭的事实。
OpenAI自己的技术文档,就介绍了让一个模型给另一个模型打分的办法。文档要求用可信的专家答案和评分来检验评分器,还提醒开发者留意一种问题:模型学会迎合打分规则,分数很高,实际表现却不行。官方评分文档
那怎么公司能用,外包人员不能用?
回到老许那里。总部当然可以看门店自查表,也可以装摄像头、做自动分析。每一种材料怎么来的,心里得有数。
但老许明明没到店,却把自查表装进“本人现场核验”的文件夹,后面的人就会误以为,多了一份来自现场的证据。
同一份材料换了件衣服,就冒充成第二个证人了。
假设原本准备收集100份人工判断,里面30份偷偷由AI代写,研究人员却不知道。他们以为自己听到了100个人的意见,实际拿到的,是70份人工意见和30份机器意见。
这个比例只是举例,不是报道统计。问题在于:连来源都弄错了,后面再精细地算平均分,也是在错账上认真打算盘。
自动评分可以公开设计、单独检验;冒充人工判断,会连检验的依据一起搅乱。
这不是打一份报告快不快的争论。客户买了现场巡查,你交一份漂亮的转述,再说自己提高了效率,账不是这么算的。
《驴得水》里,名单上多出一个“老师”,账面就能先转起来。表格填满,和事情做完,真是两回事。
03
至于“模型崩溃”,也可以借老许的报告看懂。
设想总部很久没接触真实门店,只看巡查报告;巡查报告又参考上一期总结,下一期总结再参考这批报告。最初现场有些零碎的小问题,没写进去,后来便越来越没人知道了。
材料越堆越厚,离现场却越来越远。
2024年7月,牛津大学等机构研究者在《Nature》发表论文,研究模型反复使用前代模型生成的数据训练时会发生什么。实验发现,无区别地依赖这类数据,可能逐渐丢掉原始信息中的少见情况,让错误累积,最终偏离原来的任务。
论文展示的一个例子很有画面感:原本围绕建筑的文本,经过多代训练,后来竟变成反复谈论各种颜色的长耳兔。句子还在往外冒,讨论的东西已经跑偏了。研究原文
但实验有具体条件,不能据此说,凡是AI生成的数据都不能用。论文里的实验也显示,保留一部分原始数据可以减轻退化。
几名评审违规,更不等于ChatGPT已经被他们“教傻了”。目前的报道没有证明这些评分进入了哪次训练,更没有量出它们造成了多大影响。
能确认的麻烦已经足够具体:一批原本标着“人类判断”的材料,真实性出了问题。即便暂时看不到模型出故障,也得把这些材料的来源查清楚。
04
写到这里,也别急着把所有人都骂成偷懒的混子。
报道里,一名被解聘者向记者解释,自己只是想借AI帮一点忙;他对这份工作感受不到乐趣,也不觉得在做有意义的事。这是他的个人感受,不能替违规开脱,却把另一半现实露了出来。
很多人想象的AI训练,是工程师站在大屏幕前,指挥一台越来越聪明的机器。落到这类外包任务里,却可能是一个人盯着屏幕,反复阅读、比较、打分。
人坐在那里,脑子有没有认真参与,考勤表看不出来。
假如管理者只盯完成数量和速度,就容易奖励那个最快交表的人;认真核对的,反倒显得慢。这是管理上需要防止的诱因,不能未经调查就当作本案的实际考核制度。
要买人的判断,就得给判断留出时间,检查评语有没有依据,让认真做事和敷衍交差真正拉开差别。给人发一张工牌,不会自动长出一份可靠意见。
对普通打工人,这件事也有个很实在的提醒:先弄清楚,对方付钱究竟要你交付什么,再决定哪一步可以交给工具。
有的工作允许你借助工具整理材料,有的工作就是要确认你亲自看过、独立判断过。把这条约定读明白,比偷偷换几个标点躲检查有用。
下次老许回到门店,收银台前的价签可能还是贴错了。
他把货架价格和结账小票放到一起,拍下来,写清楚哪一项不一致。这份报告也许不够漂亮,倒终于有了一条总部原先不知道的事实。
END NOTE
保持观察