ARTICLE · 1083377
【浅析】AI 越强,护理科研越难:模板化研究的红利正在结束
2026-09-26
2026-09-26
AI 越强,护理科研越难:模板化研究的红利正在结束
两种中文核心护理期刊 123 篇原始研究的设计构成,以及它们意味着什么
本文要点
本文抽样统计了两种中文核心护理期刊共 123 篇原始研究:横断面问卷、量表研制和质性访谈占 53.7%,非随机干预占 20.3%,依赖常规临床资料、预测模型或纵向随访的只有 8.9%。这个结构本身不是新闻,新闻是它为什么会在 AI 时代失去价值。
本文的核心论证只有一条线:一项研究的价值取决于它的信息增量与生产成本的比值。 模板化研究的信息增量本来就低,过去靠“写作成本高”维持着一个“做过研究”的信号;生成式 AI 把写作成本压到零,这个信号失效,出版系统于是转向不可生成的成本信号:原始数据、伦理链条、外部验证、多中心。这不是预测,PLOS 和 Frontiers 已经在做。
模板化研究的信息增量为什么低,本文给出方法学上的解释:横断面“影响因素”回答不了“改变 X 会不会改变 Y”;非同期对照识别不了干预效应;统计方法升级不改变信息增量。
用三个真实的科学问题示范什么叫有信息增量的护理研究:翻身频率与压力性损伤的剂量问题,出院准备度从测量到结局的断裂,症状网络从横断面到动态系统。每个案例都说明:模板做法产生了什么、回答不了什么、真正的问题是什么、需要什么资料与设计、AI 在其中能做什么和不能做什么。
一、先看数字:中文护理核心期刊在发表什么
讨论护理科研的形态,不能凭印象。国际上有现成的数据,中文期刊没有近年的,我们自己数了一遍。取《中华护理杂志》2025 年第 1、5、9、13、17、21 期,每 4 期取 1 期;取《护理学杂志》2026 年第 10、12、14 期。两本都是中华护理学会分级目录里的 T1 级期刊。对每一期的全部文章,逐篇读摘要里的“方法”段,按研究设计归类;述评、专家共识、标准解读、个案护理、综述、系统评价、Meta 分析、Meta 整合和证据总结不算原始研究,全部排除。得到原始研究 123 篇。分类由一人完成,依据是摘要。逐篇分类记录附在资料包里,每一篇都可以复核。
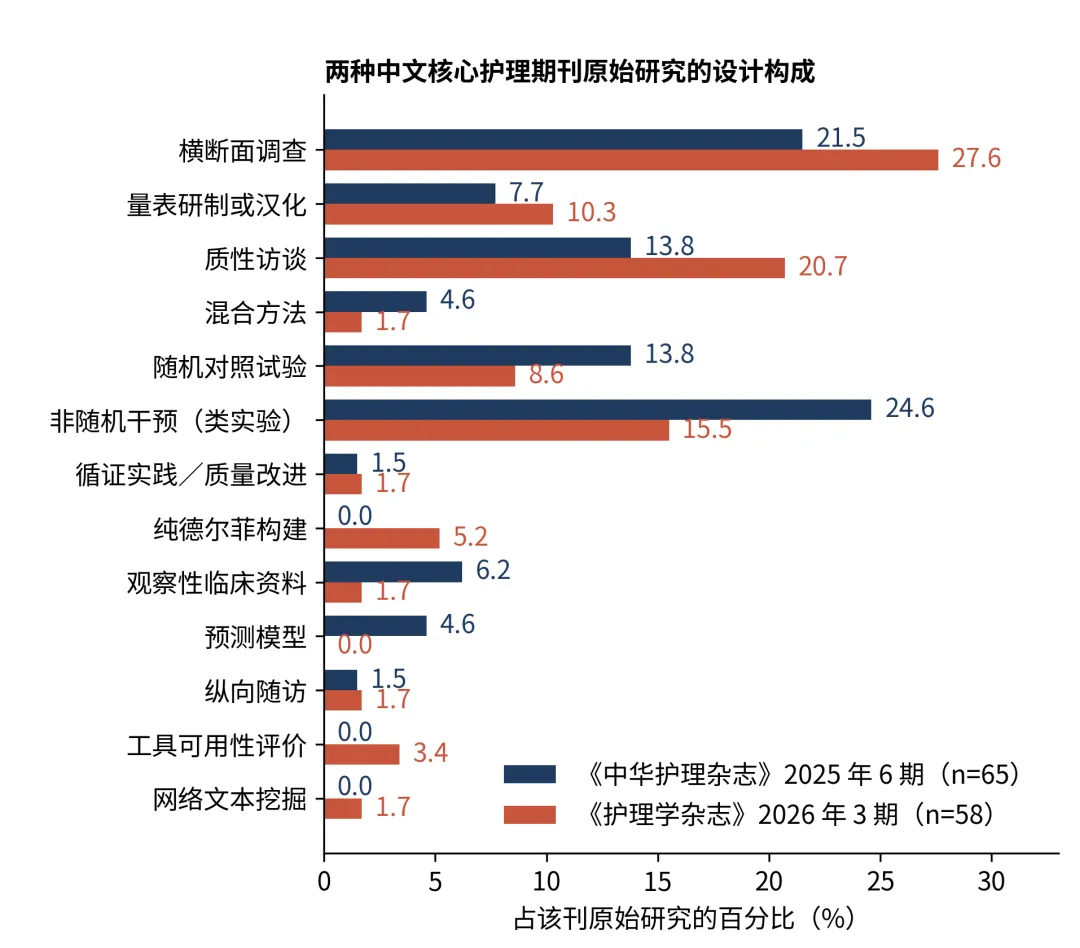
图1 两种中文核心护理期刊原始研究的设计构成
注:《中华护理杂志》取 2025 年第 1、5、9、13、17、21 期,《护理学杂志》取 2026 年第 10、12、14 期,均按摘要“方法”段分类。“横断面调查”含潜在剖面分析、结构方程模型、症状网络分析等基于单次问卷的研究;“非随机干预”含非同期对照、历史对照、按病区或时段分组和单组前后对照。
表1 两种期刊原始研究的设计构成
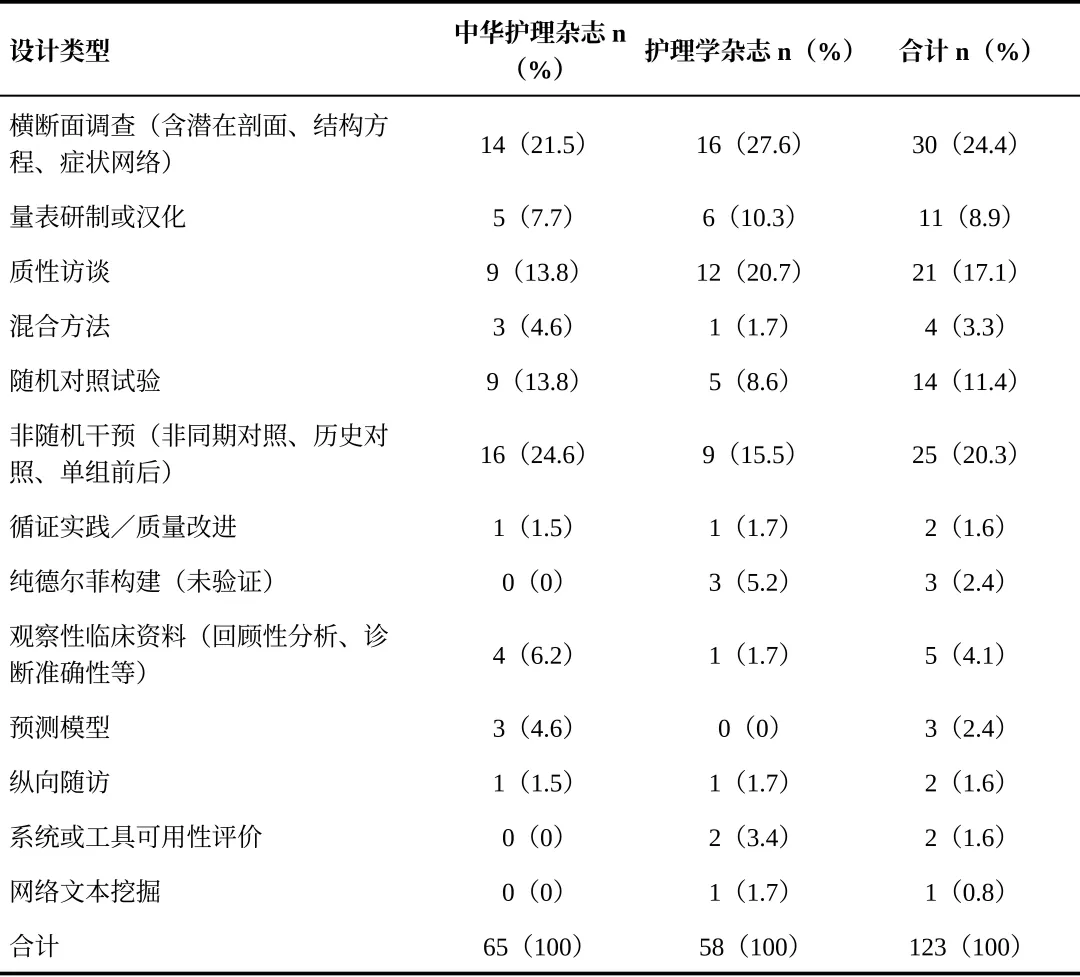
注:问卷类(横断面+量表)合计 41 篇(33.3%);问卷或访谈类(再加质性与混合)合计 66 篇(53.7%);干预研究合计 39 篇(31.7%),其中随机对照 14 篇(11.4%),非随机 25 篇(20.3%);以常规临床资料、预测模型、纵向随访或文本资料为基础的研究合计 11 篇(8.9%)。
这张表说了四件事。第一,问卷和访谈占一半多:两刊合计 53.7%,《护理学杂志》60.3%。第二,另一半里有一条同样固定的流水线:干预研究 31.7%,但随机对照只占 11.4%,非随机占 20.3%,这些非随机干预研究的写法高度一致,先做文献分析和德尔菲函询“构建方案”,再在某三级甲等医院便利抽样,前几个月收治的做对照、后几个月收治的做试验,比较干预后的量表得分;《中华护理杂志》25 篇干预研究里多中心的只有 1 篇。第三,真正依赖 AI 拿不到的资料的研究很少:常规临床资料、诊断准确性、预测模型、纵向随访、网络文本合计 8.9%,可穿戴设备一篇没有。第四,单中心和便利抽样几乎是默认设置。
国际期刊可以对照。Park 等 2025 年分析四本护理期刊 2015 到 2024 年的 5522 篇文章,横断面调查占定量研究的 31.2%,JAN 为 35.6%,日本护理科学杂志 46.9%,IJNS 只有 18.1%,因为它已经转向系统评价和随机对照试验;韩国成人护理杂志 2015 到 2024 年横断面设计占 90.8%。所以“以问卷为主”是东亚护理研究的共同形态,差别在于顶刊已经在转,普通期刊还没有。
这个统计有三点局限:只抽了两本顶级期刊,普通期刊的问卷比例几乎肯定更高,53.7% 应当看作下限;按摘要判定,摘要未说明分组方式的按非随机处理,可能低估随机对照的比例;单人分类,未做一致性检验。这些局限不改变结论的方向,但引用具体数字时请连同局限一起引。
二、这些研究生产了什么知识:一个"信息增量"的分析
看到这个结构,最容易说的一句话是“设计太简单”。但“简单”不是问题,很多简单的设计产生过重要的知识。问题要问得更准:这些研究比它们做之前,让我们多知道了什么? 这个“多知道的部分”,本文称为信息增量。下面对三类主流产出逐一分析,结论是它们的信息增量结构性地低,而这正是它们能被廉价复制的原因,不是结果。
2.1 横断面"影响因素":它在因果上说了什么
一篇典型的横断面研究这样写:“目的:了解某人群某量表得分现状及影响因素。方法:便利抽样,一般资料调查表加三到五个量表,多元线性回归。结果:得分处于中等水平,A、B、C 是影响因素。结论:建议针对影响因素进行干预。”
这段话里有三处因果语义上的问题。第一,构念驱动而非现象驱动。 研究问题不是从病房里的某个现象来的,是从文献里的某个构念来的:“自我效能影响自我管理”在文献里已经有了,于是换一个人群再测一次。这样得到的“影响因素”在做研究之前就能猜到,因为它们是被选进问卷里的变量,问卷里没有的变量不可能成为影响因素。第二,同源方法偏倚与反向因果。 所有变量由同一个人在同一时刻用同一种方式(自评量表)报告,变量之间的相关有相当一部分来自报告方式本身;而横断面无法区分“自我效能高所以自我管理好”和“自我管理好所以自我效能高”。第三,也是最关键的:影响因素分析回答的是“Y 与 X 相关”,而“建议针对 X 进行干预”预设的是“改变 X 会改变 Y”。 这两个命题之间隔着整个因果推断的距离。一项横断面研究无论样本多大、统计多复杂,都跨不过这段距离。
这不是说横断面研究没有用。它有两种正当用途:一是在没有人测过的人群里估计患病率或需求的分布,二是为一项干预研究提供假设。但本文抽样的 30 篇横断面研究里,几乎没有一篇是第一种用途,而它们的结论几乎全部越过了第二种用途,直接写成了干预建议。
2.2 非同期对照能识别什么
“德尔菲构建方案+非同期对照”这条流水线的逻辑是:先证明方案“科学”,再证明方案“有效”。两步各有问题。
德尔菲函询证明的是“专家同意这个方案合理”,不是“这个方案有效”。专家权威系数 0.85、肯德尔和谐系数有统计学意义,说明的是专家之间意见一致,与方案能不能改变患者结局没有关系。历史上被专家一致认可、后来被随机试验推翻的干预不胜枚举。
非同期对照的问题更根本。把前几个月收治的患者做对照、后几个月的做试验,干预效应与至少三种东西混在一起:一是时间趋势,医院的整体质量、人员配置、患者构成都在随时间变化;二是学习效应与关注效应,实施新方案的病房通常同时接受了培训、检查和研究者的持续关注,这些本身就会改善结局;三是病例组合的季节变化,冬季的呼吸科和夏季的呼吸科不是同一群患者。非同期对照无法把干预效应从这三种东西里分离出来,这就是为什么它在证据分级里位于随机试验之下、甚至位于设计良好的中断时间序列之下。要在不随机化的前提下识别干预效应,至少需要干预前后各多个时间点的序列资料,而不是前后各一组。
再加上单中心便利抽样,结论的外推范围就只剩“在这家医院这段时间的这些患者里,方案实施后得分变好了”。这句话的信息增量,对方案的设计者之外的任何人都很小。
2.3 统计升级不改变信息增量
抽样里有十几篇横断面研究用了潜在剖面分析、结构方程模型或症状网络分析。这些方法五年前还能让一篇论文显得高级,但它们不改变资料的性质:资料仍然是一次自评问卷,变量仍然是研究者事先选进去的构念,因果语义仍然是相关。潜在剖面把连续的得分切成了几个“类别”,结构方程把相关画成了带箭头的路径图,症状网络把相关系数矩阵画成了网络图。图变复杂了,我们对“改变什么会改变什么”的了解没有增加。第五部分的第三个案例会具体说明症状网络这一点。
2.4 小结
三类主流产出的共同特征是:资料来源单一(一次问卷或一次前后测量)、研究问题来自构念而非现象、结论超出设计的因果承载力。它们的信息增量低,不是因为研究者不努力,而是因为设计的上限就在那里。这个上限过去不构成问题,因为发表标准看的是“做得规范不规范”,不是“多知道了什么”。AI 改变的,正是这一点。
三、AI 改变了什么:一个"信号失效"的模型
要理解为什么 AI 会让模板化研究贬值,需要先理解它们过去为什么有价值。
3.1 发表曾经是一种成本信号
一篇论文在评审者眼里承载两种信息:它说了什么,以及它证明作者做了什么。第二种信息之所以可信,是因为写出一篇结构完整、术语规范、统计正确的论文本身有成本:需要受过训练、需要花时间、需要真的处理过数据。评审者不可能核查每一份原始问卷,于是“写得像研究”就被当作“做过研究”的信号。这在经济学里叫成本信号:信号之所以有效,是因为伪造它和真做一样贵。
模板化研究正是在这个信号机制下获得价值的。一篇横断面研究的信息增量很低,但它“写得像研究”,而写得像研究曾经需要真的做过一遍,所以期刊接收它,职称评审认可它。
3.2 AI 让写作成本与研究成本脱钩
生成式 AI 做的事情,是让“写得像研究”不再需要“做过研究”。Gao 等 2023 年的实验里,审稿人只能认出 68% 的 AI 生成摘要,同时把 14% 的真实摘要误判为机器写的,而且他们说不出被怀疑的摘要有什么具体破绽,只觉得“更含糊、更公式化”。这个实验用的是 2022 年底的模型,只测了摘要,之后没有人用护理全文重复过,但没有理由认为结果会更乐观。
把这个结果和第二部分的分析放在一起:模板化研究里凡是不依赖真实资料的部分,包括引言、方法的写法、讨论和结论,AI 都能生成得比大多数研究生更规范;而依赖真实资料的部分,模板化研究本来就很薄。于是一篇模板化研究里“AI 生成不了的部分”接近于零。这就是信号失效:写作成本归零之后,“写得像研究”不再证明任何事。
3.3 一次对照:让通用深度研究工具写这篇文章
写这篇文章的过程中,我们做了一次小的对照:把同一个题目和同一份提纲交给一个通用的“深度研究”工具,让它生成一份带文献的证据报告。生成的报告有摘要、七个章节、一张表、一张示意图、一份参考文献表,结构和术语都像一份合格的研究综述。然后逐条核对。
结果如下。报告称“国际护理期刊约 60% 到 70% 为横断面调查”,引用一篇 2021 年的文献;这篇文献不存在,真实数据是 Park 等的 31.2%,报告把它夸大了一倍。报告称“专家评审识别 AI 摘要的准确率约 55%”,引用一篇 2023 年的文献;文献不存在,真实的 Gao 等的数字是 68%。报告称“人工与 AI 质性编码一致率约 80% 到 85%”,引用一篇 2024 年的文献;文献不存在,真实的 Prescott 等的数字是 36% 到 47%,报告把它往有利的方向改了一倍。报告称国际护理编辑学会 2024 年发布了 AI 声明,我们专门找过,没有这份声明。报告称美国护士协会尚未发布 AI 指导,而它 2022 年 12 月就有理事会批准的立场声明。报告的参考文献表末尾有一行小字:“由于实际检索受限,下列文献信息仅示例格式。”
这不是在批评某一个工具。这是第 3.2 节那个实验在护理领域的重复:一份写得完全像研究综述的东西,十条数字里没有一条能被核查,而且在最关键的几处把数字改得对结论更有利。 如果一个研究者拿它去写文章,会写出一篇引用不存在文献、数据错一倍的稿子,而且自己看不出来。信号失效不是抽象的风险,是我们在写这篇文章的当天就遇到的事。
3.4 守门人转向不可生成的成本信号
信号失效之后,评审者有两个选择:放弃筛选,或者换一种成本信号。现实是第二种,而且换得很快。
Hanson 等 2024 年统计,Scopus 和 Web of Science 收录的论文总量 2022 年比 2016 年高 47%。Suchak 等 2025 年检出 341 篇基于美国 NHANES 公开数据库的“单因素关联”论文,年发表量从 2014 到 2021 年平均每年 4 篇,涨到 2024 年前十个月的 190 篇;Frontiers 收到的 NHANES 投稿从 2023 年 1 月的 56 篇涨到 2024 年 11 月的 286 篇。作者在其中 28 篇抑郁相关论文里重新检验了报告的关联,经错误发现率校正后只有 13 个仍然显著。
出版商的反应:据 Science 2025 年 10 月的报道,PLOS 和 Frontiers 已经对使用公开数据集、又没有外部验证的稿件实行自动拒稿,PLOS 的负责人说政策实施首月这类稿件的拒稿率从 40% 升到 94%,Frontiers 半年退回 5000 多篇;Journal of Global Health 对公开数据集稿件实行强制核查清单;PLOS Medicine 发布了公开数据二次分析的十点指南。Byrne 和 Stender 把这叫“科学摩擦”。注意这些新门槛的共同点:外部验证、原始数据、预先登记、多中心、伦理批件,全都是 AI 生成不了的东西。 守门人在寻找新的成本信号,找到的必然是“不可生成的成本”。
规范层面走在同一条路上。ICMJE 和 COPE 在 2023 年先后规定 AI 不能署名、使用必须披露;Jeong 和 Ko 2026 年检查了 154 种 PubMed 收录的护理期刊,70.1% 已有 AI 政策,88% 明确禁止 AI 署名。但披露只是第一步;PLOS 和 Frontiers 做的是第二步:不问你用没用 AI,问你的数据能不能被核查。
3.5 推论与它的边界
目前所有这些限制针对的都是公开数据库二次分析和孟德尔随机化研究,没有任何护理期刊宣布限制横断面问卷研究。本文的判断是推论:护理的横断面问卷研究和公开数据库研究在信号结构上是同一类东西,都是“信息增量低、写作成本曾经高”的产出;当守门人开始按“数据能否核查、问题是否必要”来筛选,它们会被同一个标准筛掉。而且这条流水线已经进入护理期刊:本文抽样的《护理学杂志》2026 年第 10 期里,就有一篇用 CLHLS 公开数据做的空巢老人认知障碍分析。这不是说那篇文章有问题,是说那种产品已经在这里了。
这个模型可以画成一张图。横轴是 AI 时代的边际生产成本,本质上是“AI 能否替代资料来源”;纵轴是信息增量。
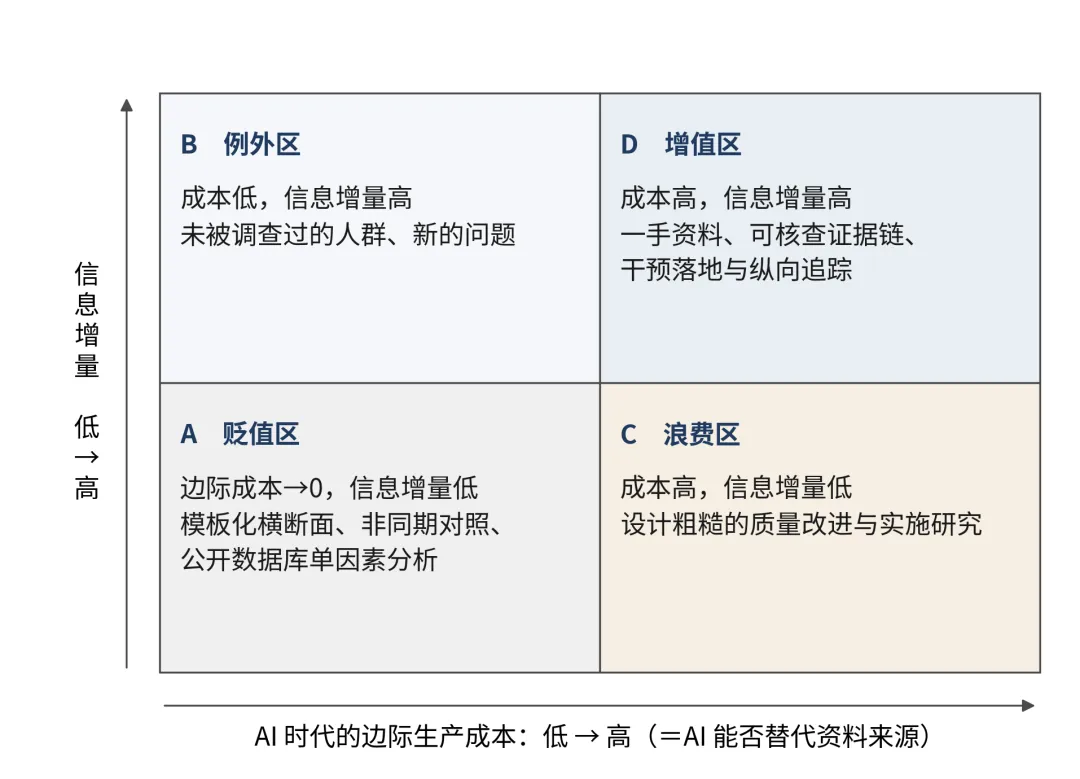
图2 信息增量与边际生产成本:AI 时代研究价值的四种位置
注:本图是分析框架的示意,不是评分工具。A 区的产出并非没有价值,而是价值随边际成本归零而归零;B 区是真实存在但很小的例外;C 区提醒实践型研究本身也可能落入低信息增量;D 区是本文主张的方向。
结论可以说得很硬:贬值的不是某种研究设计,而是 A 区的产出,也就是“AI 能替代其资料来源、而信息增量本来就低”的研究。增值的是 D 区:资料只能在真实照护场景里产生、而且回答了一个之前没有答案的问题。 “越来越难”的确切含义是:从 A 区到 D 区没有捷径,中间隔着资料、伦理、时间和临床位置。
四、护理为什么暴露最大,又为什么潜在优势最大
如果信号失效对所有学科都成立,为什么本文说护理受影响最大?因为护理科研的三个结构性特征让它在 A 区的比例特别高;同一组特征反过来也说明护理在 D 区有别人没有的位置。
第一,问题来自构念而非现象。 护理研究生的选题训练通常是“找一个还没在某人群测过的量表”,而不是“找一个病房里还没被解释的现象”。李峥等 2019 年分析 248 篇护理学博士论文,量性研究占 75.40%,统计方法里出现最多的是量表信效度分析和结构方程模型;博士尚且如此,硕士只会更集中。构念驱动的问题天然落在 A 区,因为它的答案在选变量的时候就已经决定了。但护士是整个医疗系统里离现象最近的人:为什么同样的出院指导有的患者三个月后回来了,为什么夜班的跌倒集中在某个时段,为什么某个科室的压力性损伤总比隔壁高。这些问题 AI 提不出来,因为它没有在那个病房待过。
第二,近水楼台的资料没有被用。 护理记录、生命体征的连续监测、跌倒和压力性损伤的事件记录、出入量、翻身记录、交班记录,每天都在产生,绝大多数从来没有被研究过。Mitha 等 2023 年综述了 43 项用自然语言处理分析护理记录的研究,只有 8 项用了护理专用术语;Scharp 等 2024 年综述急性期后照护的类似研究,只找到 21 项。本文抽样的 123 篇里,用常规临床资料的只有 5 篇。这些资料的门槛在数据治理,不在写作,而这正是 AI 替代不了、护士有位置优势的地方。
第三,计数激励。 职称看篇数不看设计,横断面三个月一篇,纵向一年一篇,“方案构建+非同期对照”是干预研究里周期最短、不需要随机化和多中心的做法。这个激励过去把研究者推向 A 区;当 A 区的产出被守门人贬值,同一个激励会把人推向哪里,取决于评审标准变不变。这不是研究者能独自决定的事,但研究者能决定自己往哪走。
把三条合起来:护理科研在 A 区的比例高,是因为它把最容易的资料(问卷)当成了全部资料;护理在 D 区的潜在优势大,是因为它离最难的资料(真实照护场景)最近。AI 时代的稀缺资源从分析能力变成了三样东西:好的研究问题、可获得的真实资料、能把研究嵌进临床的位置。这三样恰恰是临床护士比方法学家更有优势的地方。
五、三个案例:什么叫有信息增量的护理问题
前面的分析如果只停在框架上,就还是空的。下面用三个护理研究里最常见的题目,逐一说明:模板做法产生了什么,它回答不了什么,真正的科学问题是什么,需要什么资料与设计,AI 在其中能做什么、不能做什么。三个案例都有已发表的高质量研究可以对照,不是假想。
案例一 翻身与压力性损伤:护理剂量的因果问题
模板做法产生了什么。 压力性损伤是护理研究里发表量最大的题目之一。模板产出有两种:一种是“某科室压力性损伤发生现状及影响因素”的横断面或回顾性分析,结论永远是年龄、Braden 评分、住院时间、白蛋白;另一种是机器学习预测模型,Pei 等 2023 年系统综述了 18 项这类模型,16 项(88.9%)为高偏倚风险,主要问题是每个预测变量对应的事件数不足、缺失数据处理不当、没有处理过拟合。两种产出的共同点是:它们都把“护理做了什么”当作背景,把患者特征当作解释变量。
它回答不了什么。 压力性损伤是极少数几乎完全由护理干预决定的结局之一,而最核心的护理干预是翻身。但翻身作为一种“剂量”,从来没有被认真测量过:多久翻一次、每次翻到什么角度、实际执行和记录上写的是不是一回事。所有那些预测模型里,“翻身频率”要么不在变量表里,要么是护理记录上“q2h”三个字母,而 q2h 是医嘱,不是执行。一个把最重要的暴露变量当成常数的模型,无论 AUC 多高,都不能告诉护士该做什么。
真正的科学问题是什么。 护理执行的剂量与结局之间的关系。这个问题有真实的临床后果:如果 4 小时翻一次和 2 小时翻一次效果相同,那么一个病区每天可以省下大量护理时间用在别处;如果不同,那么现在很多病区实际做不到 2 小时的现状就是在制造损伤。Bergstrom 等 2013 年的 TURN 试验回答了这个问题的一部分:在美国和加拿大 27 家养老院的 942 名中高风险居民中,随机分配 2、3、4 小时翻身,在高密度海绵床垫上三周内压力性损伤发生率没有差异。这项研究的信息增量极大,它直接改变了指南和人力配置。但它只回答了养老院、海绵床垫、三周这一个情境;ICU、手术后、气垫床、更长时间的剂量关系仍然没有答案。
需要什么资料与设计。 两条路。一是随机试验,像 TURN 那样,但护理界很少有人做,因为它需要多中心、需要护理部支持、需要几年。二是利用现有资料做目标试验模拟:翻身在很多医院已经有带时间戳的电子记录,一些病区在用体位监测传感器;把每个患者每天的实际翻身间隔作为暴露,用倾向评分或边际结构模型处理混杂,可以在不做随机试验的前提下逼近剂量反应关系。第二条路的门槛全在资料:要拿到翻身记录的原始时间戳而不是“已执行”的勾选框,要处理记录与执行的差异,要有信息科和数据治理的支持。
AI 能做什么,不能做什么。 AI 能做的是:从护理记录的自由文本里抽取体位和时间,写目标试验模拟的分析代码,检查混杂处理的逻辑。AI 不能做的是:让翻身的时间戳存在,说服护理部允许安装传感器,判断“记录了翻身”和“真的翻了”之间的差距在这家医院有多大。后面这三件事,只有在病房里的人做得了。
案例二 出院准备度:从测量到结局的断裂
模板做法产生了什么。 出院准备度是中文护理期刊里最常见的题目之一。本文抽样里就有“某手术患者出院准备度现状及影响因素的路径分析”,用的是结构方程模型。这类研究的结论一致:出院准备度处于中等水平,社会支持、自我效能、出院指导质量是影响因素,建议加强出院指导。
它回答不了什么。 出院准备度量表存在的理由,是假设“评估了准备度,护士就会据此调整出院准备,患者的再入院就会减少”。这条链有三个环节:测量、行动、结局。横断面研究只在第一个环节上打转,它甚至没有问后两个环节存不存在。
真正的科学问题是什么。 评估到底有没有改变结局,如果没有,链条在哪一环断了。这个问题已经被认真回答过一次,答案令人不安。Weiss 等 2019 年的 READI 试验在 33 家磁性医院各选两个内外科病区,一个随机分配实施结构化出院准备度评估,一个照常,共三个逐步升级的方案:护士评估、加上患者自评、加上按临界值采取行动。总体结果:评估没有减少 30 天内的再入院和急诊就诊。 只有在基线再入院率高的病区里,加入患者自评的方案才显示出减少再入院的迹象。换句话说,“测量出院准备度”这件事本身,在大多数情境下不改变结局;它只在特定条件下、以特定方式使用时才有用。
这个结果对中文护理研究的含义是:几十篇“出院准备度现状及影响因素”的横断面研究,所依据的那个假设已经在一项 33 家医院的随机试验里被大部分否定了。它们的信息增量不是低,是负的,因为它们继续强化一个已经被证据削弱的假设。
需要什么资料与设计。 READI 留下的问题才是真问题:为什么评估在高再入院病区有用,在其他病区没用?是因为护士在低风险病区本来就做得够好,还是因为评估结果没有触发任何行动?回答这个问题需要的不是再测一次准备度,而是实施研究:在几个病区引入“评估加行动方案”,记录评估结果被查看了多少次、触发了多少次行动、行动是什么、哪些患者因此改变了出院安排,再把这些过程指标和再入院连起来。这是一项典型的“评估、行动、结局”链条研究,资料来自护理信息系统的操作日志和随访记录,设计可以是阶梯楔形。
AI 能做什么,不能做什么。 AI 能写实施研究的方案框架,能从日志里抽取过程指标,能做统计。AI 不能知道在这家医院里“评估结果没有触发行动”的原因是护士没时间看、系统没弹窗、还是医生不认可护士的判断。这个原因决定了实施策略,而它只存在于那个病区的日常里。
案例三 症状网络:从横断面到动态系统
模板做法产生了什么。 症状网络分析是近三年中文护理期刊的热门方法,本文抽样的 123 篇里有 3 篇。做法是:一次问卷测十几个症状,算相关矩阵,用正则化方法画成网络,报告“强度中心性最高的症状”和“桥梁症状”,结论是“应优先干预核心症状”。
它回答不了什么。 横断面网络刻画的是人与人之间的协变:症状 A 重的人症状 B 也重。而“优先干预核心症状会改善整个症状群”这个结论,说的是人之内的动态:在同一个人身上,先改善 A 会带动 B。人际协变和人内动态是两回事,前者不能推出后者。一个在横断面网络里“中心”的症状,可能只是因为它和其他症状有共同的原因,而不是因为它驱动其他症状。用横断面网络指导干预,和用横断面回归写干预建议,是同一个逻辑错误的两种画法。
真正的科学问题是什么。 症状之间是否存在时间上的先后和驱动关系,以及干预一个症状能否改变其他症状。这个问题的实际后果是:如果乏力真的驱动抑郁和活动减少,那么针对乏力的护理干预就有可能以一敌多;如果只是共变,针对乏力就只解决乏力。
需要什么资料与设计。 两步。第一步是密集追踪:对同一批患者每天甚至每天几次记录症状,用生态瞬时评估或可穿戴设备,得到人内的时间序列,再用时滞网络或多层模型估计“今天的 A 是否预测明天的 B”。第二步是干预检验:针对时滞网络里识别出的驱动症状做一项小型随机试验,看其他症状是否跟着变。第一步的门槛是随访的人力和患者的依从,第二步的门槛是干预的设计与实施。两步都需要真实患者在真实时间里的重复报告,这些资料没有捷径。
AI 能做什么,不能做什么。 AI 能写时滞网络的代码,能帮助设计瞬时评估的题目和推送时间,能处理缺失。AI 不能让患者每天填三次报告,不能判断哪些缺失是“忘了”、哪些是“太难受了填不了”,后者恰恰是最重要的信息。
三个案例的共同结构
把三个案例并排看,它们有同一个结构:模板做法测量的是状态,真正的问题关心的是改变;模板做法把护理做了什么当成背景,真正的问题把护理做了什么当成暴露;模板做法的资料在一次问卷里,真正的问题的资料在时间里、在记录里、在流程里。也正因为如此,模板做法可以被 AI 廉价复制,而真正的问题不能。
还可以看到一件事:三个真正的问题都不需要更高级的统计,需要的是不同的资料。TURN 是最简单的随机试验,READI 是整群随机加差分回归,时滞网络也不比横断面网络复杂多少。难的从来不是分析,是让正确的资料存在。
六、往实践走:八类设计
从三个案例可以归纳出实践型研究的共同点:资料必须在真实照护场景里产生,问题必须关心改变而不只是状态。这个共同点对应八类具体的设计。
表2 八类实践型研究
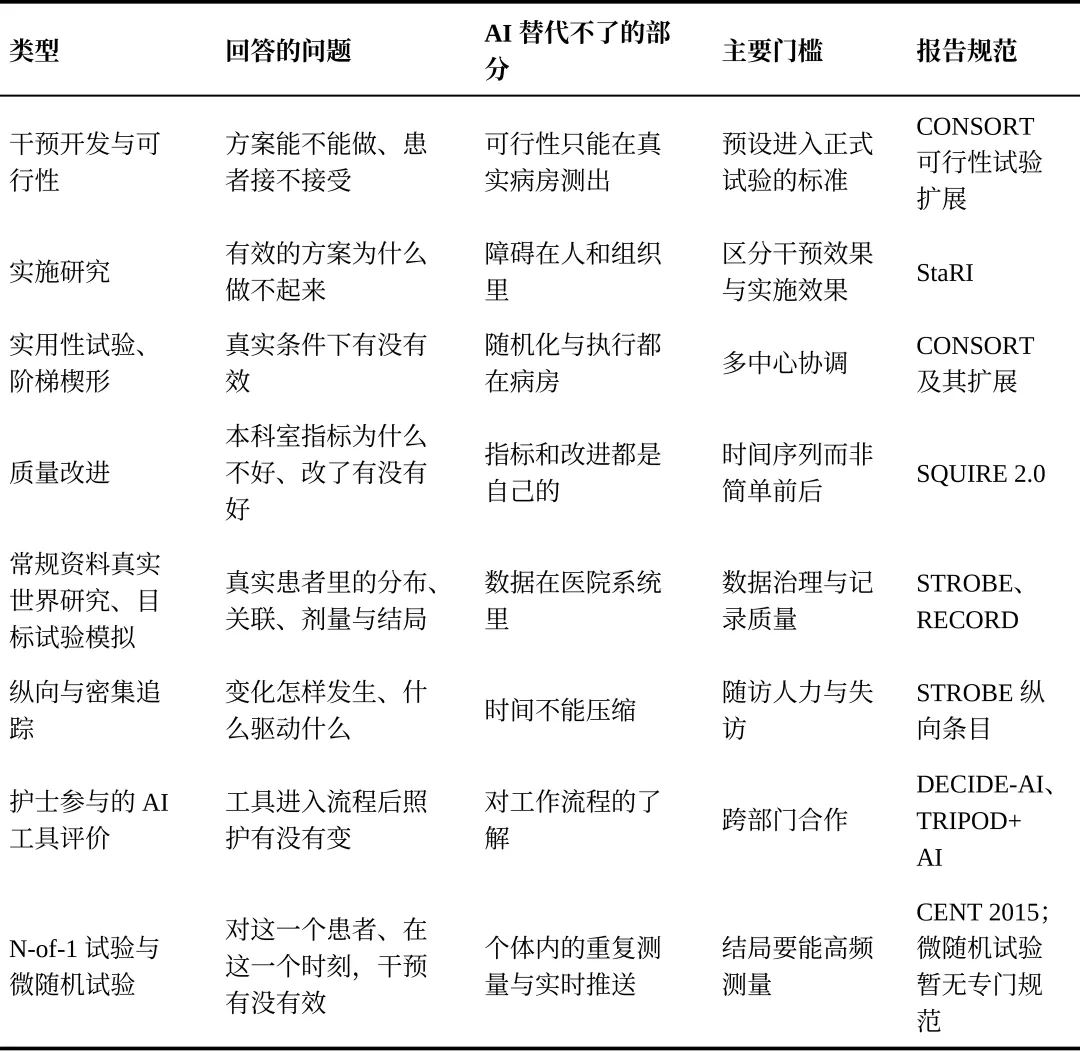
八类里有三类值得多说一句。第一是“德尔菲构建方案+非同期对照”的正规化改造。 这条流水线不必废弃,它可以拆成两步做对:第一步是干预开发与可行性研究,老实承认自己在探索,报告招募率、依从性、可接受性,预设“进入正式试验”的标准;第二步是实用性试验或阶梯楔形试验。拆开之后,第一步的信息增量是“这个方案能不能做”,第二步是“有没有效”,两步都有价值。合在一起硬说“科学可行有效”,两步的价值都没了。
第二是护士参与的 AI 工具评价。 这是一类新的研究,也是护理在 AI 时代最独特的位置。Berkhout 等 2025 年系统综述了 1263 项 ICU 人工智能应用研究,74% 处于技术成熟度 4 级及以下,进入临床整合的 25 项占 2%,完全实施的 0 项,53% 高偏倚风险,46% 用的是同一个公开数据库。Tricco 等 2023 年从 17386 条引文里寻找“已经在医院里用起来”的机器学习工具,只找到 20 项研究。模型堆积如山,能进病房的寥寥无几。护理研究者的位置不是再开发一个模型,是研究模型怎样进入照护、护士怎么用、用了之后结局有没有变。这类研究要按 DECIDE-AI 和 TRIPOD+AI 报告。
第三是 N-of-1 试验与微随机试验。 它们是第五部分第三个案例的自然延续。时滞网络识别出一个可能驱动其他症状的症状之后,验证干预效果的下一步不必马上做大样本随机试验。N-of-1 试验在同一个患者身上把干预期和对照期交替多次,随机决定顺序,用患者自己做自己的对照,回答“对这一个患者,这个干预有没有效”;一组 N-of-1 试验合起来可以估计群体效应。它适合结局能高频测量、干预效应起得快也消得快的情境,症状管理里的很多干预正是这样。微随机试验更进一步:在每一个可以推送干预的时刻,比如每天几次,随机决定推还是不推,估计干预在不同时刻、不同情境下的即时效应。它是移动健康干预的标准评价设计,Klasnja 等 2015 年提出后已经用于身体活动、服药提醒、情绪管理等领域,护理领域几乎还没有人用。这两种设计和本文的论点关系很直接:它们的资料是同一个患者在真实时间里的重复报告,AI 一行也生成不了;而它们对样本量的要求很低,一个病区、几十名患者就能做,正好是没有多中心资源的临床护士能走的路。N-of-1 试验按 CENT 2015 报告。
七、三个反驳
本文的推论链是:模板化研究信息增量低,AI 使其生产成本归零,守门人转向不可生成的成本信号,所以研究要转向 D 区。这条链的每一环都有人反驳,反驳得有道理。
第一,描述性研究不会整体贬值。 患病率、需求评估、护士人力现状,这些描述性证据是政策和干预设计的前提,没有人能用 AI 生成一个地区的真实患病率。Suchak 等在被批评的 28 篇论文里也承认 13 个关联经校正后仍然显著;Science 的报道里也有研究者担心一刀切的拒稿规则会伤害真正的公共卫生研究。所以准确的说法是:贬值的是“没有新数据、没有新问题”的重复描述,也就是图中的 A 区;一项在没人调查过的人群里做的横断面研究属于 B 区,仍然有价值。
第二,AI 释放的时间可能反而让更多人去做 D 区的研究。 护理研究的瓶颈也许从来不在写论文,而在数据获取、临床时间和统计支持。如果 AI 把写作和编程的时间省下来,临床护士可能第一次有余力做一项需要随访的研究。Amano 等 2023 年记录了非英语母语研究者在科研中承担的多重成本,对中文护理研究者来说,AI 首先解决的很可能是语言和技术门槛。这个反驳和本文并不矛盾,它们指向同一个方向:AI 让 A 区贬值,同时让 D 区变得可及。现有证据分不清这两种效应哪个更大。
第三,实践型研究本身可能落入 C 区。 这是最需要警惕的一条。Hu 等 2021 年随机抽取 100 篇新生儿科质量改进研究,按 31 条修订版 SQUIRE 2.0 评价,平均只满足 22.0 条;Carpenter 等 2025 年评估实施科学期刊的 47 份文献,StaRI 里经济评价、危害和情境变化的报告率只有 13% 到 30%。一项只有前后各一组、没有过程指标、没有保真度的“质量改进研究”,和一项模板化横断面研究一样,也可以被廉价复制。分界线不在设计类型,在信息增量。
八、对研究生和青年研究者意味着什么
不再是“再学一种统计”。 潜在剖面、结构方程、网络分析,这些五年前还能让论文显得高级的方法,现在 AI 几分钟就能写出代码和解释;而且第二部分已经说明,它们不改变信息增量。它们仍然要学,但学它们不再构成任何优势。
该学的是三样本事。 第一,把临床现象变成研究问题:不是找“还没人测过的量表”,而是找“还没人解释的现象”,然后问“改变什么会改变它”。第二,获取和管理真实资料:怎样向信息科申请数据,怎样通过伦理审批,怎样设计随访,怎样保存原始资料以备核查。第三,把研究嵌进临床流程:怎样让护理部同意,怎样让同事配合,怎样在不增加负担的前提下收集数据。三样没有一样能在课堂上学会,也没有一样能被 AI 替代。
表3 生成式 AI 在护理研究各环节的使用边界
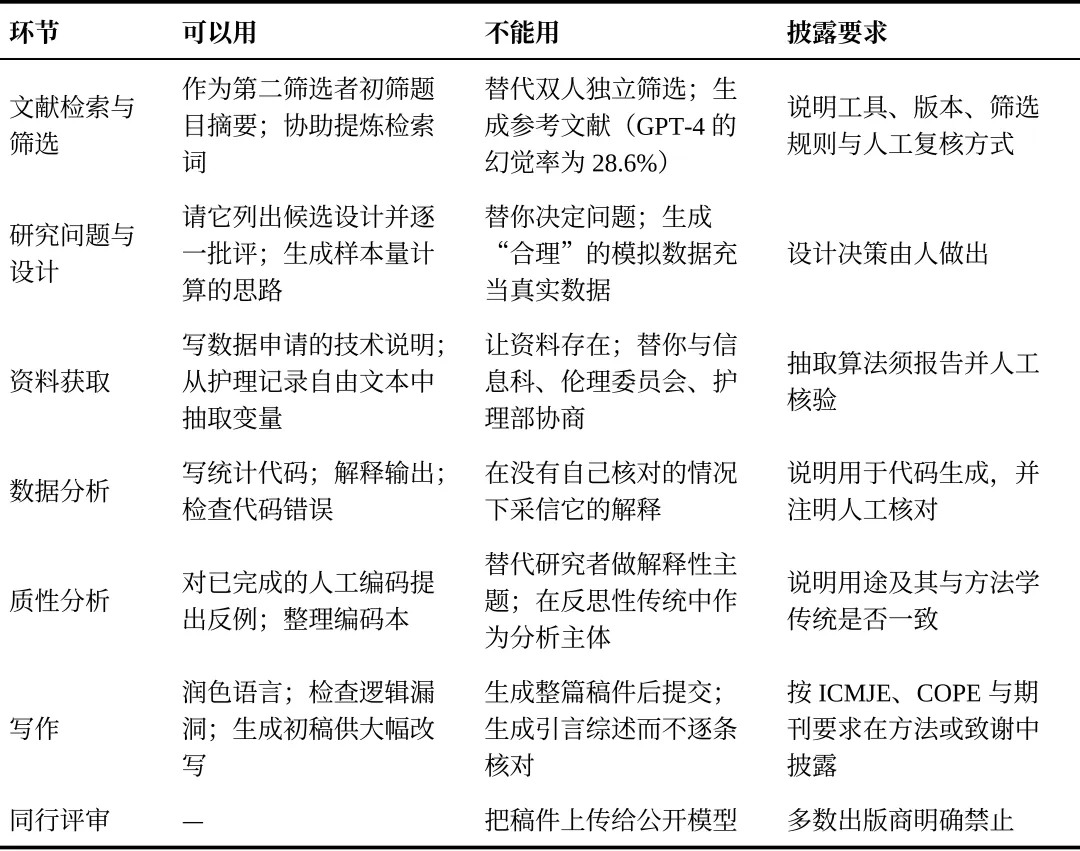
注:依据 ICMJE 2023 年后的建议、COPE 立场声明、WAME 2023 年建议以及本文引用的实证研究整理;各期刊的具体要求以其最新作者指南为准。
一条特别的提醒:永远不要让 AI 替你生成“合理”的数据。 它做得到,做出来的数据在统计上往往比真实数据更好看。这是一条不可逆的路,一旦走上去,后面所有的研究都建立在需要隐藏的东西上。
九、结语:护理是关于"改变"的学科
回到开头那个判断:“护理本质上是文科。”数据支持一半:护理研究的证据形态确实接近社会科学。但数据否定了另一半:这种形态是研究文化造成的,不是学科决定的。
更准确的说法是:护理是一门关于“改变”的实践学科,它的研究目的不是解释世界,是改变照护。三个案例里真正的问题全都关于改变:改变翻身频率会不会改变损伤,评估会不会改变行动和结局,改变一个症状会不会改变一群症状。而过去二十年护理研究的主流产出全都关于状态:现状、水平、影响因素、潜在类别。一门关于改变的学科,用了二十年测量状态,这才是问题的根源,AI 只是让它显形。
这对个体研究者是坏消息,也是好消息。坏消息是最容易走的路正在关闭。好消息是关闭的那条路,本来就不通向任何地方;而通向答案的那条路,护士站在它的起点上。
参考文献
[1] Park JH, Kim HK, Kim G, Bae SH. Ten-year trends in research designs and keywords: a bibliometric comparison of the Journal of Korean Academy of Nursing and leading international nursing journals. Journal of Korean Academy of Nursing. 2025;55(4):557-567. doi:10.4040/jkan.25119
[2] Methodological and thematic trends in the Korean Journal of Adult Nursing (2015–2024). Korean Journal of Adult Nursing. 2026. https://kjan.or.kr/journal/view.php?number=1786
[3] 李峥, 等. 中国护理学博士研究生学位论文分析. 中华护理教育. 2019;16(6):405-412. doi:10.3761/j.issn.1672-9234.2019.06.001
[4] Gao CA, Howard FM, Markov NS, Dyer EC, Ramesh S, Luo Y, Pearson AT. Comparing scientific abstracts generated by ChatGPT to real abstracts with detectors and blinded human reviewers. npj Digital Medicine. 2023;6:75. doi:10.1038/s41746-023-00819-6
[5] Chelli M, Descamps J, Lavoué V, et al. Hallucination rates and reference accuracy of ChatGPT and Bard for systematic reviews: comparative analysis. Journal of Medical Internet Research. 2024;26:e53164. doi:10.2196/53164
[6] Hanson MA, Gómez Barreiro P, Crosetto P, Brockington D. The strain on scientific publishing. Quantitative Science Studies. 2024;5(4):823-843. doi:10.1162/qss_a_00327
[7] Suchak T, Aliu AE, Harrison C, Zwiggelaar R, Geifman N, Spick M. Explosion of formulaic research articles, including inappropriate study designs and false discoveries, based on the NHANES US national health database. PLOS Biology. 2025;23(5):e3003152. doi:10.1371/journal.pbio.3003152
[8] Byrne JA, Stender S. More science friction for less science fiction. PLOS Biology. 2025;23(5):e3003167. doi:10.1371/journal.pbio.3003167
[9] O’Grady C. Journals and publishers crack down on research from open health data sets. Science. 2025-10-08. https://www.science.org/content/article/journals-and-publishers-crack-down-research-open-health-data-sets
[10] Jeong GH, Ko EJ. Presence and content of policies on the use of generative artificial intelligence in nursing journals indexed in PubMed: a descriptive study. Science Editing. 2026;13(2):103-108. doi:10.6087/kcse.401
[11] Pei J, et al. Machine learning-based prediction models for pressure injury: a systematic review and meta-analysis. International Wound Journal. 2023. doi:10.1111/iwj.14280
[12] Bergstrom N, Horn SD, Rapp MP, Stern A, Barrett R, Watkiss M. Turning for Ulcer ReductioN: a multisite randomized clinical trial in nursing homes. Journal of the American Geriatrics Society. 2013;61(10):1705-1713. doi:10.1111/jgs.12440
[13] Weiss ME, Yakusheva O, Bobay KL, Costa L, Hughes RG, Nuccio S, Hamilton M, Bahr S, Siclovan D, Bang J; READI Site Investigators. Effect of implementing discharge readiness assessment in adult medical-surgical units on 30-day return to hospital: the READI randomized clinical trial. JAMA Network Open. 2019;2(1):e187387. doi:10.1001/jamanetworkopen.2018.7387
[14] Berkhout WEM, van Wijngaarden JJ, Workum JD, et al. Operationalization of artificial intelligence applications in the intensive care unit: a systematic review. JAMA Network Open. 2025;8(7):e2522866. doi:10.1001/jamanetworkopen.2025.22866
[15] Tricco AC, Hezam A, Parker A, et al. Implemented machine learning tools to inform decision-making for patient care in hospital settings: a scoping review. BMJ Open. 2023;13(2):e065845. doi:10.1136/bmjopen-2022-065845
[16] Mitha S, Schwartz J, Hobensack M, Cato K, Woo K, Smaldone A, Topaz M. Natural language processing of nursing notes: an integrative review. CIN: Computers, Informatics, Nursing. 2023;41(6):377-384. doi:10.1097/CIN.0000000000000967
[17] Scharp D, Hobensack M, Davoudi A, Topaz M. Natural language processing applied to clinical documentation in post-acute care settings: a scoping review. Journal of the American Medical Directors Association. 2024;25(1):69-83. doi:10.1016/j.jamda.2023.09.006
[18] Hu ZJ, Fusch G, Hu C, et al. Completeness of reporting of quality improvement studies in neonatology is inadequate: a systematic literature survey. BMJ Open Quality. 2021;10(2):e001273. doi:10.1136/bmjoq-2020-001273
[19] Carpenter C, et al. EQUATOR network implementation science reporting and adherence challenges for learning health systems. Journal of Clinical and Translational Science. 2025;9:170 (会议摘要). doi:10.1017/cts.2024.1147
[20] Vohra S, Shamseer L, Sampson M, et al.; CENT group. CONSORT extension for reporting N-of-1 trials (CENT) 2015 statement. BMJ. 2015;350:h1738. doi:10.1136/bmj.h1738
[21] Klasnja P, Hekler EB, Shiffman S, Boruvka A, Almirall D, Tewari A, Murphy SA. Microrandomized trials: an experimental design for developing just-in-time adaptive interventions. Health Psychology. 2015;34(Suppl):1220-1228. doi:10.1037/hea0000305
[22] Amano T, Ramírez-Castañeda V, Berdejo-Espinola V, et al. The manifold costs of being a non-native English speaker in science. PLOS Biology. 2023;21(7):e3002184. doi:10.1371/journal.pbio.3002184
说明:第一部分的期刊设计构成为本文作者按公开摘要自行分类统计,样本、方法与局限已在正文说明,逐篇分类记录附于资料包,可供核对。第二部分与第三部分的“信息增量”与“信号失效”是本文提出的分析框架,不是既有术语。第三部分关于护理横断面研究将被同一标准筛选的判断是推论,目前没有护理期刊发布相关政策。第 3.3 节的对照使用一个通用深度研究工具于 2026 年 9 月 26 日生成,核对结果以本文引用的一手文献为准,不针对任何具体产品;三个案例中引用的 TURN 与 READI 试验结果以原文为准;对中文模板研究的描述基于本文抽样,不针对任何具体文章。