ARTICLE · 1084062
1.2B 小模型登顶文档解析榜,MinerU、PaddleOCR 全被反超,赢家是中国电信
↑阅读之前记得关注+星标⭐️,😄,每天才能第一时间接收到更新
大家好,我是杰克王,AI 算法 6 年老兵。
想象一个场景:一张被揉皱又摊开的纸,上面印着跨行跨列的表格和数学公式。你拿手机随手一拍,上传,几秒钟后,屏幕上出现还原得整整齐齐的结构化表格,行列不乱,公式符号级准确。
干这个活的模型,只有 1.2B 参数。而它的主人不是任何一家 AI 独角兽,是中国电信。
9 月 24 日,中国电信旗下星辰通用人工智能实验室开源了文档解析模型 TeleOCR。成绩单拿出来有点狠:OmniDocBench v1.6 总分 96.87 登顶,Wild-OmniDocBench 和 PureDocBench 同步第一,外加 ICDAR-2026 科学图解析挑战赛冠军。MinerU、PaddleOCR、GLM-OCR、DeepSeek-OCR2,这些赛道里的熟面孔全部排在它后面。
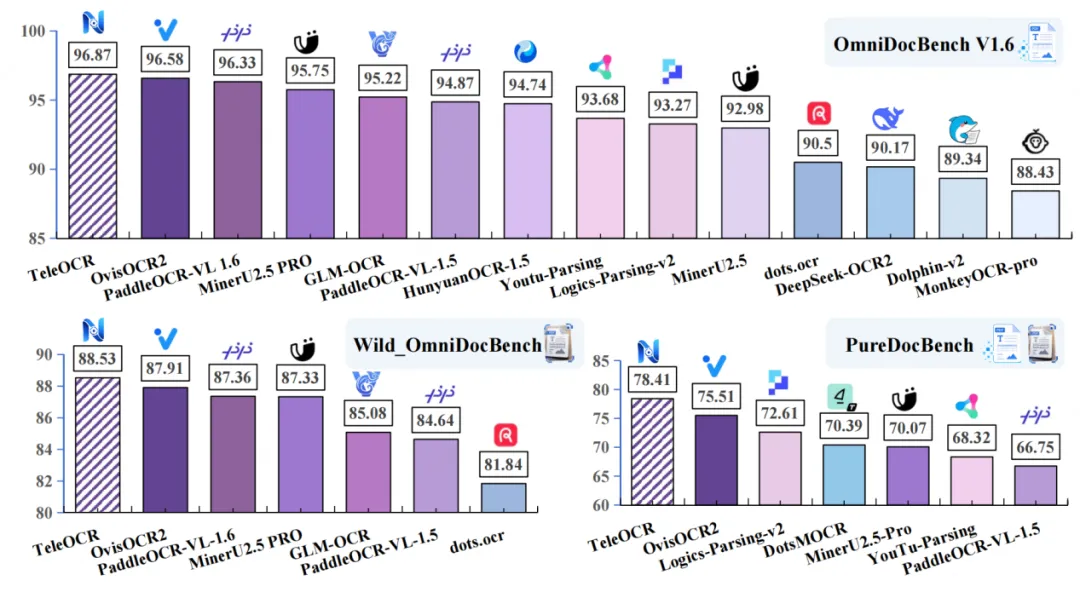
这条赛道有多挤,这个第一就有多反常
先交代背景。文档解析是 AI 落地里最脏最累的活之一。传统 OCR 只干一件事:把图片转成文字。但企业要的不是文字,是结构——这张表的跨行跨列怎么还原,这段公式的符号层级是什么,这张图表背后的数据是多少。合同、档案、论文、报销单,全是这种硬骨头。
相机拍的文档更难:纸张弯曲、透视畸变、阴影模糊,传统流程要先校正、再检测版面、再识别,每个环节错一点,误差层层累积,最后结果没法看。
这条赛道上聚满了狠角色:上海 AI Lab 的 MinerU、百度的 PaddleOCR、小红书的 dots.ocr。然后,第一名被一家运营商拿走了。
为什么是中国电信
做这件事的是 TeleAI,中国电信人工智能研究院,2024 年由李学龙牵头组建。李学龙现在是电信集团 CTO、首席科学家,拿过何梁何利科学与技术创新奖。TeleAI 给自己定的使命很值得玩味:基于国产芯片,训练国际一流模型。
运营商做文档解析,看似不务正业,其实顺理成章。电信手里最不缺的就是文档:营业厅单据、政企合同、档案系统,每天海量真实纸张在流转。有场景、有数据、有国产算力的任务指标,这三样凑齐,垂直模型做出彩是迟早的事。
第一个反直觉:赢靠的不是架构,是数据闭环
1.2B 打赢更大的对手,秘诀不在模型结构,在数据。TeleOCR 搞了一套数据流水线,核心是让模型自己给自己打工。
多节点共识投票:几个不同模型对同一份文档各自预测,投票选出高置信度的答案当训练标签,相当于三个老师傅背靠背改同一份卷子,谁偏颇谁出局。
图像到图像自验证:模型把解析结果重新渲染成图片,和原图比对,自己挑自己的错。
渐进式清洗:一致性高的进训练集,分歧大的当难题留级,循环往复。
最终形成千万级文档解析训练数据池,其中大部分生成数据不依赖人工标注。标注贵、标注慢、标注会错,这个行业最贵的成本项,被这套闭环绕开了。
第二个反直觉:揉皱的纸,不用先抚平
传统方案处理弯曲文档,必须先用一个独立模型把图像"压平",再送去识别。TeleOCR 的做法是把几何感知直接学进模型里:通过曲率引导的采样机制,模型显式学习文档的边界和空间结构。
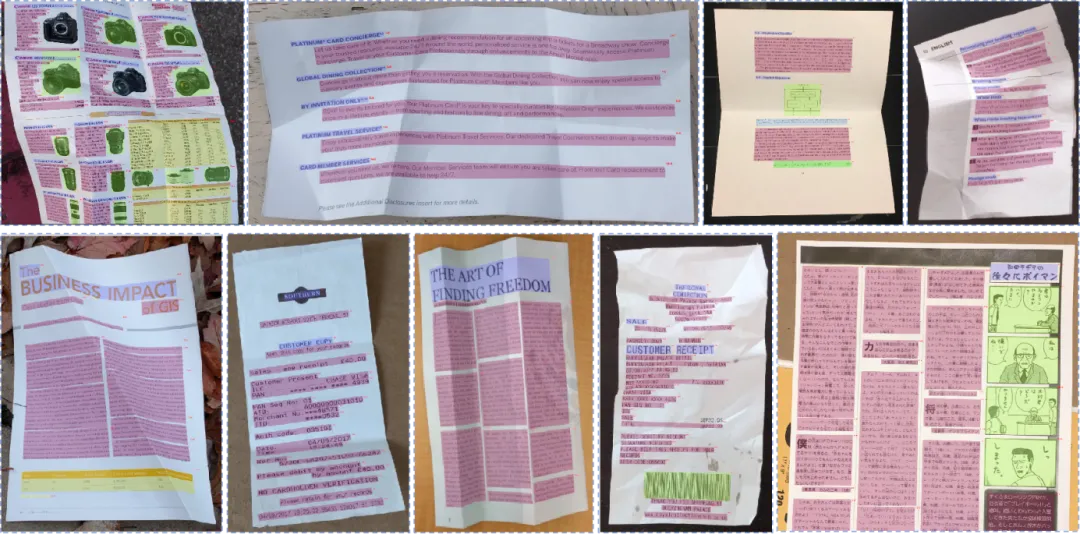
看这张实测图:揉皱的收据、弯折的论文、透视变形的海报,模型直接标出每个内容块的位置。以前是先把纸压平再读,现在是模型在脑子里自己抚平。省掉一个前置模型,误差累积的源头也就没了。
第三个反直觉:表格和文字,分开学再合上
TeleOCR 用了一种"内容-结构解耦"的训练法。以表格为例:一类数据把文字全部遮住,只留表格的拓扑骨架,强迫模型先学会行列关系和跨行跨列;另一类数据保留完整内容,再教模型把结构和语义对上。
先学五线谱,再学唱歌词。公式同理,语义和语法分开建模,最后联合对齐。整个训练分四个阶段,从基础感知一路走到强化学习。
这套方法论的巅峰之作,是科学图解析:直接读论文里的柱状图,把数据还原成结构化表格。这也是它拿下 ICDAR-2026 冠军的能力。
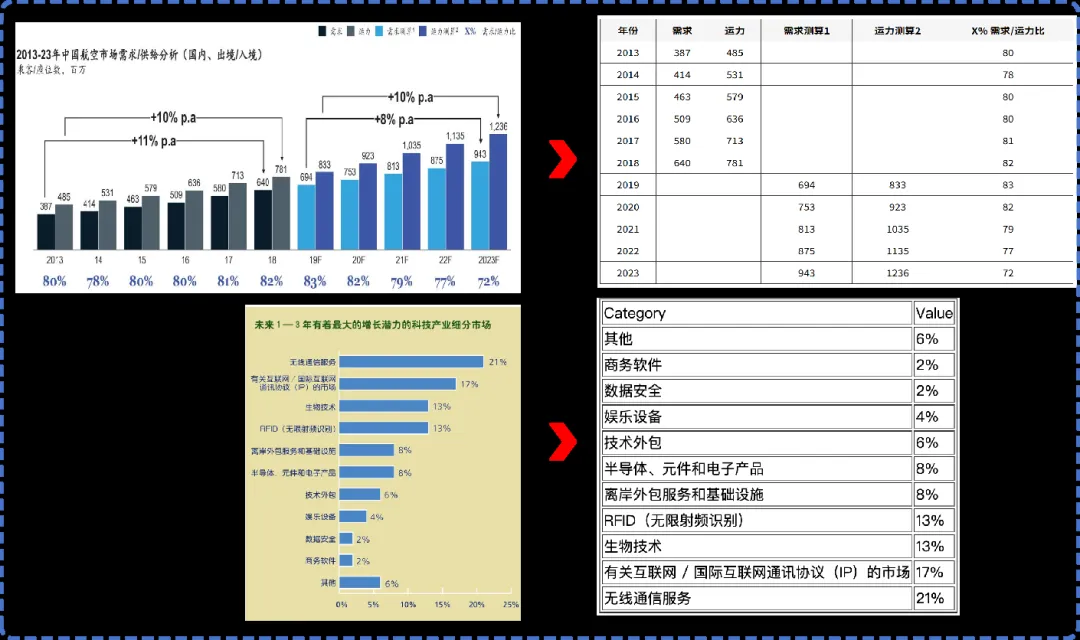
左边是论文里的柱状图,右边是模型输出的数据表。做文献调研的人应该懂这个功能值多少时间:以前要拿尺子对着屏幕量的数据,现在一键变成能计算的表格。
泼三盆冷水
第一盆:榜首优势很薄。OmniDocBench 上 TeleOCR 96.87 分,第二名 OvisOCR2 96.58 分,差距只有 0.29 分,说"屠榜"是夸张,说"登顶"刚刚好。
第二盆:榜单成绩是官方自报口径。我发稿时查了,GitHub 227 个 star,模型下载量 145,第三方复测还没影。不过 ICDAR 冠军是第三方赛事打出来的,不全是自说自话。
第三盆:它不是手机 App。本地部署要 CUDA GPU 环境,走 vllm 推理,普通用户得有点动手能力,或者等官方在线体验版放量。
我的三个判断
第一,文档解析今年会完成端到端洗牌。"校正、检测、识别"三段式串联 pipeline 会被统一框架吃掉,TeleOCR 的几何感知路线就是方向。还在维护多模型串联方案的团队,该评估迁移成本了。
第二,运营商会成为垂直模型赛道的隐形冠军。有真实场景、有私有数据、有国产算力任务,这套组合在文档、客服、网络运维这些"脏活"领域会持续产出榜首模型。我预测一年之内,另外两家运营商也会开源自己的行业模型,欢迎对账。
第三,做知识库和 RAG 的团队,解析层该换供应商了。1.2B 意味着一张消费级显卡就能跑,三榜第一加 ICDAR 冠军,这个解析层目前是开源里最划算的选项。
大模型的聚光灯总是打在通用对话上,但真正帮企业省钱的,往往是文档解析这种没人围观的脏活。
AI 落地的深水区,不在发布会上的跑分,在营业厅的单据、合同的表格和论文的图表里。谁能把这些纸张变成数据,谁才算真正踩进了产业的门槛。
觉得有收获,点个在看支持一下 👇
感谢阅读。我是杰克王,欢迎加微交流 🚀