ARTICLE · 1094705
AI 审代码总报错行号?阿里把内部用了两年的工具开源了
“
审查意见落在第几行,比审出多少条更重要。
📌 本文看点
01
AI 审代码,卡在三个老毛病
02
五分钟接入
03
三种审法,从一次提交到整个仓库
观澜科技社,只写你今晚就能上手的干货。点个关注,每天少踩一个坑。
让 AI 帮忙看代码,很多人试过:把改动丢给编程助手,等它吐出一堆意见。用多了会发现三个反复出现的老毛病。改动一大,它偷偷“挑着审”,一半文件根本没看;报的问题对不上位置,说的文件和行号经常漂到不相干的地方;提示词改几个字,审查质量就忽高忽低,今天报空指针,明天同一个问题就看不见了。
根子在于:纯靠语言模型自由发挥,整个审查过程没有硬约束。
这事阿里也踩过,他们的解法是把内部用了两年的代码审查助手开源了,项目叫 OpenCodeReview。官方给出的数据:集团内部两万多名活跃用户,累计执行三百多万次真实审查任务,安装包近 30 天下载 38 万次。GitHub 仓库建于今年 5 月,现在星标 4 万,协议 Apache-2.0,最近一次提交就落在 9 月 24 日。
BENCHMARK
五分钟接入:装上就能审
上手只要三步。前提是本机 Git 版本不低于 2.41,然后一行命令安装:
npm install -g @alibaba-group/open-code-review
装完全局多出一个 ocr 命令。第二步配模型,交互式界面会引导你选服务商、填密钥,最后自动测一遍连通性:
ocr config provider
ocr config model
它内置了 12 家模型接入,国产几乎全覆盖:阿里 DashScope、DeepSeek、Kimi、百度千帆、腾讯混元、火山方舟、小米 MiMo 都在列,OpenAI 和 Anthropic 也支持。手上有什么模型就用什么,不用绑死一家。
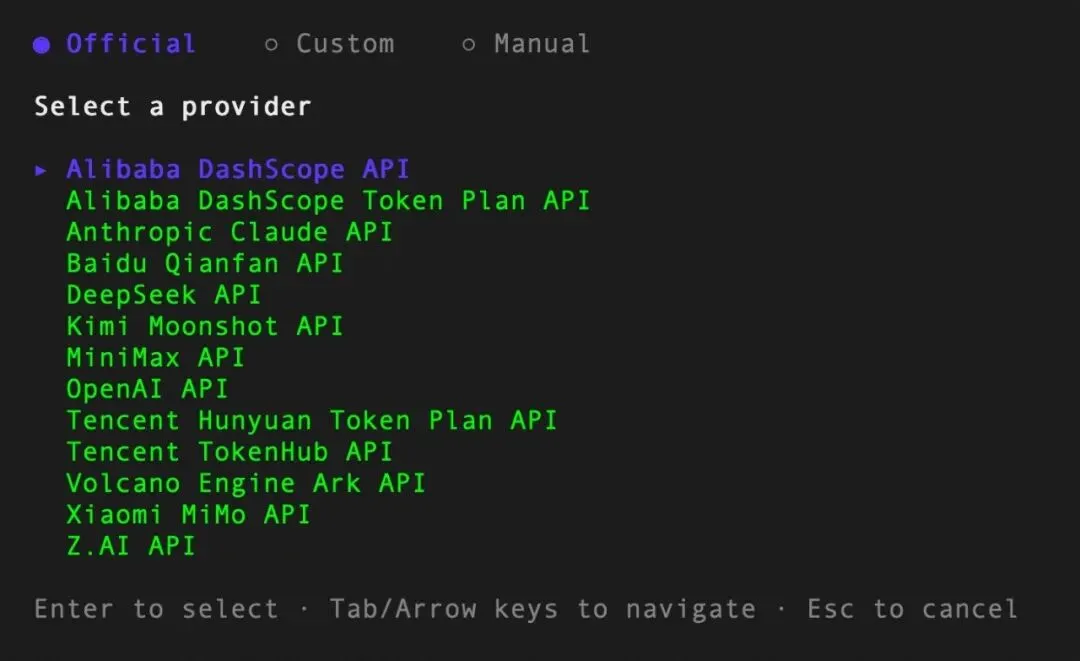
配模型:内置 12 家服务商,国产模型基本全覆盖
第三步,进项目目录跑第一次审查:
cd your-project
ocr review
METHOD
三种审法,从一次提交到整个仓库
默认的 ocr review 审的是工作区:已暂存、未暂存、新增的改动一把抓。如果你在功能分支上开发,更推荐圈定范围,只审这个分支从主干分出去之后的全部改动;也可以锁定单个提交回看:
ocr review --from main --to feature-branch
ocr review --commit abc123
还有两个实用细节。大仓库审到一半中断了,用 ocr session list 找到会话编号,加 --resume 参数接着跑,不用从头再来。接手陌生老项目时,用 ocr scan 做全文件扫描,它不依赖 git 历史,还能用 --path 指定只扫某个目录。
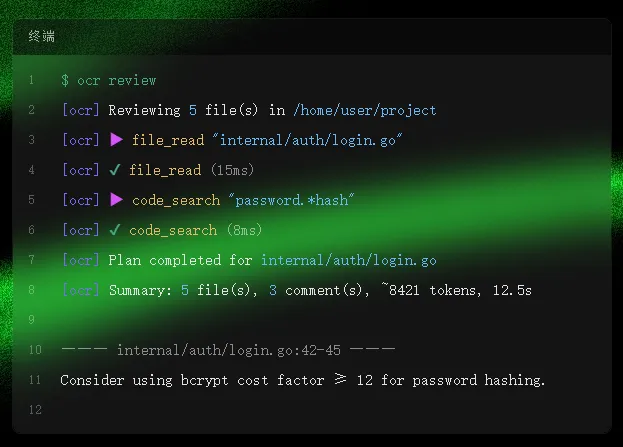
真实输出:5 个文件 3 条意见,精确指出 login.go 第 42-45 行的口令哈希问题
上面这张是官方演示的真实输出:5 个文件审出 3 条意见,耗时 12.5 秒、花掉 8421 个 token。其中一条直接落在 internal/auth/login.go 的第 42 到 45 行,建议把口令哈希的 bcrypt 成本因子提到 12 以上。意见挂在具体行上,点开就能改。
EFFICIENCY
为什么它只花九分之一的 token
token 是大模型按量计费的用量单位,审查的成本大头就在这。项目 GitHub 仓库 的说明里给了一组基准:50 个热门开源项目、200 个真实合并请求、10 种语言,80 多名工程师标注出 1505 个真实缺陷当作标准答案。同样的底层模型,OpenCodeReview 的精确率和 F1 值都比通用编程助手高,token 花销只有约九分之一,速度也更快。
省 token 的关键在架构。它把审查拆成两层:“不能出错”的环节交给确定性工程,挑哪些文件、相关文件怎么打包、规则怎么匹配,全由代码保证;“需要灵活”的判断才交给模型。改动文件还会自动分组,比如同一功能的中英文文案文件捆成一批,各批次带独立上下文并行审,改动再大也挑不了懒。
代价也说清楚:它的召回率比通用助手低。换句话说,它故意少报,换来报出来的基本是真问题;想要“宁可错杀不可放过”的全面扫描,它不是那个定位。整套基准数据集 AACR-Bench 挂在 Hugging Face 上,结论可以自己复核。
WEAKNESS
动手前的三个提醒
第一,不配模型它审不动。普通模式必须配一家服务商。不过如果你已经在用 Claude Code 这类编程助手,可以走委托模式:跑 ocr delegate preview,文件挑选和规则匹配由 ocr 负责,模型调用走你编程助手自带的,一行 API 密钥都不用填。
第二,省钱不等于免费。九分之一也是成本,大仓库建议先拿 ocr scan --path 挑个小目录试水,看看意见质量再放大范围。
第三,把它当第二双眼睛,别当门禁。审完在会话查看器里逐条标记“已修”或“忽略”,避免同一条意见反复出现;要接进流水线,官方文档 里给了 GitHub Actions 和 GitLab CI 的现成接法,代码合并前多一道机器初筛,人只看机器拿不准的部分。
说到底,AI 审代码拼的不是模型多强,而是流程管得多严。你的代码评审现在靠人还是靠 AI?评论区聊聊;觉得有用,转给那个天天被审查意见折磨的朋友。
参考链接
GitHub 仓库 — https://github.com/alibaba/open-code-review
AACR-Bench — https://huggingface.co/datasets/Alibaba-Aone/aacr-bench
官方文档 — https://open-codereview.ai/docs
我是 观澜科技社,一个盯了七年代码的老码农,专注把 AI 前沿和开源工具讲成人话。
如果今天这篇让你看清了点什么,欢迎 点赞、在看、转发三连。你最想看我从哪个角度接着写?评论区告诉我,下期安排上。