ARTICLE · 1095277
重新理解 AI 系列42:模型每一轮到底应该看见什么?
副标题:理解 Harness 中的上下文管理:从信息全集到当前工作集
引言
上一篇文章里,我们用一笔售后退款认识了 Harness。模型也许很快就能理解“帮我退掉这个订单”,但系统还要找到订单、读取规则、检查权限、保存状态,并验证退款是否完成。
这一次,我们把镜头再拉近一点,只看其中一个问题:任务每向前走一步,系统到底应该让模型看见什么?
比如用户过了一会儿又说:“继续处理刚才的订单。”
这句话对人很自然,对系统却不简单:“刚才”指哪个阶段?是哪一笔订单?前面确认了什么?规则有没有更新?下一步是继续判断,还是可以提交?
这里很容易出现一个直觉:既然资料都有,那就全部交给模型。可掌握信息,不等于模型这一轮就能正确使用信息。所有订单、政策和工具返回一起涌进来,反而可能把重点淹没。
所以,当 Harness 落实 Context Engineering 时,真正要解决的不是“怎样给模型更多”,而是:
怎样在正确的时刻,让模型看见完成当前一步所需的信息。
一、Context Engineering,为什么还要放进 Harness 里再讲一次?
在本系列第 5 篇《不要只会写 Prompt,要学会设计上下文》中,我们讨论过:上下文不只是聊天记录,还包括目标、规则、材料、工具结果和任务状态。
那为什么进入 Harness Engineering 以后,还要再讲一次上下文?
因为上下文工程不仅需要设计原则,还需要系统在运行中持续执行。
简单对话可以由人手动整理背景。但当 Agent 要多轮判断、调用工具、等待反馈,甚至隔一段时间继续任务时,系统就必须根据当前步骤选择材料、处理冲突、压缩历史,再重新组织输入。
Context Engineering 研究怎样为模型选择、组织和维护恰当的信息。Anthropic 对它的解释也强调了这种迭代性:与一次性写好 Prompt 不同,系统每次调用模型前,都要从不断变化的信息中决定这次传入什么。
Harness Engineering 则关心怎样把这些策略连同工具、状态、权限和验证机制,做成一个能够持续运行的系统。换句话说,上下文管理是 Harness 的职责之一;Harness 是 Context Engineering 的运行载体,而不是与它并列的新概念。
二、模型看到的不是信息全集,而是当前一轮的工作集
真实系统可能同时拥有规则、用户请求、历史对话、长期偏好、RAG 材料、工具结果和任务进度。
这些内容构成系统可以访问的“信息全集”,却不应每次都原封不动地进入模型。模型每次调用看到的,只是系统在那个时刻准备的一份输入快照。本文把它叫作当前一轮的“工作集”。
工作集要围绕当前问题组织:这一轮要解决什么?已经确认了哪些事实?还缺什么证据?哪些规则必须遵守?哪些信息虽然存在,此刻却没有必要出现?
完整材料仍留在外部系统中,需要时可以再读取。Harness 中的上下文管理追求的不是“知道得最多”,而是当前一步“看得恰当”。
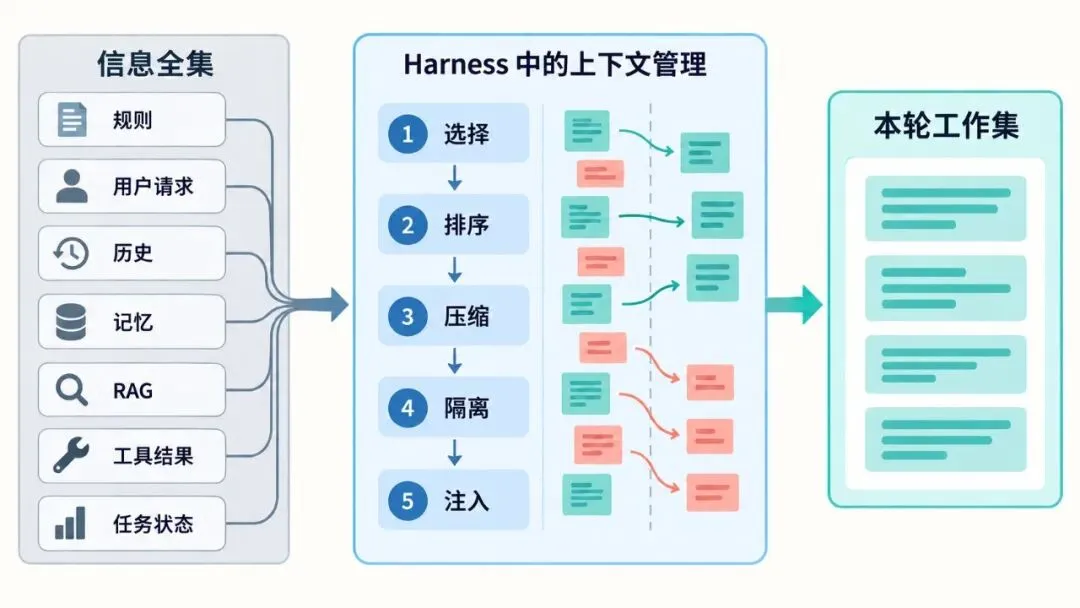
图注:规则、历史、记忆、RAG 与工具结果都可以成为候选来源,但只有与当前一步相关的内容,才会进入本轮工作集。
三、一笔退款,为什么每一步需要的上下文都不一样?
我们继续看那笔退款。
第一步:确认是哪一笔订单
用户说:“这个订单不合适,帮我退掉。”模型首先要弄清楚“这个订单”究竟指什么。
系统可以提供用户身份、会话中提到的商品和几笔候选订单。只有一笔符合描述,可以继续确认;有多笔相似订单,就应请用户选择。
这一轮不需要全部售后政策和一年前的购物记录。它们不能消除指代歧义,只会增加干扰。
第二步:判断能不能退
目标订单确认后,问题变了。模型不再需要其他候选订单,而需要这笔订单的支付时间、发货状态、商品类型和当前有效的售后规则。
如果历史里留着旧政策,系统又检索到新政策,就不能让模型猜哪一份算数。系统要标明来源和生效时间,必要时先处理冲突。
“用户选择了订单 A”应当保留,其他候选订单则可以退出工作集。任务在收敛,上下文也应随之收敛。
第三步:准备提交退款
确认订单符合条件后,模型需要看到核定金额、用户确认、执行权限、目标工具和前序核验状态。金额较高或状态异常时,还可能需要人工审批。
这一轮重要的是“执行所需的确定状态”,而不是全部推理过程。否则,模型可能重复提问,或把早期候选金额当成最终金额。
同一个任务,并不存在一份从头用到尾、永远不变的最佳上下文。
任务状态在变化,待解决的问题在变化,上下文也必须随之重组。
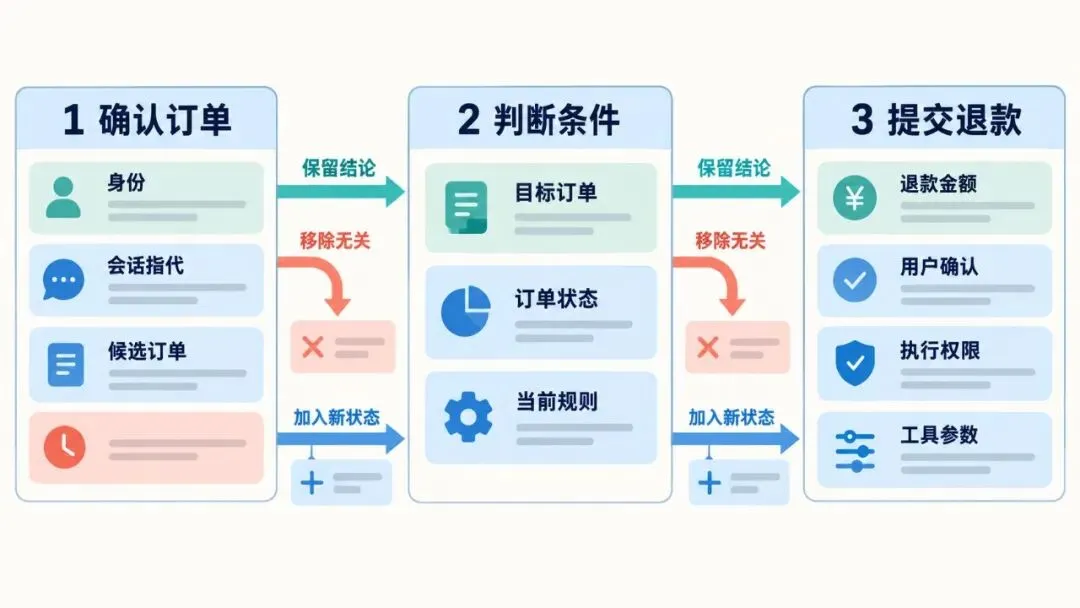
图注:同一个退款任务从确认订单、判断条件到提交退款,工作集会保留结论、移除无关信息,并加入新的任务状态。
四、Harness 如何动态组装上下文?
把刚才的过程拆开看,Harness 中的上下文管理至少在完成五类动作:选择、排序、压缩、隔离和注入。
不同团队的分类并不完全相同。例如 LangChain 把常见策略归纳为写入、选择、压缩和隔离;本文从运行时组装的角度,把“排序”和“注入”单独拿出来讲。这是一张认知地图,不是标准模块清单。
1. 选择:不是有用的信息,都适合现在进入
识别订单时,候选订单很重要;正式退款时,它们已经完成使命。判断政策时,当前制度重要,半年前另一件商品的咨询记录则大概率无关。
选择不仅看相关性,还要看来源、时效、访问权限,以及它是已确认事实,还是未经核实的推测。
没有进入本轮工作集,并不等于被删除。材料仍可留在外部,需要时再读取。
2. 排序:让模型分清信息的角色
系统规则、任务目标、用户输入、检索证据和工具返回,承担着不同角色。旧对话中的一句描述,不能自然推翻当前规则;检索回来的一段网页,也不能因为位置靠前就变成系统指令。
排序不只是调整位置,还要标明来源、用途和可信边界。来源冲突时,系统应依据权威性、适用范围、时效性和业务规则先做处理,而不是让模型凭语感裁决。
3. 压缩:保留继续工作所需的状态
任务轮次增加后,对话和工具结果会越来越长。全部保留,不仅增加成本,还会让模型反复关注已经解决的问题。
好的压缩不是把十轮对话随便缩成一段摘要,而是保留已确认事实、关键证据、未决问题,以及下一步需要的任务状态。
例如可以保留“用户已选择订单 A,订单尚未发货,按当前有效规则可全额退款,等待确认金额”,不必附上每次查询的完整输出。
压缩必须忠实。如果把“可能符合条件”压成“符合条件”,就把不确定性变成了事实。Anthropic 对 compaction 的实践也提醒,过度压缩可能丢掉当下不起眼、后续却很关键的信息。压缩从来不是无损操作,它仍然是一种取舍。
4. 隔离:不是所有信息都能进入同一个工作现场
隔离最直观的要求,是不能混入其他用户的订单和记忆。但边界还存在于不同任务、权限域和可信等级之间。
外部网页可以作为参考,却不应伪装成系统规则;子任务的中间猜测不能升级为事实;受限数据也不能因为“可能用得上”就进入上下文。
隔离不只保护隐私,也在保护模型的判断边界。OpenAI 的 Agent 安全指南同样提醒,不可信文本可能通过 Prompt Injection 试图覆盖原有指令,因此外部材料与高优先级指令之间需要清楚的边界。
5. 注入:信息正确,还要在正确时机进入
有些规则需要每轮存在,有些材料只在特定步骤加入;有些工具结果要保留关键字段,有些长文档只需提取相关片段。无论采用什么形式,都要尽量让模型分得清:哪些是规则,哪些是事实,哪些只是参考,哪些仍待验证。
模型完成这一轮后,系统会接收新的结果和状态,再据此组装下一轮工作集。这也是注入与一次性准备 Prompt 的根本差别。
五、真正危险的不是信息少,而是信息“看起来都能用”
上下文最麻烦的情况,往往不是明显缺少材料,而是同时出现了几份看起来都有道理的信息。
历史记忆写着“用户偏好原路退款”,本轮用户却要求退到余额;旧政策允许七天退款,新政策对某些品类已经调整;RAG 找回了相关说明,却来自失效页面;工具刚返回订单已发货,旧任务状态仍写着“待发货”。
如果这些内容不加区分地进入模型,它也许能生成一段很流畅的解释,却未必做出正确决定。
因此,Harness 还要在组装上下文时识别来源、标记时间、核对适用范围,让失效状态退出工作集。无法判断时,就应暴露不确定性,请求补充信息或交给人工,而不是让模型把矛盾“说圆”。
六、渐进式加载:不要让模型一开始背上全部材料
既然不该一次塞入所有内容,更自然的做法就是渐进式加载。
任务开始时,先提供当前步骤所需的最小充分信息;遇到新问题,再检索规则、读取文件或调用工具;得到结果后更新外部状态,再组装下一轮工作集。
Anthropic 把类似方式称为“just in time”上下文:先保留路径、查询或链接等线索,需要时再动态加载具体内容,而不是预先塞入全部数据。
这和刚才说的“注入”有什么区别?注入关心某份信息这一轮以什么形式进入;渐进式加载关心材料在整个任务过程中何时被取用。前者是单轮组装动作,后者是跨轮组织策略。
这里的“少”不是越少越好,而是避免无关信息过早进入。该用的材料仍要及时提供,关键证据也不能为了节省 Token 被省略。
渐进式加载还能缩小每一步的权限范围,让状态更新和过程追踪更清楚:模型当时看见了什么,为什么做出这个判断,都更容易被检查。
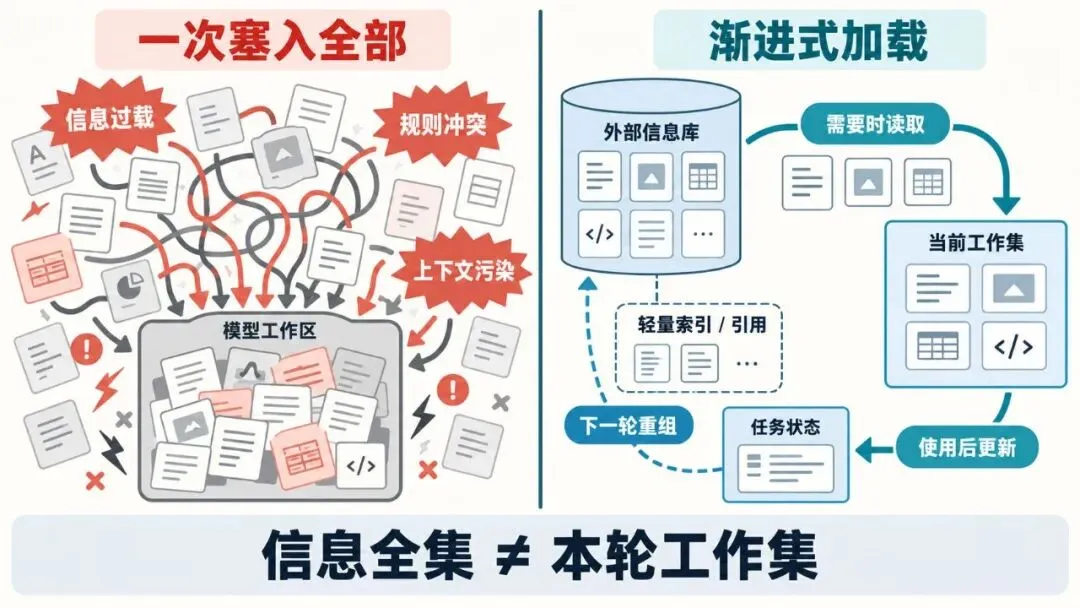
图注:信息全集可以保存在外部,系统在需要时读取相关材料,使用后更新任务状态,并为下一轮重新组装工作集。
结语:上下文不是资料仓库,而是动态搭建的工作现场
在本文中,我们从一笔退款的三个阶段,看到了上下文如何随着任务推进不断变化。
在 Harness 中,Context Engineering 不是把系统里的资料一次性交给模型,而是通过选择、排序、压缩、隔离和注入,持续组装当前工作集:让已确认的事实留下,让无关和过期的信息退出,让冲突得到处理,让新状态在合适的时候进入。
好的上下文不是越长、越丰富越好。它应该足够完成当前任务,同时保持相关、可信、及时,而且边界清楚。
模型并不是在记住整个世界,系统是在每一轮重新为它搭建需要看见的世界。
参考资料
• Anthropic, Effective context engineering for AI agents, 2025. • LangChain, Context Engineering, 2025. • Anthropic, Scaling Managed Agents: Decoupling the brain from the hands, 2026. • OpenAI, Introducing the Agents API, 2026. • OpenAI Developers, Safety in building agents, 2026.