ARTICLE · 1099353
阿里的AI产品们,都在把「上下文」作为突破口
当Agent能力逐渐趋同时,理解个人、企业与现实世界在成为新的产品分水岭。
作者 | 李威(北京)
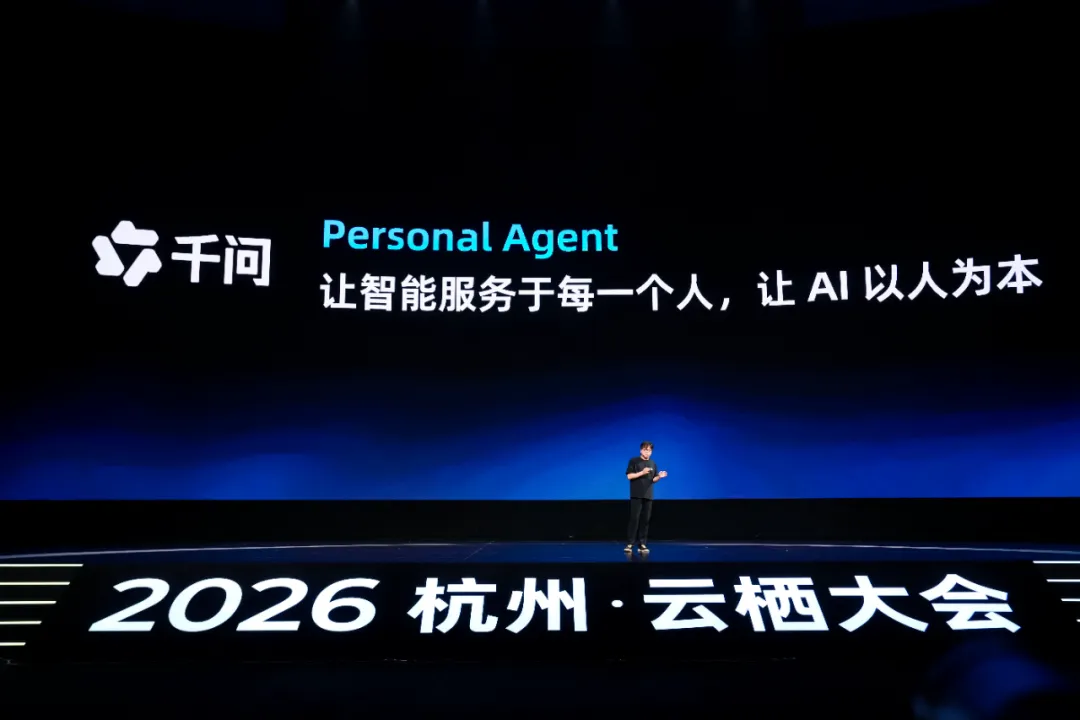
2026杭州云栖大会上,阿里巴巴集团CEO吴泳铭把AI正在开启的时代称为「机器智能」时代。
在他的判断中,顶级思考,将从奢侈品变成可规模化供给的商品。人只需要提出一个创意和目标,就能调动庞大的智力资源。这意味着,人类会拥有一系列可以随时调用的思考机器,负责驱动个人和组织的创意与目标加速落地。
如果说蒸汽机赋予了人类动力杠杆,机器智能赋予人类的则是智力杠杆。沿着这套逻辑,阿里的野心也不再只是继续为AI时代搭建商业基础设施,而是扩大到了成为未来社会智力杠杆的主要提供者,参与「思考」的生产、输送和使用。
这个目标的实现可以被拆分成两层。第一层更具确定性,是吴泳铭在演讲中重点介绍的AI模型、AI芯片和AI云「三大基石」,无论未来出现什么产品,只要机器思考规模继续增长,对这三类基础设施的需求就会增加。
第二层是更贴近用户的应用们。吴泳铭认为「机器智能」时代真正具有代表性的产品,还没有出现。千问品牌下的各个产品,承担的就是为阿里探索代表性产品的任务。
云栖大会上,千问进一步明确了Personal Agent的方向,要围绕个人提供持续服务;千问办公发布Enterprise Context,试图让Agent进入企业业务;AI眼镜、AI耳机、Qwen Book、QwenNote A2、QwenNote Eva,以及面向手机厂商的Qwen Intelligence,则把Agent带向更多终端和现实场景。
显然,这些应用在现阶段选择了同一个突破口:提高上下文汇集、管理和使用的效率。
因为,随着搜索、写作、分析和工具调用逐渐成为Agent的常见能力,产品形态越来越接近。影响体验的关键开始转向上下文,即面对同一个任务,Agent掌握哪些相关信息,能否从中找到真正有用的部分,又能否及时调用这些信息,来完成后续行动。
未来,产品形态可能还会发生变化,但上下文的重要性不会变。抓住了上下文,千问品牌下的产品就抓住了代表性产品探索过程中的一份确定性。
Personal Agent:知道在为谁思考
之前的AI助理主要围绕一次任务工作。用户提出问题,模型根据当前窗口的信息作答;换一个会话,之前的状态、偏好和选择很难继续影响下一项任务。这类产品可以回答「如何制定跑步计划」,却未必知道提问者是刚开始锻炼、正在准备半马,还是有需要谨慎对待的既往病史。
但用户对AI助理的期待是,能持续了解自己,跟进自己的变化,对齐自己的意图,然后给出针对性的反馈。
千问产品负责人郑嗣寿在云栖大会上透露,千问过去10多个月的复杂任务占比增长了5倍,围绕一个问题的交互达到5至8轮;超过60%的问题,如果可以调用中长期上下文或个人画像,能够得到更好的回答。
「人的沟通本来就是一个越来越打开、越来越深入细节的过程,需要更充分的智能来对齐用户的意图和内在目的。」郑嗣寿表示。用户问新赛季更看好哪支球队,回答可能取决于他长期支持谁;询问孩子的教育计划,背后会关联家庭预算、时间安排和城市选择。
千问也是从这种需求中,提炼出来Personal Agent的概念,把产品目标推进到持续服务一个人,让其依靠千问经营自己的日常生活。
为此,千问提出构建围绕个人的「全域、终身Context」。这个上下文会由三部分组成:职业、家庭角色和人生阶段等通用信息;健康、学习、工作等领域的专业记录;以及手机、电脑和穿戴设备提供的环境与状态信息。
这三类上下文汇总起来,Agent获得就不再是一个人的局部切片,而是一份跨场景、持续更新的个人画像。
具体到产品设计上,千问已经构建九类人群的健康记忆结构,用于区分同一账号下本人、孩子和父母等不同对象的信息,同时还在接入手机和智能穿戴设备中的运动、睡眠、血氧等数据,以补充用户的健康档案;在学习场景中,千问则会把题库、解题能力交给Agent调用,同时通过持续的学习行为建立学情档案,尝试从答题工具走向长期辅导。
此外,千问开放平台也已经接入餐饮、出行、物流、房产等服务,希望把咨询、推荐、交易和履约放进同一段交互。Personal Agent可以让同一份个人上下文为不同服务提供行动约束,比如个人口味和消费能力会决定如何点餐,已有的家庭计划会影响到家庭出行的时间、交通预定和消费额度等。
千问面临的难点可能在于,如何获得尽可能丰富、全面的个人上下文。尽管阿里拥有丰富的生态,但用户个人的社交关系、消费记录、出行信息和生活习惯,还是会分散在微信、美团以及大量垂直应用中。这些数据能不能被千问拿到,取决于第三方产品是否开放。
目前,一些第三方应用往往愿意开放产品功能,但对开放数据保持了高度警惕。同样的思路下,Meta的个人Agent Muse已经遇到了亚马逊的阻拦,因为它代替消费者购物时,可能会绕过亚马逊的个性化推荐体系。亚马逊强调,第三方Agent运行需要尊重服务提供商是否愿意参与的决定。
因此,Personal Agent的上限不只取决于模型能力,更取决于千问能够进入多少生活场景,用户愿意授予多少权限,以及产品能否把来自不同场景的信息正确归属、筛选和调用。
企业上下文:把沉淀的数据提炼成智力资源
个人上下文经常受限于信息来源分散,难以整合;企业上下文面对的最大挑战则是量大、异构,而且充满业务特有的含义。
企业多年积累的文档、会议、群聊、客户资料和业务流程,已经沉淀在钉钉、飞书、企业微信及其他系统里。但这些材料是为人和传统软件组织的,Agent拿到之后,仍然需要辨认版本、核对口径、理解关系。
千问办公CEO陈宇森在演讲中举了一个问题:「上个季度华东区的毛利率是多少?」模型要回答这个问题,至少需要知道公司是谁、华东区如何划分、毛利按什么规则计算。通用知识无法替代这些企业事实。
千问办公应对这类问题的方案就是刚发布的企业上下文(Enterprise Context)——通过在企业软件和Agent之间增加一层基础设施,把企业多年来沉淀的信息加工成Agent可以使用的上下文,并且这个上下文是可以与Agent解耦,被不同Agent使用的。
陈宇森将其概括为「连接、理解和复用」。他表示,每一个交给千问办公的任务,都会按需从企业上下文中提取执行这个任务所需要的上下文,然后按照企业的业务规范和要求,理解企业的业务知识,把任务执行下去。
「按需」是这套机制的重点。企业信息里有重复、过时和相互矛盾的内容,把它们全部塞进模型,既增加Token消耗,也可能干扰判断。而且,企业的数据量远超模型能够处理的信息。陈宇森表示,一般中大型企业内部数据平均约150PB,最强上下文窗口只有百万Token级。
因此,千问办公压缩上下文时,不是生成更短的摘要,而是还要把企业中的人、项目、会议、待办等对象及其关联关系整理出来,让Agent知道谁负责什么、哪些人参与了项目、会议形成了哪些内容,以及后续还有哪些任务。
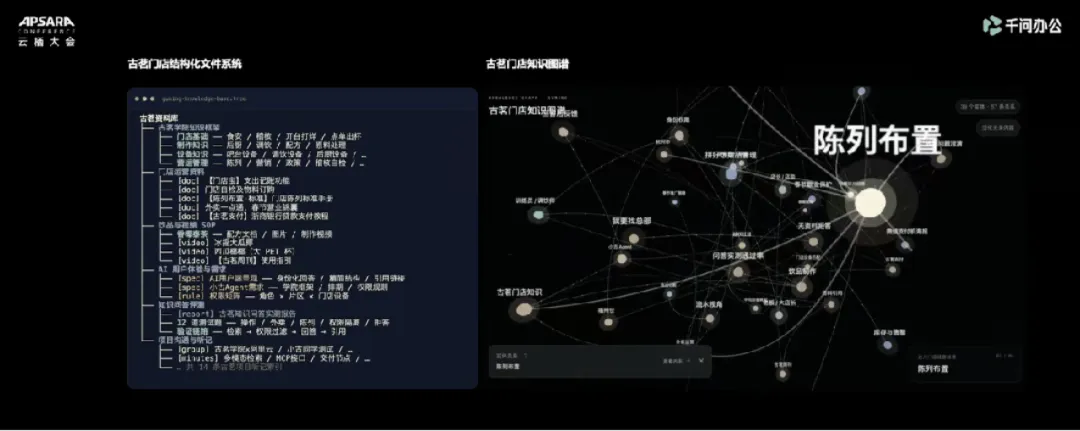
这种压缩此前可能需要耗费大量的人力和时间资源,其成本会让大部分公司望而却步。而千问办公希望借助模型能力的升级,来降低企业上下文的压缩成本,使其成为一种大众化的产品能力。
「有的方案做一家企业的上下文要10天、花100万,我们的方案3天、5000块就能做,差距就在模型上。」千问办公副总裁束骏亮表示。
对阿里而言,办公入口的竞争重心已经不再是具体的产品形态、连接体验,而是理解企业的数据和规则,以更低成本连接、整理和压缩企业信息。在这个变得越来越重要的环节,各个AI办公产品的竞争才刚开始,做得好的人会更有机会让Agent进入真实业务。
同时,企业很难为了使用千问办公迁移全部协作和业务系统,千问办公要用开放吸引更多用户把企业上下文先放到千问办公上来。
所以陈宇森会强调:「我们服务了大量使用飞书和企业微信的客户,这会是未来千问办公一个特别重要的核心。无论是千问办公还是企业上下文,我们要做到:开放,还是开放。」
开放让千问办公更快获取用户。钉钉、飞书、企业微信仍然负责承载组织关系、沟通、审批和固定业务流程,并持续沉淀企业的原始数据、信息与流程;千问办公可以同时对接使用这些协作产品的企业,将其沉淀的材料进行加工,让Agent可以消费。
AI硬件:把现实世界接入思考机器
当下,个人和企业的上下文更多来自已经被数字化的信息,但真实世界里仍有大量信息没有进入软件系统。
一次线下交流、一段临时讨论、用户看到的画面、所处的位置和身体状态,都可能改变Agent对任务的判断。如果机器智能只能读取文档、聊天记录和应用数据,它提供的智力杠杆还是更多在服务于数字世界。
阿里在千问品牌体系下同时布局了办公和个人硬件,就是为了帮助软件抵达看不到的现场。正如束骏亮所说:「硬件是一个非常好的上下文增量收集入口。」千问AI硬件总经理宋刚也把AI穿戴设备称作Personal Agent的重要载体,希望通过第一视角和语音交互建立跨设备的个人上下文。
在办公场景中, QwenNote A2负责把会议和客户沟通转化成文字,再交给千问办公整理、压缩和执行。按照陈宇森的介绍,设备默认不永久保存原始音频,音频在云端完成转写后删除,只留下文本内容。阿里将其概括为「真AI,不录音」。
QwenNote Eva则可以直接唤起Agent,并与千问办公的数据链路连接。用户不必先打开电脑、找到应用、进入对话框,再发出指令。硬件不仅收集上下文,也缩短了调用机器智能的路径。
在个人场景中,不同硬件会提供不同的上下文内容:Qwen Book定位一款能自主理解用户意图、并能不断进化的AI Agent电脑;AI耳机提供可以长时间存在的语音入口;AI眼镜则进一步加入了第一视角的视觉和环境信息。
理想状态下,带有显示功能的AI眼镜,能获取更全面的个人上下文信息。但在它能够解决重量、续航和交互问题之前,耳机和轻量AI眼镜可以先成为低门槛的常驻入口。它们提供的视觉上下文有限,却更符合已有佩戴习惯,也更容易实现长时间在场,随时唤起Agent完成任务。
面向移动端厂商的Qwen Intelligence,则把千问的模型、Harness、记忆管理和任务执行能力输出到移动终端。它围绕模型、任务运行系统和记忆组织能力,让设备能够理解意图、管理任务状态,并调用过往信息。手机中沉淀的账号、应用和用户行为,也可能是个人上下文的重要来源。
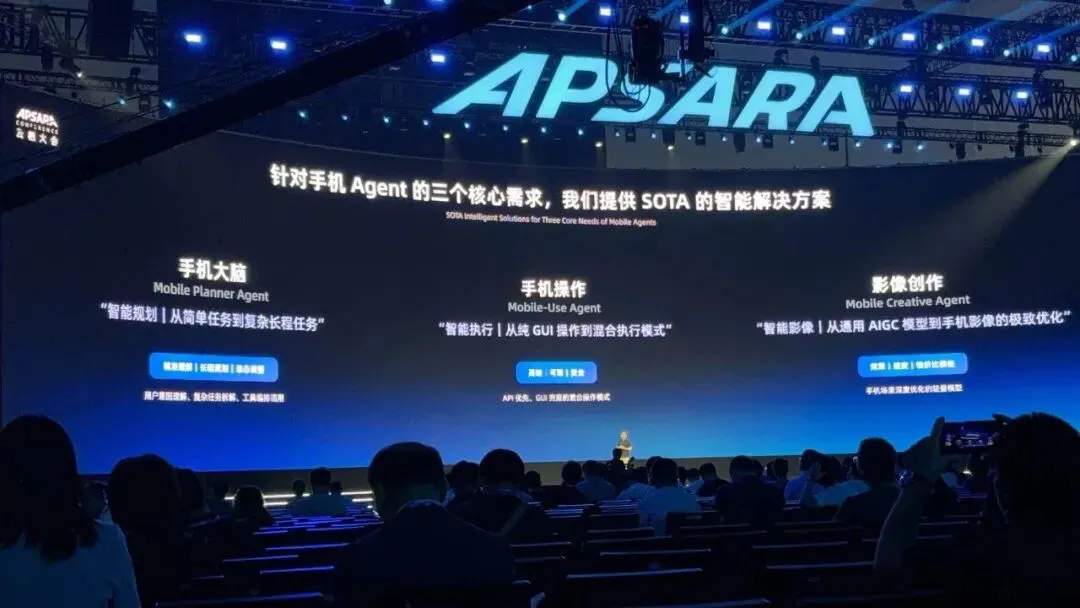
这些终端最终面对的是同一个信息处理的效率问题——哪些信息值得留下,哪些需要及时更新,当前任务又该调用哪一部分。因此,端侧模型和端云协同会变得更加重要,它们影响处理速度、能耗和数据流转方式,决定持续感知能否成为一种可长期使用的体验。
硬件不只是为模型增加一个外壳,而是在机器智能和现实世界之间增加感知与交互接口。它一端把声音、画面、位置和身体状态转化成上下文,另一端让用户可以更自然地调用智能。
尾声
吴泳铭描绘了一个机器思考极度充沛的时代,但机器智能的规模,并不自动等于产品价值。只有当通用智能足够理解具体的人、企业和环境,智力杠杆才会真正落到个人生活与组织生产中。
千问品牌下的产品们把上下文作为破局点,正是因为它位于基础设施与最终产品之间:向下承接模型、芯片和云提供的机器智能,向上决定这些智能能否围绕真实目标被正确使用。
机器智能时代的代表性产品或许还没有出现,但决定它能否出现的竞争,已经从模型能力延伸到了上下文。
- END -