ARTICLE · 1099348
算力透析 | AI开始“常驻”了!从Grok Bot、Muse到ChatGPT「o」,大模型正在长出自己的电脑与算力系统
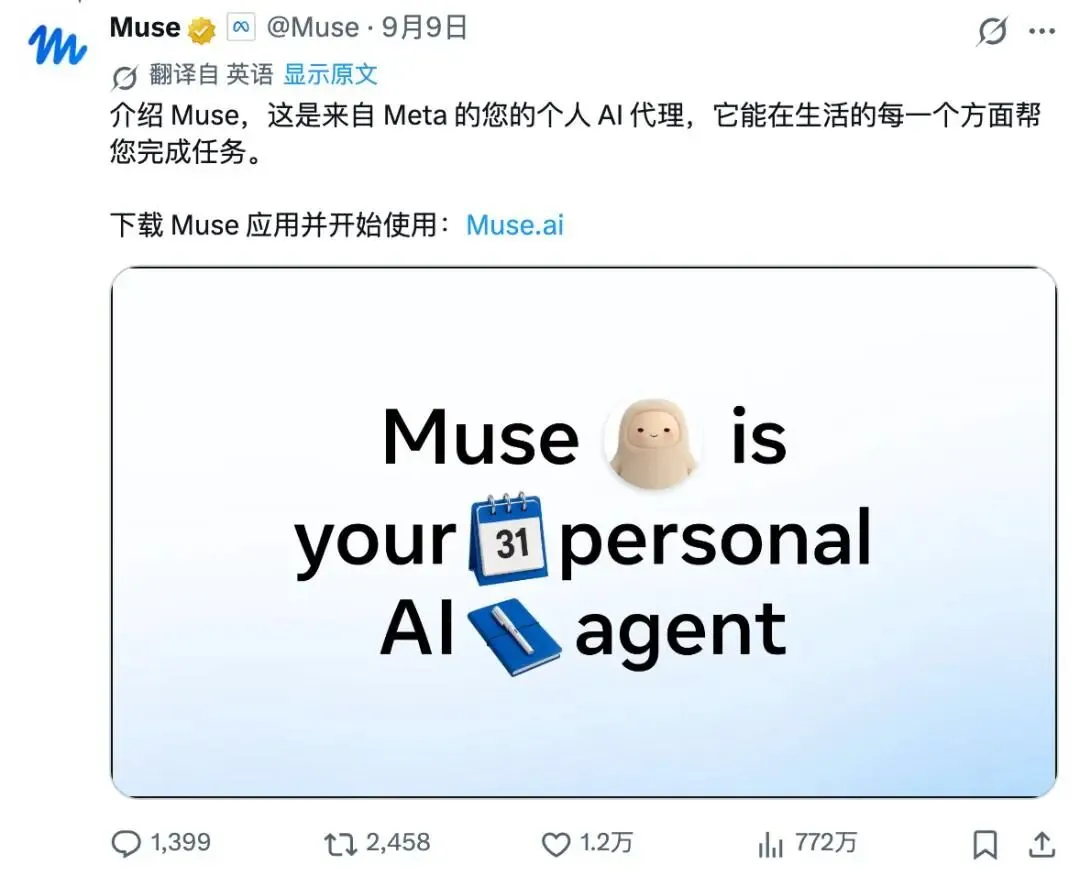
过去两年,大模型的进化主线一直是“更聪明”:更长上下文、更强推理、更好的多模态。但2026年,一个更关键的变化正在发生——AI开始从聊天框里搬出去,变成长期运行的软件进程。Grok Bot让每个Agent拥有自己的电脑并24小时工作;Meta Muse则直接运行在独立的Secure VM中,即使用户关闭App也可以继续执行任务。
而OpenAI近期被发现存在名为“o”的“always-on assistant”相关配置,但截至9月28日尚未正式公布,因此具体能力仍应视为未确认信息。如果这一方向最终落地,它所代表的竞争已经不是“谁做出了更好的Chatbot”,而是谁能率先建立一套模型、记忆、Agent、虚拟电脑和云端算力持续协同的Personal AI Runtime。
从Chatbot到Always-on Agent
传统ChatGPT式产品本质上是一个离散计算系统:用户提出问题,服务器调度GPU完成一次推理,生成答案后任务基本结束。Agent改变了这一逻辑,因为任务可能包含规划、搜索、浏览器操作、代码执行和工具调用;Always-on Agent又进一步把“会执行任务”变成了“长期负责一个目标”。
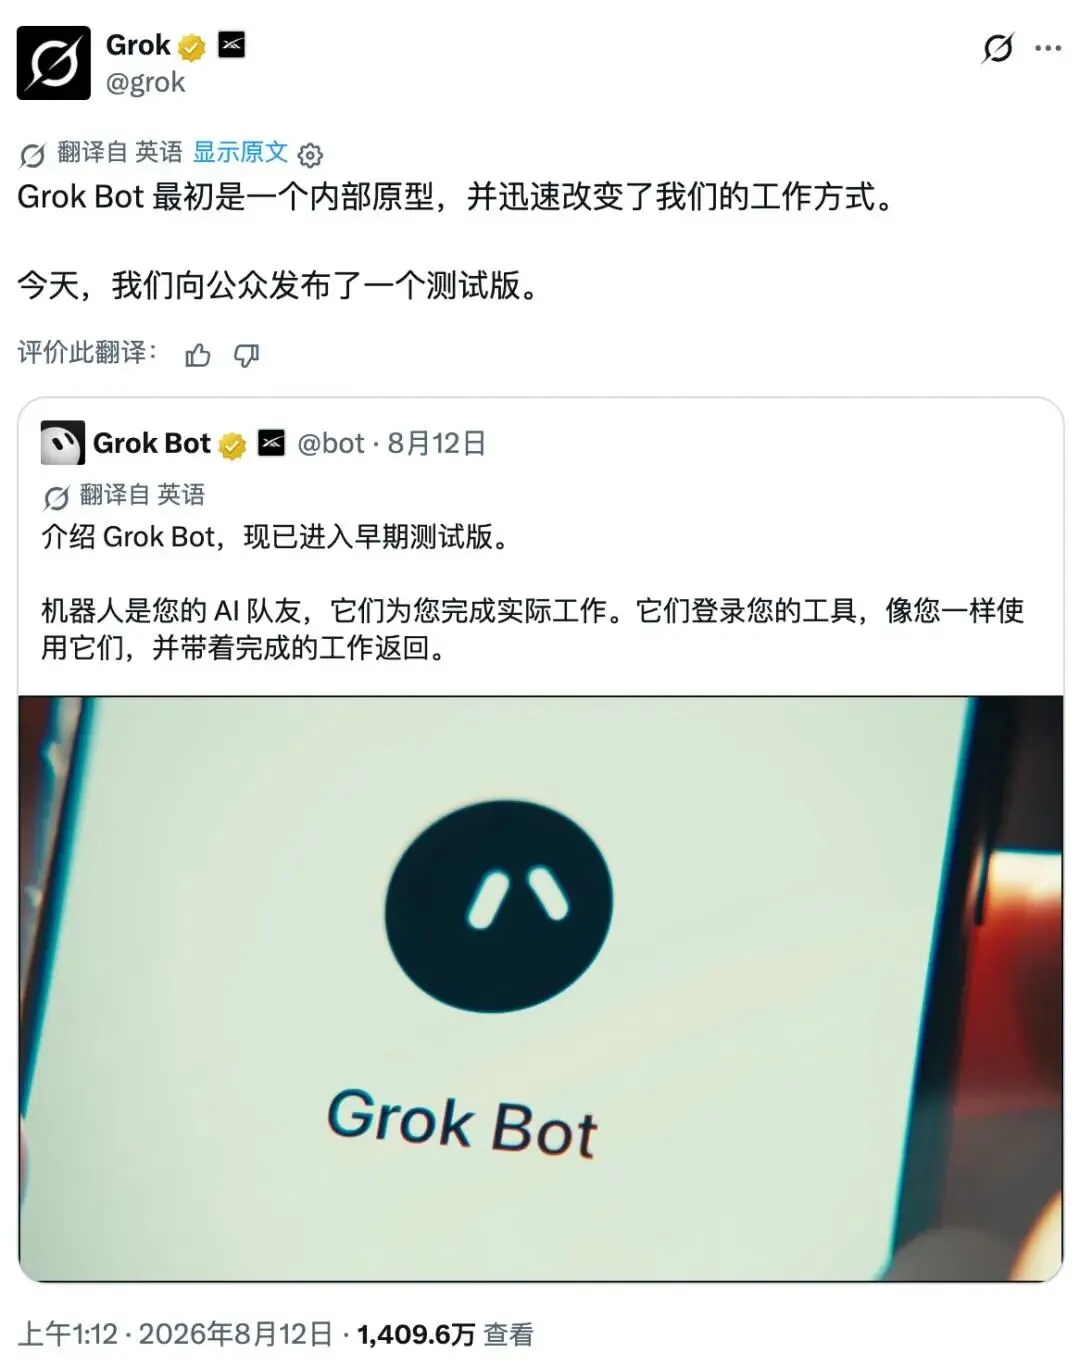
Grok Bot已经把这种形态做得非常直接:每个Bot拥有自己的计算机,可以登录软件,在邮箱和不同应用之间工作,并保持24/7运行。用户可以分别创建销售、营销、运营或开发Bot,让它们拥有不同记忆和任务。SpaceXAI Muse则更进一步,它不仅可以在后台持续执行任务,还会围绕长期目标主动推进工作,在需要发送邮件、购买商品等敏感操作时再回来请求用户授权。
这实际上改变了AI软件的基本单位。过去是“一次Prompt”,后来变成“一次Task”,下一阶段则可能变成一个长期存在的Agent Process:它拥有身份、记忆、权限、任务队列和运行环境,可以定期唤醒、检查状态、调用工具、执行任务,然后重新进入等待状态。
因此Personal AI Agent更像一个面向自然语言任务的新型“进程系统”。用户不再需要反复告诉AI“帮我查一下”,而是定义一个长期目标,例如“持续跟踪这个行业,发生重大变化时整理报告”。从这一刻开始,AI面对的就不再是一段上下文,而是一个持续数周甚至数年的状态机。
虚拟机正在成为Agent的新身体
Muse最值得关注的技术设计,并不是聊天界面,而是Meta专门为它建立的Muse Secure VM。每个Muse运行在持续存在的独立虚拟机中,拥有自己的浏览器,连接服务所需要的数据和凭证也在这一环境中管理。Facebook Grok Bot同样强调“Bots have their own computer”。
原因并不复杂:API和MCP只能覆盖已经结构化开放的能力,但现实世界大量工作仍然存在于网页、邮件、Excel、企业软件和各种GUI中。如果AI真的要完成“像人一样工作”,最终就需要一个可以打开浏览器、操作软件、保存文件并维持登录状态的执行环境。
于是新的Agent技术栈开始形成:大模型负责思考 → Agent Runtime负责规划 → Memory保存长期状态 → MCP/API调用结构化服务 → Computer Use处理GUI → 云端VM提供持续执行环境。
这比传统LLM复杂得多。Meta甚至专门训练Muse处理零样本工具调用、长上下文、长轨迹指令执行、多Agent协作以及Prompt Injection等问题。Meta AI Research 这意味着未来衡量Agent能力,不能只看模型在Benchmark里答对多少题,而要看它在连续执行几百甚至几千个动作之后,是否仍然能够保持目标一致性。也因此,“给AI一台电脑”并不是营销噱头,而是在补齐Agent的执行层。LLM是大脑,Memory是长期记忆,MCP/API是接口,而云端Computer正在变成AI的身体。
Always-on真正烧的是算力
常驻Agent会带来完全不同的算力问题。Chatbot的GPU负载通常由用户消息触发,而一个长期Agent需要不断经历“观察—判断—规划—执行—验证”的循环。一个看似简单的“持续帮我关注AI新闻”,背后可能包括搜索、网页抓取、信息去重、相关性判断、摘要、事实核验和通知决策。
如果每一步都调用最大模型,Personal AI Agent几乎不可能经济地扩展到数亿用户。因此真正决定这一产品能否规模化的,很可能不是单纯增加GPU,而是建立分层AI算力调度系统。轻量模型负责事件检测和分类,大模型只在复杂规划时被唤醒,视觉模型处理GUI,代码模型负责程序执行,安全模型再独立检查高风险动作。
这样一来,AI基础设施的优化目标也会发生变化。过去行业强调Tokens/s和GPU利用率;Agent时代还需要关注Cost per Task、Time to Task以及每个长期Agent每天消耗多少计算资源。KV Cache、Prompt Cache、模型路由、动态批处理、异步推理和状态持久化都会从优化项变成核心基础设施。
更重要的是,Agent并不是始终需要GPU满负荷运行。绝大部分时间可能只是等待邮件、价格变化或者某个触发条件。因此未来的数据中心可能采用“事件触发+弹性算力”的架构:数百万Agent保持逻辑上的在线状态,真正需要思考时才动态唤醒GPU推理资源。这使Always-on AI更像云计算,而不是传统聊天机器人。竞争焦点也会从“谁拥有最大的模型”逐渐延伸到谁能以最低成本维持最多长期在线的智能体。
Personal AI的终局是一套AI操作系统
当AI拥有自己的电脑、长期记忆、定时任务和持续运行能力之后,一个新的问题会出现:如果每个人同时拥有多个Agent,谁负责管理它们?
未来一个用户可能同时拥有工作Agent、研究Agent、购物Agent、财务Agent和内容Agent。它们需要共享部分记忆,却又不能共享全部权限;需要相互协作,又不能让一个被Prompt Injection攻击的Agent获得其他Agent的账户权限。这已经非常接近操作系统面对的进程隔离、权限管理和资源调度问题。
Muse的设计已经出现这种趋势。Meta为它额外部署了与主Agent系统隔离的Sentinel Agent,Muse对互联网执行操作需要经过安全检查,发送邮件、购买商品等敏感行为还需要用户确认,并保留完整操作审计记录。Facebook 这说明真正可用的Personal AI不能只是“LLM+浏览器”,而需要形成Planner + Memory + Computer + Permission + Security Agent + Audit Log的完整Runtime。
OpenAI被曝光的“o”目前仍缺乏官方产品说明,因此还不能确认它最终是否具备类似Muse的独立虚拟机或完整常驻能力。BleepingComputer 但Grok Bot和Muse已经把行业方向展示得非常清楚:AI产品正在从“一个模型回答所有问题”,走向“一个系统长期管理任务”。
因此,下一阶段AI真正争夺的可能不是聊天框,而是Personal AI Runtime。模型负责推理,Agent负责行动,Memory维持长期状态,云电脑提供执行环境,GPU集群提供按需智能算力,安全系统决定它能够走多远。
[1] YAO S, ZHAO J, YU D, et al. ReAct: Synergizing reasoning and acting in language models[C]//International Conference on Learning Representations. 2023. ML Anthology
[2] PARK J S, O'BRIEN J C, CAI C J, et al. Generative agents: Interactive simulacra of human behavior[C]//Proceedings of the 36th Annual ACM Symposium on User Interface Software and Technology. New York: ACM, 2023: 1-22. Google Research
[3] PACKER C, WOODERS S, LIN K, et al. MemGPT: Towards LLMs as operating systems[EB/OL]. arXiv:2310.08560, 2023. arXiv
[4] LIU X, YU H, ZHANG H, et al. AgentBench: Evaluating LLMs as agents[C]//International Conference on Learning Representations. 2024.
[5] XIE T, ZHANG D, CHEN J, et al. OSWorld: Benchmarking multimodal agents for open-ended tasks in real computer environments[C]//Advances in Neural Information Processing Systems. 2024, 37.
联系我们
服务热线:010-8622 9776
品牌合作:pr@fitodata.com
商业合作:marketing@fitodata.com
官方网站:www.fitodata.com
#GPU#AIGC#LLM#智算服务#算力租赁#智算中心#算力规模#算力平台#IB组网#大模型#算法优化服务#算力组网服务#算力平台规划服务#训练平台#NVIDIA #英伟达 #CUDA