ARTICLE · 1101838
AI 越强,工程越重要:医疗AI智能体需要的是把「规则」做成「工程」的能力
当智能体接管了执行,人类的价值转移到「判断」。一位前沿工程师的实测方法论,照见国内医疗 AI 最缺的那一环。
2026 年 8 月 25 日,Tessl(Snyk 创始人创办的 AI 编码智能体赋能平台)研究工程师 Amy Heineike 在自家产品与工程博客发了一篇文章:《The Rise of the Harness Engineer》。没有新模型发布,没有榜单刷新,通篇在讲一件在硅谷语境里略显复古的事——工程的约束与检查。
但它给出的几个数字足够刺人:Tessl 一周约有90% 的代码由内部「软件工厂」生成,过去一个月稳定在 80% 以上;而在一项自建技能基准测试中,任务完成率普遍很高,真正被遵守的技能指令平均只有约 70%。
对国内医疗 AI 行业来说,这篇写「怎么管住写代码的智能体」的文章,非常值得深读。原因很简单:医疗 AI 当下最缺的,不是模型能力,而是同一套「Harness 式」的工程约束体系。
《The Rise of the Harness Engineer》 · 图片来源:Tessl 产品与工程博客
一、原文速览:五个硬结论
以下五条为原文核心观点归纳,数据与措辞尽量保留原始口径。
01 · 智能体很强,但裂缝随时间出现。编程智能体的采纳曲线接近垂直,多数组织里「绝大部分代码由 AI 编写」,但与之同步上升的是缺陷与生产事故——越来越多 PR 在无人工评审的情况下被合并。基准测试呈现同样的两面性:任务型基准已接近饱和,但一旦要求重构大型代码库、或在既有成果上持续迭代,成功率就明显下降。
02 · 「等更强模型」解决不了问题,而且很贵。智能体与成本的关系是:智力轴近似线性上升,价格轴却按对数级膨胀——同一任务,顶级模型与「够用」的便宜模型之间可能有约 10 倍价差,整体区间跨度可达约 100 倍。Tessl一周合并了约 600 个 PR,此时成本与效率本身就是一等一的工程问题。
03 · 「指令鸿沟」(The steering gap)是核心发现。他们从开源仓库抽取近千条技能(skills),构建任务,分别在有/无技能条件下跑智能体,并做双重评分:任务是否完成、指令是否被真正遵守。结论是——技能定义得好,可以降低任务难度,让更便宜、更小的智能体达到与昂贵大模型同等的成功率;但是有个大坑:AI 虽然把事情做完了,并不严格遵守你给它的全部要求,指令遵守率平均只有 70%。所以技能必须与「检查」配对。
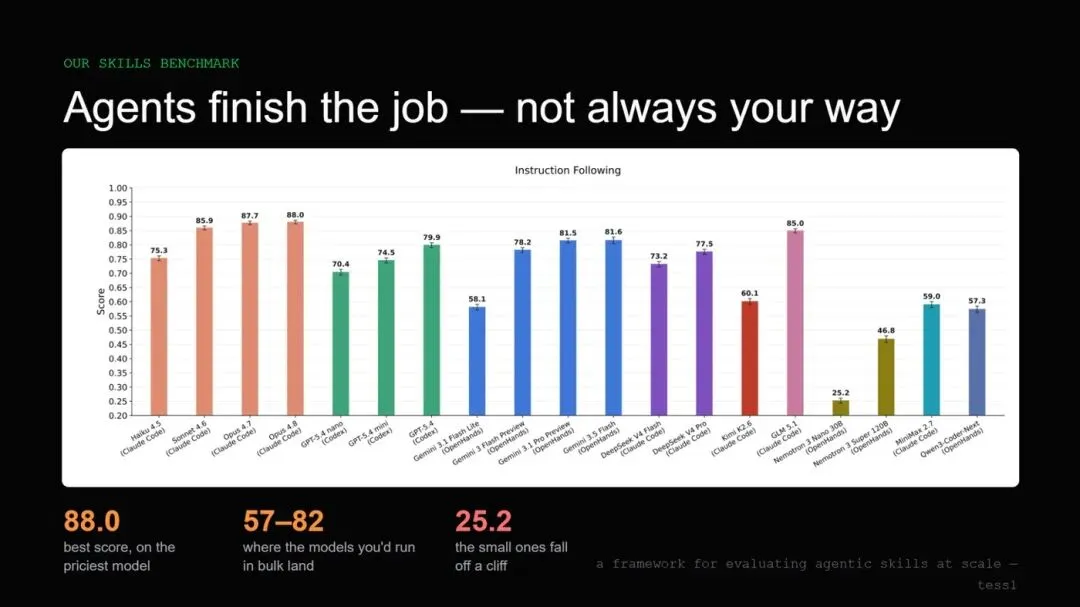
Tessl 官方 Skill Benchmark · Instruction Following 维度各模型得分(图片来源:Tessl 博客)· 手机端可点击图片放大查看
把这张图换算成一句话会更刺眼:最强的模型也只拿到88.0分,而「把活干完」和「按你说的干完」是两件不同的事——逐条核对下来,平均只有约 70% 的指令被真正遵守。
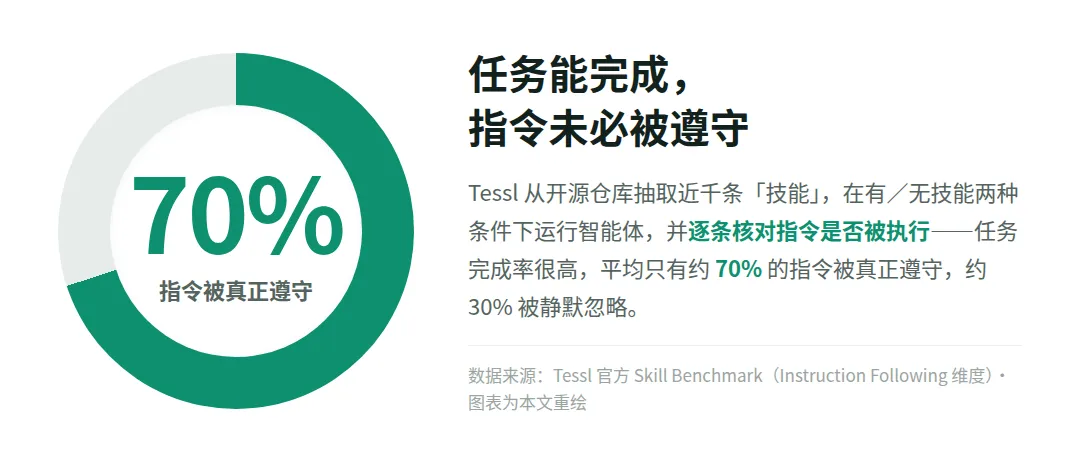
数据来源同为原文 Skills Benchmark——近千条技能任务,逐条核对「指令是否被执行」而非「任务是否完成」。
04 · 工程不是变少了,而是变得更重要了。手写代码时代,关键决策可以在协作中隐式涌现(画一张架构图、选一个库);智能体时代节奏太快,人很容易退化成「被通知去评审 PR」的被动反应者。想真正快,就必须主动设计智能体运行的系统,把选择显式化,并度量「涌现出来的系统是否是我们要的」。
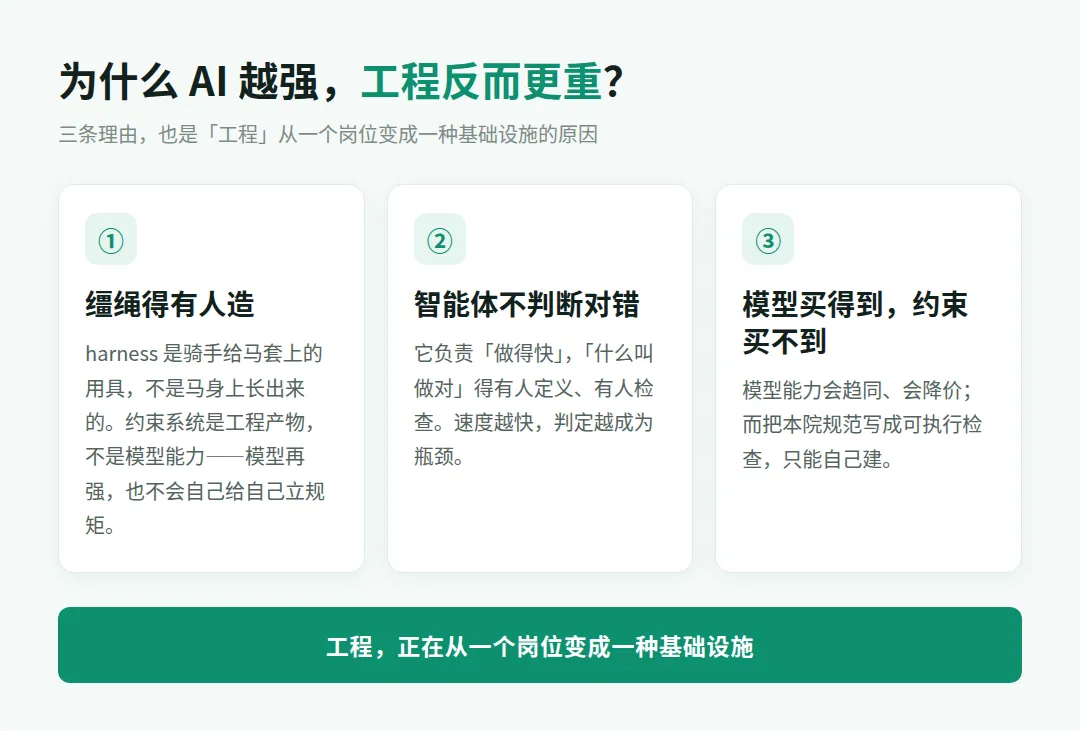
为什么 AI 越强,工程反而更重?
①缰绳得有人造。harness 是骑手给马套上的用具,不是马身上长出来的。约束系统是工程产物,不是模型能力——模型再强,也不会自己给自己立规矩。
②智能体不判断对错。它负责「做得快」,「什么叫做对」得有人定义、有人检查。速度越快,判定越是瓶颈——所以检查不是变少了,而是必须前置进系统设计。
③模型买得到,约束买不到。模型能力会趋同、会降价,而「把本院规范写成可执行检查」只能自己建——这,就是把规范做成工程的能力。
这三点也是「工程」从一个岗位,变成一种基础设施的原因。
05 · 三项新核心能力 + 一个新角色。
① 系统思维:捕获不变量(invariants)。把设计系统、架构约定、工程最佳实践里「必须一直为真」的原则显式化,再用四层手段强制执行:skills 描述、确定性检查(CI / linter / ast-grep)、窄域 verifier、智能体代码评审。
② 分析能力:用数据推理系统。智能体日志(它在哪儿打转、读错文件)、PR 评论(错误是否可归纳为通用不变量)、代码库分析(复杂度、上帝文件、重复实现、变异测试),把信号转成假设,再回到根因修复。
③ 风险与运营:给爆炸半径分级。从「研究代码随便合」到「内部工具全自动合」到「必须 owner 自己合」再到「高杠杆部分必须找想过这个问题的人」,把分级写进审批流。
④ Harness Engineer。不变量 + 分析 + 风险 = 驾驭工程。少数组织由专家承担,多数组织里它将成为每个工程师工作的一部分——身份从「写功能的人」变成「代码与系统的园丁」。
二、为什么一篇写代码的文章,值得医疗 AI 读
「智能体写代码」与「医疗AI 」高度同构
医疗AI是高后果领域:出错有真实代价;都受大量既有规范约束:代码有架构约定,医疗有诊疗指南与核心制度;都面临同一个困境——执行者的速度,已经远超人类的审核速度。Tessl 遇到的是「PR 太多、评审不过来」,医疗遇到的是「模型输出太多、医生看不过来」。
把两套语汇一一对齐,会看到一张几乎同形的结构表: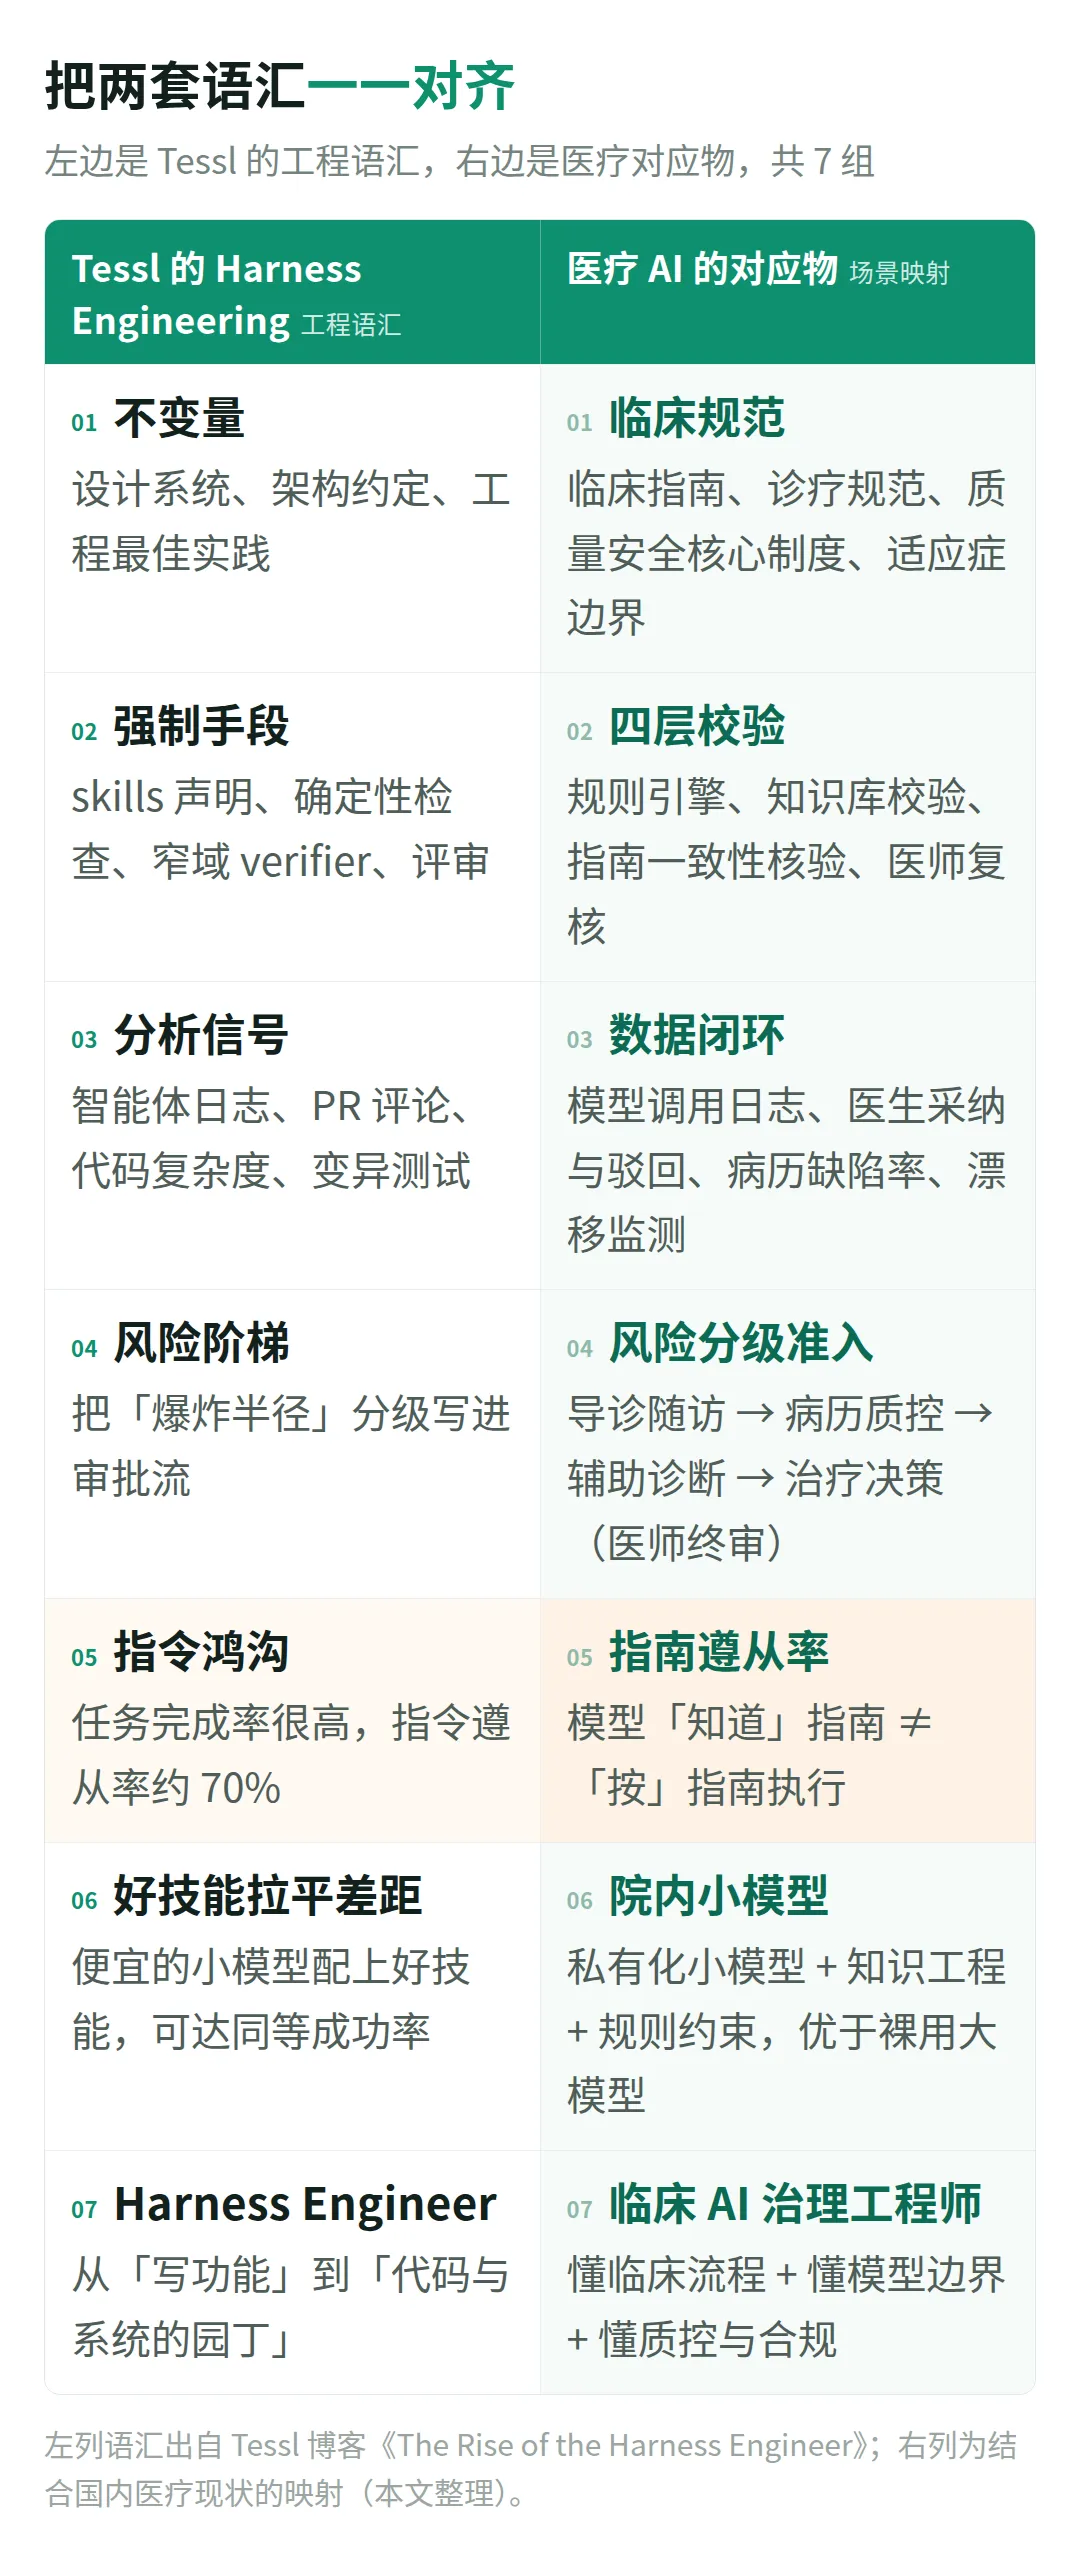
一句话:医疗 AI 缺的不是「更强的模型」,而是把临床规范变成可执行、可检查、可度量的护栏体系。
三、对照国内医疗行业现状:四个结构性约束
把 Harness 框架放进国内的医疗土壤里,会先撞上四道墙。
1 · 需求端:缺口是结构性的,不是总量性的。老龄化与慢病负担持续加重,基层诊疗能力薄弱,影像、病理、儿科、全科的人力缺口长期存在。这决定了 AI 的第一性价值是补位与提效,而不是替代。
2 · 支付端:谁掏钱,比模型多强更要紧。医保主导的支付格局下,控费(DRG/DIP)是长期主线;在放射检查等价格项目立项指南中,AI 辅助诊断被作为扩展项、不单独设立收费项。这意味着AI 很难靠「多收一笔钱」变现,必须把价值内嵌到「省了什么成本、提了什么效率、降了什么风险」里。
3 · 监管端:分级准入 + 责任不转移。AI 医疗器械走 NMPA 审批路径(三类为主),卫健委侧持续发布人工智能应用场景指引,明确推荐场景与边界,叠加《数据安全法》《个人信息保护法》要求。关键在于:无论 AI 多强,诊疗责任的终审主体仍是医师与医疗机构——这正是「爆炸半径分级」在医疗里的制度版本。
4 · 数据端:护城河同时也是枷锁。数据不出院、院内系统割裂、标注质量参差、跨院流通受限。而模型侧的通用能力已「基本够用」,于是瓶颈从「能不能做出来」转移到了「能不能在真实院内环境里被信任、被采纳、被度量」。
四、对医疗 AI 的六个直接影响
如果承认「瓶颈在工程而不在模型」,行业里六件事会随之变化。
1 · 竞争焦点从「模型能力」转向「护栏能力」。未来比拼的是:临床知识能否被工程化为可执行规则?模型输出能否被逐条核验?异常能否被日志捕获并回溯?
2 · 「指南遵从率」将成为比 AUC 更重要的指标。参考约 70% 的指令遵从率——医疗 AI 真正要回答的是「该做的做了没有、不该做的做了没有」,而非离线测试集上的漂亮分数。
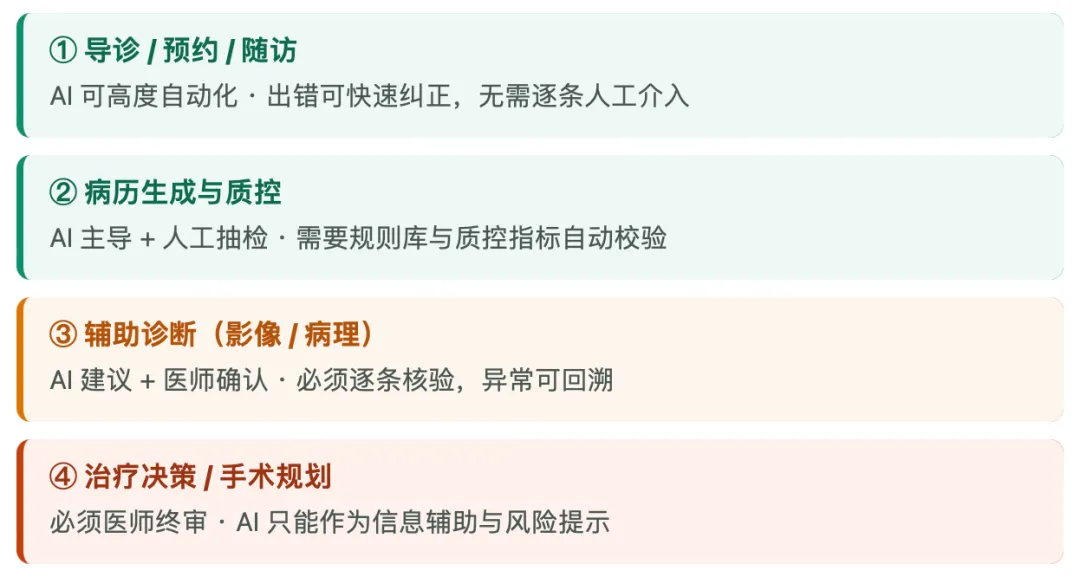
3 · 风险分级会成为产品设计的第一原则。低风险场景(文书、随访、导诊)可以激进自动化;高风险场景(诊断、用药、手术)必须以 verifier + 医师终审兜底。
把它画成阶梯,边界会清楚得多——场景风险越高,AI 能自主的空间越小,人工终审的比重越大:
4 · 「小模型 + 知识工程 + 规则约束」的院内路线将被重新估值。它在成本、隐私、可控性上占优,且与「好技能让便宜模型达到同等成功率」的结论一致。
5 · 数据闭环成为核心资产。医生的采纳与驳回、修改痕迹、质控缺陷,是医疗版的「智能体日志 + PR 评论」,也是持续迭代的唯一燃料。
6 · 新岗位出现:AI 治理工程师。既懂医院流程与质控,又懂模型边界与合规,负责把「不变量」写下来、把检查建起来、把风险分级定下来。
五、未来判断:短期看文书,中期看闭环,长期看责任与支付
以下为基于上述框架的判断,非原文观点。
短期 · 12–18 个月
· 应用重心从「辅助诊断」向「文书与流程」偏移:病历生成与质控、随访、患者服务、科研辅助。原因是风险低、付费路径相对清晰(直接节省医生时间)。
· 院内私有化/本地化部署成为标配,数据不出院是默认前提。
· 影像 AI 进入存量整合期:三类证合规运营、场景收敛,从「卖软件」转向「卖服务与效率」。
中期 · 2–3 年
· 多模态与智能体进入临床辅助决策(CDSS 2.0 形态),但前提是三项基础设施建成:可执行的临床知识库(不变量)、院内数据闭环(分析)、风险分级准入(风险)。
· 评价体系切换:从模型指标转向系统指标——指南遵从率、漏诊与误诊率、医生采纳率、单病种流程耗时、单位成本。
· 会有一批企业因「只有模型、没有护栏」而在规模化阶段掉队。
长期 · 5 年
· AI 成为医疗基础设施,但天花板不由技术决定,而由责任界定与支付机制决定。
· 人机协同从「技术选项」变成「制度设计」:终审权、举证责任、质量责任如何分配,将直接决定 AI 能走多深。
五条凝练判断
1. 模型能力不再是主要瓶颈,把规范做成工程的能力才是——AI 越强,工程越重要。
2. 医疗 AI 的竞争,将从「比模型」转向「比护栏、比闭环、比风险分级」。
3. 「小模型 + 知识工程 + 规则约束」在院内场景胜过通用大模型的裸用。
4. 不进收费目录的现实,决定了价值必须内嵌进效率与质控指标。
5. 医疗界的 harness engineer(AI 治理工程师)会成为稀缺岗位。
一个反直觉的推论:AI 越强,掌握「终审权」和「规则设计权」的人越值钱。速度被智能体接管之后,人类的负荷并不会减少,而是从「做事」转移到「定义什么叫做对、并检查它是否做对」。
六、行动清单
原文结尾给了一份「本周就能做的三项练习」,这里翻译成医疗语境。
医院
· 建立院内 AI 应用的风险分级清单与审批流:哪些场景可自动、哪些必须人工终审。
· 把现有质控规则、临床路径「工程化」,先做 3 条可自动校验的不变量。
· 保留完整使用日志与采纳记录——这是未来所有迭代的燃料。
医疗 AI 厂商
· 从 demo 指标转向交付指标:指南遵从率、医生采纳率、流程耗时下降。
· 把「验证器」当作产品的一等公民,而不是评测环节的附属品。
· 重新评估小模型/私有化路线:在成本与合规双重约束下,它可能是更优解。
投资人与决策者
· 尽调时少问「你们模型多强」,多问「你们的护栏在哪里、闭环怎么转、风险怎么分级」。
· 关注具备「临床规则工程化能力」的团队——这类能力比模型参数更稀缺、更难被追上。
参考资料:Amy Heineike,The Rise of the Harness Engineer, Tessl 产品与工程博客, 2026-08-25