ARTICLE · 1112238
保持功能的AI生成蛋白质水印技术
【按】:这两天,AI生物技术领域又发生了一件不算小的事情:谷歌团队开发出蛋白质水印技术,在人工设计的序列中嵌入可识别标记,并在所测试的结合分子中保持了功能。
往好处看,它有助于追溯来源、保护知识产权。
往深处想,也引出了垄断隐忧。试想,若谷歌或其他巨头凭借算力和模型优势,围绕所有已知蛋白大规模设计结合分子、激动剂、拮抗剂、抗体等,并提前布局专利,其利益版图可能延伸至医药、农业和工业生物技术等领域。届时,中小企业面对的可能是覆盖关键靶点与应用的专利壁垒。
Google DeepMind 团队于 2026年9月30日在《Nature》发表的:
Function-preserving watermarking of AI-generated proteins中文可译为:《保持功能的AI生成蛋白质水印技术》作者:David Stutz、Alexander I. Cowen-Rivers 等。DOI:10.1038/s41586-026-10965-y。Nature
研究者开发了 SynthIDBio,为AI生成的生物数据嵌入可检测的“水印”。其中包含两种不同技术:
序列水印不是在蛋白末端加一段标签。 它在 ProteinMPNN 选择氨基酸时,用密钥对候选选择施加偏好,使信号分散在序列中。官方已公开相关代码:SynthIDBio代码库。Nature
图1:水印怎样加入蛋白设计流程
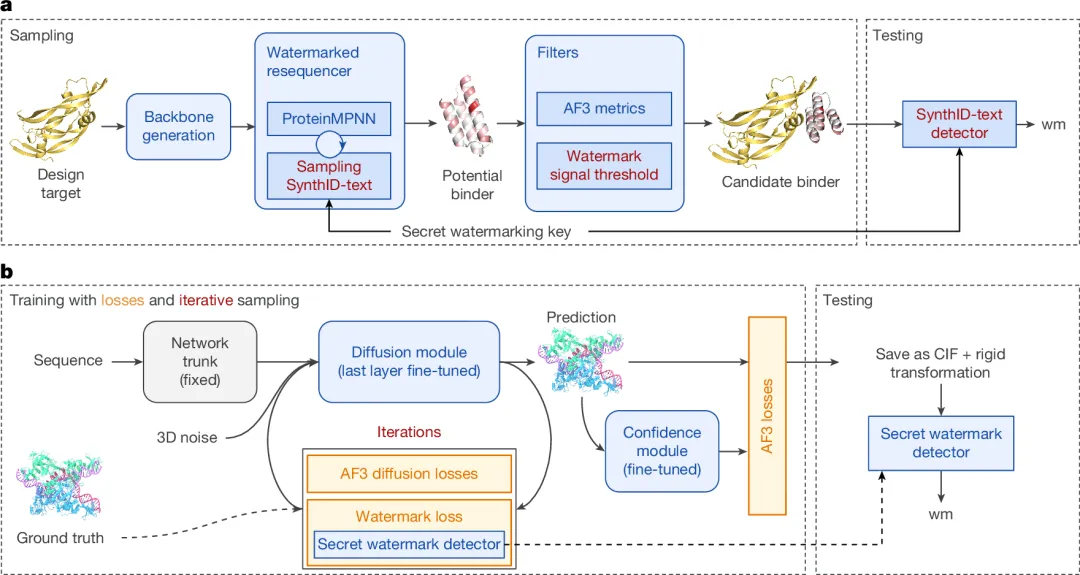
这里的“标签”是分散的统计信号,并非额外接上一段标签肽。
作者用三个靶点的已知结合蛋白骨架重新设计序列,比较有水印和无水印的蛋白:
新冠病毒受体结合域(RBD); VEGF-A; PD-L1。
SPR测定显示,两组整体结合亲和力相近。不过,这证明的是这些结合分子的结合性能可以保持,不能直接推广为所有酶、抗体或激动剂的全部功能均不受影响。
图2:加水印后,结合性能仍可保持
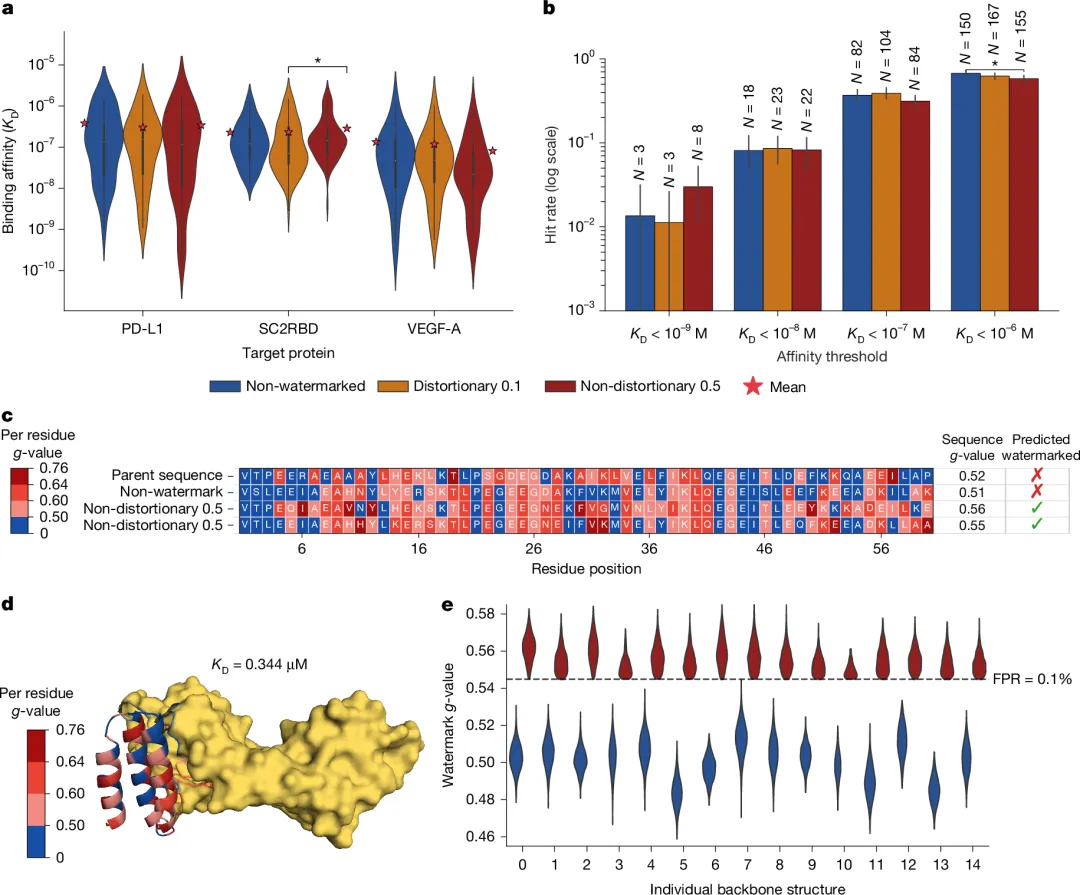
结果支持测试结合分子的性能总体保持,不能推广为所有蛋白功能都不受影响
图3:水印检测的代价与局限
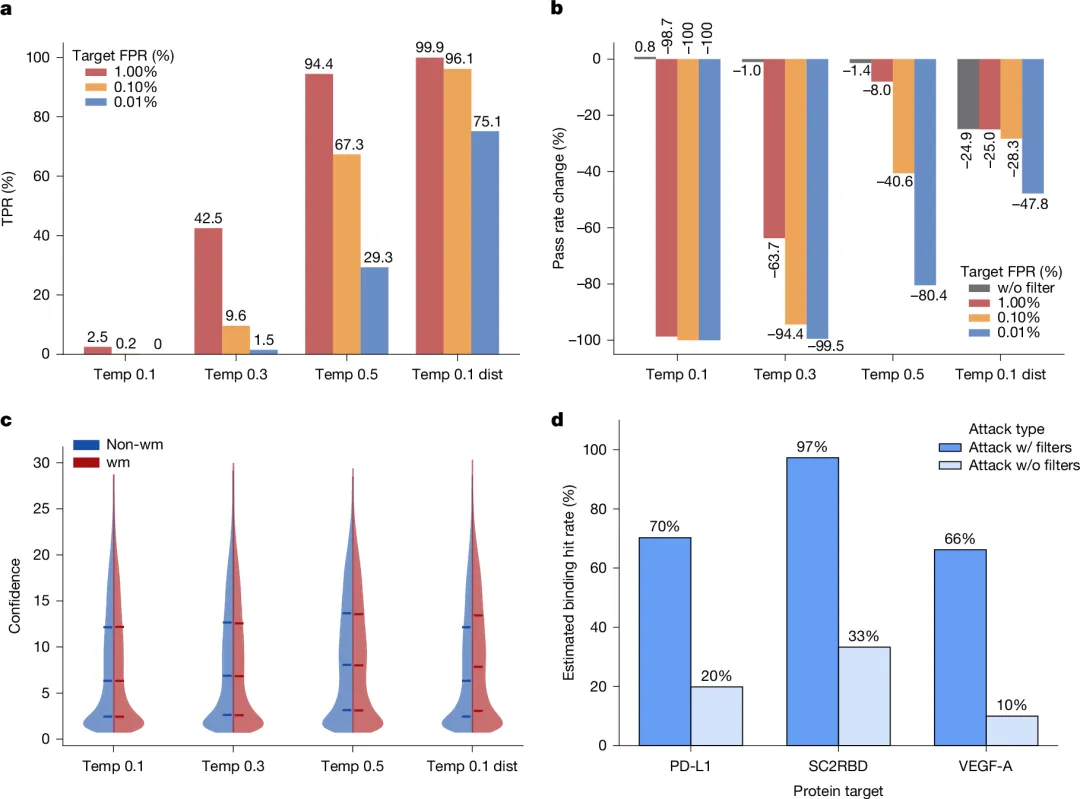 a、b: 提高检出率、降低误报率,会使更多候选被筛掉。这里的“温度”是模型采样参数。
因此,论文中提出的水印并非不可移除的分子身份证。
图4:结构水印能否保持预测准确度?
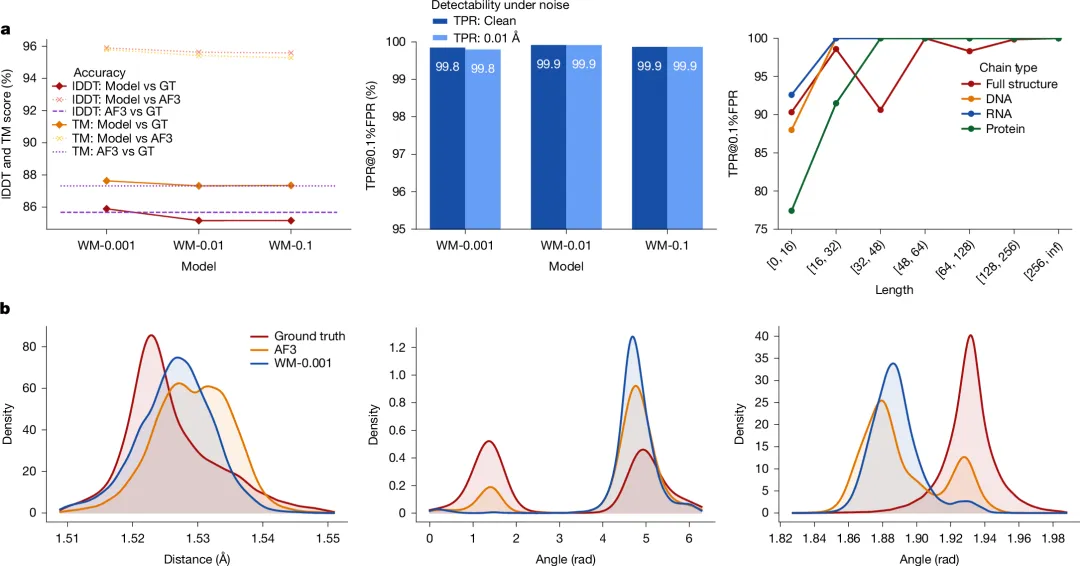
论文中标记的是预测结构数据,还不能据此认定实际合成蛋白会保留同样的几何水印。