ARTICLE · 1113508
突破 AI 内存墙(Memory Wall)
过去几年,AI 芯片竞争最醒目的指标一直是 FLOPS:更多 Tensor Core、更低精度、更高算力。但进入大模型推理、长上下文和 Agentic AI 阶段后,一个越来越现实的问题正在浮出水面:
芯片可能已经算得足够快,但数据送不过来。
特别是在大模型逐 token 生成阶段,计算单元需要不断读取模型权重、KV Cache 和中间数据。算力增长速度如果持续超过内存容量、内存带宽和芯片间互连速度,那么大量昂贵的计算单元最终只能等待数据。
这就是 AI 时代越来越突出的问题:Memory Wall——内存墙。
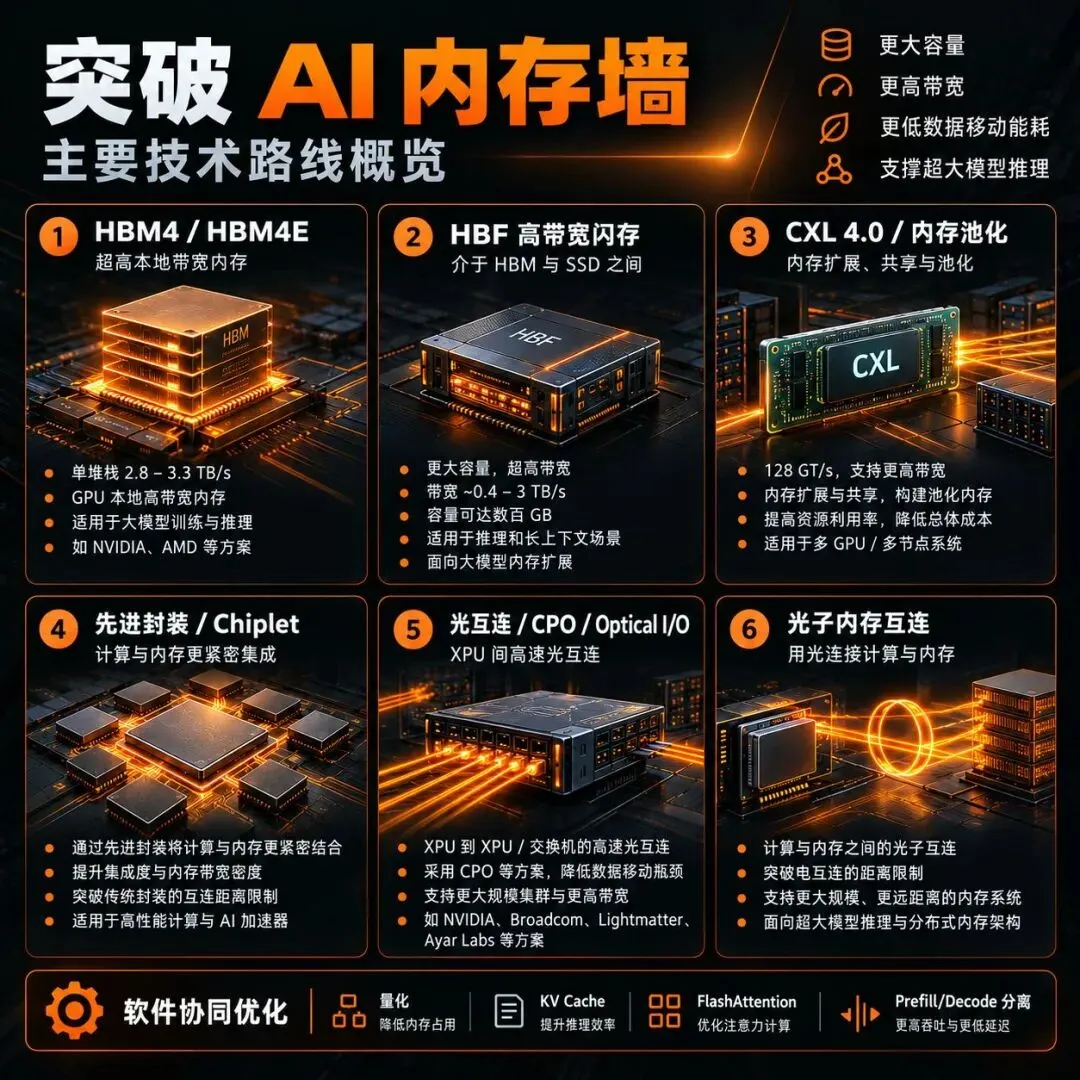
截至 2026 年,一个明显趋势已经形成:产业界不再试图依靠单一技术解决它,而是在同时推进 HBM、分层内存、CXL、先进封装、光互连以及软件优化。而 Volantis Semiconductor 公司的方案,则是另辟蹊径的创新——直接用光连接计算芯片和大规模内存。
一、AI 的“内存墙”已经不只是 DRAM 太慢
传统计算机领域讨论 Memory Wall,主要指 CPU 运算性能增长速度远高于 DRAM 访问性能。
到了 AI 时代,这个概念已经扩展成至少三个问题。
第一个是带宽墙。GPU 拥有极高的矩阵计算能力,但必须持续获得模型参数才能保持这些计算单元满载。尤其在低 Batch、大模型推理场景下,算术强度并不高,性能往往直接受制于每秒能够读取多少模型数据。
第二个是容量墙。模型权重之外,还有不断增长的 KV Cache。上下文从几万 token 扩展到数十万甚至百万 token 后,每个用户会占用更多内存;多个 Agent 同时运行,又会进一步扩大内存需求。一项 2026 年的 LLM 推理 I/O 综述指出,大模型推理的主要数据流已经可以分成模型权重、KV Cache 和 Activation 三类,瓶颈越来越多地出现在整个 memory hierarchy,而不仅仅是计算本身。
第三个则是距离墙。HBM 可以提供巨大带宽,但必须非常靠近 GPU。高速电信号的距离越长,信号完整性、SerDes 功耗和延迟问题越明显。因此,“内存能不能放得下”逐渐变成“高速内存还能在处理器周围放多少”的物理问题。
换句话说:
AI 的 Memory Wall 正逐渐演变成 Data Movement Wall——数据移动墙。
二、第一条路线:继续把 HBM 做得更快、更宽
目前最成熟、也是最直接的路线仍然是 HBM。
NVIDIA Vera Rubin GPU 已采用 HBM4,每颗 GPU 配置最高 288 GB HBM4,内存带宽达到 22 TB/s;与此同时,AMD Instinct MI455X 则达到 432 GB HBM4 和 23.3 TB/s。仅仅几年前,单 GPU 数 TB/s 已经被视为非常高的内存带宽,现在这个数字正在向 20 TB/s 以上发展。
HBM4 本身也发生了架构变化:接口从上一代 1024 bit 扩展到 2048 bit。Micron 当前 HBM4 单堆栈带宽已经超过 2.8 TB/s;Samsung 公布的 HBM4 则最高达到约 3.3 TB/s。
下一阶段甚至已经来到 HBM4E。SK hynix 在 2026 年 6 月开始向主要客户提供 12 层 HBM4E 样品,其单引脚速度最高达到 16 Gb/s,同时宣称能效较前代继续改善超过 20%。
所以 HBM 并没有走到终点。
但它面临的问题也越来越明显:更高堆叠、更宽接口、更复杂 Base Die 和更先进封装,会同步增加制造成本、封装难度和散热压力。
因此,HBM 很可能仍然是最快的“第一层内存”,却不一定能够独自承担未来整个 AI 内存体系。
三、第二条路线:在 HBM 和 SSD 之间增加新的内存层
2026 年一个值得关注的新方向是 HBF——High Bandwidth Flash,高带宽闪存。
SK hynix 和 Sandisk 在今年已经通过 Open Compute Project 推出了首个 HBF 技术规范。其思路并不是用 NAND 取代 HBM,而是在 HBM 和 SSD 之间创造一个新的层级:
比 HBM 容量大得多,同时又比传统 SSD 更靠近计算单元。
目前公布的规格最高支持 512 GB,带宽等级从约 0.4 TB/s 到 3 TB/s,并采用 UCIe 与 CPU/GPU 等处理器连接。
这条路线尤其适合推理。
训练通常非常重视写入速度和极高带宽,而推理过程中,大量模型权重本身相对稳定,更多是反复读取。因此未来一个 AI 加速器完全可能拥有这样的层级:
SRAM → HBM → HBF → CXL Memory → SSD。
不再追求“所有数据都塞进最贵的 HBM”,而是按照数据访问频率进行分层。
这其实是一个很重要的变化:
突破 Memory Wall 不一定意味着制造一种无限大的超级内存,而可能是把不同类型的内存组织成一个智能层级。
四、第三条路线:CXL 把“本地内存”变成“内存池”
如果说 HBM 解决的是 GPU 身边的高速内存,那么 CXL 解决的是更大范围的内存扩展和共享。
2025 年发布的 CXL 4.0 已经把链路速度从 64 GT/s 提升到 128 GT/s,增加 Bundled Ports,并继续强化内存共享、池化和 RAS 能力。2026 年的 CXL 产业活动也已经直接把“Beyond the Memory Wall”作为 AI 推理的重要应用场景,重点讨论 Memory Pooling、Memory Sharing 和 KV Cache Offloading。
它提供的思路是:
过去:
GPU A 有自己的内存,GPU B 有自己的内存。
未来:
多个 CPU/GPU 可以访问一个更大的共享内存池。
这样可以缓解“某张卡内存不足、另一张卡却闲置”的资源碎片问题。
但 CXL 本质上解决的是容量、共享和资源利用率问题,其延迟和带宽仍很难真正达到本地 HBM 水平。因此它更可能成为 HBM 的补充,而不是替代。
五、第四条路线正在迅速升温:让光进入 AI 系统
当高速电互连开始受到距离和能耗限制以后,一个越来越明确的答案就是:
光。
过去数据中心中的光通信主要发生在交换机、服务器甚至机柜之间。
但现在光正在逐渐向芯片靠近:
Pluggable Optics → On-Board Optics → Near-Package Optics → Co-Packaged Optics → Optical I/O。
2026 年,这个趋势明显加速。
NVIDIA 已经把 Spectrum-X Ethernet Photonics 引入 Vera Rubin AI Factory,CPO 光引擎直接与交换 ASIC 集成,其 Spectrum-X Photonics 系统最高达到 409.6 Tb/s 的交换带宽。
Broadcom 的 Tomahawk 6 Davisson 已经把 102.4 Tb/s Ethernet Switch + CPO 做成产品;Lightmatter 则在 2026 年推出 Passage L20,单模块双向分别达到 6.4 Tb/s,并展示了 1.6 Tb/s per fiber 的 DWDM 光互连。
Ayar Labs 今年也加入 NVIDIA NVLink Fusion 生态,并与 Wiwynn 展示面向 AI Scale-Up 的光连接 Rack。其技术重点同样是把光学 I/O 从传统网络端口推进到 XPU 封装附近。
另一个颇有象征意义的事件,则是 Marvell 在 2026 年完成对 Celestial AI 的收购。Celestial AI 的 Photonic Fabric 原本就是围绕 AI Scale-Up 和未来 Memory Fabric 构建的,Marvell 明确表示,其长期应用还包括 pooled memory appliances 和用光替代传统 die-to-die 电互连。
这说明光互连正在从实验室技术逐渐进入 AI 基础设施主流路线图。
六、Volantis 更激进:不是用光连接 GPU,而是用光连接内存
在这些公司中,Volantis Semiconductor 的路线尤其值得注意。
Lightmatter、NVIDIA、Broadcom 和目前的 Ayar Labs 主要首先解决的是:
XPU ↔ XPU、XPU ↔ Switch
之间的 Scale-Up / Scale-Out 互连。
而 Volantis 更直接瞄准:
Compute ↔ Memory。
Volantis 把自己的技术称为 Photonic Wires。它的出发点非常简单:传统高速电互连在 interposer 上通常只能有效延伸数毫米,而其光波导目标可以达到 200 mm 以上,因此 Memory Chiplet 不需要全部紧贴计算芯片排列。公司宣称,其架构可以连接超过 220 个 Memory Chiplet。
Volantis 采用大量 Micro-VCSEL 和大量并行低速光通道,而不是传统通信系统中较少数量的超高速 SerDes。其公开指标包括 24 Gb/s 每 lane、数万条 lane、总带宽超过 200 TB/s、低于 1 pJ/bit 和低于 5 ns 延迟。这些数字目前主要来自公司自身测试和产品披露,仍需要未来量产系统验证。
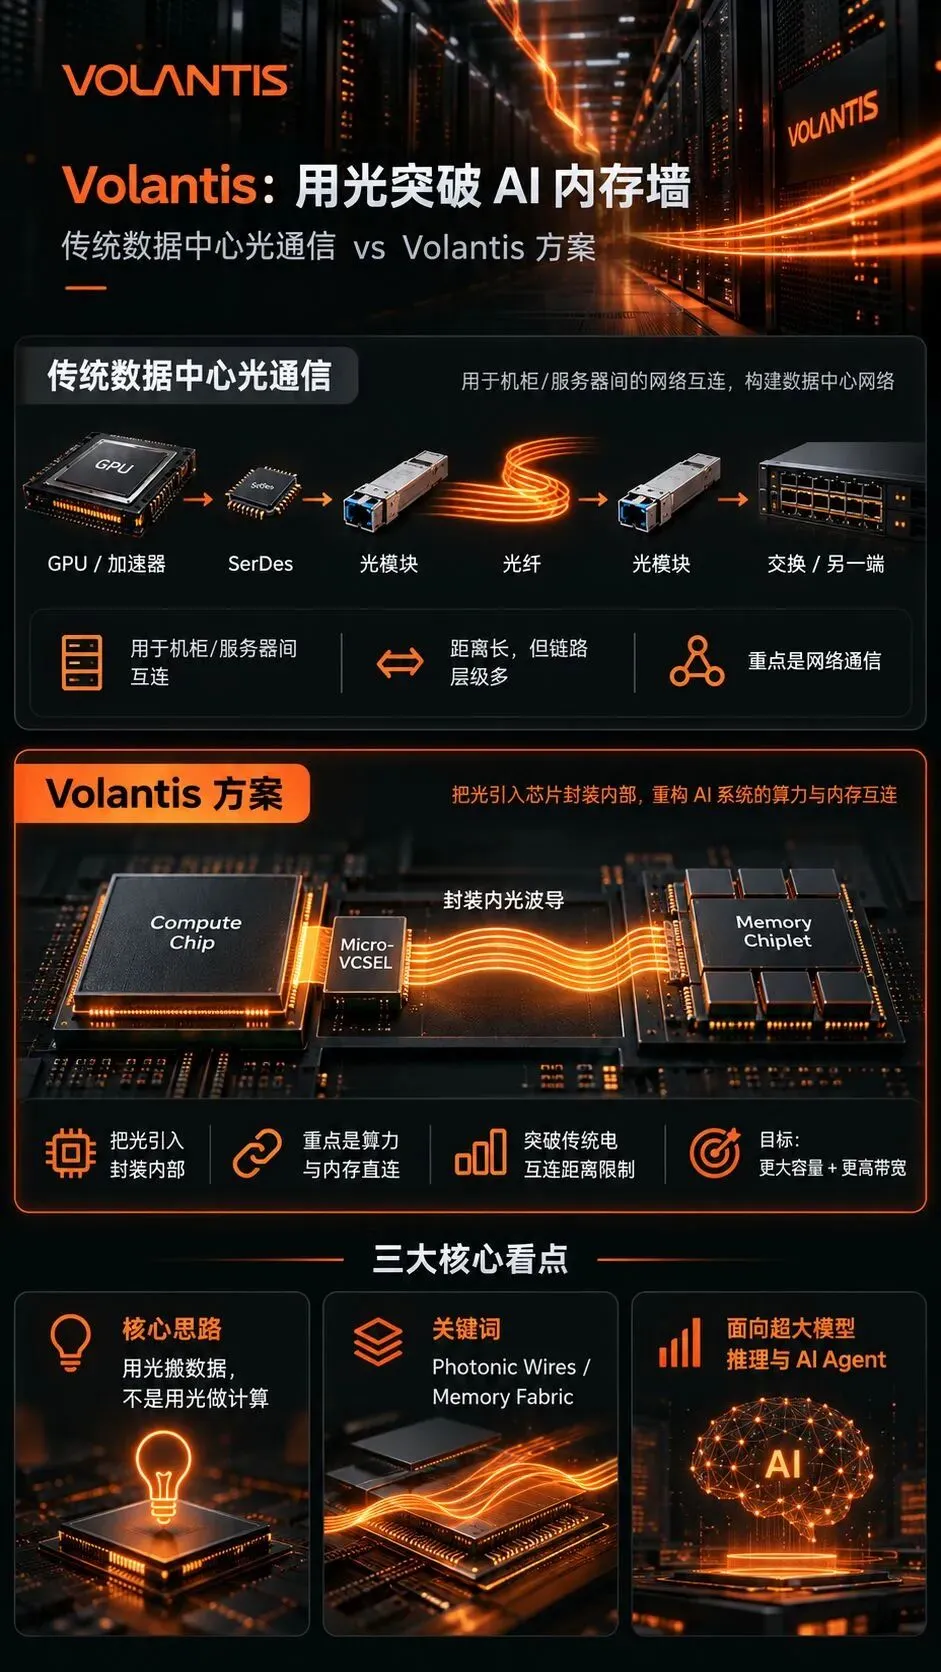
Volantis 的做法:Compute Chip → Micro-VCSEL → 封装内部光波导 → Memory Chiplet
其第一代 A-1 更进一步给出了系统目标:
Volantis A-1 官方公布的规格为 10 TB 内存、240 TB/s 内存带宽、10 TB/s Off-wafer I/O、20 kW、15U。更值得注意的是,公司第一代产品并不准备重新发明所有 AI 计算单元,而是采用已经 silicon-proven 的外部 Compute IP,把技术风险集中在光互连和内存架构上。
如果它最终能够工程化,那么意义并不是“又出现了一块比 GPU 更快的 AI 芯片”。
真正变化的是:
内存不再必须围绕 GPU 摆放,而可能通过 Photonic Memory Fabric 变成一个面积大得多的高速内存系统。
七、软件同样是突破 Memory Wall 的重要部分
硬件之外,AI 软件正在做另一件事情:
尽量少搬数据。
量化把 FP16/FP8 权重进一步压缩到 INT8、INT4 甚至更低精度;FlashAttention 减少 Attention 在 HBM 与片上 SRAM 之间的数据往返;PagedAttention 改善 KV Cache 的内存碎片;Prefix Cache 避免重复计算公共上下文;KV Cache 压缩和 Offloading 则尝试把低频数据移到更便宜的内存层。
越来越流行的 Prefill / Decode 分离同样与 Memory Wall 有关:Prefill 通常更偏计算密集,而 Decode 更容易受内存带宽限制。将两种负载拆到不同硬件池,实际上就是根据不同的 Compute-to-Memory 比例重新组织数据中心。2026 年的研究综述已经把量化、FlashAttention、PagedAttention、KV Cache 压缩、Offloading 和 Disaggregated Prefill-Decode 放在同一个 memory/I/O 优化框架内讨论。
因此,未来很难存在某一种硬件单独“消灭”内存墙。
八、AI 架构正在从“计算中心”走向“数据移动中心”
从 2026 年的产业变化来看,一条技术脉络已经非常清晰:
过去提升 AI 性能主要依赖:
更多晶体管 → 更多计算单元 → 更高 FLOPS。
接下来越来越重要的是:
HBM4/HBM4E → 分层内存 → CXL → Chiplet → CPO → Optical I/O → Photonic Memory Fabric。
其中 HBM 解决最近的一层,HBF 和 CXL解决容量扩展,CPO解决大规模计算节点之间的数据移动,而 Volantis 代表的下一步,则是在尝试把光进一步推进到计算与内存之间。
Volantis 的方案和产品值得关注。它并不是在与 NVIDIA 比谁拥有更多 Tensor Core,而是在挑战一个更加基础的问题:
一个 AI 处理器究竟应该能够“看到”多少内存?这些内存又应该以多高的速度被访问?
未来的大型 AI 系统很可能不再是一颗 GPU 加几颗 HBM,而会逐渐演化为:
Compute Chiplets + HBM + HBF + CXL Memory + Optical Fabric + Storage
共同组成的多层数据系统。
届时,衡量 AI 基础设施的关键指标,也不会只有 FLOPS。
Memory Capacity、Memory Bandwidth、Interconnect Bandwidth、pJ/bit、Latency,以及每个 Token 所需要移动多少数据,将与算力本身同样重要。
从这个意义上说,下一轮 AI 芯片竞争的核心,或许正在从:
“谁算得更快”
转向:
“谁能以最低能耗,把最多的数据最快送到计算单元。”
而这,才是今天产业界真正意义上的——突破 AI 内存墙。