ARTICLE · 1114787
AI 编程越快,安全越要前置:让团队放心 Vibe Coding 的四道闸
开篇先说立场:AI 编程 / Vibe Coding 是确定性的大势,我自己每天都在用。讲安全合规不是要你别用。恰恰相反,把这道关把住了,你才敢放开手,让全队放心用。安全合规是安全带,不是刹车。
一、提效讲得震天响,安全没人愿意讲
前面三篇,我讲了乱象,也讲了架构和管控。这一篇,我想专门讲一件绝大多数人刻意回避、但最可能让你"一夜回到解放前"的事——安全与合规。
为什么说刻意回避?因为讲提效多爽啊,画面都是"十倍工程师""一个人顶一个团队",大家听了就像打鸡血一样,兴奋的不行。一讲安全,全是刹车和约束,句句都是"这个不能干",特别扫兴。厂商不会主动跟你讲,讲多了工具不好卖。一线同学们更不愿意听,没人愿意被束手束脚。
但我认为,这章必须讲!这个专题我从一开始就说了:提效、可控、安全是个三角形。安全这条边塌了,另外两条边再长也毫无意义。
我先给你描述几个正在真实发生、而且一点都不新鲜的场景:
工程师为了让 AI 帮忙排查问题,把公司核心源码整段贴进公共大模型。连配置文件和带密钥的代码,都往里贴; 更隐蔽的是 9 月刚被实锤的 ZCode 事件。一款国产 AI 编程工具,被太原一家企业公开发函追责。客户端在用户没充分知情的情况下,静默把整个含 .git 的工作区上传云端,里面有完整源码、数据库口令、API 密钥。企业同时还在质疑数据出境的风险; AI 三秒钟生成一段依赖库调用,看着完美,里面却藏着一个已知高危漏洞。运气再差一点,它直接引用了一个被投毒的恶意包; 今年 4 月刚出了一个实锤事故。美国一家做汽车租赁系统的公司 PocketOS,工程师用 Cursor 里跑的 Claude 改测试库,卡在凭据不匹配上。Agent 没停下来问人,而是在不相干的文件里翻出一枚权限过大的 token,九秒钟删光生产库连同备份; 团队用 AI 改了一堆涉及用户隐私的逻辑。等监管来问"谁改的、审没审、数据怎么流转",没人能给完整答案。Git里有谁提交的、谁点的 approve、什么时候合入、什么时候上线,但是却不知道哪部分代码是AI写的,基于什么提示词生成的,上下文里有没有客户数据,过程中把什么内容发出去了。
这些话听着吓人,但都是当下每天都在发生的事。区别只在于:有的团队已经爆了,有的团队还不知道自己已经裸奔了。
二、为什么我对"安全"两个字格外敏感
讲风险之前,先交代一下我的背景,你就明白我为什么对这事近乎偏执。
我做过两个对安全合规要求极高的行业。
一个是金融。我在一家金融科技公司主导过开放银行相关产品,深度集成过多家股份制银行、民营银行和头部支付机构的底层账户与支付能力。我们的平台上跑着多个合作伙伴的实时分账、收支两条线、融合支付,日均交易额超过数千万。想想,这种系统对接的是银行的账户、是真金白银。一次越权,或者一笔错账,后果你敢想吗?在金融领域,安全和稳定是一票否决的。功能可以晚两天上,安全的口子一个都不能有。
另一个是医疗。我在一家智慧医疗科技公司任职技术副总裁,做的产品是智慧病房。我们的智能设备能够 7×24 小时采集患者的心率、呼吸率、呼吸节律、姿态、行为等这些生命体征,部署在上海某顶级三甲医院,还要走医疗器械注册的认证路径。患者数据是最敏感的个人信息,医疗器械更不一样,它要对生命负责,要过严格审评,而且全程可追溯。这逼着我养成一种本能:每一个环节都要可审计、可追溯、责任到人,出了问题必须能完整复盘。
AI 编码是最近几年刚出现的,但我可以很负责地告诉你:AI 编码今天遇到的这些安全合规问题,金融和医疗等行业在很多年前就用成熟的工程体系回答过了。最小权限、纵深防御、事前拦截、全程留痕、审计追溯。这些原则穿越行业,也穿越技术周期,一个字都不会过时。把它们搬到 AI 编码上,就是降维打击。
三、三大风险,一个比一个隐蔽
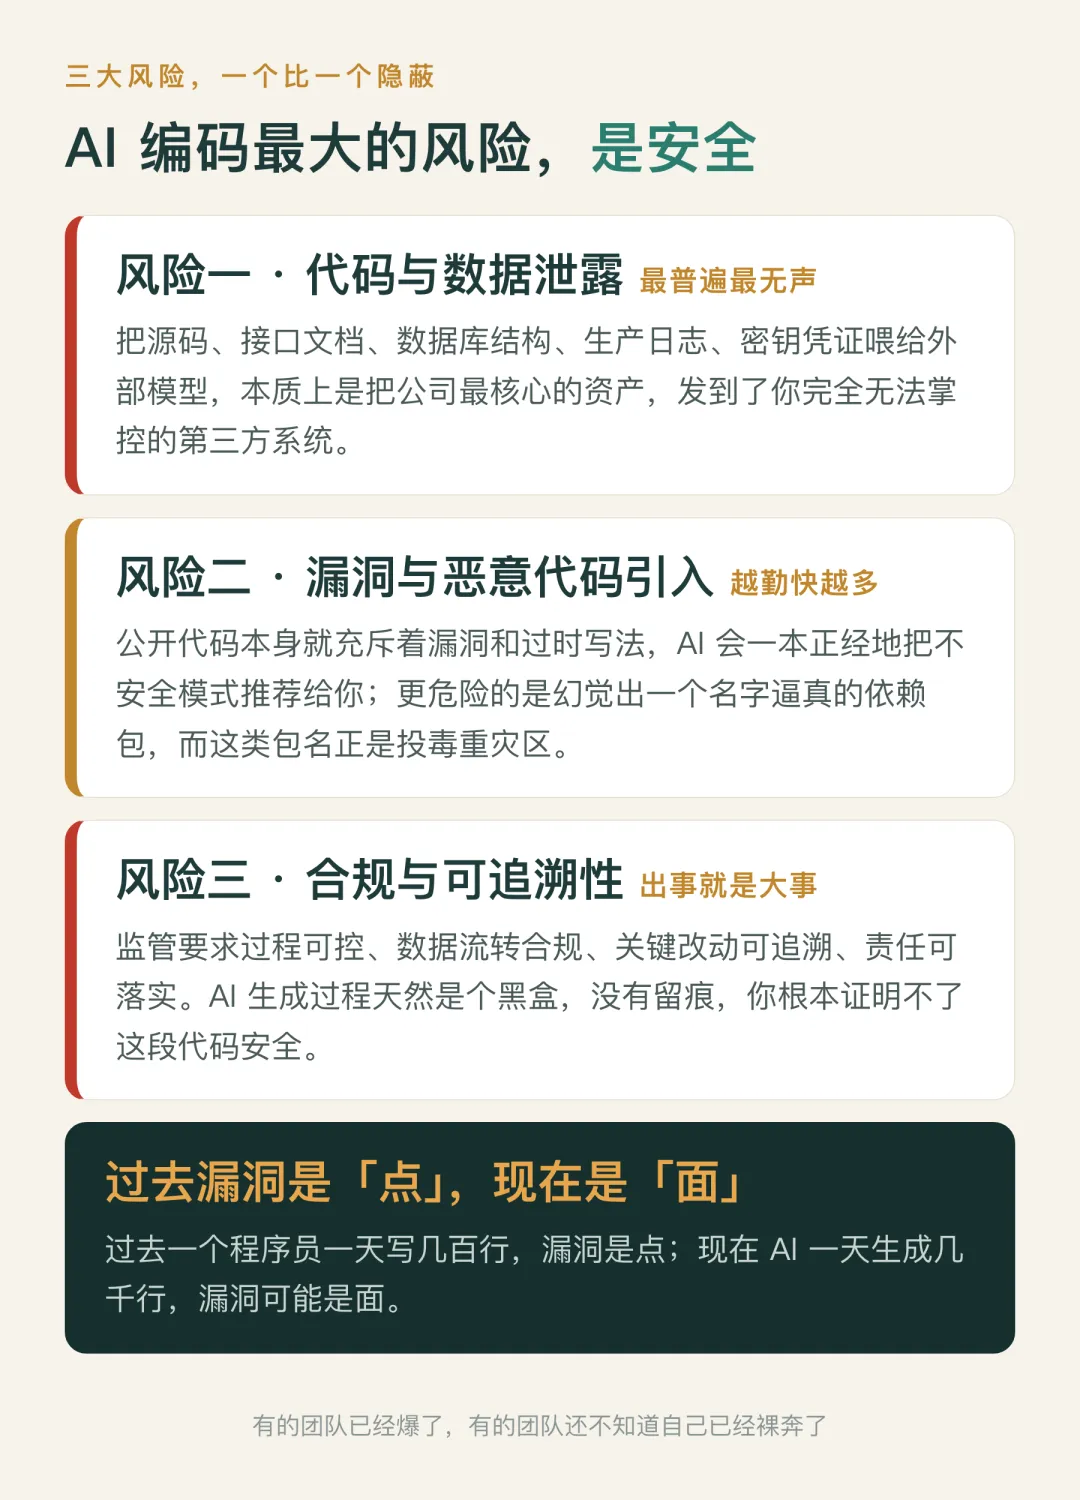
我把 AI 编码的安全风险归成三类,你可以对照着自查。
但读到这儿,你可能安慰自己:"这些也就是个别团队运气差吧。" 我必须把这个误判纠正过来。CloudBees 2026 年 5 月的调研(延君晨 @ Dify 在 2026 年 6 月 Agentic AICon 上海引用)显示:81% 的企业技术负责人报告,AI 生成的代码在生产环境出过事故。这跟"别人运气差"没关系,八成的团队都在裸奔,靠"小心点"就是赌运气,赌不起。所以这件事不能靠个人纪律,必须做成默认开启、关不掉的能力。第四节我会给你四道闸,把这道关焊进流程,而不是指望每个人时刻清醒。
风险一:代码与数据泄露(最普遍、发生得最无声)。
这是眼下最高发的。你把源码、接口文档、数据库结构、生产日志、密钥凭证喂给外部模型。说白了,就是把公司最核心的资产,发送到了你完全无法掌控的第三方系统。这些数据可能被拿去训练模型,也可能被缓存下来。还有一种更麻烦的:供应商自己出了安全问题,你的数据跟着一起泄露。
而且这事不只是"你主动贴"这一种形式。9 月的 ZCode 事件就是教科书式的案例。太原承明科技在独立取证后发函,说这款 AI 编程工具的客户端,在用户登录状态下静默打包上传整个工作区。里面是完整源代码、系统架构设计、Git 提交历史、数据库口令、云服务 API 密钥,甚至员工和客户的个人信息。一共 6 个工作区、三万多个文件、数亿明文字符,全部超出了它《隐私政策》载明的收集范围。
更要命的是,承明科技发现客户端请求指向的是境外主体,直接质疑数据出境,已要求对方 10 月 10 日前书面答复。智谱随后紧急上线了"数据不留存"功能。到 9 月 21 日,厂商正式回应:问题源于一个默认开启的"代码库索引"功能,用途是自动生成仓库文档,相关机制已修复,并引入中国信通院开展第三方安全审计。
你看,从用户取证、发函到厂商整改,恰恰说明这件事的性质有多严重。你根本没主动贴任何东西,但整个代码库已经在你没充分知情的情况下出去了。.git 目录里有什么?有完整的提交历史、有分支信息,还可能有曾经提交过又删掉的密钥和配置。这是数据主权的红线,比主动贴代码严重得多。
很多人根本没意识到这有多严重,觉得"我就贴了个函数"。但技术泄露往往就是从一个个"不起眼的片段"开始的。有心人能从碎片里拼出你的整个系统架构和业务逻辑。在金融和医疗,数据出域是红线中的红线,碰了就是事故。
风险二:漏洞与恶意代码引入(AI 越勤快,风险越大)。
AI 是基于海量公开代码训练的,而公开代码里本身就充斥着大量漏洞和过时写法。它会一本正经地把这些"看起来很对"的不安全模式推荐给你,SQL 注入、硬编码密钥、不安全的反序列化、权限校验缺失,应有尽有。更危险的是"供应链投毒"。AI 可能幻觉出一个根本不存在、但名字极其逼真的依赖包,而这类包名恰恰是黑客抢注投毒的重灾区。
AI 生成代码的速度越快、量越大,这些漏洞被引入的速度和数量就越大。过去一个程序员一天写几百行,漏洞是"点";现在 AI 一天生成几千行,漏洞可能是"面"。
这不是我吓唬人,学术界早就算过这笔账。最早 2021 年 IEEE 那篇被引烂了的研究,拿 MITRE 漏洞清单测 Copilot 生成的代码,约 40% 存在安全漏洞。后来有人直接分析 GitHub 真实生产仓库里 700 多个片段,29.5% 的 Python、24.2% 的 JavaScript都带着安全弱点。就算这两年模型进步,漏洞率从三成多降到四分之一左右,也意味着你每贴四段 AI 代码进来,平均就有一段可能带雷。
再加上 2026 年 3 月一篇大规模实证研究专门指出:AI 生成代码会把长期维护成本一并带进真实项目。你品品,写得越快,雷埋得越多。
风险三:合规与可追溯性风险(不出事没事,一出事就是大事)。
还有一类新风险,2026 年 9 月 17 日被安全公司 AIR Security 具名披露,代号 Plugin4Shell。它被称为 AI 编码 agent 插件生态首个供应链级漏洞,Claude Code、OpenAI Codex、Copilot 和 Gemini CLI,四大厂工具一个没跑。
它的机理特别值得研发管理者警醒。为防插件被篡改,行业本来用 SHA-pinning 把插件锁死在"审计过、不可变"的代码版本上。但 agent 拉取了锁定版本,却从不校验真正落地的代码是不是它。攻击者只要控制了插件仓库,就能让插件被掉包,而"安全锁"看起来完好。手法有两种:先传一个良性插件过审再投毒,或者直接劫持作者账号。再叠加 Claude Code、Codex 默认后台自动更新插件,整个攻击就是零点击。没有弹窗,也不需要开发者点任何"允许",后门自己就装进来了。
这说明什么?以前是你担心 AI 写的代码不安全,现在连"AI 自己用的工具"都成了攻击面。它同时击穿了两个我们习以为常的安全假设:一是"我锁了版本、审过的插件不会变",二是"危险操作会弹窗、我点了才执行"。JFrog 2026 年的数据更直白。约 36% 的 MCP server 和 agent skill 至少含一个安全缺陷,约 80% 的企业还没有 agentic AI 治理框架,公开仓库里已扫描出 969 个恶意 skill。所以插件绝不是装得越多越好。来源要走允许清单,非必要就关掉自动更新,给 agent 最小权限。这一点我在后面讲 MCP/Skill 时还会展开,本专辑的时效番外《四大 AI 编程工具同曝"零点击"漏洞》里有可直接落地的防护清单。
如果你所在的是金融、医疗、政务、出海这类强监管行业,这一条最致命。监管要求你的软件过程可控、数据流转合规、关键改动可追溯、责任可落实。但 AI 生成过程天然是个"黑盒"。你拿得出 Git 里那一截记录,却拿不出它之前的那一截:读了什么、发了什么、基于什么提示、用的哪个模型和插件。少了这一截,你依然无法向监管、向客户证明:这段代码是安全的、数据没被滥用、每一步都经过了审核。
合规这件事,说到底就一句话:你要能证明你做到了。拿不出证据,在监管眼里就等于你没做。我在医疗领域走医疗器械注册认证,最深的体会就是这一点。产品安不安全是一回事。你能不能用文档和记录"证明"它全程安全,是另一回事,而且后者往往更难。
这个风险最近又密集添了不少新案例。9 月 17 日同一天,Claude Code 连发两个版本,修的全是 MCP 传输漏洞、Bash 权限检查,还有一个"子代理输出可以被伪装成会话指令"的注入漏洞。换成大白话,你让 AI 装的第三方插件,可能反过来操控 AI 的判断。同一天 Google 把托管 Agent 关进了受控 Linux 沙箱里,才允许它改文件。
你把这几件事连起来看就明白了:头部厂商这段时间集体在补的课,全是权限、沙箱、审计这三件事。企业采购的门槛已经从"能不能提效"变成了"你敢不敢让它碰生产"。
刚进十月,又添两个实例,一个来自工具,一个来自论文。
先说工具。Claude Code 2.1.287,官方 Changelog 2026-10-01,全量 106 项变更。里面修掉的一个洞值得抄进检查单:危险 rm,也就是删 /或者 home 目录,本来一定会弹确认。但同一条命令里只要同时把输出重定向到 ~或者通配路径,这道 always-ask 保护就没了。
你注意看这个形状。不是它拦不住删根目录,是那道闸在特定写法下消失了。你的危险命令清单如果只登记了命令名,没登记命令的完整形态,这种口子一条都匹配不上。
再说论文。Meta 那篇上下文语言模型的工作,arXiv 2609.37725,发布日 2026-09-29,在自己的安全章节里警告了一件事:模型可写的上下文,是 prompt injection 跨轮持久化的新位置。以前的注入是骗一次,现在能一直住下去。
论文给的对策就两条,edit auditing 与 rollback。翻成团队能落地的话:凡是模型能写的地方,都要能查出来是谁在什么时候写的,而且要能退回上一版。
四、四道防线,把安全做成"默认开启、关不掉"的底层能力
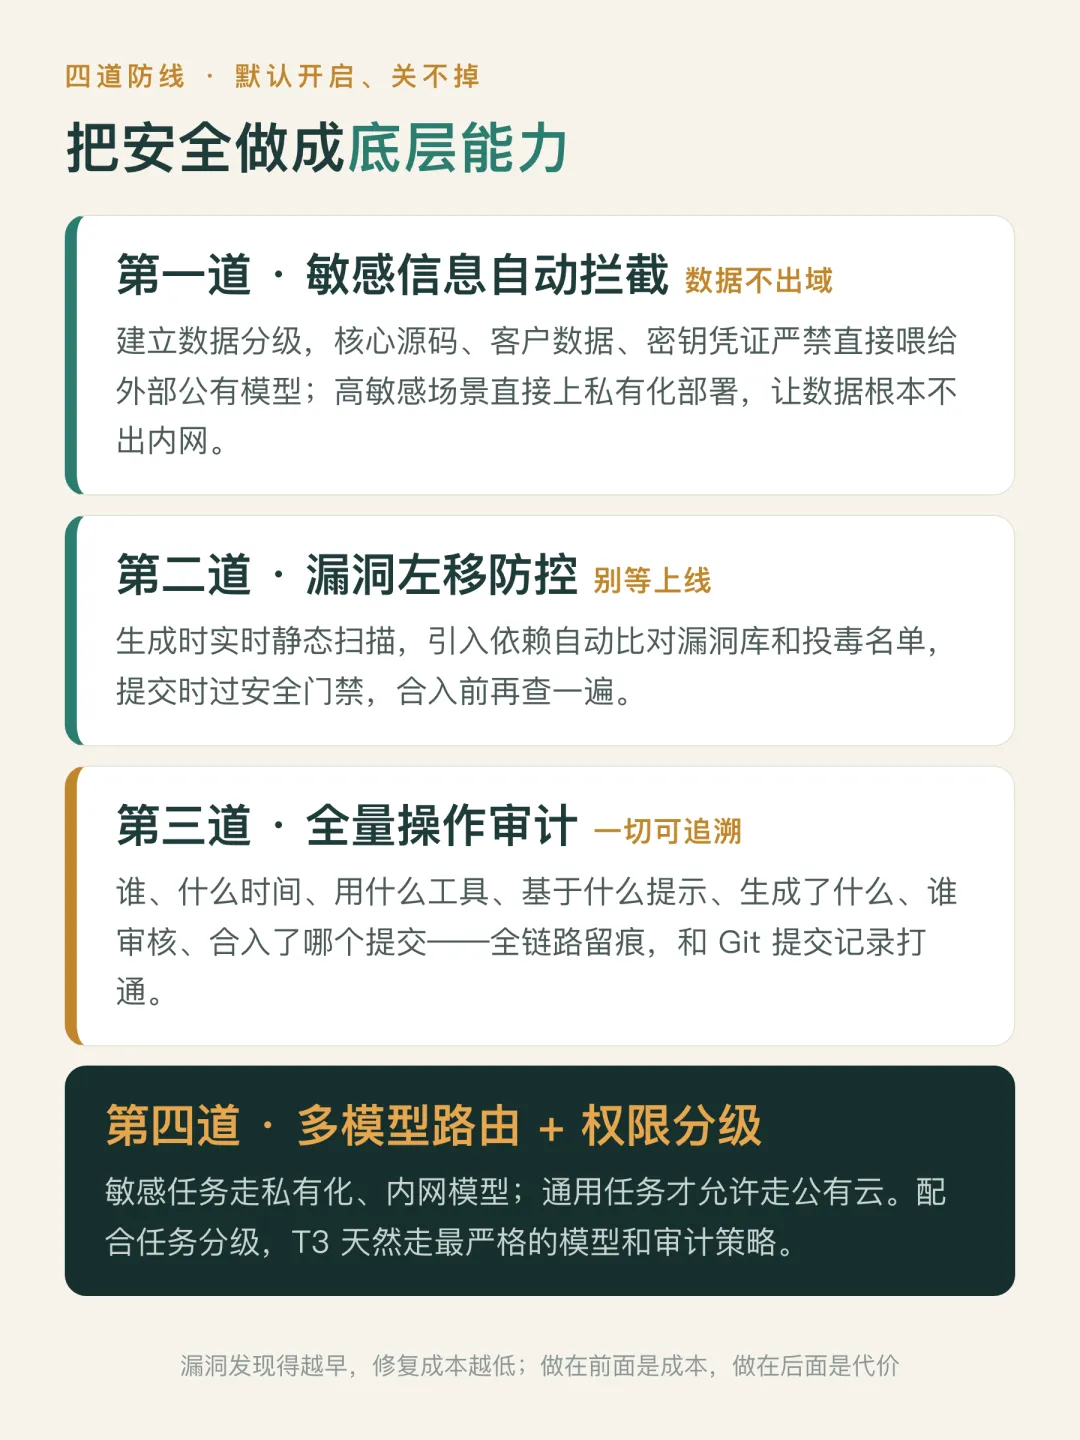
风险讲完,给方案。注意,安全治理不是买一个安全工具就完事。它必须像我在七层架构里强调的那样,横向贯穿每一层,成为一种默认开启、无法关闭的底层属性。我给你四道防线。
第一道:敏感信息自动拦截(数据不出域)。
在数据离开你的环境之前就拦住它。先建立数据分级:哪些是公开信息、哪些是内部资料、哪些是核心源码和客户数据、哪些是密钥凭证。后两类严禁直接喂给外部公有模型。落地上,靠工具在网关层、IDE 插件层做自动识别和拦截。检测到密钥、身份证号、患者信息、核心代码片段,直接阻断并提示。高敏感场景,直接上私有化部署或企业级合规版本,让数据根本不出内网。原则就一条,跟金融一样:数据分级、最小授权、默认最小化。
第二道:漏洞左移防控(别等上线才发现)。
这是我最想强调的一条,也是我从一家头部门户公司的反作弊实践里学到的最值钱的经验。我加入时系统已经有了初版,我参与推进的最有价值的一个变化,就是把识别能力前置到广告服务的最开始,在入口就拦作弊流量,彻底摆脱了"事后堵漏"的被动。安全防护一模一样:漏洞发现得越早,修复成本越低,呈数量级下降。
所以要把安全扫描嵌进 AI 编码的全流程:生成代码时尽量实时做 SAST 静态扫描,引依赖时就自动比对漏洞库和投毒名单,提交时必须要过安全门禁。别指望上线前的渗透测试兜底,那时候木已成舟,修复代价是编码阶段的几十上百倍。
第三道:全量操作审计(一切皆可追溯)。
谁、在什么时间、用什么工具、基于什么提示、让 AI 生成了什么、最终谁审核、合入了哪个提交,这些全部留痕,并且和 Git 提交记录打通。注意,Git 不是被替代掉,它是这条链的最后一环——缺了它,前面记再多也对不上最终落地的那行代码;只有它,又补不上前面那一截。这一条直接回应合规要求。出了问题能复盘,监管来了能举证。责任链条清清楚楚。这就是医疗、金融行业"可审计、可追溯"原则在 AI 编码上的直接落地。记住,没有日志的安全,等于没有安全。
第四道:多模型智能路由 + 权限分级(不同的活,走不同安全等级的路)。
不是所有任务都需要同一个模型、同一种部署方式。敏感任务走私有化、内网模型;通用、不敏感的任务才允许走公有云模型。通过智能路由,按任务的密级和风险自动选择合适的模型通道,既保安全又不浪费成本。再配合第 3 篇讲的任务分级,T3 高风险任务天然要走最严格的模型和审计策略。
为什么这四道闸必须是系统能力,而不是贴在墙上的纪律?因为靠人自觉是不可能防住系统性风险的。腾讯张栋(2026 年 6 月 Agentic AICon 上海)讲过一个判断:能读敏感数据、会接收不可信内容、能对外通信,三者同时具备就必然泄密。这就是"致命三件套",而框架层只要切断其中一条就能防住。他还有句话我记到现在:"Prompt 不是边界,工具调用路径才是边界"。别指望靠写个好提示词防住泄露,要卡的是它能不能真的去读、去发。
五、给技术负责人的一句心里话
我知道,看到这儿你可能觉得"太重了,小团队哪搞得起"。
别被吓到。安全合规这东西,工具全不全不是关键。关键是意识,是那几条不能碰的红线。哪怕你是十个人的团队,先做三件零成本或低成本的事,就能挡掉绝大多数风险:
- 立刻立 L0 红线
:生产数据、密钥、客户隐私、核心源码,禁止贴进任何公共大模型。违者按事故处理; - 开一个动作
:AI 生成的代码,提交前必须过一遍免费的静态扫描和依赖漏洞检查; - 建一本台账
:用 Git 记录和简单的流程,保证每段 AI 代码有人审、责任有人担。
就这三件,先做起来,你就已经跑赢 90% 裸奔的团队了。剩下的私有化部署、智能路由、全链路审计不用急。随着团队规模和业务敏感度提高,再逐步补齐。
安全合规这件事,做在前面是成本,做在后面是代价。成本是你能预算、能控制的。代价,往往是你承受不起的。这是我在两个强监管行业摸爬滚打出来、最想送给你的一句话。
安全合规这件事,做在前面是成本,做在后面是代价。
下一篇,我们从"防风险"转向"怎么落地":《研发团队 AI 转型,我建议你分三阶段走,稳落地不抵触》。