ARTICLE · 1121026
文档都上传了,AI 为什么还在胡说八道?
你大概还记得 2024 年 5 月那场全网群嘲:有人问谷歌 AI 搜索摘要"披萨上的芝士不粘怎么办",AI 一本正经地回答——"往酱料里加约 1/8 杯无毒胶水。"
而答案的出处,是 Reddit 上一条十多年前的玩笑帖。AI 把玩笑当成了权威知识。
大公司、顶级团队、全球级产品,照样胡说八道。到了企业里,这个病更日常:产品手册、技术文档、FAQ 全部上传了,问它保修政策,它答一条库里根本没有的规定;问它报销流程,它张口就是一个不存在的条款。
这不是玄学,也不是模型太笨。你的 AI 有一个"胃"——RAG 系统,负责把文档"吃进去"、消化成它能用的知识。它胡说八道,不一定是脑子的锅,多半是胃的锅。谷歌那次的病根:垃圾内容混进了知识库(环节 1),检索还偏偏把它排到了最前面(环节 5)——下面逐个环节拆给你看。
01 先复习:胃是怎么工作的 🍚
大模型(LLM)是大脑皮层,负责"想"。但它有个天生的毛病:训练数据有截止日期,而且没见过你公司的内部文档。
所以工程师给它接了一个"胃"——RAG(检索增强生成):先从文档库里捞出相关内容,再塞给大脑"开卷考试"。
但注意:胃不是保险箱,是一条流水线——吃进文档 → 切成小块 → 存进胃里 → 捞出几块 → 喂给大脑。
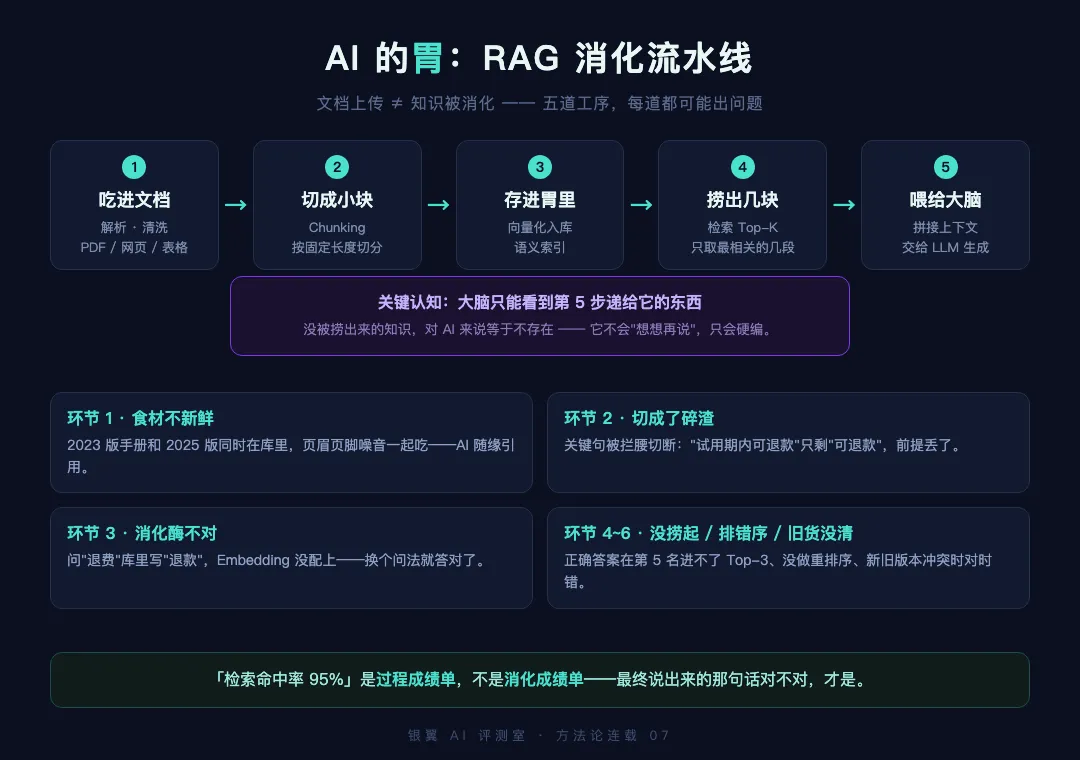
▲ RAG 消化流水线:文档上传 ≠ 知识被消化,大脑只能看到最后一道工序递给它的东西
最关键的一条认知:没被捞出来的知识,对 AI 来说等于不存在。它不会"想想再说",只会硬编。
02 胃病的六个环节:每一个都会让它胡说八道 🩺
环节 1 · 食材不新鲜——文档本身就是脏的
症状:AI 引用过时的政策、废弃的产品版本、互相矛盾的数据。
手册是 2023 版、最新版是 2025 版;文档 A 说"退款 7 天"、文档 B 说"退款 30 天";页眉页脚、目录、表格碎片这些噪音也被一起吃了进去。AI 不会帮你判断哪份更新、哪个对——检索到什么就用什么,两份矛盾就随机挑一个,或者揉在一起说。
怎么修:上传前清洗(去页眉页脚、去重复)、给文档打时间戳和版本号、矛盾处人工标注哪份有效。
专业修法:这条要做成一条"预处理流水线",不是手动打扫——① 格式解析层:扫描件先过 OCR 并做置信度抽检(OCR 认错的字就是未来的错误答案),PDF 表格用专门解析器还原结构,而不是拍扁成乱码;② 元数据层:每篇文档入库时写入版本号(version)、生效日期(effective_date)、来源(source)三件套,检索时可直接按元数据过滤——比如"只查 2024 以后的制度";③ 冲突检测层:同主题文档入库前做一次语义比对,发现冲突就转人工仲裁,仲裁结果决定旧版本"下线"还是"归档"。行业里翻车最狠的恰恰是这一步没人做——库里的"正确答案"和真实政策是两套(后文的加航判例就是它)。
环节 2 · 切错了——一篇文章被切成碎渣
症状:回答断章取义,前半句对、后半句错。
这是 RAG 最常见的技术问题:分块(Chunking)切得不对。就像吃牛排,切成 1 毫米的丝——AI 检索到的可能只是"可退款"三个字,而完整上下文是"试用期内可退款"。前提丢了,它就会说"随时可退款"。切太大也不行:关键信息被淹没在无关内容里。
怎么修:按语义切,不要按固定长度硬切;块与块之间留重叠(overlap);表格、代码、列表不要切碎。
专业修法:① 切块参数:常见起点是每块 300–500 token、块间重叠 10–20%(overlap),在这个基础上按业务文档实测调参——没有万能数字,只有"对你的文档最优"的数字;② 结构感知:按标题层级和段落语义切,永远不要把表格、代码块、条款列表拦腰切断——法规类文档一条就是一块;③ 父子块检索(small-to-big):用小块做检索(匹配准),命中的把它的"父段落"喂给模型(上下文全)——这是工业界对付"断章取义"最有效的一招,正好治"只捞到'可退款'三个字"的病;④ 验证方法:随机抽 20 个回答,回查每个答案引用的原文块,看前提条件有没有被切丢——这个抽查半小时就能做完。
环节 3 · 消化酶不够——Embedding 没理解对意思
症状:明明问"怎么退款",检索到的全是"怎么发货"的内容。
Embedding(向量化)就是胃里的"消化酶",负责判断哪些内容意思相近。消化酶不行,就会出现:用户问"退费",文档写的是"退款"——字面不同、意思一样,但没配上对。
最快的排查法:换个问法再问一次。换个说法就答对了,说明是消化酶的问题,不是文档的问题。
怎么修:换更匹配业务语言的 Embedding 模型(不是越大越好)、加同义词词典、混合检索(向量 + 关键词一起上)。
专业修法:① 选型靠实测不靠榜单:从真实用户问题里抽 50–100 条,人工标出"正确答案在哪篇文档",用 MRR / Recall@k 两个指标对比候选模型——业务黑话多的领域,一个几百 M 的领域模型常常打赢通用大模型;② 查询改写(Query Rewriting):检索前先用 LLM 把口语问法改写成文档用语("钱退回来没"→"退款进度"),成本极低、收益立竿见影;③ 混合检索(Hybrid Search):向量检索(语义)+ BM25 关键词检索(字面)双路并行,用 RRF(倒数排名融合)合并结果——专治型号、编号、专有名词这种"向量很模糊、关键词一查就中"的场景;④ 同义词表:把行业黑话和官方术语的映射维护成词典,命中即扩写。
环节 4 · 点菜点错了——召回策略不对
症状:文档里明明有正确答案,AI 就是没检索到。
常见原因:相似度阈值设太高,正确答案被过滤掉;只召回 top 3,正确答案在第 5 条。排查法:拿同一个问题去知识库里手动搜一下,看正确答案排第几。
怎么修:调大召回数量、降低阈值先召回再筛选、加重排序。
专业修法:① 先测指标再调参:建一个 50 条的"金标问题集"(问题 + 标准答案所在文档),量出 Recall@5(前 5 条里有没有正确答案)——低于 85% 就先别谈别的,召回就是当前瓶颈;② 参数原则:宁滥勿缺:top_k 从 3 提到 5–10,相似度阈值先放开,让"漏掉的损失"交给后端重排兜——漏检是不可逆的(AI 根本没看见),多检只是干扰(重排能筛掉);③ 元数据路由:能按文档类型、产品线、时间范围先过滤的就先过滤,别让 10 万篇文档一起参战——缩小候选池本身就是最便宜的召回优化;④ 每次只动一个旋钮:调完跑一遍金标问题集,确认指标涨了再动下一个,否则你永远不知道是哪个改动起的作用。
环节 5 · 上菜顺序乱了——没做重排序
症状:检索到了 5 条文档,AI 用了第 4 条(错的),没用第 1 条(对的)。
先粗召回一堆"差不多相关"的文档,然后需要重排序(Rerank)把最相关的排到最前面。没做这一步,AI 就自己挑一条用——挑中的那个未必对。
怎么修:加 Cross-Encoder 做精准重排;在系统提示词里写明"优先使用排在前面的文档";控制喂给 AI 的文档数量,太多反而干扰。
专业修法:① 两段式检索是标配:粗召回拉 20–50 条(向量+BM25),再用 Cross-Encoder 重排模型(如 bge-reranker、Cohere Rerank 这类开源/商业 API)精排出 top 3–5 喂给大脑——Cross-Encoder 把问题和每条候选"逐字对读",精度远高于向量相似度,这是当前性价比最高的一次升级;② 引用纪律写进提示词:明确要求"只依据提供的资料回答,资料中没有就直说没有,禁止编造",并要求答案标注引用来源——有 citation 的答案才可校验,出了错能定位到具体文档;③ 上下文配额:喂 3–5 条最相关的,好过喂 10 条"差不多"的——长上下文会稀释模型注意力,无关内容每多一条,编造概率就升一分。
环节 6 · 吃了不该吃的——知识冲突和过期
症状:同一个问题,今天对、明天错。这是最隐蔽的一种,因为它不稳定复现。
原因:知识库里多版本文档并存、旧文档没删、外部数据更新了但向量库里还是旧的。排查法:同一个问题多问几次,时对时错,大概率是库里内容冲突。
怎么修:建更新机制(新文档进来,旧的自动标记或删除)、给文档加"生效时间"、定期清理向量库。
专业修法:① 文档生命周期管理:每篇文档带生效日期(effective_date)和失效日期(expiry_date)两个元数据,检索时默认过滤已失效内容——而不是靠"删得勤";② 增量同步而非一次性导入:知识库要和文档源(网盘、Confluence、官网)建自动同步管道,源端更新后向量库跟着更新,带上内容哈希去重——"文档源是唯一事实,向量库只是缓存"是这条的根本原则;③ 旧版本打标不删:旧版本从检索范围排除并标记"已作废"(superseded),但不物理删除——审计时还要查"当时的政策是什么";④ 漂移监控:把金标问题集设成定时重跑(比如每周一次),时对时错的病在报告里立刻现形。这也是为什么验收时测不出这类问题:它只在"上线之后、知识库变更之后"发作,验收永远测的是静态快照。
03 一张表:你的 RAG 胃出了什么问题?📋
收藏这张表,下次排查对着查。
04 这不是理论:还有两个真实判例 ⚖️
加拿大航空,赔了钱。2024 年,加航官网客服机器人告诉乘客丧亲票价"可以先订票、90 天内补申请"——实际政策不是这样。乘客起诉,加航辩称"聊天机器人是独立法律实体"被审裁处驳回,判赔约 650 加元(Moffatt v. Air Canada,BC Civil Resolution Tribunal,BBC、卫报均有报道)。
病根:环节 1——库里的"政策"和真实政策是两套。
纽约市政府,认了错。2024 年 3 月 The Markup 报道:纽约市官方企业服务机器人告诉雇主"拿走员工小费的一部分是可以的"——这在纽约市违法,政府随后承认"回答不正确"。
病根:环节 6 的近亲——吃进去的内容和真实规则冲突,胃不分对错,只管往外吐。
加上开头的谷歌胶水披萨(环节 1 + 环节 5),三个判例、三笔账,全是"胃"的锅。
05 写在最后 🧾
1. 文档上传 ≠ 知识被消化。从上传到能被正确引用,中间隔着六道环节,每一环都可能让它胡说八道。
2. 别急着换模型。胡说八道的根因大多在数据和检索——对照上面的表,先找器官再花钱。很多团队的第一反应是换更强的模型,其实八成的问题出在胃上。
3. 胃需要定期体检。知识库每天在变、用户问法每天在变——上线那天测一遍是不够的,要像体检一样定期批量地测。这也是我们每天在做的事。
你的 AI 有没有过"知识库明明有,它就是说错"的时刻?对一下上面的表,评论区说说你是哪种胃病,我帮你判断。觉得有用,转发给那个正在骂模型的同事。
—— AI 胡说八道,不一定是脑子的锅,多半是胃的锅。——
银翼 AI 评测室 · 方法论连载 07
愿所有 Agent 都经得起 Voight-Kampff 测试。