ARTICLE · 1121016
喂了三千份文档,智能体还是答不对
RAG不是喂文档那么简单,数据治理才是的大头
一家阀门厂花八十万上了一套RAG知识库,三千份工艺文档喂进去,智能体回答问题准确率只有百分之三十七。原因不在模型在数据。
去年秋天,一家阀门厂花八十万上了一套RAG知识库。
三千份工艺文档、操作手册、质量标准全喂了进去。供应商演示的时候,准确率看起来不错,工人问什么它都能答上来。老板很高兴,说那就上线吧。
上线一个月后,问题暴露了。
工人问"这台泵的密封件怎么换",智能体从三千份文档里找到了十二份相关的,给出了一个综合答案。但这个答案里混了两家供应商的密封件型号,工人照着换了两只不同品牌的件,装上去之后漏油。
智能体没有说谎。它确实把相关内容都呈现了出来。但它不知道这十二份文档来自不同的供应商、不同的时代、不同的产品系列。
RAG能帮它找到答案,但找不到"这个答案适不适用这一台设备"。
很多人以为RAG就是"把文档喂给AI,AI就能回答问题"。这个理解太浅了。
RAG的本质是检索增强生成。它先从你的文档库里找到最相关的几段,然后把问题跟这几段一起送给大模型,让模型组织成一段回答。
问题出在"最相关"这三个字上。
向量检索找的是语义相似度,不是事实准确性。一份五年前的工艺变更通知和一份现行有效的作业指导书,可能在向量空间里距离很近,但它们的权威性完全不同。
智能体把两份文档的内容综合在一起,给了你一个看起来合理但实际执行会出问题的答案。
这不是RAG的缺陷,这是只用文档做判断的缺陷。
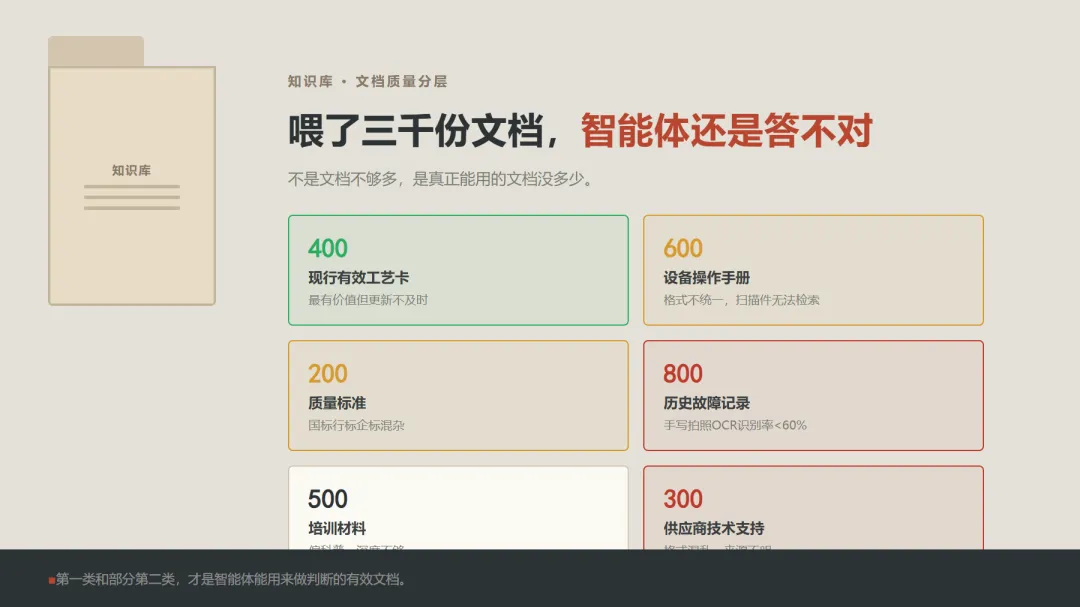
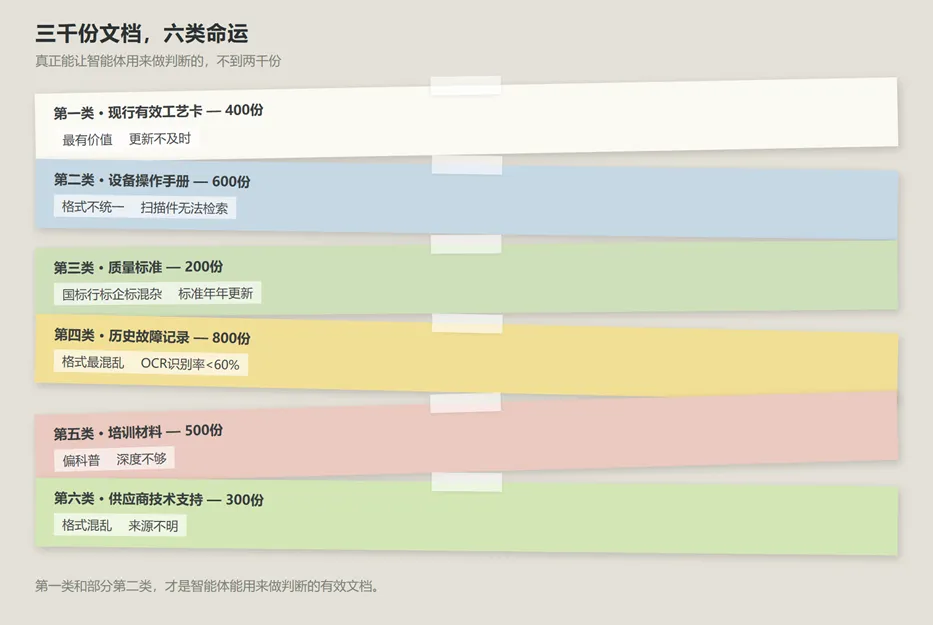
我让那家阀门厂把所有文档按类别分了一下。三千份文档,大致分成六类。
第一类,现行有效的工艺卡。大约四百份。这是最有价值的部分,但也是更新最不及时的部分——新工艺出了三个月,旧工艺卡还没撤。
第二类,设备操作手册。大约六百份。来自不同供应商,格式不统一,有些是PDF扫描件没法检索,有些是Word版本但图片里的文字识别不准。
第三类,质量标准。大约两百份。国标、行标、企标混在一起,而且标准年年更新,很多文档里的标准号已经作废了。
第四类,历史故障记录。大约八百份。格式最不统一,有的是表格有的是自由文本,有的只有结论没有过程,有的过程很长但结论模糊。
第五类,培训材料。大约五百份。内容偏科普,深度不够,但新人培训用得着。
第六类,供应商技术支持文档。大约三百份。格式混乱,来源不明,有些甚至是手写的照片。
这六类文档里,真正能让智能体用来做判断的,只有第一类和部分第二类。其余四类,智能体能检索到,但不能直接作为决策依据。
不是文档不够多,是真正能用的文档没多少。
那家阀门厂后来重新做了知识库建设,我陪他们走了一遍。踩过的坑总结如下。
第一个坑,向量数据库选型。市面上有十几种选择,Pinecone、Milvus、Chroma、FAISS、Weaviate。每种都有优劣。工厂场景最重要的是两件事:支持中文Embedding、支持本地部署。最终选了Milvus,因为对中文支持最好,而且可以完全本地化。
第二个坑,文档预处理。不是所有PDF都能直接扔进向量库。扫描件要OCR,表格要解析,公式要保留,图片要描述。那家厂的八百份故障记录,大部分是手写拍照的,OCR识别率不到百分之六十,相当于废了一半。
第三个坑,切片策略。文档不能整篇投进去,要切成片段。切多长合适?太短丢失上下文,太长引入噪声。我们试了五百字、八百字、一千字三个档,最后定了八百字,重叠一百字。
第四个坑,元数据过滤。光靠向量相似度不够,要加元数据过滤。每份文档打上标签:产品型号、适用设备、生效日期、来源部门。检索的时候先按元数据过滤,再在过滤后的结果里做向量检索。
第五个坑,增量更新。知识库不是一劳永逸的。新文档进来、旧文档作废、标准更新,都需要及时处理。那家厂最开始没有增量更新机制,上线三个月后就有四百份过期文档还在库里,拉低了整体准确率。
问三个问题。
第一个:你们的文档有多少是经过审核的?
如果它的回答是全部由供应商整理过,你要追问整理标准是什么。如果它的回答是由厂里技术人员审核后入库,那它在数据质量上站住了。
第二个:检索结果有元数据过滤吗?
如果没有,那它只是在所有文档里做语义搜索,准确率和可用性都很难保证。如果有,你要看过滤维度够不够——产品型号、设备、生效日期这三个至少要有。
第三个:知识库有增量更新机制吗?
没有增量更新的RAG系统,三个月后就会变成垃圾场。文档在积累,但过期文档没有清理,新员工文档没有及时入库。
这三个问题答不上来,不管演示效果多好,都不适合下厂。
其他的,聊过之后再讲。