ARTICLE · 1121021
RAG 知识库落地实操:企业内部文档 AI 问答,完整搭建步骤
但大量企业上线 RAG 项目之后,普遍遭遇同类问题:AI 回答过时、内容张冠李戴、检索到无关文档、长篇资料提取信息错误,投入人力整理文档,最后员工不愿使用。
RAG(检索增强生成)不是简单把文件上传到大模型。它是一套包含文档处理、向量存储、检索匹配、答案生成的完整工程体系。本文不讲复杂学术原理,输出一套企业可直接照搬的落地 SOP,覆盖从资料收集到上线调优全流程。
一、RAG 知识库适合哪些企业场景,哪些场景不适合
✅推荐落地场景
内部管理制度、人事行政、财务报销制度问答; 产品手册、技术规格、售后维修资料查询; 过往项目档案、投标资料、项目经验沉淀检索; 合同模板、风险条款、法务资料查阅; 培训课件、内部课程资料智能答疑。
❌ 不建议使用 RAG 的场景
需要实时动态业务数据(例如实时订单、实时库存,RAG 只处理静态文档); 强数学计算、实时数据分析; 高频变更、每日大量新增且来不及更新的业务数据; 非文本类素材(纯图片、扫描件无文字 OCR,需要额外前置处理)。
核心判断:静态文档、高频查阅、知识分散在大量文件里,就是 RAG 的最佳适用场景。
二、RAG 搭建完整五步 SOP
步骤 1:文档收集与范围划定
第一步最容易被忽略:先划定知识库边界,不要一次性上传全公司所有文档。
明确使用人群:是售后团队、销售团队还是全公司员工,按需收集资料; 文档筛选:剔除过期版本、草稿、重复文件、涉密未脱敏资料; 文件格式整理:优先使用 Word、Markdown、PDF 可复制文本;图片扫描件,需要先做 OCR 文字识别提取; 版本管控:同一文档保留最新版,旧版文档单独归档,禁止新旧文档同时入库。
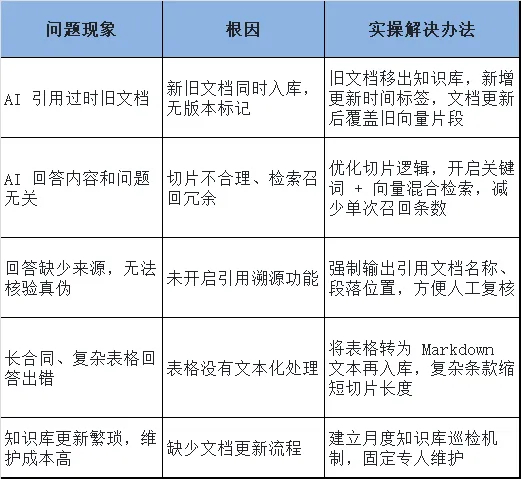
踩坑预警:很多企业直接全盘拖拽所有文件夹入库,新旧文档混杂,AI 经常调取废弃旧版本,这是 RAG 项目失败头号诱因。
步骤 2:文档清洗与预处理
原始文档存在大量无效内容,直接送入向量库会严重干扰检索效果。清洗清单:
删除页眉页脚、页码、水印、空白段落; 清理无关备注、修订痕迹、重复表头; 统一文档排版,拆分超长段落; 对表格做文本化转换,大模型很难直接识别原生表格; 敏感信息脱敏:手机号、身份证、客户隐私信息提前替换。
步骤 3:文本切片
切片是 RAG 效果的核心。切片就是把长篇文档切分成小段文本,用于向量检索。
切片长度选择:通用企业知识库推荐500-1000 字符;技术手册、合同条款建议缩短至 300-600 字符; 重叠窗口设置:片段之间保留 10%-20% 文字重叠,避免一句话被切断丢失上下文; 优先按语义切片,不要简单按固定字数粗暴切割。不要把一个完整业务段落强行拆成两段。
实操经验:固定字数切割是新手最常见错误,容易把完整逻辑语句拦腰截断,导致 AI 理解断层。
步骤 4:向量化入库,搭建向量知识库
选择嵌入模型:通用场景选用中文嵌入模型;专业技术文档,选用领域优化嵌入模型; 向量数据库选型:轻量化试点可以使用开源向量库,企业规模化部署可选用云原生向量库; 给片段增加元数据标签:给每一段打上标签 —— 文档名称、版本、部门、更新时间,方便后续溯源。
元数据的价值:AI 给出答案后,员工可以直接查看引用的原文来源,核验真实性。
步骤 5:检索策略配置 + 效果调优
检索方式:混合检索(向量语义检索 + 关键词检索)优于单纯向量检索,兼顾语义相似和专有名词匹配; 召回数量设置:单次提问召回 3-5 条相关片段,召回太多会混入无关内容; Prompt 约束:强制要求 AI 仅基于检索回来的文档作答,文档无相关信息时,明确回复 “知识库暂无该内容,无法回答”,禁止编造信息; 测试验收:准备一批真实业务问题,批量测试,持续优化。 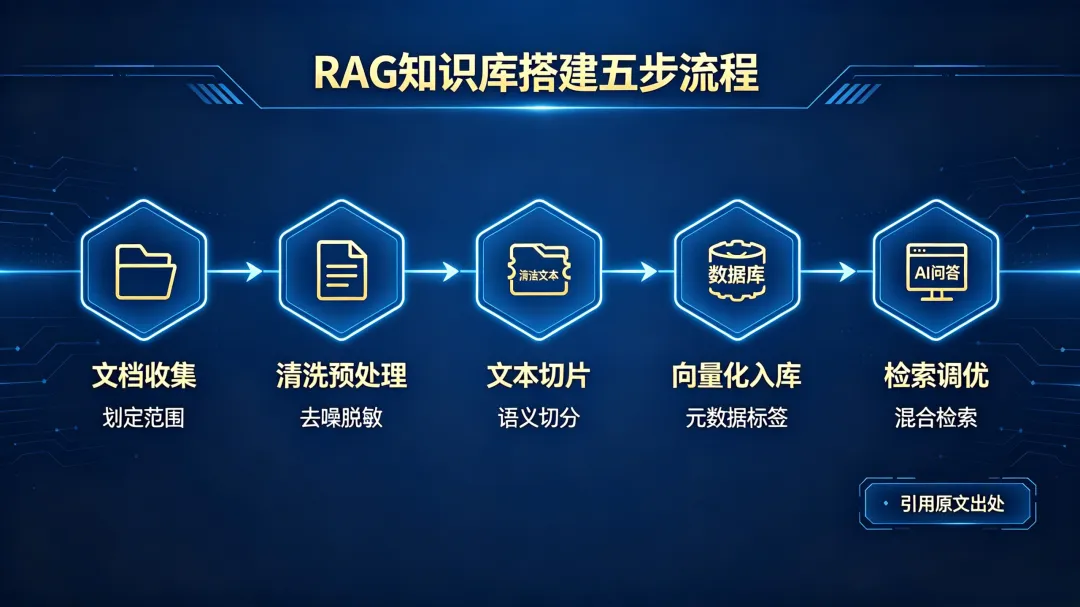
三、RAG 高频踩坑清单与解决方案
四、落地案例:工程咨询企业内部知识库落地
某工程咨询企业,内部有上千份项目方案、投标模板、行业规范文档。过去员工查找资料平均需要 20-40 分钟。
落地方案:
筛选近 5 年有效项目资料,清理过期作废方案; 文档清洗、OCR 识别扫描件,统一切片入库; 面向技术、投标两个部门开放问答入口; 配置引用溯源,AI 回答附带原文出处。
落地效果:
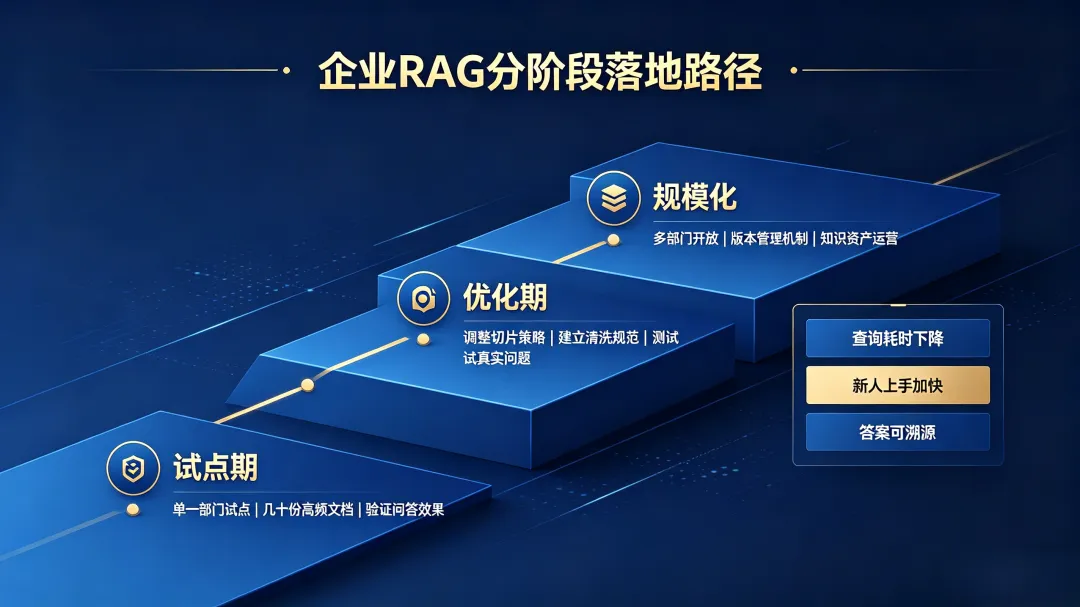
员工查询资料平均耗时下降 70%;新人上手查阅项目经验资料的周期大幅缩短。运维机制:设置知识库管理员,每月定期新增项目文档,清理失效资料。
五、轻量化落地建议,分阶段推进
阶段 1(试点期):选取单一部门,小范围测试,仅导入几十份高频文档,验证问答效果,不用一次性全量迁移。
阶段 2(优化期):根据测试反馈调整切片、检索策略,沉淀文档清洗规范。
阶段 3(规模化):多部门开放,建立常态化文档更新、版本管理机制。
核心结论:RAG 不是一次性交付项目,它是需要持续运营维护的知识资产。只搭建不维护,知识库很快失效。
六、最后:实操思考题
你们企业内部,哪一类文档最适合优先搭建 RAG 知识库试点? 在文档收集阶段,如何避免大量过期、重复资料混入知识库? 上线 RAG 之后,该建立怎样的长期维护机制,防止知识库逐步失效?