ARTICLE · 1124716
别踩坑!无纸化病历PDF直接转OFD≠OFD‑H电子病历
别踩坑!无纸化病历PDF直接转OFD≠OFD‑H电子病历近日,OFD‑H新版电子病历国标发布,不少人心里冒出一个省事的想法:咱们手上存量都是PDF病历,直接批量转成OFD格式,是不是就算达标了? 
这不单单是转换工具做得好不好的问题,本质上是方向就搞错了。 PDF转出来的OFD,仅仅只是外表看着是OFD后缀的文件,并不是符合规范的OFD‑H病历。 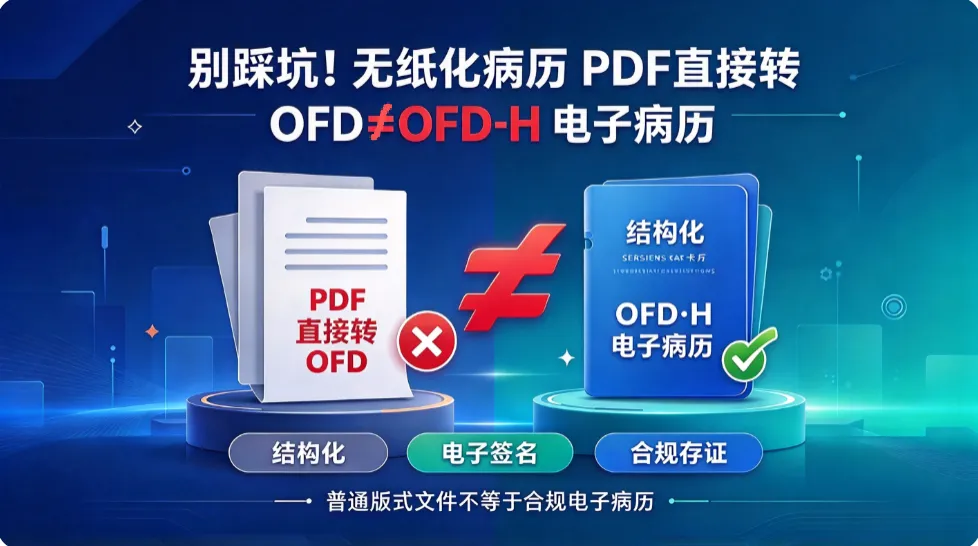
改得了文件外壳,改不动里面的数据内核。 PDF转OFD,到底干了一件什么事? 说白了就是把原有页面上的文字、表格、图形,重新梳理一遍排版,翻译成OFD的版式文件。 最后的效果,打印、翻看的时候,肉眼看上去几乎跟原来一模一样。 但OFD‑H要的可不只是“人看得懂”,更关键是医院的业务系统也得读得懂病历里面的各项医疗数据。 像患者姓名、疾病诊断、检验指标、血压读数、就诊时间这些信息。 标准要求这些内容不能简简单单只是页面上写出来的一行文字,而是一条条独立的结构化数据。 系统可以直接抓取、识别、运算、比对。 可经过PDF转换之后呢?所有文字依然相当于“画”在页面上。 转换工具只知道,在页面某个坐标位置有一段文字,它根本分不清这串数字是血压,还是血糖;分不清这一段话是医生诊断,还是用药医嘱。 人阅读没问题,后台系统却抓不到有效的业务字段。 提到OFD‑H,绕不开“语义标引”这个概念。说得通俗一点,就是给每一项医疗数据打上专属“身份标签”。 拿血压举个例子:页面上显示130/85mmHg,这只是表面数字。 语义标引就要额外标记清楚:这是收缩压、舒张压,计量单位是mmHg,什么时间测的,归属哪一次门诊记录。 打上这套标签之后,医院系统才能够自动校验、做数据分析,甚至是数据关联。 可惜的是,PDF转OFD的过程,完全不会生成这一套标签。 相当于你把报纸的文章原样印刷到另外一张纸上,字一个不差,但是不会自动给里面每一条医学信息加上备注说明。 机器依旧不知道每一段内容背后代表什么业务含义。这是单纯格式转换解决不了的硬缺口。 签章风险!好看的电子印章不等于合法有效签名。 还有一个很容易被大家忽视的隐患,就是电子签章。 OFD‑H明确要求采用国密SM2/SM3/SM4算法完成签名加密。 一份正规的OFD‑H病历,医生、审核人员的电子签名是和整个文档深度绑定。一旦文档内容被篡改,签名立刻失效,以此保障病历的可信性。 一旦把原先已经签好章的PDF直接转成OFD,原有文件整体结构发生改动,原来那一份具备法律效力的电子签名直接就废掉了。 有些转换工具还很“贴心”,会把原来的印章截图贴到新OFD页面上面。 外表看着印章还好好盖在那里,可这仅仅只是一张静态图片而已。 没有密码学的校验能力,系统后台验签根本通不过,也就不具备法律上的防篡改效力。这点一定要警惕。 很多人以为新标准只是换个存储格式而已,其实不是。 OFD‑H最大的亮点就是提出了“文档即接口”。 两家医院之间直接交换这份病历文件,接收方不光可以打开纸质版式阅读; 同时不需要专门对接对方的业务系统,就可以直接核验这份病历真伪,自动提取里面的检验、诊断数据,导入本院系统开展后续诊疗。 要是只是PDF转过来的OFD,这份能力直接就消失了。 拿到文件以后依旧只能靠医护人员人工阅读、手动录入数据。跟以前传阅PDF病历相比,实际上没有实质性改善,跨院病历数据互通也就无从谈起。 合规没有捷径:OFD‑H是“生成”出来,不是“转换”出来的。 既然靠后期转换这条路行不通,那正确路径是什么? 行业一直在提的“流‑版‑签”流程,就是答案。先在电子病历系统里面流式完成病历编写;接着固化生成版式文档;最后完成国密电子签名锁定全文。 也就是说,OFD‑H合规文档,必须从业务源头直接生成。 写病历的时候系统就同步把患者各项诊疗数据提取出来,自动完成语义标引打标签,版式固化之后再完成国密签章。 存量PDF属于已经定稿固化完成的结果。事后再做格式转换,属于事后补救。外壳改完了,底层结构化字段、语义标签、合法国密签章全部补不回来。 PDF转OFD,只能解决文件显示浏览的表层需求; 而OFD‑H国标瞄准的是病历机器识别、可信签章、跨院业务互操作。 千万不要抱有侥幸心理,指望后期批量转换就完成新标准落地。 外衣可以换,但底层的数据内核,是转换工具改不了的。 真正的落脚点,还是回归电子病历业务系统,从文档生成环节做起。
实话先说在前头:这条路走不通。