ARTICLE · 1125696
从零搭建一个 AI Infra 实验室⑬:Kubernetes 的 Pod 到底是谁启动的——containerd、CRI 与单节点 K8S
上一篇,我们已经把 GPU 从:
Host↓Docker Container
真正跑通了。
通过:
docker run --gpus all ...我们知道了 Docker Container 怎样通过 NVIDIA Container Toolkit 使用宿主机 GPU。
但是继续往 AI Infra 走,一个新的问题马上出现。
以后我们不会只运行:
一个 Docker Container而是会进入:
Kubernetes↓Pod↓Container
这时候一个很基础、但也很容易被忽略的问题出现了:
执行
kubectl apply以后,Pod 里面的 Container 到底是谁启动的?
以前我们很熟悉:
docker run nginx因为:
Docker清清楚楚地站在那里。
但 Kubernetes 里面:
kubectl apply -f pod.yaml然后:
kubectl get pods过一会儿就变成:
Running中间发生了什么?
这一篇我们先不碰 GPU,也不讨论 Device Plugin。
先搭一个:
单节点 Kubernetes但和我之前写过的单节点 K8S 系列不同,这一次不再走:
Docker+cri-dockerd
而是直接让:
kubelet↓CRI↓containerd
这样也正好为下一篇:
Kubernetes GPU做准备。
一、为什么又写一次单节点 Kubernetes?
之前的《从零搭建一个单节点 K8S 可观测实验室(二):安装单节点 Kubernetes》中,我已经完整介绍过:
Ubuntu↓Docker Engine↓cri-dockerd↓kubelet↓kubeadm↓Flannel
那套环境主要服务于:
PrometheusGrafanaLokiTempoOpenTelemetry
等可观测实验。
当时选择:
Docker + cri-dockerd主要是因为 Docker 更熟悉,个人实验也比较直观。
但 AI Infra 系列现在已经讲到了:
Container RuntimeNVIDIA Container ToolkitCDIGPU Device
继续往 Kubernetes 走,如果还经过:
cri-dockerd↓Docker Engine
反而会多出两层。
所以这次直接使用:
kubelet││ CRI▼containerd│▼runc
整个 Runtime Path 会清楚很多。
二、上一篇装好的 Docker 要删掉吗?
不用。
这一点其实很值得理解。
我们的实验机完全可以同时存在:
Docker和:
Kubernetes只是它们走不同的入口。
Docker 继续用于:
docker pulldocker builddocker rundocker compose
例如上一篇:
docker run --gpus all ...仍然照常使用。
而 Kubernetes 则走:
kubectl↓API Server↓kubelet↓CRI↓containerd
所以:
Kubernetes 并不要求机器必须通过 Docker Engine 运行 Container。
这也是从 Docker 进入 Kubernetes 时非常重要的一次认知变化。
三、先搞清楚三个组件:Docker、containerd、runc
这三个名字经常同时出现。
可以先粗略理解成三个层级。
Docker
我们最熟悉:
docker run nginxDocker Engine 提供了一整套:
ImageContainerNetworkVolumeBuildAPI
使用体验。
它更像一个完整的:
Container Platformcontainerd
containerd 更靠下一层。
它负责:
ImageSnapshotContainer LifecycleRuntime
更重要的是:
containerd 可以直接提供 CRI所以 Kubernetes 的 kubelet 可以直接和它通信。
runc
再往下是:
runc它更接近真正创建 Linux Container 的那一层。
最终:
containerd↓runc↓Linux Kernel↓Namespace / cgroup / mount↓Process
也就是说:
Container最后仍然只是:
Linux Process只是被 Namespace、cgroup 等机制隔离起来。
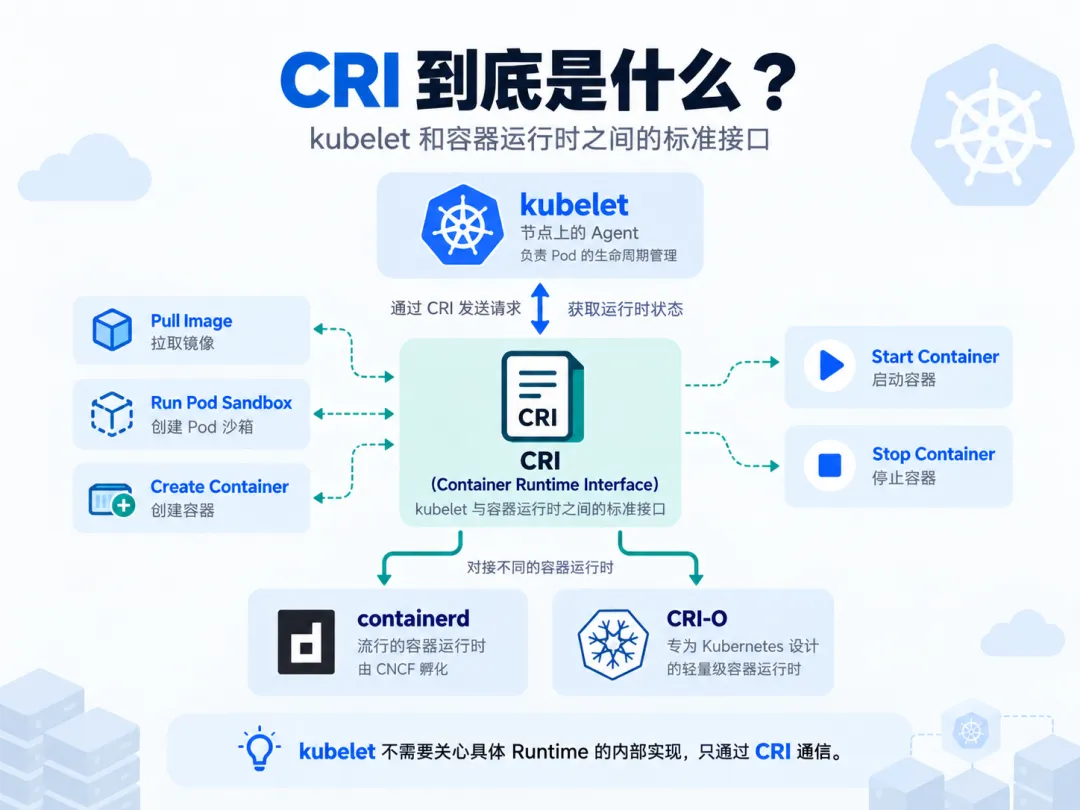
四、CRI 到底是什么?
这篇真正需要记住的新概念只有一个:
CRIContainer Runtime Interface
它可以简单理解成:
kubelet 和 Container Runtime 之间的一套标准接口。
例如:
kubelet││ CRI▼┌─────┴─────┐│ │containerd CRI-O
kubelet 不需要关心:
containerd 内部怎么创建 Container它只通过 CRI 请求:
拉取 Image创建 Pod Sandbox创建 Container启动 Container停止 Container
具体怎么完成,由 Runtime 自己负责。
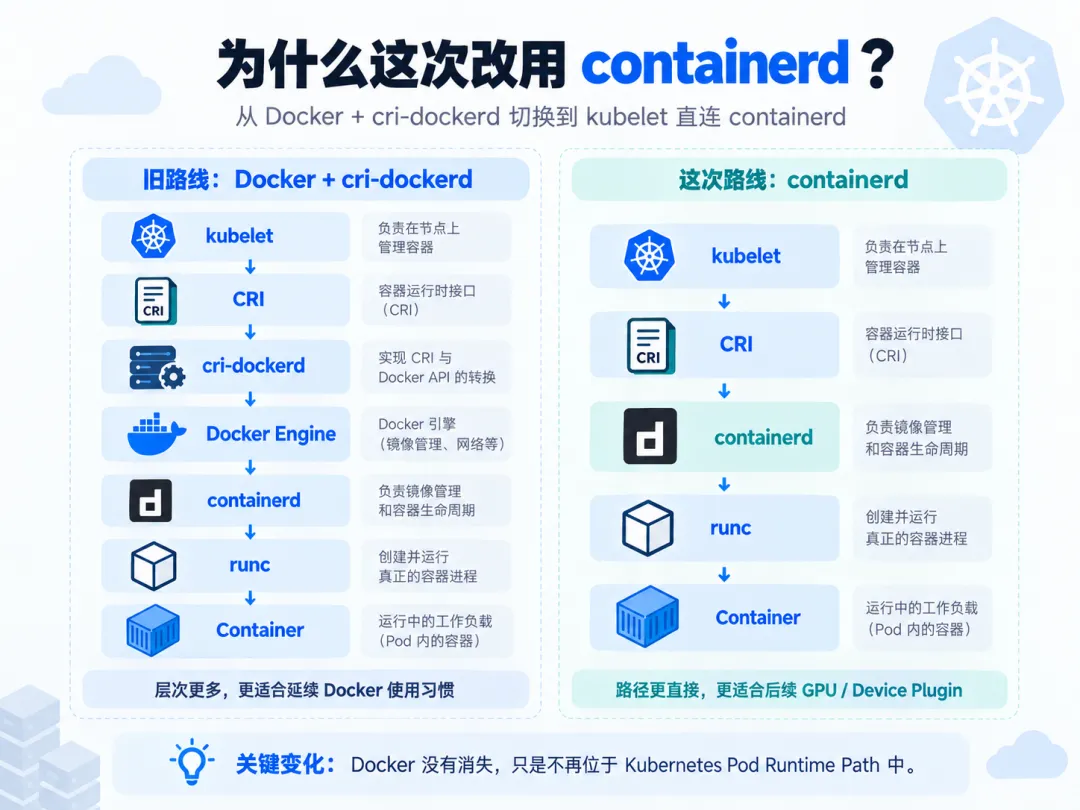
五、那以前的 dockershim 和 cri-dockerd 又是什么?
Docker Engine 本身并不直接实现 Kubernetes CRI。
所以早期 Kubernetes 曾经在 kubelet 内部放了一层:
dockershim大致是:
kubelet↓dockershim↓Docker Engine
后来 Kubernetes 移除了内置 dockershim。
如果现在仍然希望 kubelet 使用 Docker Engine,就需要:
cri-dockerd于是:
kubelet↓CRI↓cri-dockerd↓Docker Engine↓containerd↓runc
而这一篇,我们直接变成:
kubelet↓CRI↓containerd↓runc
这就是这次实验最大的变化。
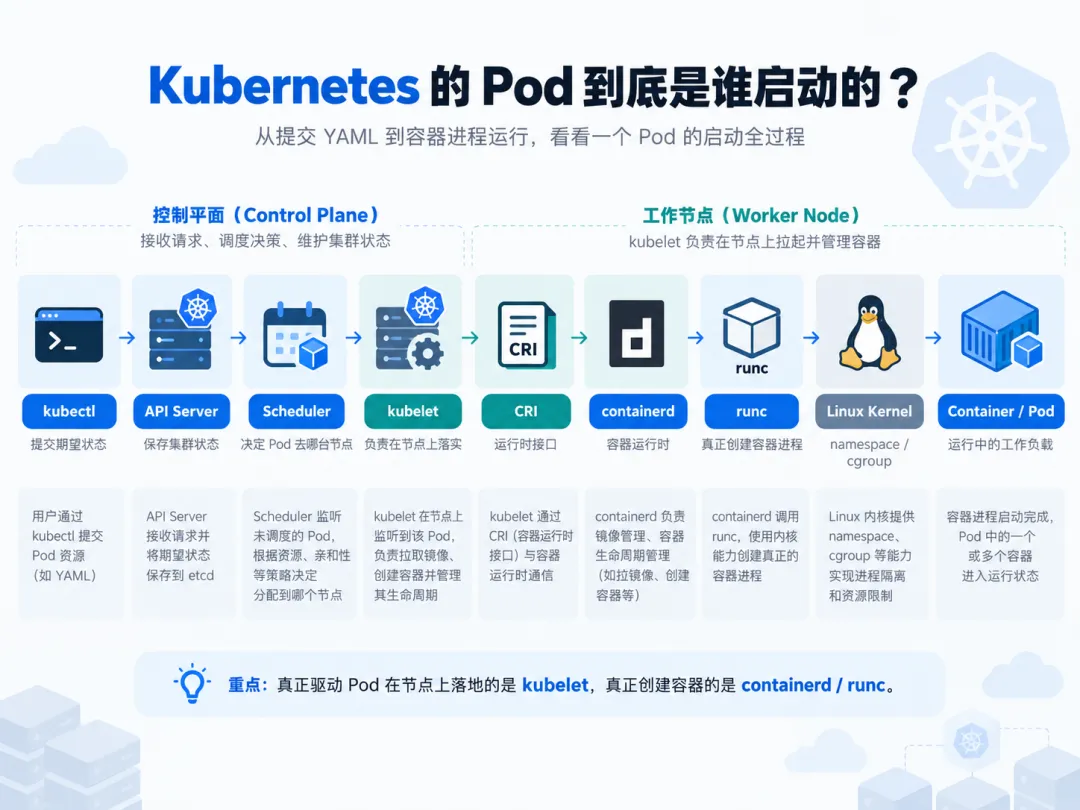
六、Pod 到底是谁启动的?
现在可以先把答案说出来。
完整链路大致是:
kubectl↓API Server↓Scheduler↓kubelet↓CRI↓containerd↓runc↓Linux Kernel
其中:
kubectl只是 Client。
它把:
我希望存在一个 Pod提交给 API Server。
Scheduler 负责:
这个 Pod 应该去哪台 Node例如:
Pod A↓Node 1
它并不真正创建 Container。
真正运行在每台 Node 上、不断观察:
有哪些 Pod 应该运行在我这里?的是:
kubelet当 kubelet 发现:
这个 Pod 应该运行在本机就通过:
CRI告诉 containerd:
把它运行起来最后:
containerd↓runc
真正创建 Linux Container。
所以如果非要回答:
Pod 是谁启动的?
可以说:
kubelet 负责驱动 Pod 在 Node 上变成现实,而真正创建 Container 的 Runtime 是 containerd / runc。
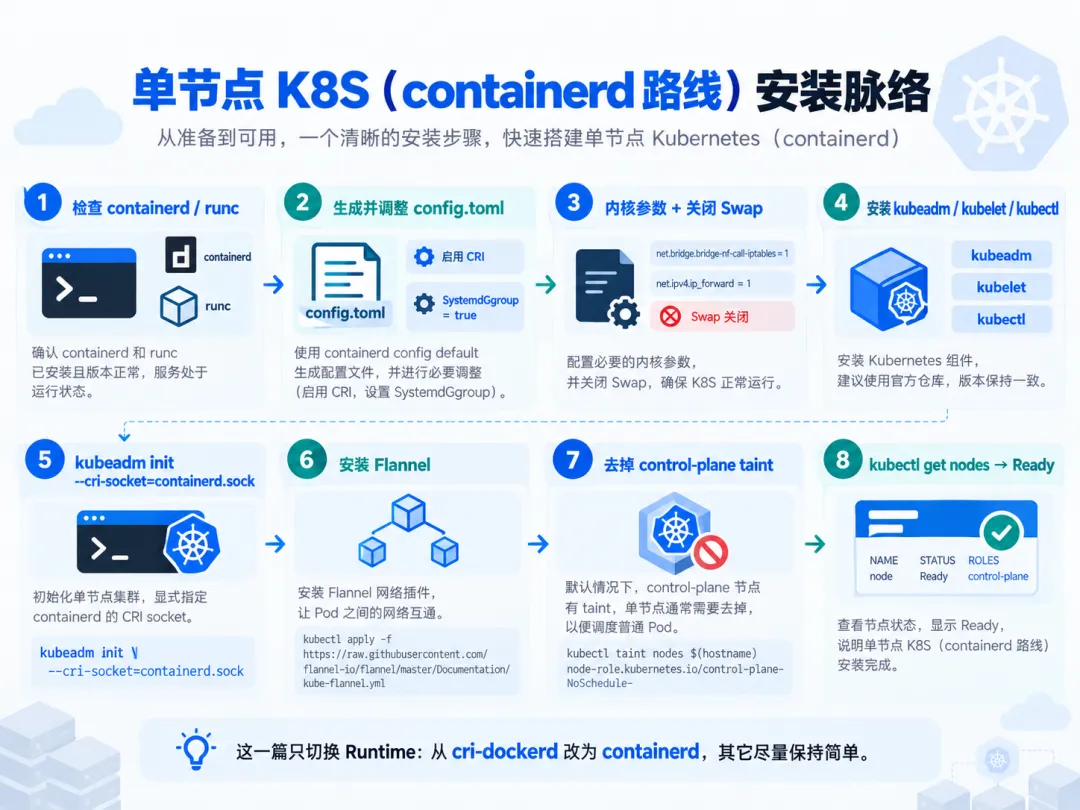
七、实验环境
继续使用 AI Infra 实验机:
Ubuntu 24.04 ServerIntel Core i5-10400FNVIDIA GeForce RTX 306012GB VRAM
上一篇已经安装:
DockerNVIDIA DriverNVIDIA Container Toolkit
这篇不删除任何东西。
新增:
containerd CRIkubeadmkubeletkubectlFlannel
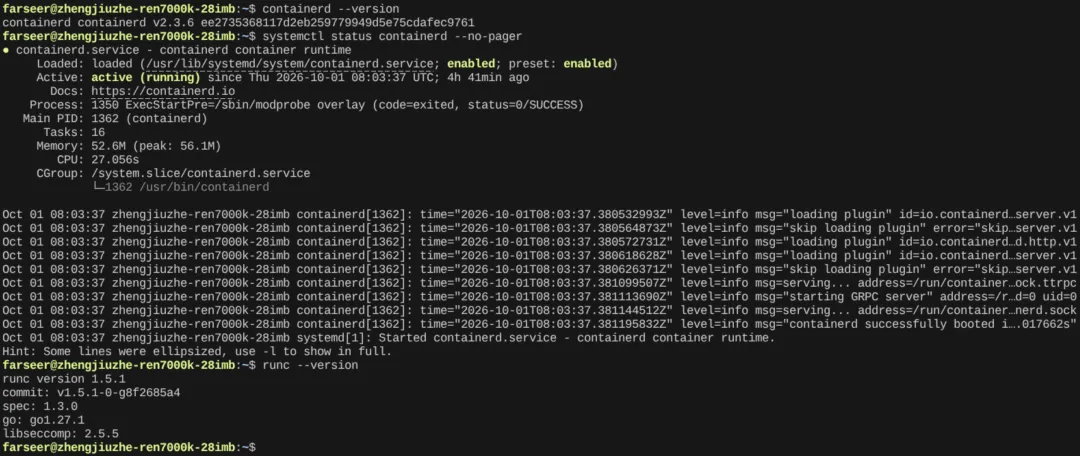
八、先看看现有 containerd
因为上一章已经安装 Docker,所以机器上通常已经存在 containerd。
先看:
containerd --version再看:
systemctl status containerd --no-pager以及:
runc --version如果这些已经存在:
不要重复安装另一套 containerd尤其不要看到 containerd 已经存在以后,又随手安装不同来源的软件包。
先沿用当前 Docker 安装带来的 containerd 即可。
九、把 containerd 调整成 Kubernetes 可以使用的 CRI Runtime
这一点是整篇最重要的准备工作。
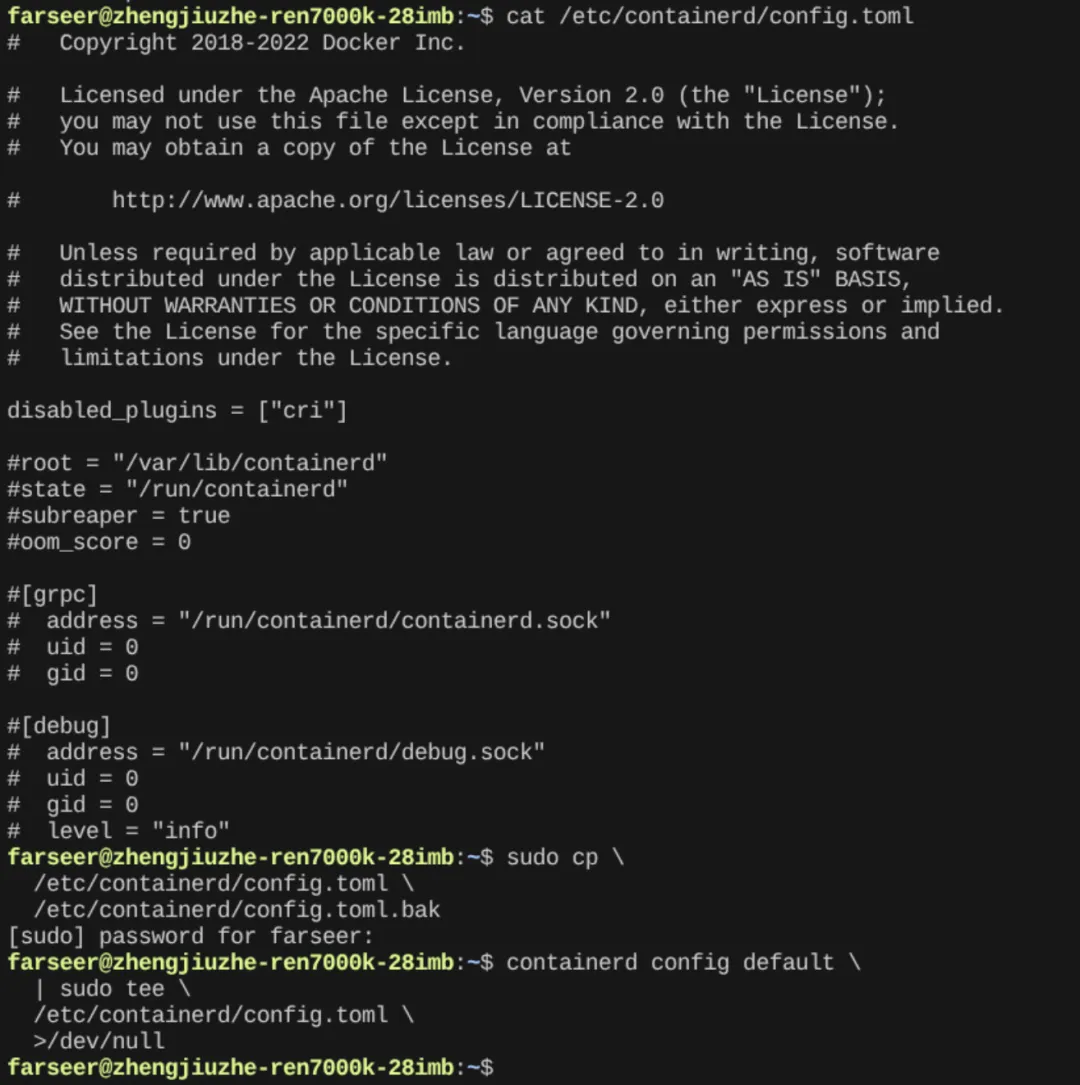
先看:
cat /etc/containerd/config.toml我在实测时,Docker 安装带来的配置非常精简,而且直接出现:
disabled_plugins = ["cri"]这意味着:
containerd 虽然在运行但 CRI Plugin 被关闭了
Docker 可以正常工作,
但是:
Kubernetes 不能直接把它当 CRI Runtime如果当前配置比较精简,最简单的方法是先备份:
sudo cp \/etc/containerd/config.toml \/etc/containerd/config.toml.bak
然后重新生成完整默认配置:
containerd config default \| sudo tee \/etc/containerd/config.toml \>/dev/null
十、确认 CRI 没有被禁用
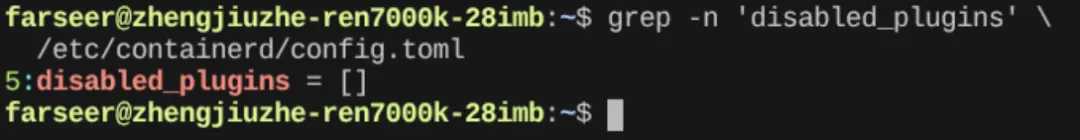
检查:
grep -n 'disabled_plugins' \/etc/containerd/config.toml
如果仍然看到:
disabled_plugins = ["cri"]就需要删掉:
cri例如改成:
disabled_plugins = []如果默认配置里根本没有禁用 CRI,则不用处理。
十一、配置 SystemdCgroup = true
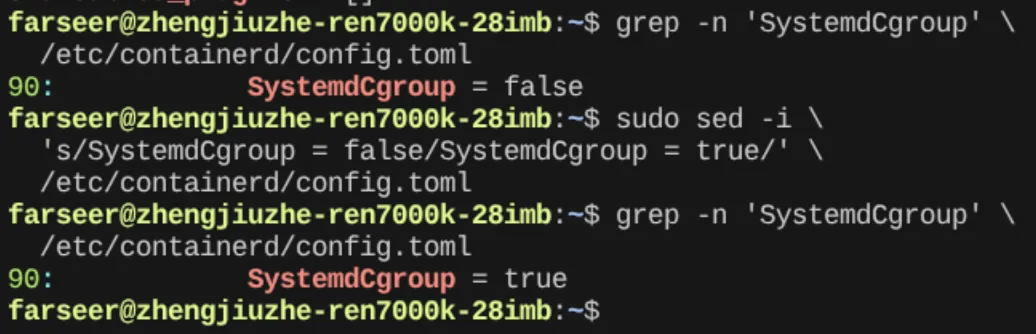
继续看:
grep -n 'SystemdCgroup' \/etc/containerd/config.toml
如果是:
SystemdCgroup = false改成:
SystemdCgroup = true例如:
sudo sed -i \'s/SystemdCgroup = false/SystemdCgroup = true/' \/etc/containerd/config.toml
现代 Ubuntu 使用:
systemd+cgroup v2
让:
kubelet和:
containerd都使用 systemd 管理 cgroup,可以减少很多奇怪问题。
然后:
sudo systemctl restart containerd确认:
systemctl status containerd --no-pager正常。
十二、准备 Kubernetes 的基本系统参数
加载:
overlaybr_netfilter
:
sudo tee /etc/modules-load.d/k8s.conf <<EOFoverlaybr_netfilterEOFsudo modprobe overlaysudo modprobe br_netfilter
再设置:
sudo tee /etc/sysctl.d/k8s.conf <<EOFnet.bridge.bridge-nf-call-iptables = 1net.bridge.bridge-nf-call-ip6tables = 1net.ipv4.ip_forward = 1EOFsudo sysctl --system
确认:
sysctl net.ipv4.ip_forward结果:
net.ipv4.ip_forward = 1即可。
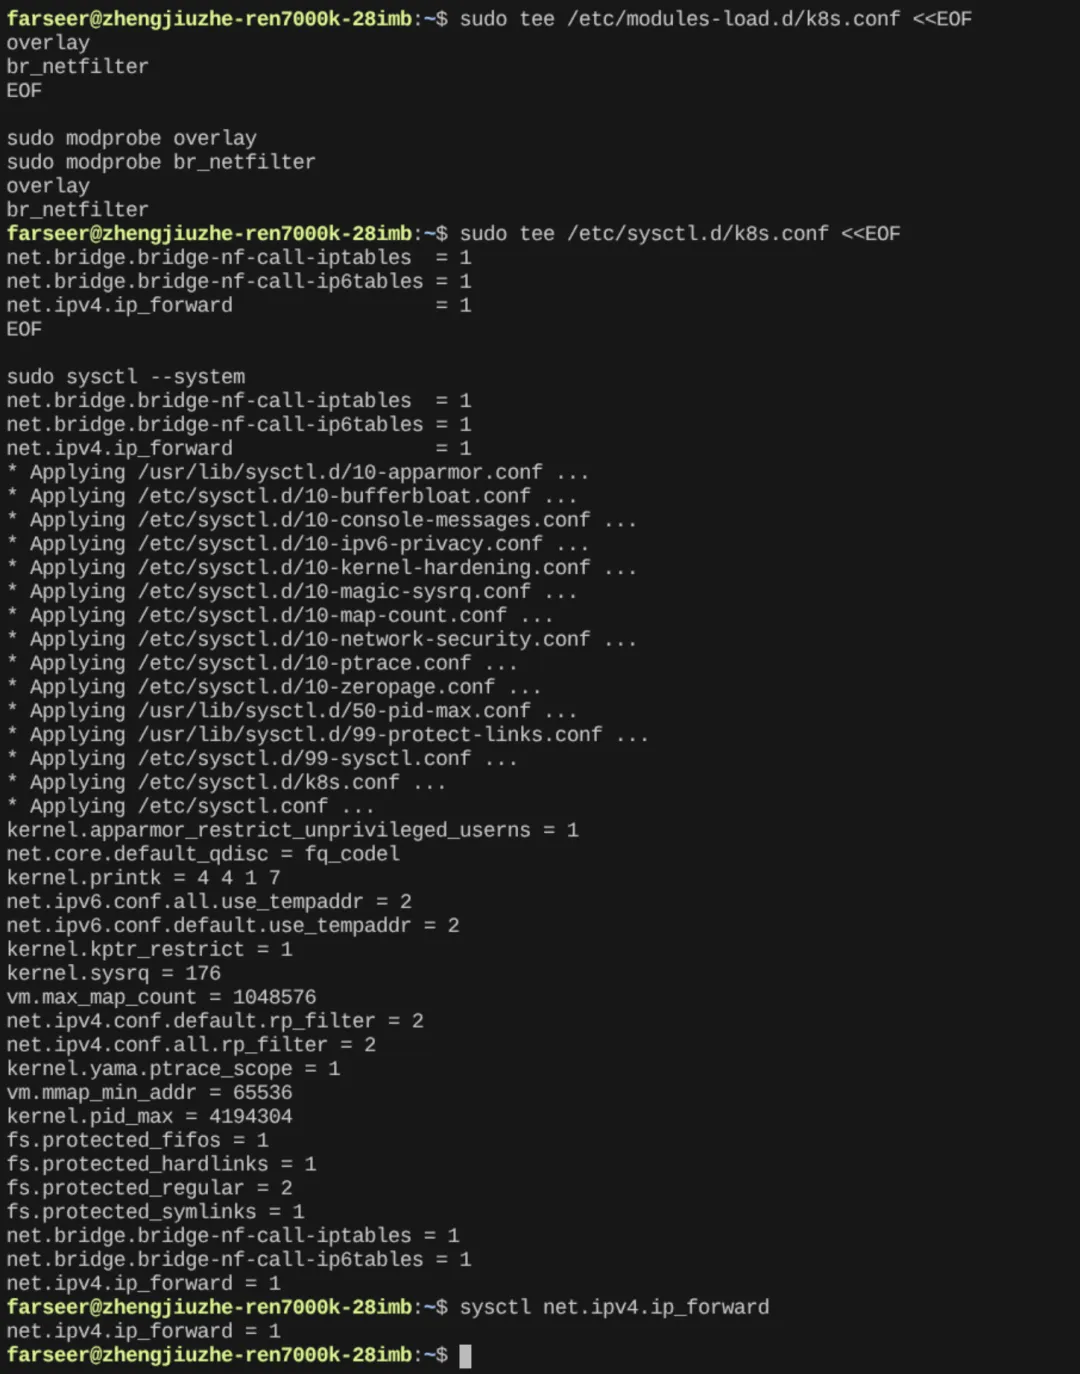
这部分和以前单节点 Kubernetes 实验基本一样,不再展开。
十三、关闭 Swap
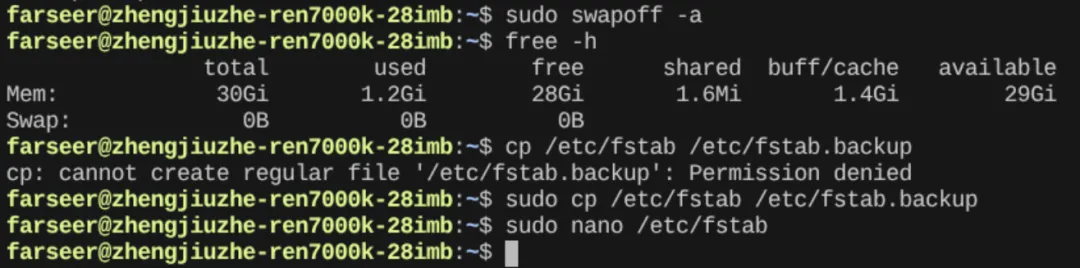
个人实验环境继续采用最简单方式:
sudo swapoff -a检查:
free -h确认 Swap 为:
0如果希望重启后继续关闭,再把:
/etc/fstab里的 Swap Entry 注释掉。
十四、安装 kubeadm、kubelet、kubectl
本次实测使用:
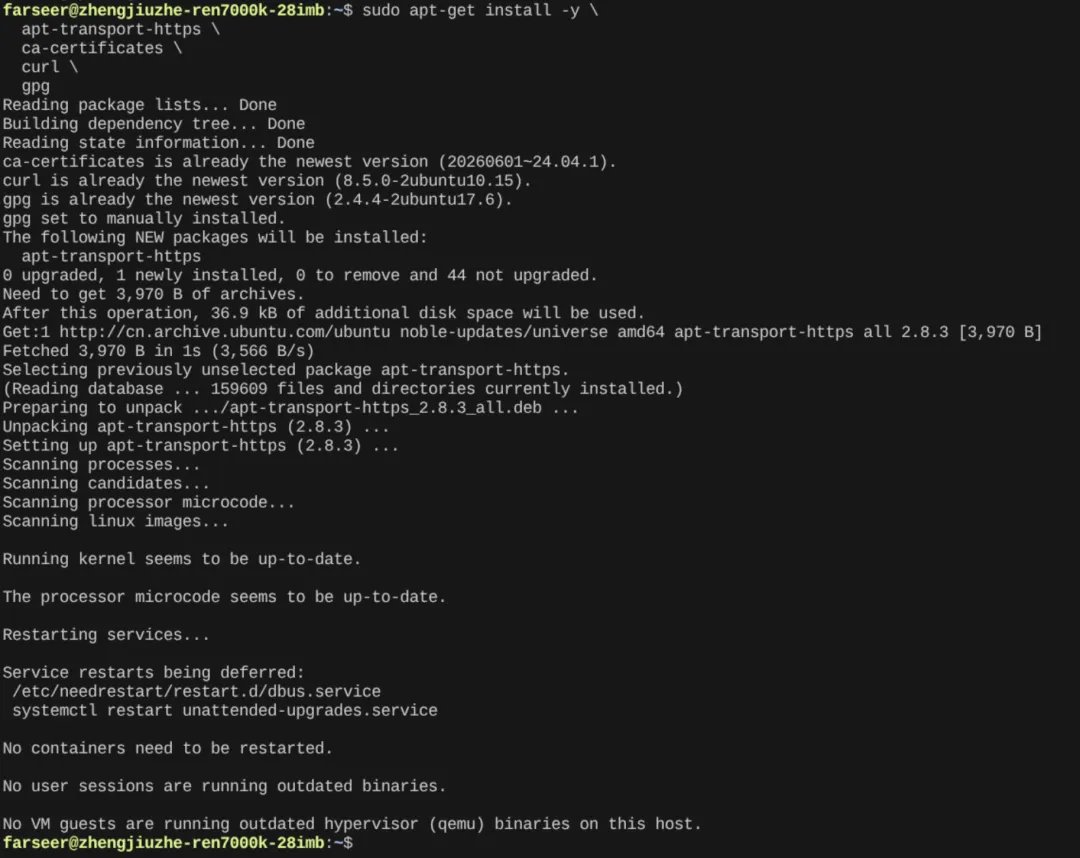
Kubernetes 1.37.1加入 Kubernetes v1.37 Repository:
sudo apt-get updatesudo apt-get install -y \apt-transport-https \ca-certificates \curl \gpg
导入 Key:
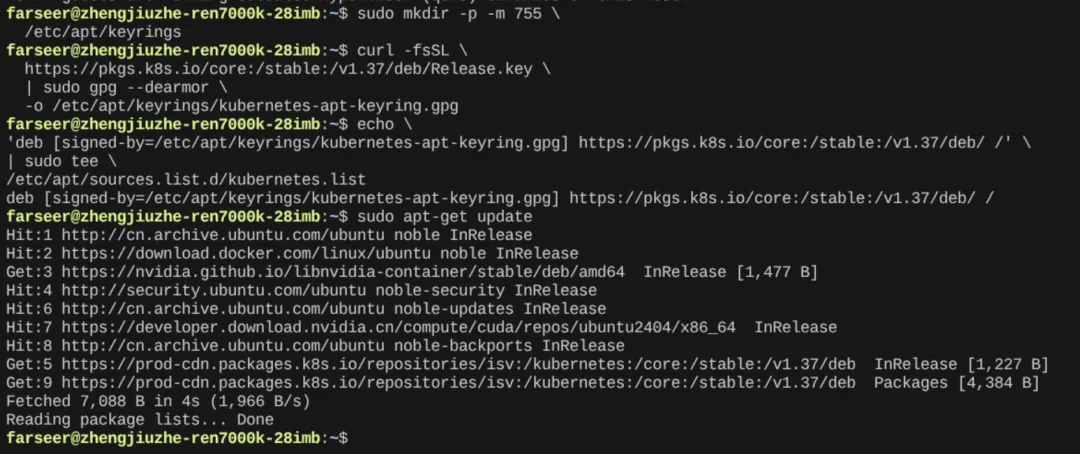
sudo mkdir -p -m 755 \/etc/apt/keyringscurl -fsSL \https://pkgs.k8s.io/core:/stable:/v1.37/deb/Release.key \| sudo gpg --dearmor \-o /etc/apt/keyrings/kubernetes-apt-keyring.gpg
添加 Repository:
echo \'deb [signed-by=/etc/apt/keyrings/kubernetes-apt-keyring.gpg] https://pkgs.k8s.io/core:/stable:/v1.37/deb/ /' \| sudo tee \/etc/apt/sources.list.d/kubernetes.list
安装:
sudo apt-get updatesudo apt-get install -y \kubelet \kubeadm \kubectl
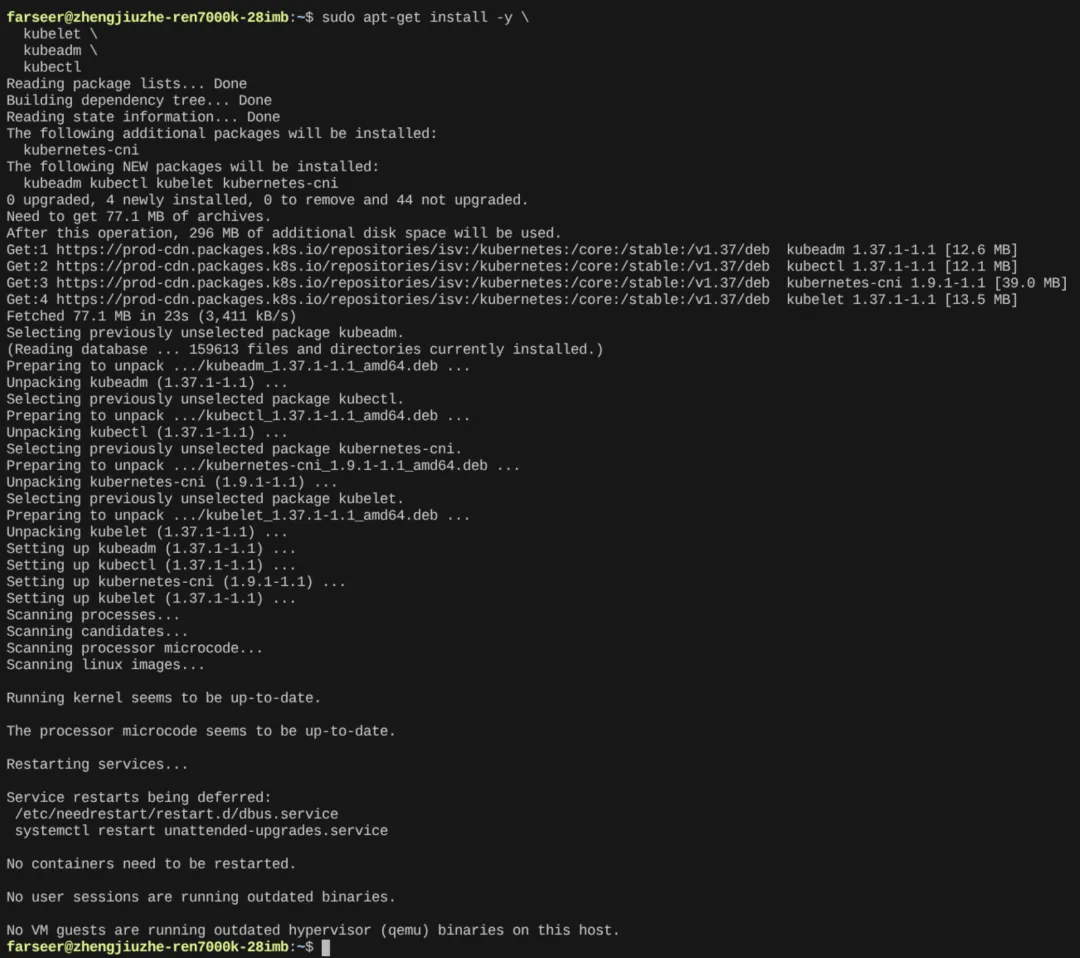
然后锁定版本:
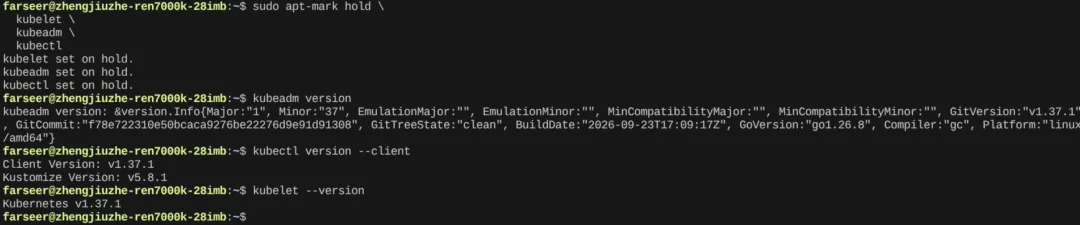
sudo apt-mark hold \kubelet \kubeadm \kubectl
查看:
kubeadm versionkubectl version --clientkubelet --version
十五、可选安装 crictl
这里有一个实测时发现的小坑:
安装 kubeadm / kubelet / kubectl并不会自动保证:
crictl存在。
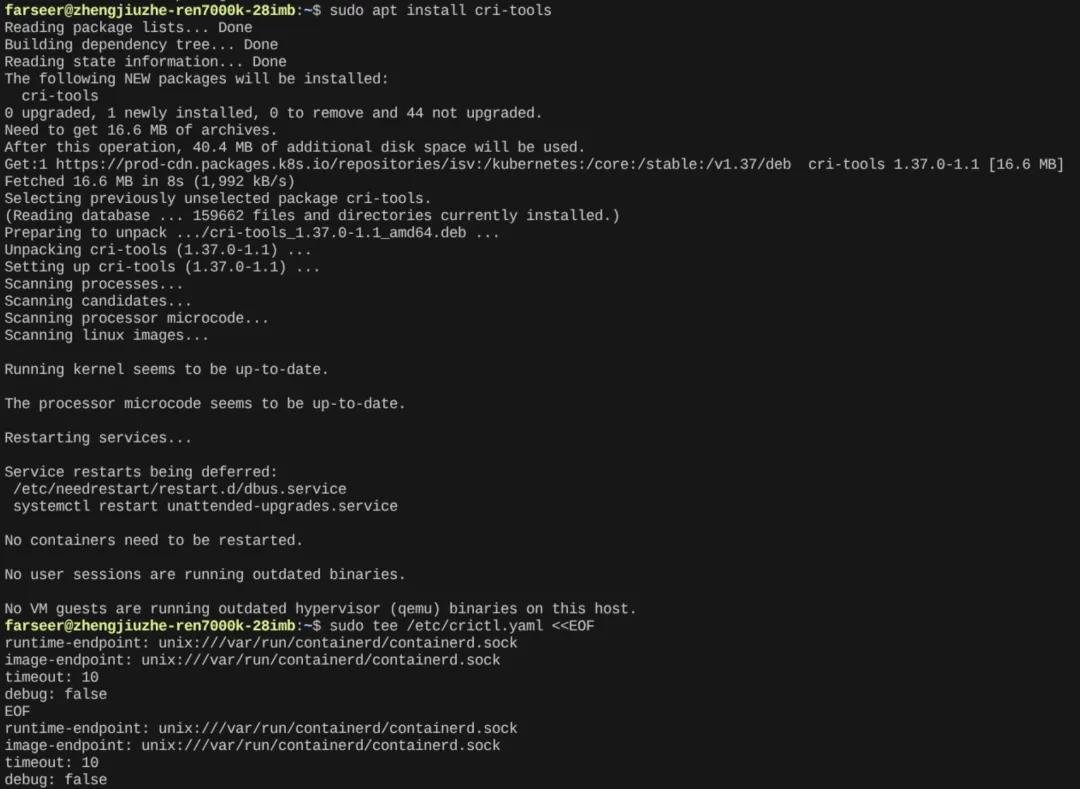
crictl 属于:
cri-tools它非常适合后面观察 Kubernetes Runtime。
安装后可以配置:
sudo tee /etc/crictl.yaml <<EOFruntime-endpoint: unix:///var/run/containerd/containerd.sockimage-endpoint: unix:///var/run/containerd/containerd.socktimeout: 10debug: falseEOF
 然后:
sudo crictl info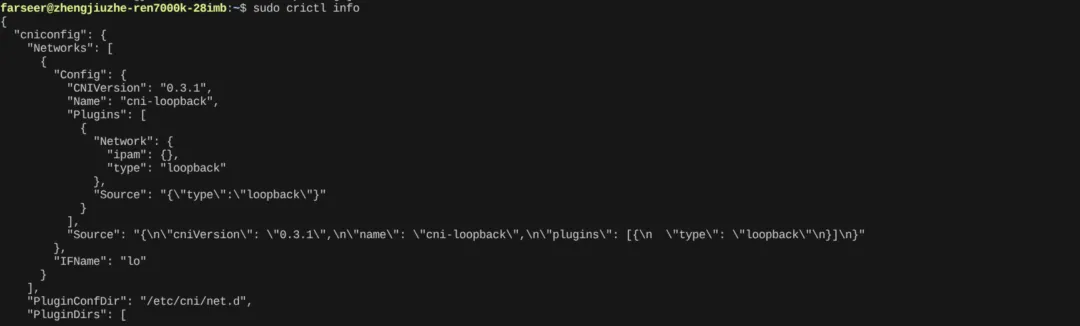
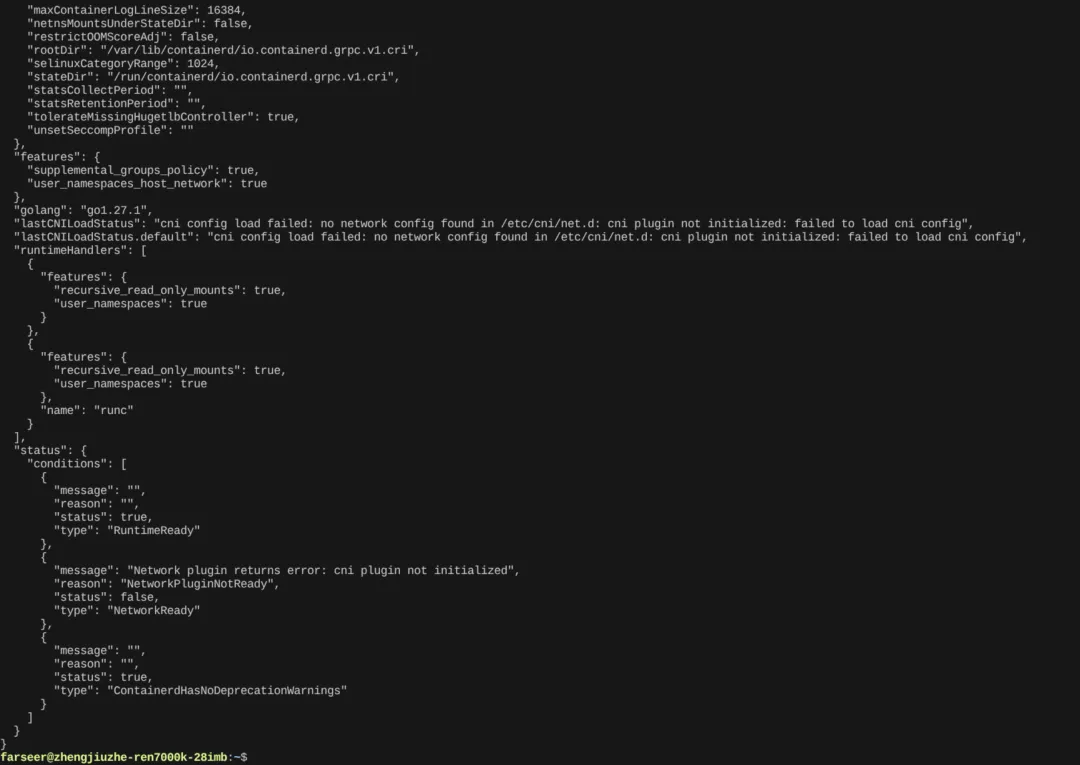 如果能正常返回 Runtime 信息,就说明:
crictl↓CRI↓containerd
已经打通。
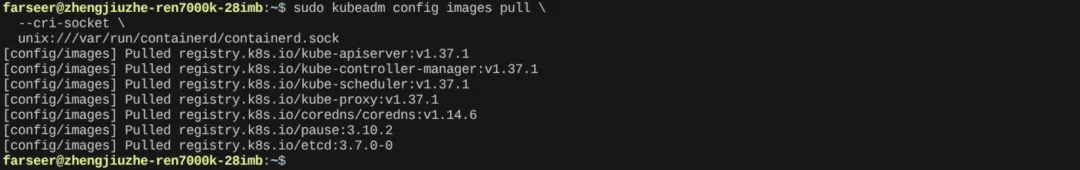
十六、提前拉取 Kubernetes Image
可以先:
sudo kubeadm config images pull \--cri-socket \unix:///var/run/containerd/containerd.sock
这里我在 VirtualBox 测试时还碰到一个很典型的问题:
Docker 可以访问网络但 containerd 拉 registry.k8s.io 超时
原因也很简单:
Docker Proxy和:
containerd Proxy不是一回事。
如果你的环境需要代理,需要单独给:
containerd.service配置:
sudo mkdir -p /etc/systemd/system/containerd.service.dsudo nano /etc/systemd/system/containerd.service.d/http-proxy.conf-------------------------------------------------------------------------[Service]Environment="HTTP_PROXY=http://PROXY_IP_ADDRESS:PROXY_PORT"Environment="HTTPS_PROXY=http://PROXY_IP_ADDRESS:PROXY_PORT"Environment="NO_PROXY=127.0.0.1,localhost,10.96.0.0/12,10.244.0.0/16,192.168.56.0/24,192.168.31.0/24"-------------------------------------------------------------------------sudo systemctl daemon-reloadsudo systemctl restart containerd
这也再次说明:
docker pull 正常并不能证明:
Kubernetes Runtime 拉镜像也正常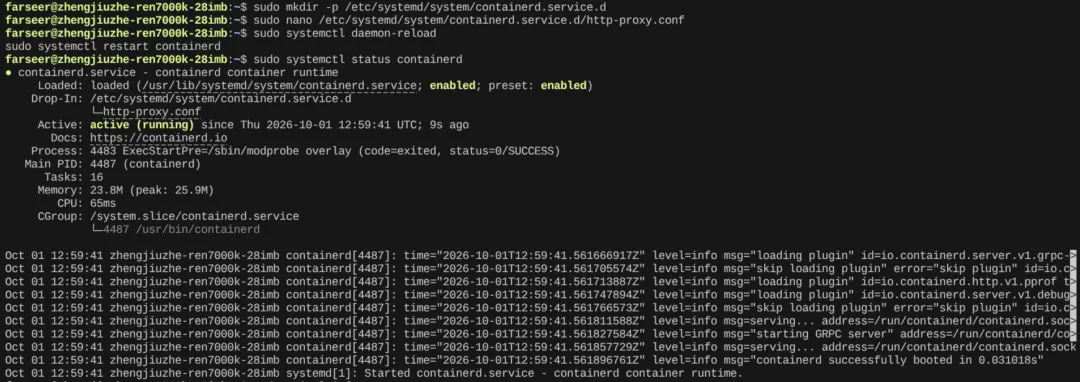
十七、初始化单节点 Kubernetes
找到当前服务器管理 IP:
ip addr假设:
192.168.x.x初始化:
sudo kubeadm init \--apiserver-advertise-address=192.168.x.x \--pod-network-cidr=10.244.0.0/16 \--cri-socket=unix:///var/run/containerd/containerd.sock
这里最值得注意的是:
--cri-socket它明确告诉 kubeadm:
Kubernetes Runtime=containerd
而不是:
Docker + cri-dockerd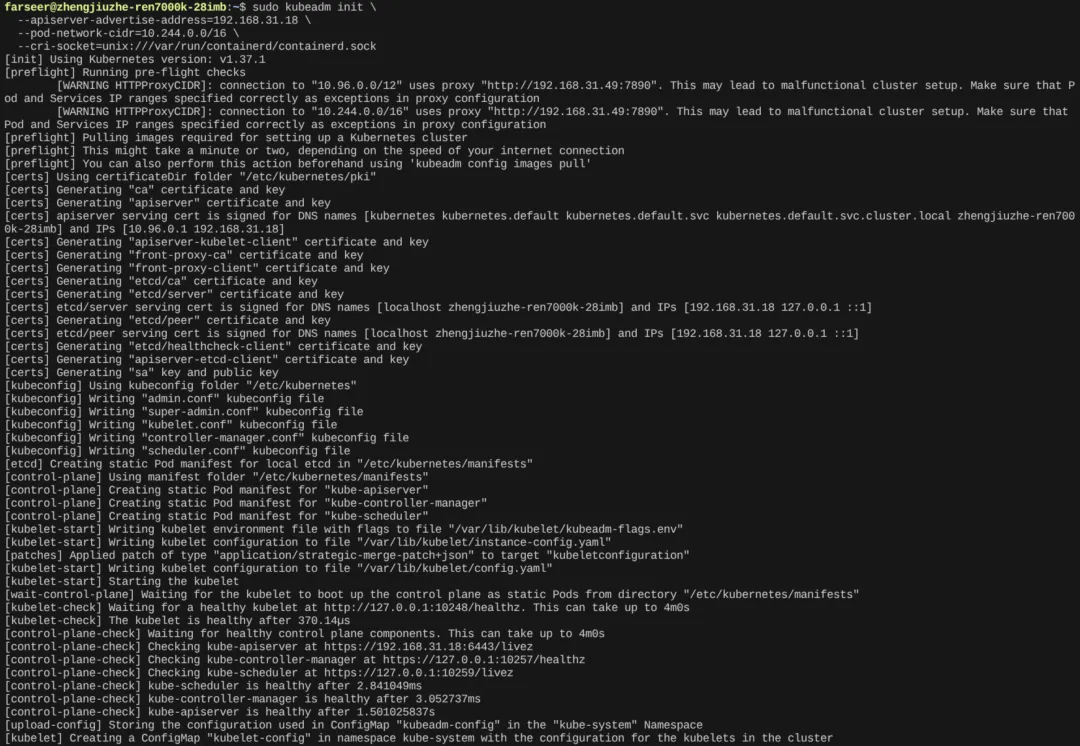
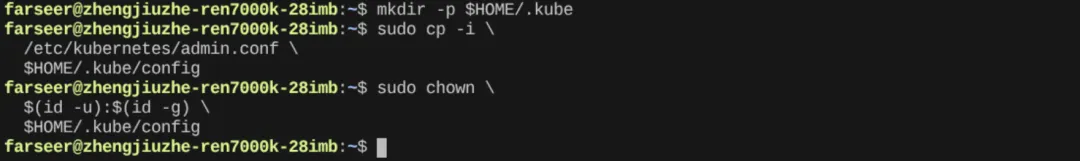
十八、配置 kubectl
初始化完成后:
mkdir -p $HOME/.kubesudo cp -i \/etc/kubernetes/admin.conf \$HOME/.kube/configsudo chown \$(id -u):$(id -g) \$HOME/.kube/config
现在:
kubectl get nodes可能还是:
NotReady因为还没有安装 CNI。
十九、继续使用 Flannel
为了让这篇只改变:
Container Runtime这一项,我继续使用之前熟悉的:
FlannelPod CIDR:
10.244.0.0/16前面已经在 kubeadm init 中配置好了。
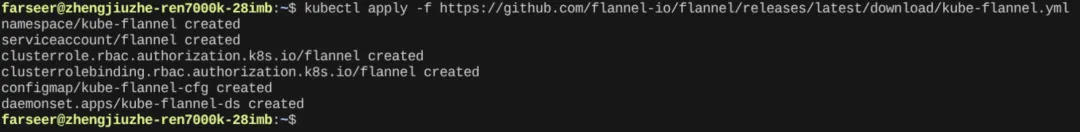
安装:
kubectl apply -f \https://github.com/flannel-io/flannel/releases/latest/download/kube-flannel.yml
观察:
watch kubectl get pods -A等系统组件逐渐进入:
Running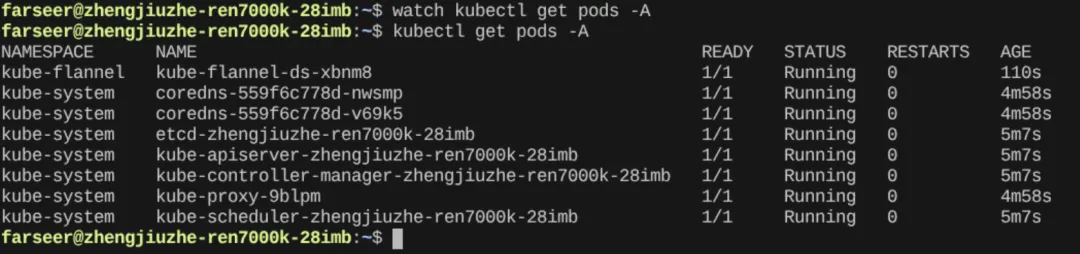
二十、让单节点可以运行普通 Pod
kubeadm 创建的 Control Plane 默认带:
NoScheduleTaint。
但我们这里只有一台机器:
Control Plane=Worker=以后要使用的 GPU Node
所以执行:
kubectl taint nodes --all \node-role.kubernetes.io/control-plane-
然后:
kubectl get nodes最终应该看到:
Ready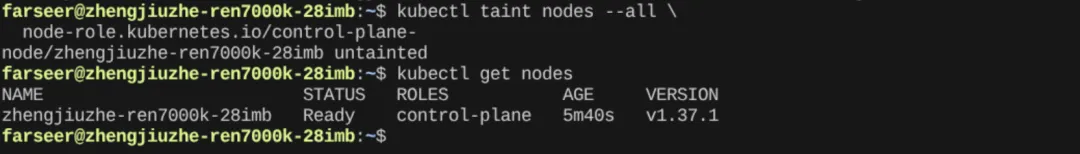
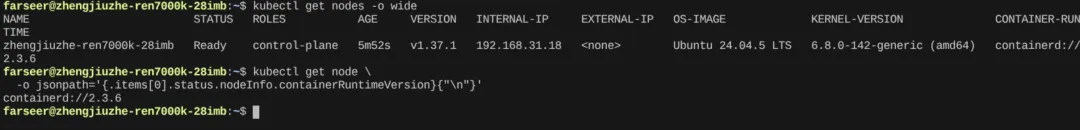
二十一、确认 Kubernetes 真正使用的是 containerd
这一步很重要。
运行:
kubectl get nodes -o wide看:
CONTAINER-RUNTIME应该类似:
containerd://...也可以:
kubectl get node \-o jsonpath='{.items[0].status.nodeInfo.containerRuntimeVersion}{"\n"}'
如果看到:
containerd://...说明:
Docker仍然存在但是:Kubernetes已经直接使用 containerd
二十二、运行第一个普通 Pod
先创建一个最简单的:
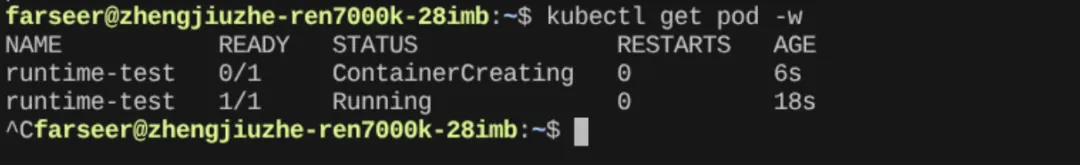
kubectl run runtime-test \--image=nginx:alpine
观察:
kubectl get pod -w应该经历:
Pending↓ContainerCreating↓Running
到这里:
kubectl↓API Server↓Scheduler↓kubelet↓CRI↓containerd↓runc
整条链路就已经真正跑通。
二十三、一个很直观的小实验:docker ps vs crictl ps
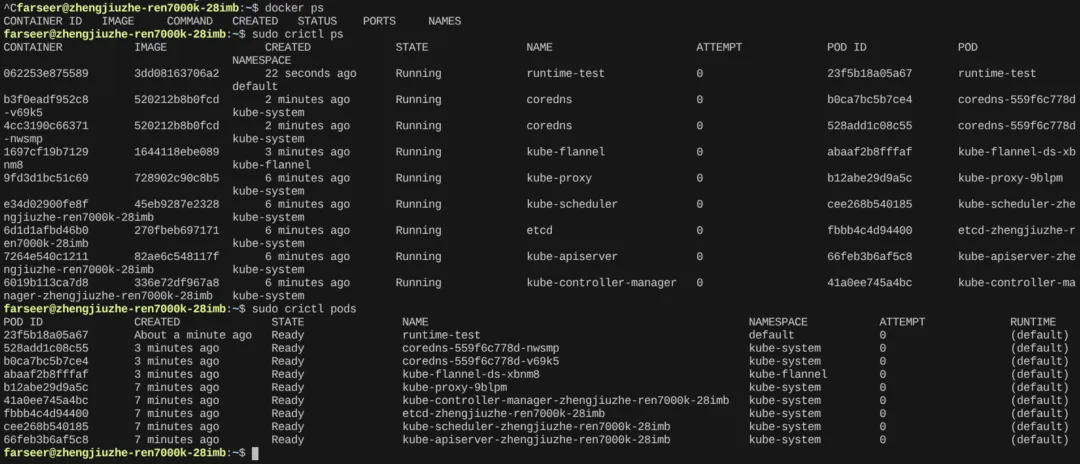
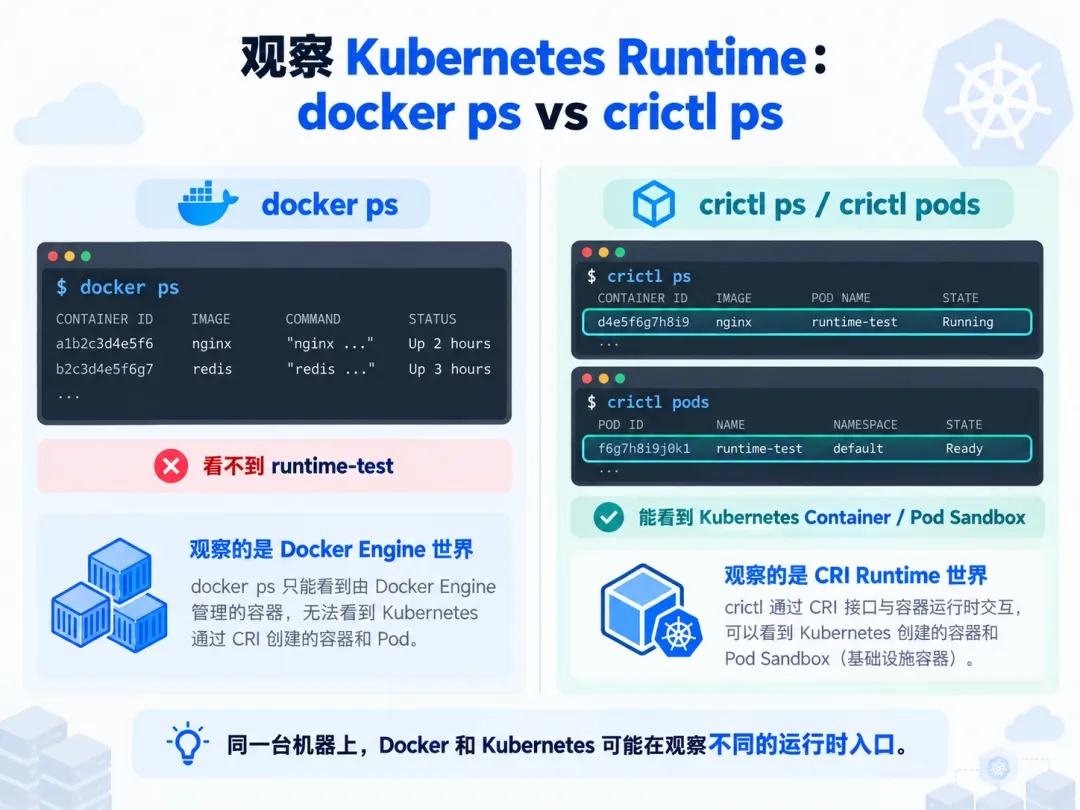
现在执行:
docker ps通常找不到刚才的:
runtime-test因为它根本不是:
Docker Engine创建的。
再执行:
sudo crictl ps则可以看到 Kubernetes Container。
也可以:
sudo crictl pods看到对应的:
Pod Sandbox这几个命令非常直观地证明:
docker ps观察的是:
Docker Engine而:
crictl ps观察的是:
CRI Runtime这也是这篇实验最值得保留的一组现象。
二十四、所以 Pod 到底是谁启动的?
现在重新回答标题。
执行:
kubectl apply以后:
kubectl只是把 Desired State 提交给:
API ServerScheduler 决定:
Pod应该去哪台 Node
到了 Node:
kubelet发现:
这个 Pod应该运行在这里
于是:
kubelet││ CRI▼containerd│▼runc│▼Linux Kernel
真正创建 Container。
所以最值得记住的是:
kubectl↓API Server↓Scheduler↓kubelet↓CRI↓containerd↓runc↓Container
二十五、和之前 Docker + cri-dockerd 有什么不同?
之前:
kubelet↓CRI↓cri-dockerd↓Docker Engine↓containerd↓runc
现在:
kubelet↓CRI↓containerd↓runc
少了:
cri-dockerdDocker Engine
但 Docker 本身没有消失。
以后仍然可以:
docker builddocker run
只是它不再位于:
Kubernetes Pod Runtime Path里。
对于后面继续学习:
GPUDevice PluginNVIDIA Container ToolkitGPU Operator
这条 Runtime Path 会更加直接。
二十六、下一篇为什么出现?
现在我们已经有:
Ubuntu↓containerd↓Kubernetes↓Pod
机器本身还有:
RTX 3060并且:
nvidia-smi正常。
上一篇:
docker run --gpus all ...也已经证明:
Docker Container能够使用 GPU。
看起来:
GPUContainerKubernetes
全都有了。
但现在执行:
kubectl describe node看:
CapacityAllocatable
会发现:
cpumemorypods...
都有。
却没有:
nvidia.com/gpu于是问题又来了:
Linux明明知道这里有 RTX 3060Docker也已经能使用 RTX 3060但是:Kubernetes为什么完全不知道这台 Node 有 GPU?
这就不是 Container Runtime 的问题了。
而是:
Kubernetes Resource的问题。
于是下一篇继续:
《从零搭建一个 AI Infra 实验室⑭:Kubernetes 如何认识一张 GPU——Extended Resource、NVIDIA Device Plugin 与 nvidia.com/gpu》
这一篇,我们解决了:
Kubernetes怎样运行 Container
下一篇,再解决:
Kubernetes怎样第一次知道:这台机器有一张 GPU。