ARTICLE · 1128733
文档解析——检索质量的上限在这里决定
同一篇文档,解析方式不同,后面的检索效果为什么能差很多?
正式因为检索只能在解析出来的文本上工作。解析时丢掉的信息,后面任何检索器都找不回来;解析时混进来的噪声,会一路进到索引,再进到模型的上下文里。
上一篇讲经典 RAG 时,流水线的第一步是文档 → 切块,这个箭头被一笔带过了。这一篇就讲箭头前面的部分。我会先讲 PDF 里到底存了什么,然后拿一篇论文,把它的PDF版本和XML版本各解析一遍,逐项对比结果,看这些差别怎么一路影响到检索。最后聊聊如果只有 PDF 时有哪些办法,以及这件事在 Agent 时代还重不重要。
PDF 里存的是什么
PDF 的设计目标是让一份文档在任何设备上,任何打印机上都长得一模一样。为了做到这一点,它存下来的其实是一串绘制指令:在哪个坐标,用哪个字体,多大的字号,画出哪几个字符。
我从这篇实验用的论文里截了一小段原始内容,是第 4 页小标题 Intervention 和它下面第一行正文的绘制指令:
/T1_2 1 Tf
9.199999809 0 0 9.199999809 56.692901611 696.082580566 Tm
[(I)-6(n)5(t)6(er)-22(v)13(en)5(tion)]TJ
/T1_3 1 Tf
.139 Tw
9.8 0 0 9.8 56.692901611 684.082580566 Tm
[(D)-12(ur)-8(ing t)6(he 12-)-10(we)-14(e)7(k in)9(t)6(er)-33(ven)9(tion p)-13(er)-7.9(io)-13(d, f)-9(r)6(e)-14(e non-alc)8(o)]TJ
0 Tw
9.8 0 0 9.8 286.954711914 684.082580566 Tm
(-)Tj
大致读一下:Tf 选字体,Tm 设定位置和字号,TJ 画出一串字符。小标题 Intervention 被拆成了 I、n、t、er、v、en、tion 好几段,中间夹着的数字是字距微调。正文第一行画到 non-alco 就结束了,行尾那个连字符是用另一条指令,在横坐标 286.95 的位置单独画上去的。
这里面没有段落,没有小节,没有哪一行是标题的标记,也没有表格的行和列,甚至没有阅读顺序。PDF 只保证看起来一样,不保证读起来通顺。 所谓从 PDF 里提取文字,本质上是根据这些坐标,把散落在页面上的字符重新拼回一行行、一段段的文本。双栏排版、跨页的表格、插在正文中间的图,都会让这个拼回去的过程出错。
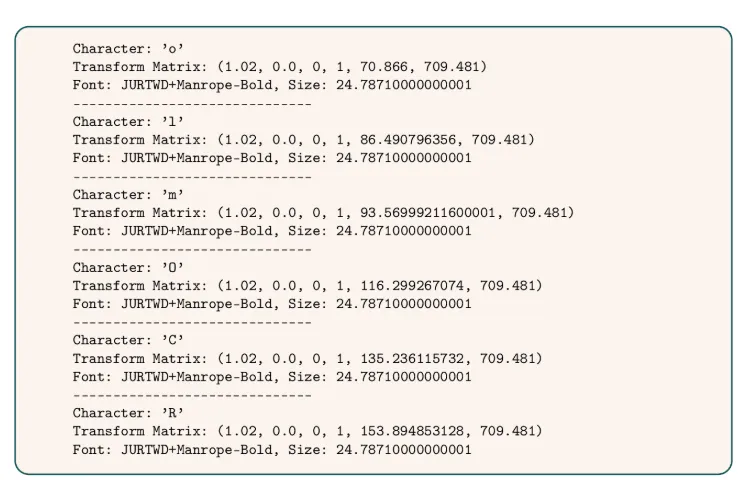
从 PDF 里读出来的原始信息:每个字符各自带着变换矩阵(最后两个数是坐标)、字体和字号。要从这些信息里还原出段落和阅读顺序,需要额外的推断。图源:Poznanski et al. 2025(olmOCR),Figure 1
而且还有一种更极端的情况——扫描件。扫描得到的 PDF 每一页只是一张图片,根本没有文本层。我把实验论文的第 4 页渲染成图片再存成 PDF,用同一个工具提取文字,原始页面能提取出 5,542 个字符,而扫描版却是 0 个。两份文件在屏幕上看起来完全一样,对检索来说一个有内容,一个是空白。这种文档必须先做 OCR,也就是光学字符识别才能进入索引。
同一篇论文,两种解析结果
实验用的论文是 Yoshimoto 等人 2023 年发表在 BMC Medicine 上的一项随机对照试验,研究给饮酒者免费提供无醇饮料,能不能减少他们的饮酒量。选它有几个原因:它以 CC BY 4.0 协议开放获取,可以自由引用;它同时有出版社提供的 PDF 和 PubMed Central 收录的 XML 两个版本;PDF 是典型的双栏排版,一共 10 页,里面有三张表和几张图,比较有代表性。
PDF 这边,我用 pypdf 和 PyMuPDF 这两个最常用的库直接提取文本,很多 RAG 教程里加载 PDF 的第一步用的就是这类工具。XML 这边,用 lxml 按标签读出正文的各个小节。
多出来的三分之一
先看总量:
PDF 抽出来的文字里,大约三分之一落在正文段落之外。其中有些是有用的,比如摘要;更多的是会污染索引的内容:
参考文献列表 952 个词,占全部文本的 12.9%; 页眉,10 页里每一页都有,一共 19 处:9 个页码 Page 7 of 10 这样的,加上 10 个 Yoshimoto et al. BMC Medicine (2023) 21:379 这样的期刊信息; 图注、流程图里的文字、作者贡献声明、利益冲突声明、补充材料的说明,全都和正文混在同一个字符串里。
XML 那边,这些内容各有各的位置。正文分成背景、方法、结果、讨论、结论五个部分,方法部分下面还有研究设计、参与者、干预措施、样本量、随机化与盲法等 10 个小节;32 条参考文献放在单独的 <ref-list> 里,每条都有作者、标题、期刊、年份的字段。哪些是正文,哪些是参考文献,哪些是表格,XML 里写得清清楚楚,但是 PDF 里要靠猜。
被行尾连字符切断的词
双栏排版的每一栏都很窄,排版软件会在行尾把长单词断开,加一个连字符。PyMuPDF 提取的文本里,这样的行尾断词一共有 143 处,比如 coef-ficient、sig-nificantly、alco-hol。pypdf 的输出还会在连字符前后加上空格,变成 signifi - cant 这样的形式。
对检索来说,这意味着 significant 这个词在索引里变成了 signifi 和 cant 两个毫无意义的词。用户查 significant,这一处永远匹配不上。
那把行尾的连字符全部删掉,把前后两段拼起来行不行? 也不行。这 143 处里有 14 处是本来就带连字符的词,比如 evidence-based、low-alcohol,删掉连字符就变成了 evidencebased。一律删和一律留都会出错,得逐个判断拼起来之后是否构成一个真实的词。这类细节正是专门的解析工具要处理的。
表格被打平
论文的表2 是两组参与者的基本特征。pypdf 提取出来是这样的:
Table 2 Characteristics in the participants
SD standard deviation, IQR interquartile range
a t-test, bChi-square test, cFisher’s exact probability test, dMann–Whitney U test
n = 123 Intervention group
n = 54
(43.9%)
Control group
n = 69
(56.1%)
p
Age (years, SD) 47.5 (10.2) 47.8 (10.7) 47.2 (9.8) 0.74a
Female (number of participants, %) 69 (56.1) 28 (51.9) 41 (59.4) 0.40b
XML 里的同一张表,每个单元格都在自己的位置上:
对比一下 PDF 版本的问题。表头被拆成了七行,第一列的 n = 123 和干预组的标题挤在同一行,看不出它是全体参与者的人数。表格底部的脚注跑到了数据前面。最隐蔽的是 0.74a:这里的 a 是上标,表示这个 p 值来自 t 检验,打平之后它变成了一个紧贴在数字后面的普通字母。XML 里它是一个明确标记的 <sup> 元素。
更麻烦的是表格在正文里的位置。表 2 和表 3 在 PDF 里是浮动排版的,提取出来之后,正好插在一句话的中间:
...at each time point from Week 4 to [表 2、表 3、表注和页眉,共 245 个词] Week 20. The main outcome...
一句完整的话被切成了两半,然后中间夹着两张表的全部数字。
这些问题怎么影响检索
把两个版本各自按 100 个词切块,用和上一篇相同的 BM25 检索,查询是:
correlation between non-alcoholic beverage consumption and alcohol consumption in the intervention group
这个问题的答案在结果部分:干预组里无醇饮料消费的变化和饮酒量的变化呈显著负相关,ρ = −0.500。
XML 版本里,包含这句话的块排在第 1 名(共 50 块)。PDF 版本里,包含同一句话的块排在第 6 名(共 74 块),它的内容是这样的:
IQR) 6.0 (12.0) 6.0 (16.0) 6.0 (11.0) 0.92d Page 7 of 10 Yoshimoto et al. BMC Medicine (2023) 21:379 Week 20. The main outcome, alcohol consumption at Week 12, was not significantly correlated with non- alcoholic beverage consumption in the control group (ρ = − 0.063, n = 67, p = 0.615). In contrast, a signifi - cant negative correlation was noted in the intervention group (ρ = − 0.500, n = 54, p < 0.001, Fig. 3) and
前面三分之一是表 3 的最后一行数字和一行页眉,接着是一个被切断的半句话 Week 20.,然后才是真正的内容,其中 significant 还被断成了两半。排在它前面的五个块,有两块来自讨论部分,一块是图 2 的图注,一块是摘要,还有一块是补充材料的说明文字。
这只是一篇论文、一个查询、一个最简单的检索器,都算不上严格的评测。这次答案恰好在摘要里也出现了,系统未必会答错。但方向很清楚就是噪声会稀释一个块的得分,被切断的句子和单词会让本该匹配的词匹配不上。 在一个几万篇文献的真实语料里,这些损失会在每一篇上重复发生,而且很多细节只写在正文里,摘要不会替你兜底。
有结构化的源文件,就千万别从 PDF 反推
上面这些问题,XML 版本几乎都没有,因为它从一开始就是按结构写成的。
PubMed Central 用的是 JATS 格式(Journal Article Tag Suite,美国国家标准 NISO Z39.96),期刊文章的标题、作者、单位、摘要、各级小节、表格、图注、参考文献,都有对应的标签。通过 Europe PMC 的接口,开放获取子集里的文章都能直接下载到这种 XML。
对科学文献来说,结构还有一层额外的价值就是几乎所有论文都遵循 IMRaD 结构,也就是引言(Introduction)、方法(Methods)、结果(Results)和讨论(Discussion)。Sollaci 和 Pereira 2004 年统计了 BMJ、JAMA、Lancet 和 NEJM 四本医学期刊 1935 年到 1985 年的论文,发现这种结构在 1940 年代开始出现,1970 年代占到 80%,到 1980 年代已经是原创论文唯一的写法。
这意味着其实小节标题在科学文献里是一个很可靠的信号。拿到结构之后,你可以把小节标题附在每个切块上,可以只在结果部分里找数字,回答疗效问题时也可以优先看结果部分,少受引言里对前人工作的转述干扰。下一篇讲切分时,还会用到这一点。
元数据也是一样。这篇论文 PDF 自带的文档信息里有标题,作者一栏只写了第一作者;XML 里有全部 5 位作者、单位、发表年份、DOI 和许可协议。标题、作者、年份、文献类型这些字段,后面做元数据过滤、生成引用时都要用到,从 PDF 里要么拿不到,要么要靠模型去猜。
HTML 介于两者之间。出版社网页通常也有标题层级、表格和图的标签,比 PDF 好处理得多,但每家出版社的页面结构都不一样,还混着导航栏、推荐文章、Cookie 提示这类和正文无关的内容。
所以我的一个心得或者想法就是能拿到 XML、HTML 或者 LaTeX 源文件,就不要从 PDF 反推结构。 开放获取的生物医学文献可以找 PMC 的 XML,arXiv 上的论文大多能拿到 LaTeX 源文件或者官方生成的 HTML 版本。
如果只有 PDF 的时候
现实中很多文档只有 PDF:像什么内部报告、扫描的病历、没有开放获取的论文等等,这时的工具大致分三类,思路的话一类比一类重。
第一类是直接读文本层,也就是上面实验用的 pypdf、PyMuPDF,还有 pdfminer 这类库。速度快,几乎没有成本,能拿到的就是 PDF 里本来存着的字符,结构基本靠自己用规则去补。对于排版简单的单栏文档,这往往就够了。扫描件完全没有文本层,这一类工具无能为力。
第二类是版面分析加结构识别,先判断页面上每个区域是标题、正文、表格、图注还是页眉,再分别处理。GROBID 是这类工具里历史最长的一个,Patrice Lopez 从 2008 年开始开发,2011 年开源,专门处理学术文献,能输出 TEI 格式的 XML,识别出标题、作者、单位、各级小节、段落、图表和参考文献等五十多种标签。默认模型是条件随机场,也可以换成深度学习模型。Semantic Scholar 构建 S2ORC 语料时,就是用 GROBID 来处理每一篇 PDF 的。IBM 2024 年开源的 Docling 是更新的一个代表,用专门的版面分析模型和表格结构模型,把 PDF 转成 JSON 或 Markdown。
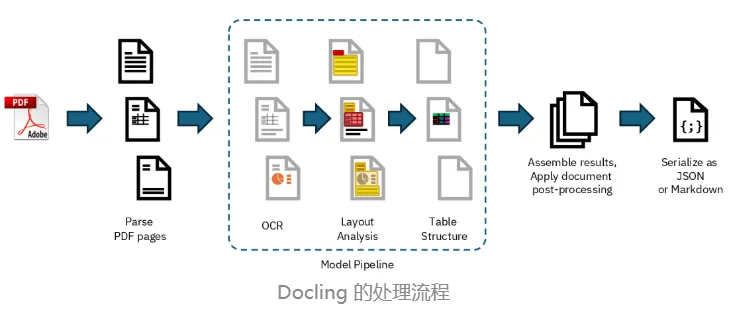
Docling 的处理流程:先解析 PDF 页面,然后依次做 OCR、版面分析和表格结构识别,最后组装结果,输出 JSON 或 Markdown。图源:Auer et al. 2024(Docling Technical Report),Figure 1
第三类是直接用视觉语言模型看图识字。 这一类不去读 PDF 的文本层,把每一页渲染成图片,让模型直接输出带结构的文本。Meta 2023 年发布的 Nougat(Blecher 等,ICLR 2024)是一个早期代表,用一个视觉编码器加一个文本解码器,把学术论文的页面图像转成标记语言,特别擅长处理数学公式,因为公式在 PDF 文本层里往往是一堆零散的特殊符号,看图反而更容易还原。AI2 在 2025 年发布的 olmOCR 用一个 70 亿参数的视觉语言模型做同样的事,按论文的估算,处理一百万页的成本约 176 美元。
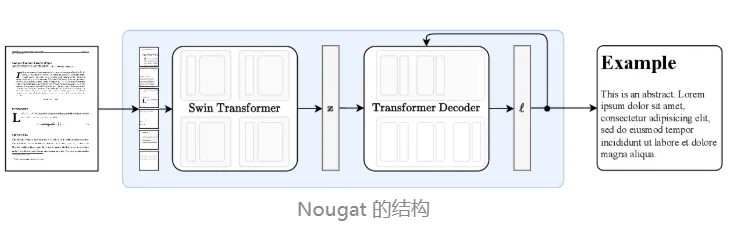
Nougat 的结构:页面图像经过 Swin Transformer 编码,再由 Transformer 解码器逐词生成带标记的文本。图源:Blecher et al. 2023(Nougat),Figure 1
三类方法的取舍大致如下:
最后一格值得多说一句。因为视觉语言模型是逐词生成文本的,它出错时可能真的会写出一段通顺但页面上并不存在的话。这是我根据生成式模型的一般特点做的判断,具体程度要看模型和文档类型。不过下面的实测会看到,专门的结构化工具也会犯很隐蔽的错。
用 GROBID 实测同一篇论文
我在本地用 Docker 跑了 GROBID 0.9.1(这是一个轻量的 CRF 模型版本),把同一个 PDF 交给它,处理耗时约 46 秒,输出 TEI 格式的 XML。和前面直接提取文本相比,它解决了一大半问题:
但仔细看,它也犯了几个错,而且都不容易发现。
一是把带连字符的词拼错了。前面说过,行尾的连字符有一部分是词本身就带的。GROBID 把其中几处 non-alcoholic 拼成了 nonalcoholic,正文里出现了 3 次,但是 XML 原文里一次都没有。
二是表格时好时坏。表 3 被拆成了行和单元格,数字和列基本对得上,只是表头的词序有点乱。表 2 则完全失败了,整张表只识别出一个单元格,内容是一段不相干的残句 ). Bonferroni's test for mul-。另外,表 1 被当成了一个小节标题。
三是最重要的的一个:结果部分里那段包含答案的文字,也就是前面检索实验要找的 ρ = −0.500 那一段,被 GROBID 当成了表 3 的表注,放进了表格的 <note> 里。表 3 在 PDF 里正好排在这段文字的前面,两者挨得太近,被一起划进了表格区域。
结果就是,如果只把 GROBID 识别出的正文小节拿去建索引,这句话在结果部分里根本不存在,检索器再好也找不到它。前面直接提取文本时,这个块至少还排在第 6 名。
解析工具的错误方式各不相同,但共同点是它们都不会告诉你自己错了。
GROBID 在这篇论文上整体比直接提取好得多,可它恰好在最关键的那段话上出了错。所以不管用哪类工具,处理重要文档时都要抽样和原文对照着看一看。
两个比较最常见的坑
把参考文献和页眉页脚当作正文建索引,是最常见的一个。它会自然地发生,因为文本提取工具的职责就是把页面上所有的字都拿出来,它不知道哪些字是正文,后面的切块程序拿到的又是一整个字符串,更无从分辨。这个问题在单篇文档上不明显,一旦语料里有成千上万篇论文就会暴露:参考文献列表里全是其他论文的标题,而标题恰恰是一篇论文里主题词最密集的部分。用户的问题很可能匹配上 A 论文参考文献里引用的 B 论文标题,检索返回的是 A 的参考文献列表,模型读到的是一串作者名和期刊名。页眉页脚则会在每一个块里重复出现,既占位置,又让所有块都带上同样的几个词。
把表格打平成文本,是另一个。表格是二维的,每个数字的含义由它所在的行和列共同决定;纯文本是一维的,提取工具按绘制顺序把单元格一个个吐出来,行和列的对应关系就丢了。上面的表 2 里,如果有人问对照组的平均年龄是多少,答案 47.2 在文本里离对照组这几个字隔了好几行,中间还隔着另一组的数字,模型很可能读错列。比较稳妥的做法是把表格单独作为一个检索单元,保留成 Markdown 或 HTML 表格;或者按行展开,每一行都带上表头,例如:
Table 2, Age (years, SD): all participants 47.5 (10.2); intervention group 47.8 (10.7); control group 47.2 (9.8); p = 0.74 (t-test)
这样无论这一行被切到哪个块里,它的含义都是完整的。
最后聊聊 在 Agent 时代还重要吗
现在的前沿模型可以直接读 PDF。以 Claude 为例,官方文档说明它会把 PDF 的每一页转换成图片,同时提取每一页的文字,两者一起交给模型。对于放进上下文的单份文档,版面、表格、图表,模型看图就能理解得很好,很多解析问题在这个场景里确实被绕过去了。
但这只解决了读一份文档的问题。同一份文档里也写了成本:仅文本部分,每页通常就要消耗 1,500 到 3,000 个 token,图片还要另算。总纲里算过,稍大一点的语料放进上下文都放不下,更不可能每次查询都把几万份 PDF 逐页看一遍。要在大量文档里找东西,依然需要先把它们解析成干净的文本,建好索引。Agent 用 grep 搜文件,前提也是文件里有可以搜的文字。
所以那是那句话,他在Agent 时代解析的位置变了,重要性没有降低。它不再只是建索引前一次性的预处理,Agent 读到某篇文档、需要细看时,还会临时解析一次。无论哪种情况,解析的质量都决定了 Agent 手里的检索工具能返回什么。
索引里是乱码和噪声,Agent 再聪明,搜出来的也是乱码和噪声,它只能多搜几轮,把步数和 token 浪费在上面。
最后
这一篇讲的其实是一件很简单的事:检索系统能找到的,只有解析留下来的东西。
PDF 保存的是字符和坐标,段落、小节、表格、阅读顺序这些对检索最有用的信息,都要从坐标里重新推断出来,推断就会出错。同一篇论文,从 PDF 里直接提取,三分之一的文本是正文以外的东西,一百多个词被行尾连字符切断,表格被打平,一句话被表格从中间劈开。这些损失发生在流水线的最上游,后面的嵌入、检索、重排都无法弥补。
所以做检索系统的第一件事,是先把文档读对:能拿到结构化的源文件就用源文件,只有 PDF 就选合适的解析工具,并且抽样看一看解析出来的结果到底长什么样。
下一篇,我们接着往下走一步:解析好的文本应该切成多大的块,为什么切分方式会同时影响检索和回答。
如果觉得文章有帮助,欢迎点赞关注一波~
我是旷野,带你探索无尽技术!