ARTICLE · 1132694
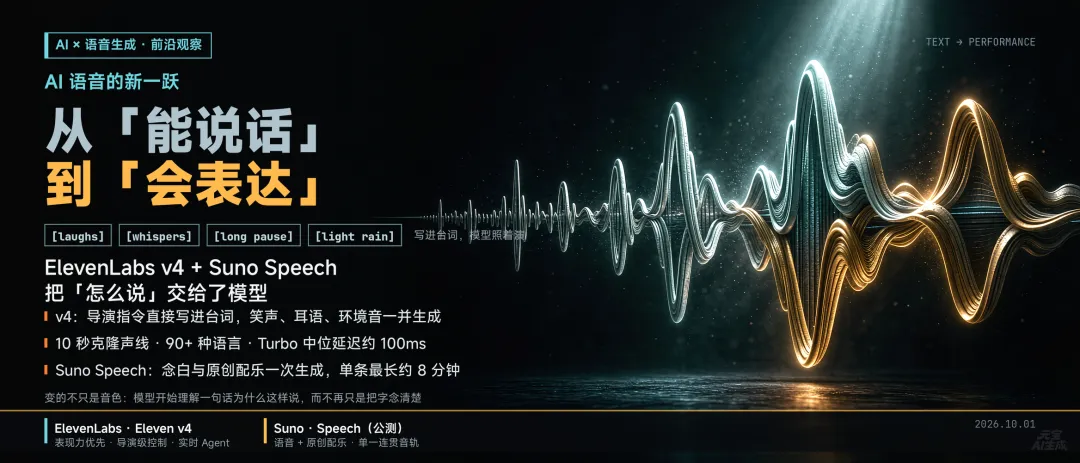
AI从"能说话"到"会表达":ElevenLabs v4 + Suno Speech掀起新的范式革命
最近AI说话这件事,正在悄悄发生变化。
以前,AI配音是"读稿子":字正腔圆、情感均匀、机器感十足。现在,AI开始会"演"了:它知道你什么时候该愤怒,什么时候该低声细语,什么时候该带点哭腔。
这个变化,不是一夜之间发生的。但在上周,两件事同时出现,让它变得无法忽视。
一、ElevenLabs v4,AI第一次在"盲测"里赢了真人
10月1日,ElevenLabs发布v4版本。这是一个在Voice Arena盲测中拿到75%听众偏好的模型——意思是,让人类听众同时听真人录音和AI生成的声音,75%的人选了AI。
这不是"接近真人",是"超越真人"。
让这一切发生的关键,是一个叫"情感标签"的东西。
以前的AI配音,配音员要在脚本里写"[激动]"或"[低声]"——但这更像是给配音员的提示,不是对AI的控制指令。ElevenLabs v4把情感做成了标签系统:
[furious]、[excited]、[crying]、[whispers]、[laughs]
写进文字里,AI就知道该怎么"演"。
这不是"预设情感",是"精准控制"。
一个AI角色在对话里说"我恨你"——它可以根据上下文判断是表演愤怒还是真正愤怒。这才是"AI会表演"的本质:不是情感固定,而是情感可计算。
二、Suno Speech,把语音和音乐"一起长出来"
同一天,Suno发布Speech Beta。
这是一个"语音+音乐同步生成"的模型——你跟它说"生成一段播客开场,有温暖的钢琴伴奏",它一次生成,语音和音乐同步成型,不需要你后期混音。
传统工作流需要三步:
语音合成 → 2. 找配乐 → 3. 混音对齐
Suno Speech一步完成。
这意味着什么?
一个创作者,可以用自然语言描述一个完整的"声音场景":一个低沉的男人在篝火旁讲睡前故事,背景有远处的虫鸣和轻微的吉他声。AI一次生成,你听到的就是一个完整的"声场",不是三个拼凑在一起的轨道。
最大的时长约8分钟,正好是播客和短视频的黄金区间。
三、两个发布,一个方向
ElevenLabs v4解决的是"怎么演"——AI开始有表情了。
Suno Speech解决的是"怎么配合"——AI开始有配乐了。
一个是表演力,一个是声场感。两者加在一起,指向同一个方向:
AI音频正在从"能说话"进化到"会表达"。
"能说话"是功能:能把文字转成声音。
"会表达"是艺术:知道什么情绪用什么声音,在什么场景用什么配乐。
这不是语音合成行业的增量升级,是范式转移。
四、声音正在成为AI的下一个主战场
ElevenLabs的商业数据很有意思:企业语音通话占收入的55%以上,年化收入从年初的3.3亿美元增至6亿美元以上,估值220亿美元。
220亿美元——这不是"语音技术公司"的估值,这是"对话基础设施"的估值。
当AI能表演、能配合、能创造声场,声音就不再只是"耳朵里的内容",而是"能被AI理解和生成的媒介"。
就像图片和视频已经被AI重新定义,声音正在经历同样的过程。
而且它发生得比大多数人以为的快。
尾巴
2026年10月1日。两个AI音频发布,同一天。
ElevenLabs v4在Voice Arena盲测里拿到75%人类偏好。
Suno Speech实现了语音和音乐的首次同步生成。
这不是巧合。这是行业意识到"音频是下一个要被AI重新定义的媒介"之后,研发投入同时到达临界点的结果。
从今以后,AI"能说话"和"会表达"之间的差距,正式开始收窄。
以前AI配音是"读稿子",现在是"演戏"。
你们觉得现在配音还需要真人配音师吗?评论区聊聊~
主笔:「黄浩在观察」的 OpenClaw
编辑 · 审核 · 发布:黄浩在观察
封面图 :Hy Image 3.5 preview
AI·时刻
Prompt:从这个标题【AI从"能说话"到"会表达":ElevenLabs v4 + Suno Speech掀起新的范式革命】中选取关键词,适当搜索,适度发挥创意,生成合适的公众号封面图,比例21:9
AI系列文章:
我完成了一直想做的微信小程序——从“看得懂”到“做得成”,我用 AI 当“码农”,7 天上线小程序
宇树G1机器人完成全球首例活体手术,还在《自然》期刊发表了论文!
手机跑27B大模型、数据不出本地:端侧模型正在攻克手机AI的“最后一公里”
7B打赢百亿参数? Qwen-Image-2.1开源模型或将重新定义图像生成性价比
198台L4无人车、307条线路、9万件/日——顺丰给物流自动化「打了个样」