ARTICLE · 1135847
AI 写轮眼:教你反推一个 Codex Skill
最近,刷小红书看到一个不错的口播视频,满足了我所有的期待和要求:有清晰的面补,不用出镜。
但是很多视频就像这个视频教程一样,要么是说话说一半;要么就是评论区领取,然后半天找不到。
所以,索性我开始自己重新反推这个技能。
这个教程不是教会你某一个视频的制作方法,而是讲解一个反推、拆解 Skill 的方法论;下面也不会给你一个前后顺序的操作步骤,而是很多错误的探索,带你完整地走一遍技能的创建。
用马斯克的话说就是第一性原理:任何事物都存在不可拆分的基本要素。
一个视频拆分到最后,其实就是声音、画面、动效。
声音可以直接录制;画面稍微复杂一点,有不同类别:矢量图标、手绘和真实图片等;动效则包括缩放、滑动、向左、向右等。
技能的创建,我们不必想象成某种专业技能,而是把它当成小孩子的游戏:不同形状、不同特征的积木,搭建起来的一座宏伟城堡。
其实很多新技能,不过是一些基础技能的改良,或者多个技能的混合。
video-shotcraft:视频动效库
doodle-icons:矢量图标库
声音:口播录制 + 脚本文字(实际不需要文字)
画面:多张原视频的参考图,锁定风格、比例等
在这里,我们基本敲定了设想视频的基本要求:手绘风格,3:4 比例,动效、图标组合。
图:先把文案、音频和画面素材拆成可组合的基本输入
我们通过自然语言,根据 Skill 创建的效果来不断迭代。
底层原理上,这类视频都是 Hyperframe 或者 Remotion 框架上的逐帧渲染。真实技能的创建经过多轮迭代,可能和最初的模样大相径庭。
没有调用矢量图标库。
画面风格不是手绘字体。
字体颜色、内容过于 AI 味。
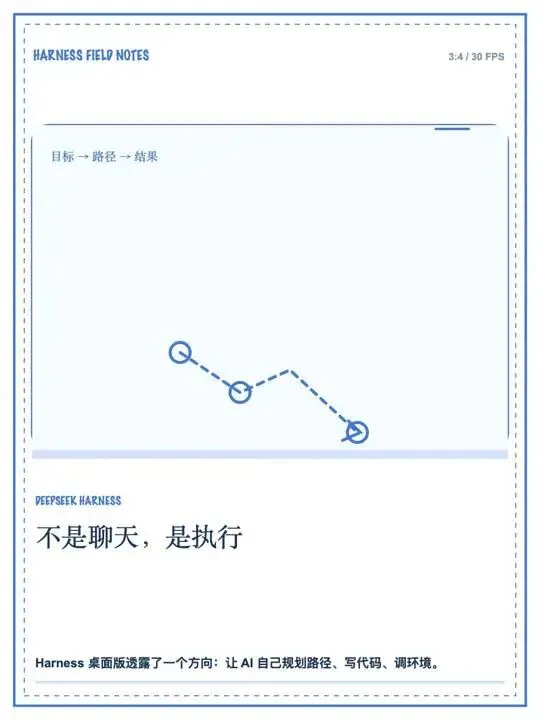
这一轮试错,我应用了两个技巧。其一,把参考视频截图作为参考图,来确定视频的风格;其二,进一步优化提示词,在图标、配色、风格提示词上提升细节。
缺陷仍然明显。虽然已经初步具备了手绘特点,但是图标还是缺乏复杂度,内容过于单调。
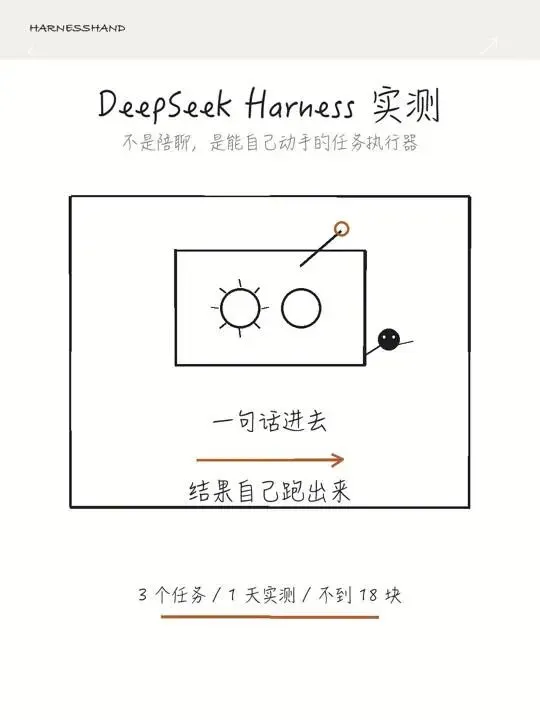
接下来,又是不停地挑刺:
1. 优先确保清晰度,手绘不影响清晰度。
2. 做好排版对齐,手绘不代表混乱;标记的红线起码要和对应的字对齐。
3. 手绘图标,能采用仓库的就采用仓库的资产,不要手绘。
4. 手绘主要解决的是线条、框架、字体这些简单的关系,而不是复杂图标。
5. 检查图标库,要不要再拓展丰富一些开源资源。
请你严格思考这些问题,执行。
反复多次修改后,才慢慢有了雏形和轮廓。
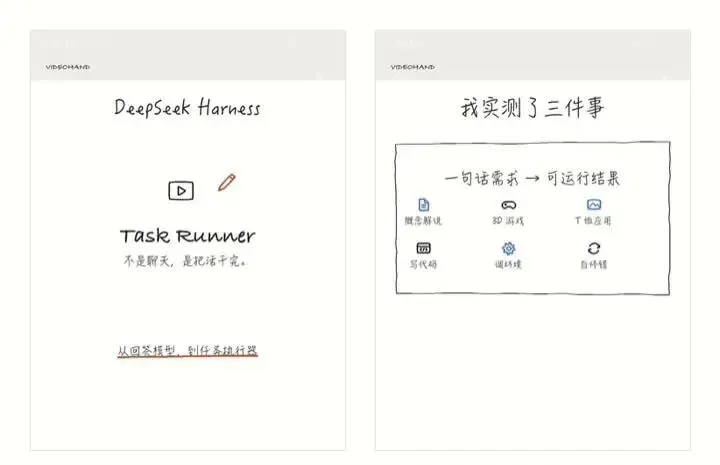
看起来很简单,但是上面一轮的试错和跑图,也花掉我一晚上的时间,才得到了想象的效果。可想而知,一个技能的创建,并没有想象中的容易。
我还面临着 3 项阻碍:声音和画面对齐的问题;如何锁定每一帧的画面;优化工作流程。
声音对齐画面,根据我的推论有 2 种思路。
一种是生成音频后,我再去配音。这个没有尝试,我担心我跟不上画面速度。当然,也可以采用分段录制、调整音轨速度的办法。
另外一种是让 Codex 标记音轨速度,音频转文字,文字转图片,转动态帧视频。
我要求:1. 画面长度和音频长度保持一致;2. 根据音频确定画面,2–6 秒生成一个关键帧,从而避免视频在一个关键帧停留过久。
效果还是很不错。我发现整体开头和结尾的速度对齐了,时长也是一致的。但是细节上,还是有 3–4 处没办法对齐,因为我的声音是忽快忽慢的,时长是不定的。
我尝试了很久,才发现音频根本和画面无法真正对齐。后面看到其他人同类视频的创作思路,才明白,原来大家都是通过后期剪辑来优化的。
Codex 生产了很多帧,跑了 40–50 张图,但是我发现依赖技能自动生成的图片,总是不尽如人意。要么缺乏创意,要么画面简陋。
除此之外,很多复杂图案,矢量图标库没有对应图标,手绘的又十分简陋。我开始重新思考,如何锁定每一帧的画面和动效。
我重塑了工作流程:
浏览器自动化(搜集额外的素材图片) → 口播视频设计表(素材、动效的脚本) → 技能生成分段视频 → 二次生成不合格的视频 → 剪映合并剪辑
图:为每句话配置一个视觉重点,避免画面只是在“陪跑”
这整个的思路,我代入了剪辑的思路到其中。用浏览器搜索的手绘风格图片,来丰富技能本身资产的不足,把这部分图片作为视频的补充。
同时,在工作流程中,加入动效表格和画面设计的脚本,人工参与到前期的设计和检查中。
为了解决对齐问题和画面效果问题,我把完整的视频拆分成每个独立的段落,每个段落 2–6 秒。对不合格的视频,二次生成效果,最后统一在剪映后期处理和合并导出。
在这一步,我实现了音画同步,解决了画面质量问题。
图:不用出镜,也可以用画面、声音和字幕完成表达
得到初步效果,这只是技能的一部分。虽然效果可以,但是我们发现,这种技术路线逐帧读取本身意味着多张图片生成、逐帧合并,速度真的太慢了。
叠加素材搜集和修改,这个和剪辑都快一个速度了,一次需要 2–3 个小时。
其实在反推技能的时候,我已经盯着思维链,质疑很多不合理的需求。
比如:后期明明要剪辑,为什么还要合成音频,这不是消耗 Token 和延迟速度吗?明明已经生成视频,不可撤回,但是 Codex 居然启动时还检查,检查导出和要求的一致性;明明可以一条龙导出,脚本和画面动效在后台运行即可,不需要人工参与。
大概是五类问题:后置检查、产出要求、视频素材和特效要求。中间出现很多奇奇怪怪的问题,产出了一些脚本甚至图片,这些其实都可以砍掉,对整个工作流程没有任何影响。
1. 取消或弱化后置人工检查:不再等完整视频渲出来后,再人工看哪里错。
2. 检查前置:先用静态关键帧 + 动效设计表确认排版、元素、触发关系、入场帧、Hold 帧。
3. 短片段化输出:每段 2–6 秒,哪里不满意只重做对应编号,不重渲整条。
4. 无声片段交付:音频只做节奏参考,避免音频合成拖慢。
5. Cue 表冻结后再渲染:字幕和动效从同一份数据派生,减少返工。
技能不是一次生成的答案,而是一套在使用中不断被修正的工作流。
经过六轮反反复复地修改,才终于拿到了可以用的技能包。
很多技能的创建并不是一蹴而就的,更多的可能是花费数周,甚至 1–2 个月时间才完善的。
我们可以在使用过程中,不断优化资产,调整工作流,慢慢积累出带有个人 IP 风格的技能。