ARTICLE · 1143107
3个AI工具实测Computer Use,国产vsChatGPT谁更胜一筹?
↑↑↑点击上方蓝字【程序喵有话说】,关注+星标吖
最近 AI 圈大火的Computer Use,核心就是让 AI 接管键鼠,直接像人一样操作电脑软件。这项能力最早由 ChatGPT 背后的 Codex 率先引入;恰逢国庆假期,国内各大 AI 厂商接连放出多轮免费福利,我也顺势下载体验了 Qoder、ZCode 两款国产 AI Agent 工具。
一边是海外成熟方案,一边是奋起追赶的国产选手,不禁让人好奇:国产 VS ChatGPT,Computer Use 实际能力到底孰强孰弱?
为了拿到客观可复现的结果,我设计了一组对照实验。控制统一环境:同一台电脑、Windows 自带「画图」软件,执行完全相同的指令:打开画图,画一面五星红旗。
ChatGPT(Codex)后端接入 DeepSeek‑flash Qoder 接入自家旗舰 flash 模型Qwen3.8-flash ZCode 接入自家旗舰 flash 模型Glm5.3-flash
很多人对 Computer Use 的固有印象是:AI 死死盯住屏幕,模仿人手点点拖拖完成操作。 可当我导出全部运行日志,搭建日志回放工具逐帧复盘全过程,一个反常识结论摆在眼前:绝大多数时间,AI 根本就没有在 “看屏幕”。GUI 鼠标点击,只是万般无奈之下才启用的最后备选。
先上三组成品直观对比,高下一眼可见👇
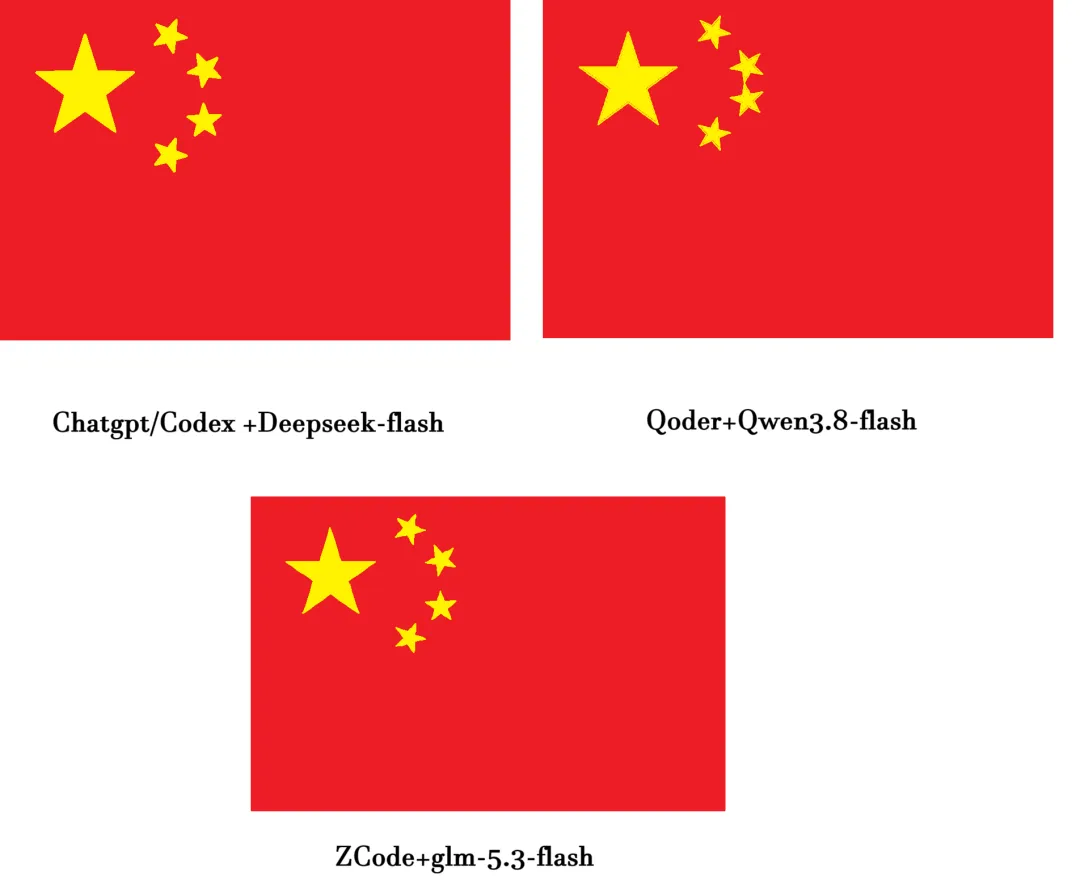
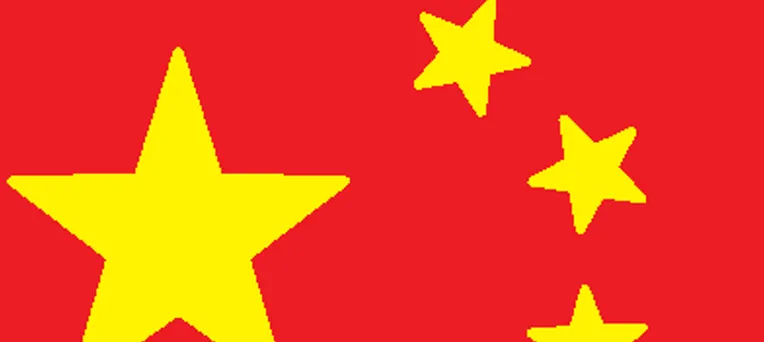
ChatGPT/Codex + DeepSeek‑flash:本次横评综合表现最好,五星位置、旋转角度高度贴合官方绘制规范,仅有个别线条不够笔直;
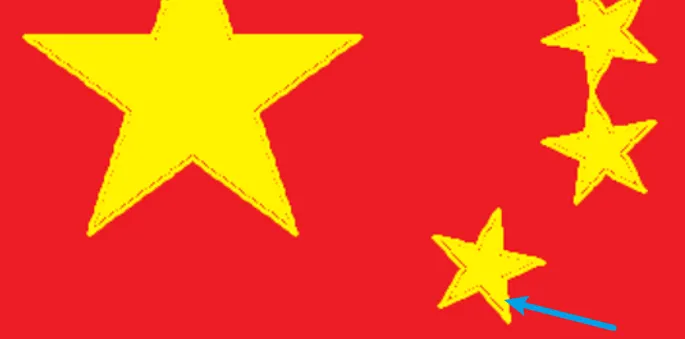
Qoder:能够完整完成绘制,但五角星外框和内部黄色填充之间存在明显缝隙,并且五角星的位置有轻微重叠;
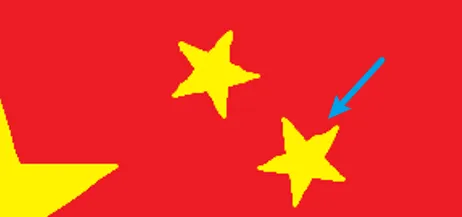
ZCode:整体构图没问题,但部分手绘线条存在凹陷瑕疵。
成品大体都能看,但真正拉开差距的,是 AI 面对障碍时的处理思路与执行过程,这也是本次测评最值得深挖的部分。
同样画国旗,三个AI,三种截然不同的解题风格
没有绝对的非黑即白,国产两款工具和 ChatGPT,走出了完全不一样的技术路线,也造就了上面的成品差异。
Qoder+Qwen3.8-flash:遇山开山,自己造工具的硬核国产工程师
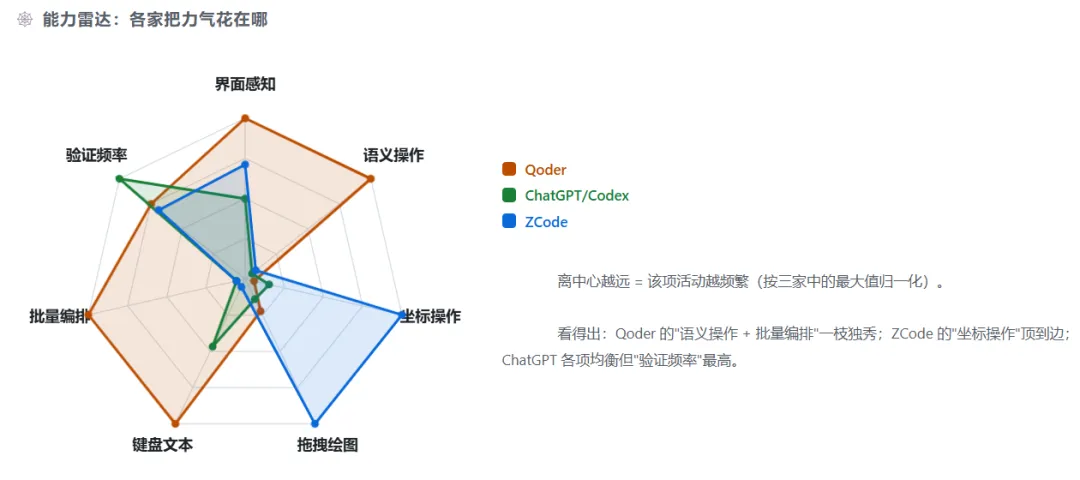
Qoder的做事逻辑很有工程师味道:优先读取系统控件信息做语义操作,能批量打包执行动作,就绝不拆分反复点击。
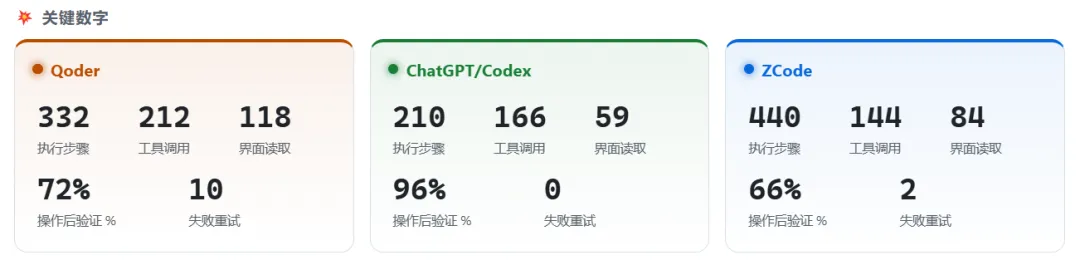
但很快就撞上现实大坑:画图这款老旧软件不接收虚拟鼠标移动指令,仅识别鼠标按下、抬起两个信号,中间拖拽移动轨迹会直接被系统吞掉,画出来全是生硬直线。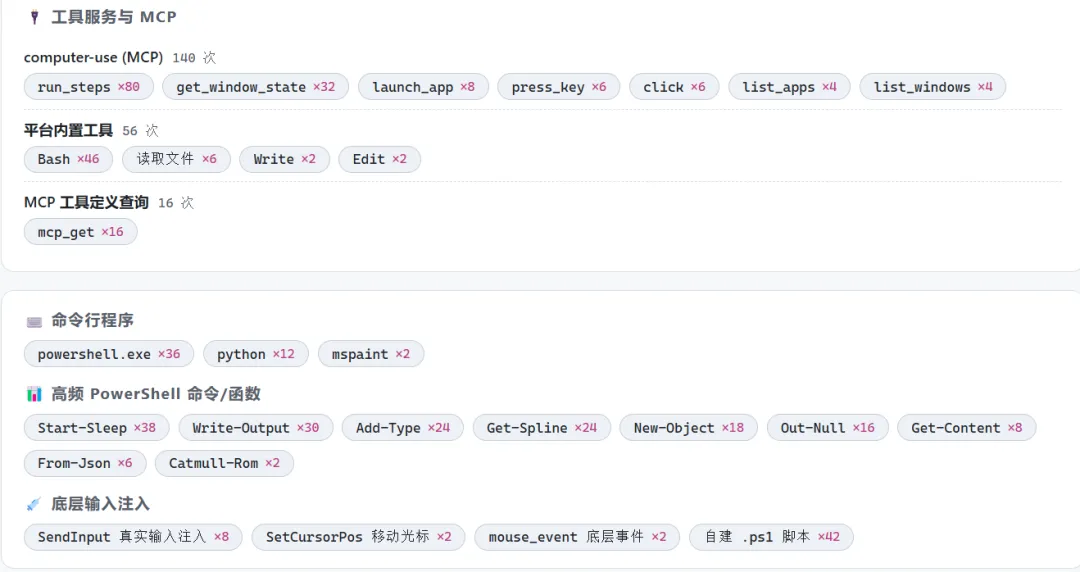 很多AI遇到这种阻碍,大概率直接妥协,随便画个简陋五角星交差。但 Qoder 选择硬刚底层限制: 调用 Windows 系统底层 API,用 SendInput 注入真实鼠标数据流;手写 Catmull‑Rom 样条曲线算法,把线条拆解成密密麻麻的点位模拟人手运笔;前后落地42 个独立 PowerShell 脚本,精密计算大小五星的坐标、旋转角度,完成轮廓绘制与填色。
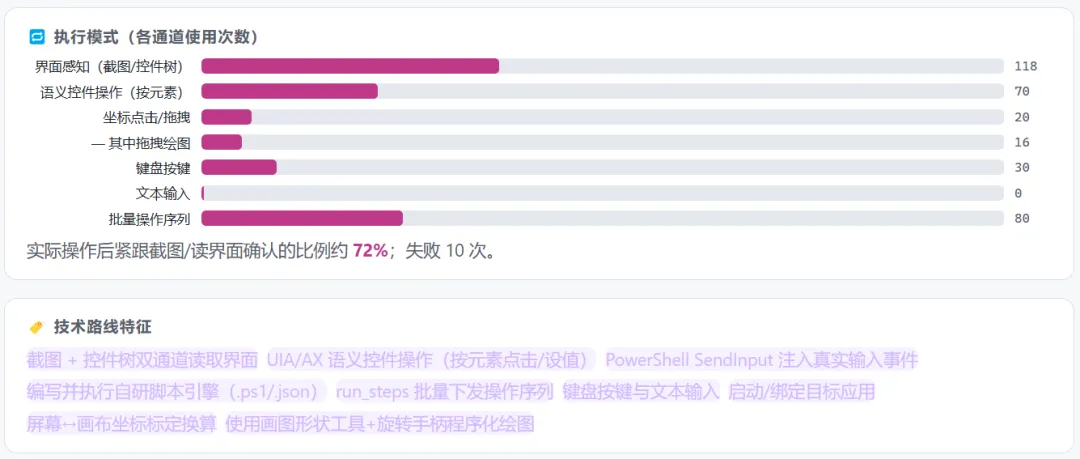 全程累计失败 10 次,每一次报错,它都会复盘根因、更换方案继续攻坚。 像极了职场里碰到棘手需求,不抱怨不躺平,默默重写整套工具链的技术大佬。
小彩蛋:中途我测试提问画图是否支持自定义角度旋转,它一开始凭印象笃定只能 90° 旋转;打开菜单核验之后,又老老实实推翻自己的判断,主动认错。
ChatGPT(Codex)+DeepSeek‑flash:步步谨慎,拿下全场最佳成品的学霸
作为 Computer Use 概念的先行者,ChatGPT 这套组合,也是本次测评里成品质量最优的一方。
它采用保守稳妥的 “小步快跑” 模式,96% 的操作都会配套截图校验,是三者中验证密度最高的。整套任务走完 210 步,做到工具调用 0 失败。
不是全程一路坦途,而是潜在风险、异常问题,都在每一步截图复核的环节就被提前拦截。
正式绘图之前,它先查阅国旗官方绘制标准,把大星、四颗小星的坐标、旋转角度全部核对到位。没有选择手动拖拽手绘,而是复用画图自带的五角星形状工具,逐个摆放、调整旋转角度,保证每一颗小星的尖角精准指向大星中心。 碰到软件原生 bug:调色面板唤起后键盘输入会卡死,它不会暴力操作,如实记录这个问题,改用调色板点选拾取标准红色。
唯一瑕疵仅为少量线条不够笔直。短板在于步骤细碎重复,执行速度不算快,但规格、布局、色彩的完成度遥遥领先。
ZCode+glm5.3-flash:敢冲敢改,被挑错就返工的实干国产选手
ZCode 是非常极端的坐标派,98% 的操作直接依靠屏幕坐标完成,很少读取界面控件树信息。
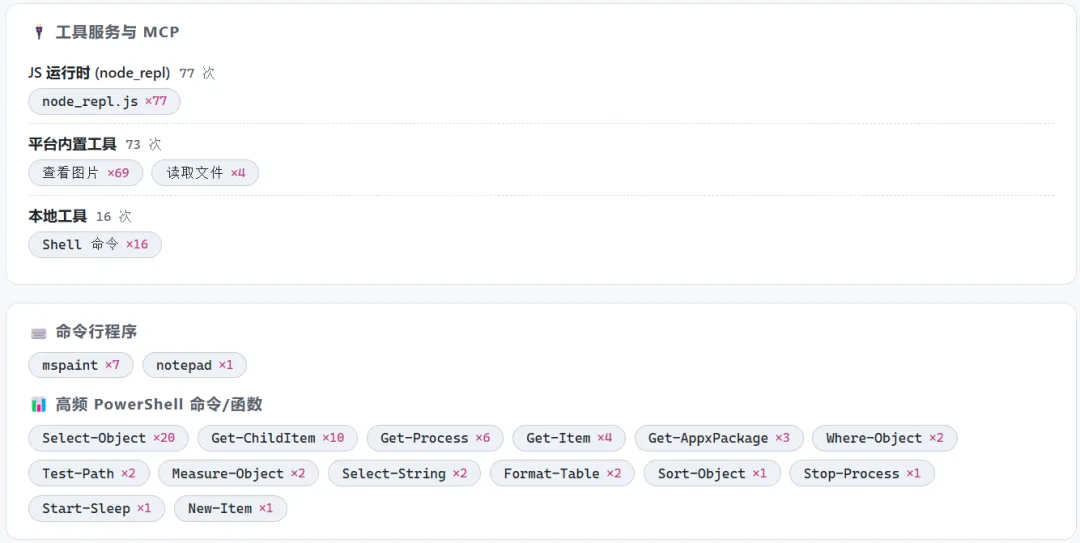
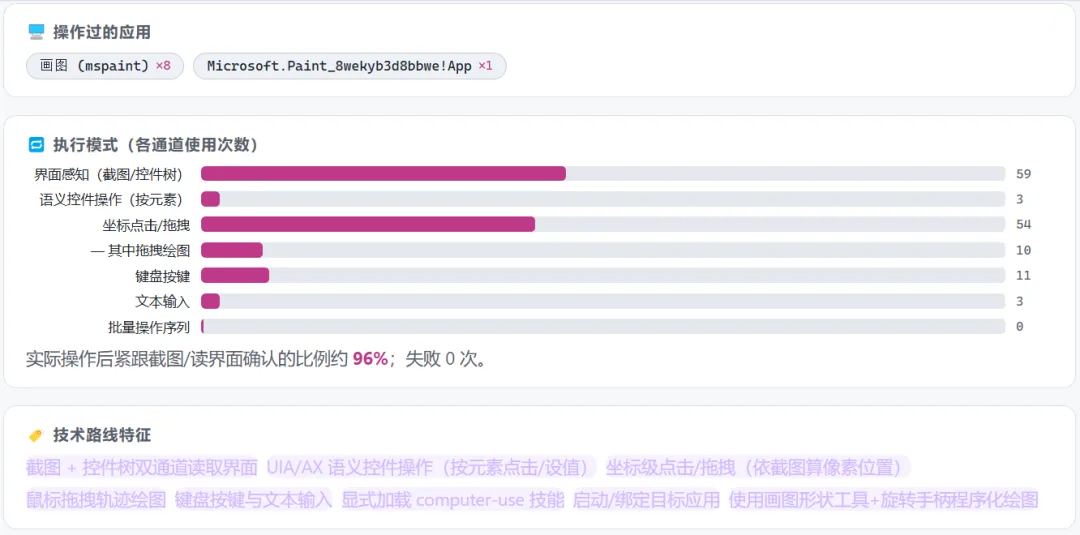 但它并非盲目乱点,有很专业的前置动作:动手绘画前先做坐标系标定。 截图的像素坐标和画布实际绘图坐标会受缩放影响错位,它先拉出已知像素尺寸的选区,测算缩放系数,校准画布原点,后续所有绘图点位全部经过换算。
绘制五角星不调用系统预设形状,直接鼠标拖拽一笔勾勒五星轮廓,再填充黄色。
它也是整场测试最具备 “人味儿” 的选手,上演多轮人机质检拉扯:
我质疑:“你自己检查画面了吗?” → 立刻启动完整自查; 我指出:“五星位置不对,应当集中在左上角!” → 对照 15×10 国旗网格重新排布全部星星; 我反馈:“星星填充和轮廓之间有细缝隙” → 马上迭代修复细节。
即便经过多轮修改,成品依旧遗留缺陷:部分线条出现凹陷。它没有掩饰问题,如实说明这是像素级拖拽模式下的物理局限。有错就改、接受反馈迭代,交互感拉满。
测评深挖:两条技术分岔口,决定 AI 的最终上限
三套 AI 底层基础框架其实是相通的:统一走「感知→决策→执行→校验」循环,都会先绑定目标软件窗口,操作完成后都会做截图校验。 国产两款工具和 ChatGPT 真正拉开体验差距,来源于两个关键的技术抉择。
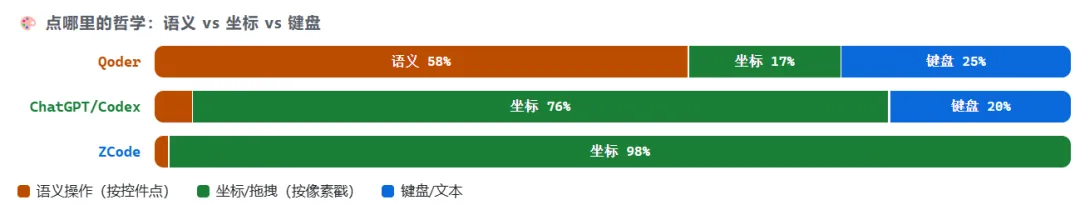
第一个抉择:优先信任控件树文本,还是信任截图画面?
Qoder 偏向控件树语义:依托系统无障碍信息,稳定性强,但极度依赖软件本身的适配程度; ZCode 偏向截图坐标:通用性极强,只要屏幕能显示就能操作,但一旦窗口移动、缩放,整套坐标体系直接失效,需要重新标定; ChatGPT 处于两者中间,平衡两种感知方式。
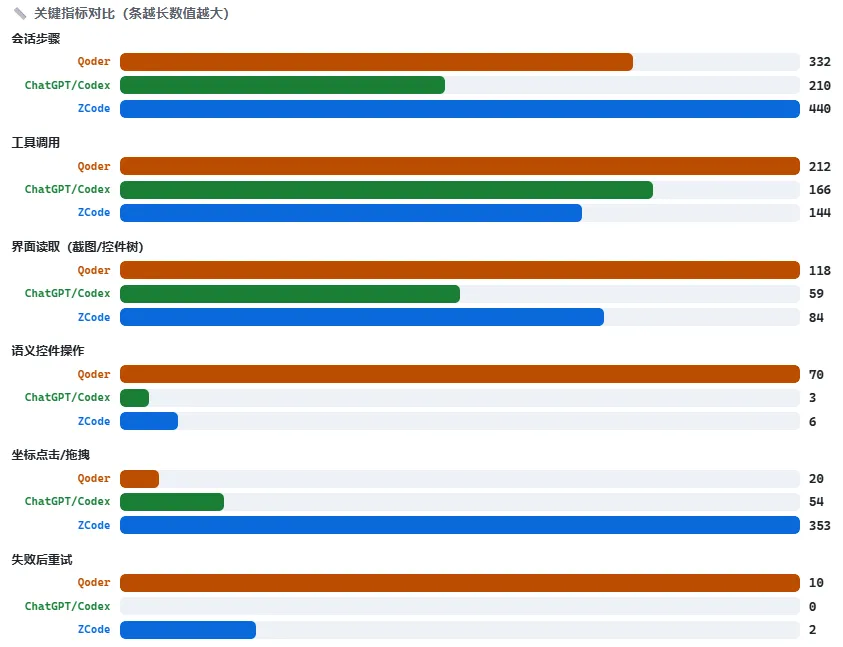
第二个抉择:遇到现有能力搞不定的难题,该怎么办?
Qoder 选择翻墙:现有工具能力不足,就自己写底层脚本创造条件; ChatGPT 选择绕墙:手绘路径行不通,就换软件自带功能曲线达成目标; ZCode 选择硬闯:效果达不到预期,那就反复重算、反复修改打磨。
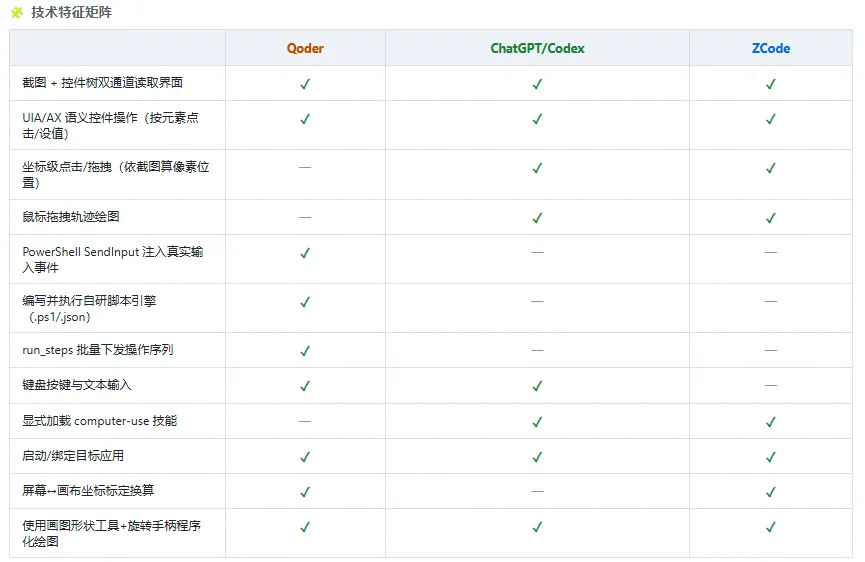
不存在绝对完美的路线,各有取舍。
这里也要破除一个网上很流行的误区: 不少观点鼓吹 GUI 时代到来,命令行、脚本会就此消亡。但本次实测恰恰得出相反结论:鼠标 GUI 点击,只是 AI 的兜底手段。API、脚本、命令行,才是 AI 操作软件的首选通道。
AI 处理文本的效率,远高于解析图片。当下火热的 MCP 协议也是这个逻辑:软件对外开放的结构化接口越完善,AI 就越能把软件用到位;软件越封闭,AI 才不得不像 Qoder 一样,用硬核底层方案硬啃。这里推荐大家去看B站的一位UP主 “飞天闪客” 的解读视频,理解的会更深刻一点。
搞懂 Computer Use:AI 到底是怎么操控电脑的?
看完国产工具与 ChatGPT 的实战对比,很多人会好奇,Computer Use 背后的底层原理是什么?
三款工具表层表现差异巨大,但底层流水线高度统一,分为三层:
👀 眼睛|感知层 AI 的主要信息来源并不是截图,而是操作系统自带的无障碍控件树(Windows 为 UIA)。 这套技术原本服务视障读屏软件,会把界面翻译成结构化文本。AI 读取文本,更省算力、节省 Token。 截图更多作为备用兜底:遇到游戏画面、自定义绘制界面,控件树无法读取信息时,才会启用截图做校验。
🧠 大脑|决策层 大模型结合控件文本 + 截图信息,推理输出标准化动作指令:点击控件、点击指定坐标、输入文字等。
🖱️ 手|执行层 Windows 提供两套执行能力。普通合成鼠标事件用来点击按钮足够;想要模拟真实拖拽轨迹绘画,就必须调用 SendInput 完成真实输入注入。
这套技术构想二十年前就已经存在,为什么直到近年才爆发?主要是因为四道曾经跨不过的门槛终于被打通:
多模态大模型成熟,AI 真正具备看懂屏幕画面的能力; 坐标识别精度提升,鼠标点击不再频繁跑偏; AI 工具调用协议标准化,MCP 问世,读取界面、模拟键鼠变得简单; 大模型长任务规划能力升级,可以稳定支撑上百步长流程,不会中途遗忘目标。
总结
客观来说,三款 AI 绘制的国旗,都能给到 80‑90 分,国产两款工具已经展现出不俗实力,但在成品完整度、规范性上,ChatGPT依然略占上风。当然,本次测评的任务比较简单,所采用的模型也不统一,不能够完全反映出 AI 编程工具的真实能力,或者说 AI 编程工具的能力也要依赖于AI模型的能力。
但是,比一张最终图片更有价值的,是面对同一个任务,中外三套 AI 完全不同的解题思路。
看完本次横评,你觉得 Computer Use 国产工具,还有哪些地方需要追赶?
如果是你,你更认同哪一种做事方式?
是遇山开山硬核造轮子?步步小心求稳?还是不怕出错、反复迭代的实干派?
设为【星标】,更容易收到推送哦↓↓↓