ARTICLE · 1143111
当 AI 变成水电煤一场都灵演讲 与创业者剩下的位置
创 业 者 视 角
当 AI 变成水电煤
一场都灵演讲与创业者剩下的位置
2026 年 10 月 8 日,意大利都灵,Wave by Vento 峰会。
这一天,距离阿里巴巴宣布那笔 800 亿港元的配售,过去不到两个月。这笔钱只有一个用途:全栈 AI。
一个中国人站上台。他没有讲产品,没有报业绩,先抛出一个判断——五年之后,人们可能不会再单独讨论 AI 了。
他叫蔡崇信。
这句话听起来像一句恭维,像是在夸 AI 终于不需要被解释了。
但如果你是一个创业者,它更像一句判决。
因为过去三年,很多公司的商业模式压缩到极致,只剩下一句话:我在做 AI。
这一篇,我想把这句话拆开看看:它到底对谁说,说了什么,以及——它给创业者留下了什么位置。
01
一句话的杀伤力
先把那句话再读一遍:五年之后,人们可能不会再单独讨论 AI 了。
它的意思是,AI 会像今天的互联网一样,融进每一项业务、每一个环节,变成大家习以为常的东西。
蔡崇信还补了一句更重的:AI 不是某一个产品、某一个功能,它更像是下一代的基础能力。它会慢慢沉到各行各业的底层,变成像水电煤一样的存在——看不见,但离不了。
这是全场最狠的一句话。
但它狠的不是 AI。是那些把 AI 当卖点的人。
回头看二十年,这个规律其实演过一遍了。
2000 年前后,一家公司说自己「触网了」,是能上新闻的。到了 2010 年,没有一家公司会把这三个字写进简介——因为所有人都有了。
当一样能力成为标配,它就不再是竞争优势,而是准入门槛。
AI 正在走同一条路。今天你做一个产品,说一句「我用了大模型」,还能吸引人。五年后,这句话会变得像「我用了电」一样多余。
其实这件事已经演过一个小版本了。
2023 年,「百模大战」是最热的词,人人都在数参数;到 2026 年,已经很少有创业者主动提参数了——提了也没人惊讶,因为谁都能拿到。
热词的寿命在缩短。而商业模式的寿命,比热词更短。
所以真正需要警惕的,不是同行太多,是卖点本身会到期。
而基础设施还有一个更残酷的特征:它的利润是被压住的。
电很伟大,但很少有人靠卖电成为首富。因为基础设施的定价,最终会被公众、被监管、被竞争者,一起压到一个薄薄的区间里。
AI 会走上同一条路:当它变成水电煤,卖 AI 会越来越不赚钱,用 AI 才会。
顺便说,这也是为什么那句话,对创业者比对大公司更重。
大公司可以把 AI 变成自己的业务能力——灌进电商和物流,效果直接体现在成本表上。
而如果你的产品里只有 AI,那么当 AI 变便宜、变普及,你的产品也跟着变便宜。
「不是因为 AI 不灵了。是因为 AI 变成了空气。」
于是,AI 从「行业」退化成「能力」的过程,就是一批公司无声消失的过程。
但这句话还有另一面,很少有人讲。
能力会消失,问题不会。
蔡崇信把阿里的历史切成两段:1999 年到 2023 年是 BC 时期,任务是不断把业务规模做大;2023 年之后进入 AD 时期,核心只剩两件事——电商,和全栈 AI。
阿 里 的 两 个 时 代
2023
转折之年。此前做规模,此后只做电商与全栈 AI
这个分法本身就是一个信号:连一家已经足够大的公司,都要重新给自己划定边界,只留下两件必须亲自做的事。
那么创业者呢?我们先把巨头那条路看清楚,再回来看自己。
02
全栈的账本
蔡崇信在台上系统讲了一层阿里的架构。
最底下是算力,靠阿里云十几年的积累托着;中间是模型,就是千问,也是全球应用最广的开源大模型之一;最上面是应用,把 AI 灌进电商、云服务、物流这些具体场景。
他给这套结构的评价只有两个字:可控。
自己的模型跑在自己的算力上,再在自己的业务里反复打磨。这一圈一旦转起来,外面的人很难插进去。
这一圈里最值钱的,其实是那条回路:业务产生数据,数据喂给模型,模型再反过来提升业务。
有回路的人,越跑越快;没有回路的人,只能租能力。
而租来的能力,定价权不在你手里。
但我想给创业者看的,不是这三层,是这三层的账单。
2025 年 2 月,阿里宣布未来三年投入 3800 亿元,建设云和 AI 硬件基础设施。
到 2026 年 6 月底,这笔计划累计投入约 1900 亿元——刚过半。
其中 2026 年二季度单季的资本开支是 677 亿元,同比增长 75%,创下近三年单季新高。
2026 年 8 月,阿里又配售新股募资 800 亿港元,净额全部投向全栈 AI 能力建设。
这不是阿里一家的选择。
2026 年二季度,腾讯单季资本开支 527.84 亿元,同比增长 176%。同一个季度,几家大厂都在做同一件事:把钱变成算力。
换句话说,全栈不是一条被谁验证过的路,而是一场正在同时开打的军备竞赛。谁先停下,谁就先出局。
这些钱不是利润,是现金。
代价写在报表的另一栏:阿里的自由现金流,从 2024 财年的 1562 亿元,变成了 2026 财年的负 466 亿元。
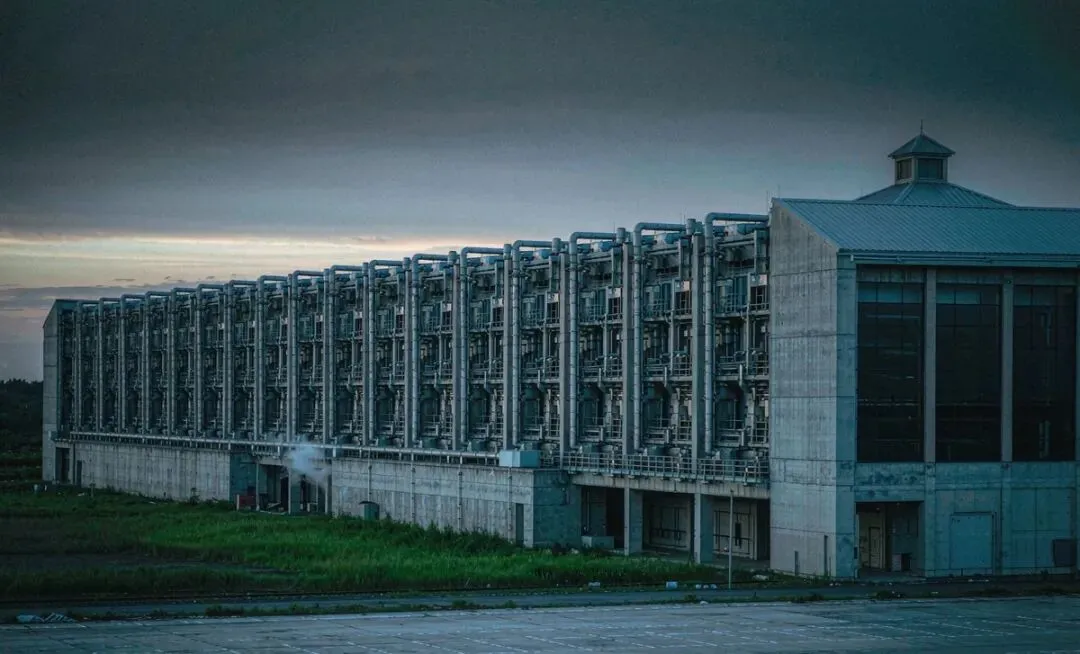
数据中心外景。算力不是概念,是钢筋、电力和现金流。
单 季 资 本 开 支
677 亿元
2026 年二季度,同比 +75%。平均每天花掉七个亿
所以,全栈到底是一张什么样的门票?
它是一张要求你先掏出几千亿、把算力造出来、再等两三年才可能回本的门票。
阿里管理层自己算过这笔账:按现有 AI 产品的毛利率水平,如果资本开支的回收周期是三年,把业务增速控制在 33% 以内,理论上就能保持正向现金流。
但他们选择继续把增长放在前面。理由也简单:AI 还在非常早期,现在收缩,等于把位置让出去。
这句话翻译过来就是:这门生意眼下拼的,是谁敢在还没赚钱的时候,先把钱花出去。
再往里看一层,有一个数字很有意思。
同一个季度,阿里的 AI 云与算力服务收入 484.37 亿元,同比增长 45%,利润同比翻了一倍多。
而「AI 实验室与应用」这一块——也就是模型和消费级应用——收入 33.38 亿元,经营亏损 138.61 亿元。
云在赚钱,应用在烧钱。
这说明即便对阿里,越靠上的那一层,越难做出利润。
而这恰恰给创业者留了一道缝:最难的那一层,也意味着胜负未定。已经分出胜负的地方,才轮不到你。
创业者做不了这件事。
不是说你不能有雄心。是说这张门票的形状,从一开始就是为巨头设计的——它比的是资产负债表,不是聪明程度。
「全栈是一种资格。而资格,是要用钱买的。」
既然如此,创业者的位置在哪里?
03
开源,是唯一的杠杆
蔡崇信在演讲里讲了一段关于开源的判断。我认为那是全场对创业者最有用的部分。
他说,现在美国头部 AI 公司越来越封闭,前沿研究不再公开;而中国企业普遍走开源路线,就像顶尖大学开放教育资源一样,推动技术普惠。
这段话听起来像价值观表达。
但对创业者来说,它是生存条件。
因为没有开源,你连入场券都拿不到。
看一组数字。
千问系列自 2023 年开源至今,已经累计开源 460 余个模型,衍生模型超过 30 万个,全球累计下载量突破 30 亿次。
Hugging Face 的报告给出了更细的切面。
2026 年前七个月,千问在单一平台上的下载量达到 20.45 亿次。
同一个口径下,Google 是 4.18 亿次,Meta 是 2.27 亿次。
基于千问的衍生模型超过 15 万个,是 Meta 的 2.6 倍、Llama 系列的 4.7 倍,而且还在以每天约 200 个的速度往上加。
还有一个容易被忽略的细节:许可协议的宽松程度。
有统计显示,中国 200 亿参数以上的模型里,八成以上采用可商用的宽松许可;而美国同量级的模型,这个比例不到三成。
对创业者来说,这一条比参数重要得多。因为它决定了你做出来的东西,能不能名正言顺地拿去卖。
千 问 全 球 累 计 下 载 量
30 亿次
开源 460 余个模型,衍生模型超 30 万个
这些数字,对创业者意味着什么?
意味着模型这一层的成本,从「自研」变成了「集成」。
你不需要再花几十亿去训一个基础模型。地基是免费的,而且是全球最好的那几块之一。十年前想做一个 AI 公司,你得先有钱买算力;今天,你需要的是一台电脑和一个好问题。
但开源那一方的算盘,也要看懂。
开源从来不是慈善,是分发。谁的模型被用得越多,谁就定义了默认标准——开发者习惯了它的接口、它的工具链、它的踩坑经验,就很难再换。
所以开源,本质上是一场关于「默认」的争夺。
还有一层更实际的意义。
开源把「技术能力」变成了公共品,于是竞争的重心整体后移了——从「谁能做出来」,变成「谁更懂行」。
这对小团队是好消息。因为懂行不需要上市公司的预算,它只需要你真的在那个行业里待过。
但这里有一个反直觉的推论,也是我最想强调的一点。
当地基免费、人人都能盖房子的时候,房子就不值钱了。
「模型会越来越便宜。位置会越来越贵。」
所以创业者的创新,不该发生在模型那一层。那里是全球最不缺钱、也不缺聪明人的战场。
它该发生在哪儿?发生在模型做不了的最后一公里——那个需要行业知识、需要现场经验、需要有人愿意干脏活的地方。
04
真正的富矿,在物理世界
蔡崇信在演讲里点出了中国 AI 的两个别人比不了的优势。这两点,我认为是给创业者划的重点。
第一个是制造数据。
他说,中国占了全球差不多 30% 的工业生产,工厂里积累的海量生产数据,用来训练 AI,可以直接帮企业提升良率、优化设计。
这个数字站得住。中国制造业增加值占全球的比重已接近 30%,连续十六年保持全球第一。
但关键不在比例,在性质。
互联网上的数据,巨头也有。而一条产线上、一台设备里、一道工序中长出来的数据,只有扎进那家工厂的人拿得到。
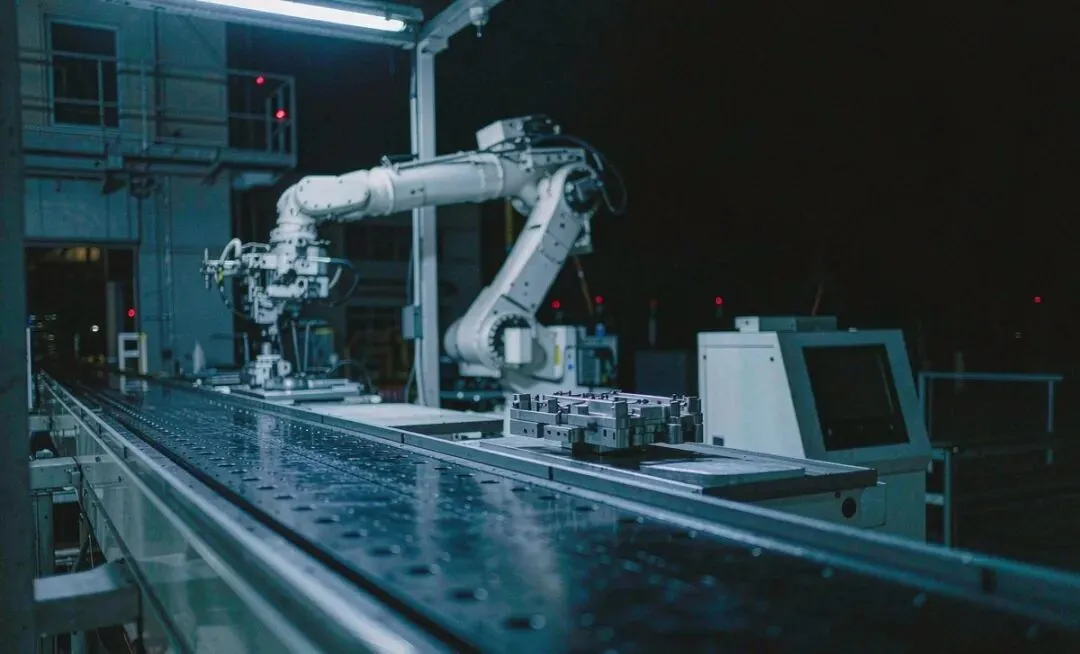
深夜的精密制造车间。这里长出来的数据,不在任何一家大模型的训练集里。
这类数据有一个特征,我把它叫「独占数据」:它不公开、不可爬、不可买。你要么在里面,要么拿不到。
而这类数据的载体,还在快速增加。
截至目前,中国已累计建成三万余家基础级智能工厂、八千余家先进级、五百余家卓越级。
每一座,都是一台不停生产数据、却还没有被充分开采的矿。
而这恰恰是巨头最难受的地方——它有钱、有算力、有全世界最好的模型,但它进不去每一个人的车间。
第二个优势,是硬件供应链。
蔡崇信说,从电动车到机器人,中国有最完整的产业链。未来 AI 要和物理世界深度融合,这就是硬实力。
这句话可以落到具体的产业上。
中国的具身智能市场规模,从 2018 年的约 2133 亿元,预计到 2026 年达到 1.09 万亿元,年均复合增速在两成以上。
这个行业里,中国拥有全球唯一、也最完整的全链条产业配套——从核心传感器、伺服电机、谐波减速器,到整机组装、算法适配。整体制造成本比国外低 30% 到 50%。
拆开看这个市场:工业机器人占了约 45%,服务机器人约 25%,特种机器人约 15%,人形机器人目前只占 5%——但增速最快。
这个结构说明了一件事:真正在赚钱的,往往是那些不酷的场景。
电力巡检、应急消防、仓储搬运、产线上料。它们不上新闻,但它们在付款。
中 国 制 造 业 增 加 值
近 30%
占全球比重,连续十六年保持全球第一
再往下看,人形机器人的变化更快。
2025 年,全球人形机器人出货 1.3 万台,出货量前五名全部是中国企业;美国那两家最有名的公司,分列第七和第九。
摩根士丹利在 2026 年内两次上调中国出货预期——从年初的 1.4 万台,到年中的 2.8 万台,再到 5 万台,预测值几乎翻倍。
不过这里要泼一盆冷水。
人形机器人的出货涨得快,落地却很慢。一年五万台的量,摊到具体的工厂里,仍然是一个很小的数字。
所以真正的机会,往往不在整机,而在那些同样「不酷」的环节:关节、传感器、减速器、控制系统。
产线上的机械臂。数字世界的 AI 已经挤满了人,物理世界的 AI 才刚刚开场。
把这两点合起来说,就是一句话。
数字世界的 AI,已经卷成了红海;物理世界的 AI,才刚刚开场。
而在这条新赛道上,中国的创业者手里拿着的,是全球最好的一副牌。
所以,创业者现在最该问自己的问题,不是「我要不要用 AI」。
而是——我手里有没有别人拿不到的数据?
05
欧洲:一个被低估的窗口
演讲在都灵,蔡崇信自然也谈了欧洲。
他给欧洲开了一个方子:欧洲不必在中美之间选边站,开源就是最优解。
但他紧接着补了一句狠话:只掌握模型远远不够,必须建设本土的算力基础设施,否则数字主权终究会受制于人。
他还点了欧洲的两个优势:全球顶尖 AI 实验室里,有两三成研发人员是欧洲人;深厚的工业家底,能产出海量高价值的行业数据。他同时看好欧洲本土崛起的新型云服务商。
这段话对做出海的人,信息量很大。
因为欧洲的现状可以概括成六个字:人才够,数据够,算力不够。
不够到什么程度?看两组数字。
按 Gartner 的口径,2026 年美国几家超大规模云厂商的资本开支合计约 7250 亿美元;而欧洲的主权云支出,只有约 126 亿美元。
差了将近六十倍。
2 0 2 6 年 算 力 投 入
7250 亿 : 126 亿
美国超大规模厂商资本开支 : 欧洲主权云支出(美元)
现实也印证了这个缺口。
欧洲最有名的 AI 公司,2026 年 3 月用债务融资了 8.3 亿美元,在巴黎南郊建起一座 44 兆瓦的数据中心——里面装的是 13800 张美国芯片。
欧洲的人工智能,跑在美国的硬件上。这句话不是调侃,是招股书里会写的事实。
所以欧洲才要补课。2026 年 1 月,欧盟批准了 370 亿欧元,在七个国家建设 AI 超级工厂;Gartner 的调查显示,六成西欧企业的首席信息官想增加本地云的使用。
而这一连串动作,对创业者意味着什么?
意味着一个结构错配的市场。
哪里缺什么,哪里就有生意。
欧洲缺的甚至不只是芯片,是「能合规地用起来的算力」。欧盟人工智能法案在 2026 年 8 月开始执行,数据放在哪里、由谁运营、受哪国法律管辖,全都变成了硬约束。
而这些约束,对巨头是麻烦,对熟悉规则的人是机会。
具体到生意上,至少有三个方向是现成的。
一是合规算力:把本地的数据中心做成「能过审计」的产品,而不只是卖机器。
二是行业数据服务:欧洲的工业家底还在那儿,但把机器里的数据变成模型能力,中间需要一整套工艺,这活儿没人干完过。
三是本地化交付:欧洲客户要的往往不只是模型,是一份能用母语解释清楚、能对上监管条款的部署方案。
顺带说一句,蔡崇信之所以劝欧洲走开源,也是因为开源最贴合欧洲的现实。
它不需要一次性砸出几千亿,却能让本土企业以更低的成本获得能力。对一个算力落后、但人才和数据都不缺的地区来说,这几乎是唯一的解法。
「出海不是去更大的市场,是去结构错配的市场。」
06
创业者该押什么
回到那句判断:五年之后,人们可能不会再单独讨论 AI。
报道这场演讲的媒体在最后写了一句总结:AI 竞赛是一场长跑,比的不是一时的热度,而是谁的基础更牢、谁和现实生活结合得更深。
这句话换个说法,就是给创业者的三条纪律。
深夜的白板。全栈是巨头的答案,创业者的答案只能是「窄」。
第一,不要押参数,要押纵深。
参数是全球最不缺的东西。缺的是有人愿意花三年,把某一个行业的某一个环节,摸到别人摸不透。巨头比的是广度,你只能比深度。
第二,不要做通用工具,要做行业里的脏活。
通用工具的门槛是零——今天搭一个套壳应用,可能只需要一个下午。但你要去一家工厂蹲三个月,把它的良率问题搞清楚,就没有人跟你抢。
第三,不要追概念,要攒独占的数据。
风口会换,词汇会过期。但一条产线上跑出来的数据,只会越攒越厚,越来越值钱。
还有一条,是反向的纪律。
不要一上来就想做平台。
平台是结果,不是起点。所有活下来的平台,一开始都只解决了一个非常窄的问题。你先把那一个问题解决到别人绕不过去,平台才可能成为你的下一个身份。
最后说一句关于心态的话。
既然是长跑,那么最昂贵的东西就不是速度,是耐心。
过去三年,我们见过太多项目在半年里融资、估值翻十倍、然后悄无声息。它们大多不是败给了技术,是败给了节奏——把一件本需要三年的事,当成三个月来做。
「工具会消失。问题不会。」
五年后,没有人再单独讨论 AI。
那不是因为它退场了,恰恰是因为它无处不在——像电一样,像水一样,像今天的互联网一样。
而真正的问题,从来都是同一个:当所有人都能拿到同样的能力时,你手里还剩下什么?
这个问题,巨头用几千亿来回答。
创业者,只能用减法来回答。