ARTICLE · 1147661
能拿奥数金牌的 AI,读不准墙上的钟:对临床医生AI使用的经验分享和建议
今年有条数据,我反反复复讲给科室的同事听:
谷歌的 Gemini Deep Think 在国际数学奥林匹克拿了金牌——那是人类顶尖数学少年们厮杀的比赛。而同一个时代最好的 AI,去读一只指针式钟表,十只表里看错五只。人类的正确率是九成,AI 是五成;而且人看错,通常是差三分钟,AI 看错,中位误差是一到三个小时。
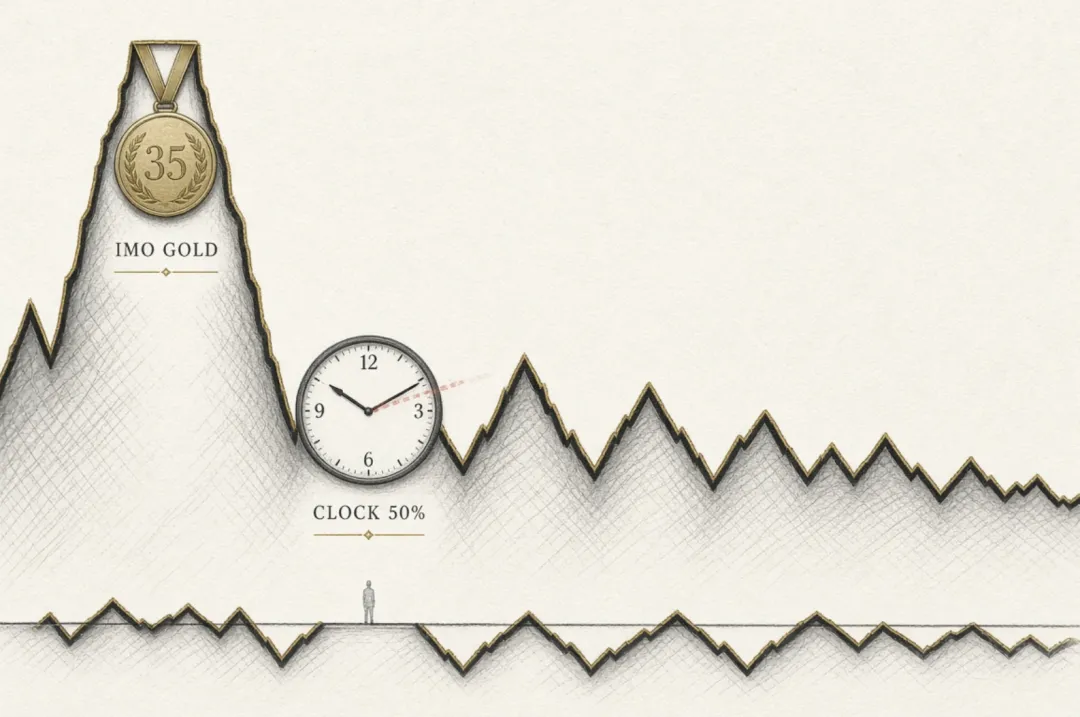
这个反差出自斯坦福刚发布的《AI Index 2026》——每年一本、四百多页、被各国政府和实验室反复引用的 AI 年鉴。它给这个现象起了个名字:锯齿状前沿。意思是 AI 的能力边界不是一条平滑的线,而是锯齿:在某些地方它已经越过人类,在隔壁不远处,它连小学生都不如。
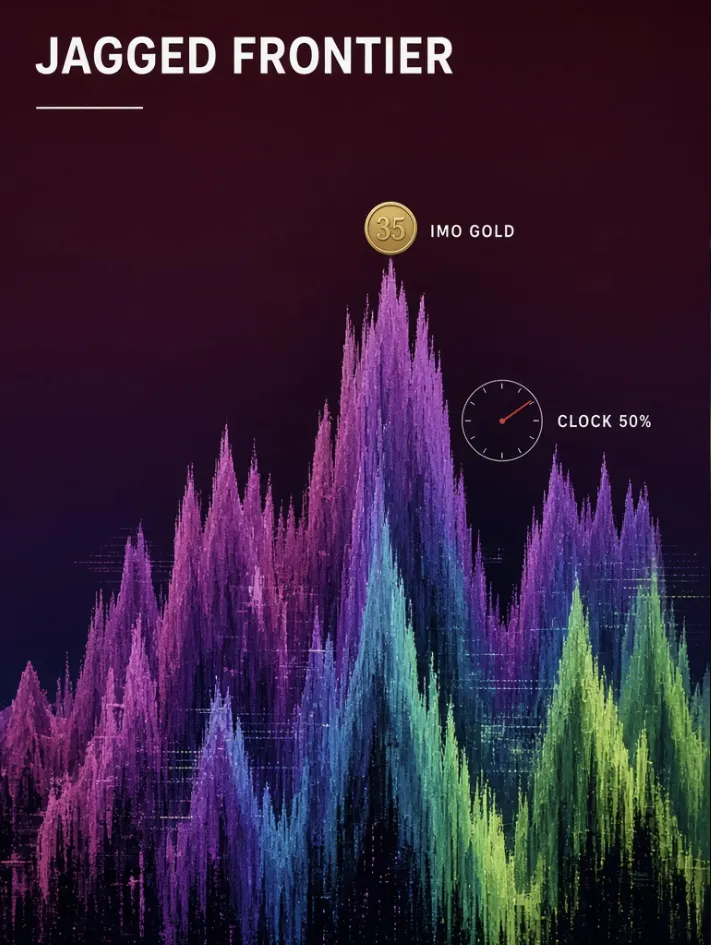
我建议大家把这张图存在手机里。因为今后每一次有人跟你吹嘘"AI 什么都能干",或者跟你哀叹"AI 马上取代医生",你都可以把这张钟表的图甩出来。两边都错。真实世界里,AI 是一个偏科到极致的天才同事——用对了地方,它是神器;用错了地方,它是一本正经的灾难。
一、先看清楚:这个"天才同事"的真面目
年鉴里最诚实的一组数字,是关于 AI 智能体(就是能自己操作电脑、查资料、干活的 AI)的:
在 OSWorld 这个模拟真实电脑操作的测试里,表现最好的 AI 成功率是 66%。什么概念?人类大学生随手一做,是 72%。也就是说,今天全世界最聪明的 AI 助手,大约每干三件事,就要搞砸一件。这就是所谓的“三次一败”;
我知道这听起来像泼冷水。但请想想另一个数字:一年前,这个数字是 12%。一年之内从 12% 涨到 66%。这就是年鉴开篇那句话的含义——AI 的能力不是停滞,而是加速,只不过连给它量身定做的考试都快跟不上了。
对我们医生来说,这组数字的正确读法不是"AI 不行",也不是"AI 无敌",而是:
可以托付给它的,是那些搞砸了也能重来、有它没它效率翻倍的事——查文献、整理数据、跑统计、写初稿的骨架。而必须捏在自己手里的,是那些错一次就回不了头的事——最终诊断、用药决策、以及对任何 AI 输出结果的临床合理性终审。
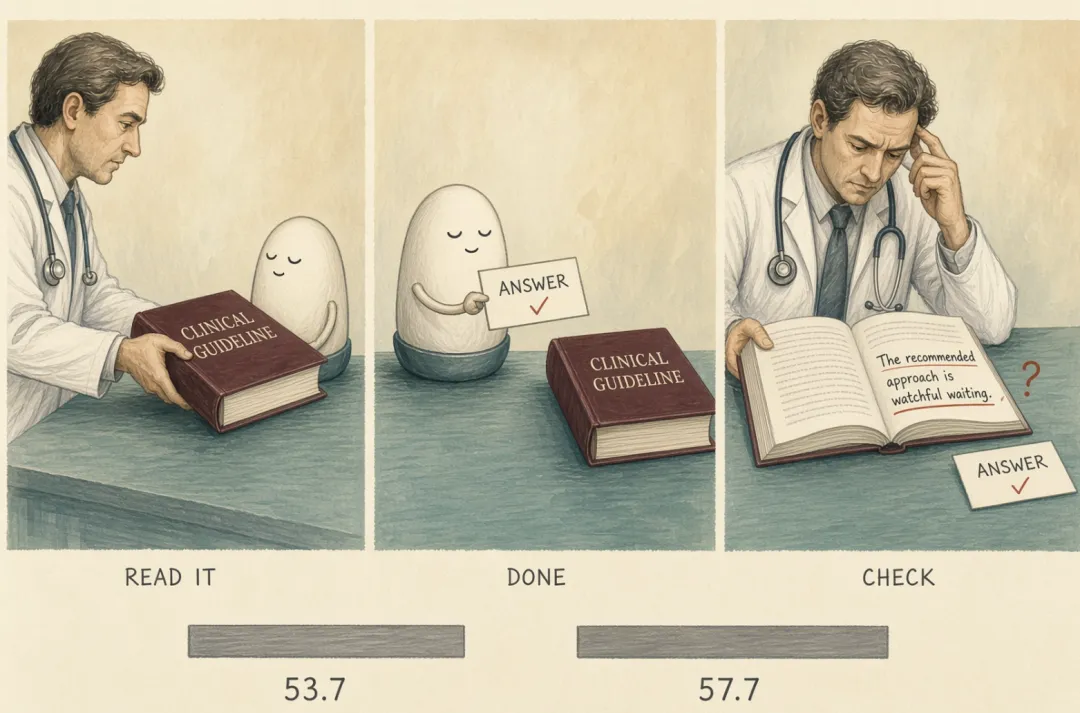
还有一个被严重高估的能力:长文本。各家大模型都在比谁的"上下文窗口"长——能一次"读进去"多少字,现在头部模型号称一百万字。但年鉴里有个细节很值得玩味:在一项专家级长文理解测试(LongBench v2)上,人类专家限时 15 分钟,得分 53.7%;最好的 AI,57.7%。
四百分点的差距。也就是说,把一整本指南"喂"给 AI,它确实全都"看"了——但看懂的程度,和你快速翻阅一下午差不多。输入量的暴增,没有换来理解力的等比例暴增。 这件事对我们有直接的提醒:AI 读过你给的文献,不等于 AI 理解了它给的答案。
二、数学家们已经替我们吵过一架了
如果说年鉴是体检报告,那上个月数学界和 OpenAI 的一场公开决裂,就是病理切片。
简单回顾一下来龙去脉。9 月 8 日,OpenAI 宣布:一个尚未公开的内部模型,调动近万个 AI 智能体并行工作了 88 个小时,攻克了纳维–斯托克斯方程——就是克雷数学研究所悬赏一百万美元、七道"千禧年大奖难题"之一的那座珠峰。166 页的证明文档,附计算机代码。
消息一出,欢呼声还没落地,质疑就到了。纽约大学的数学家巴克马斯特公开指控 OpenAI"截胡":他和合作者在这个方向上已经做了一年多,期间大量使用 OpenAI 的编程助手辅助推导——草稿、几何模型、推演代码,都留在人家的系统里。OpenAI 后来承认:"无法排除去标识化的用户会话数据帮助改进了模型能力。"
紧接着,陶哲轩、邓煜、舒尔茨等 25 位菲尔兹奖得主联名发表公开信,标题就叫《人工智能在数学中的严重错位》。他们承认大模型进步惊人,也承认自己在用——但话锋很硬:把攻克名题当成模型能力的"基准测试",正在损害数学这门科学本身。
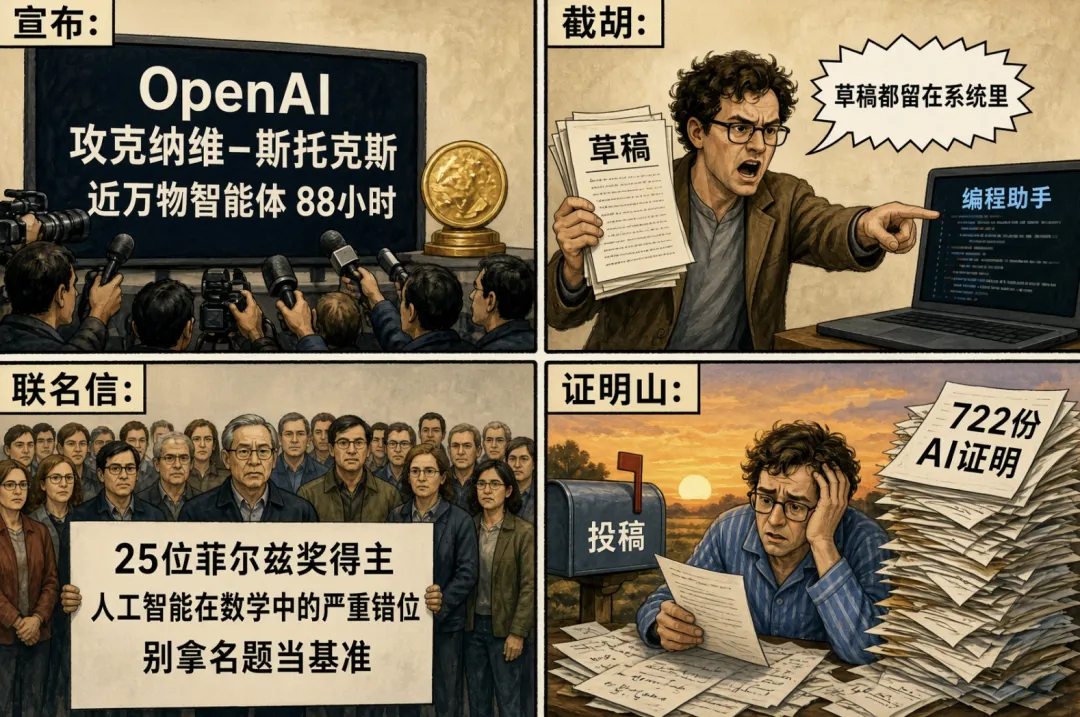
真正的决裂发生在 10 月。OpenAI 先是与普林斯顿高等研究院共建了专家咨询小组,专家们明确划出红线:不要拿内部模型擅自去刷高深数学难题。话音未落,OpenAI 一次性甩出七百多份 AI 生成的数学证明手稿,声称覆盖数千道问题、数百组成果。数学家们的起床方式从此改变——睁眼就要面对一座读不完的证明山。
于是,"人类数学协会"发出声明,陶哲轩在个人博客全文转载,呼吁数学家停止与 OpenAI 合作。声明里有一句话,我建议大家抄下来:
"一次性发布七百多份文件,展示的不是学术研究,而是权力。"
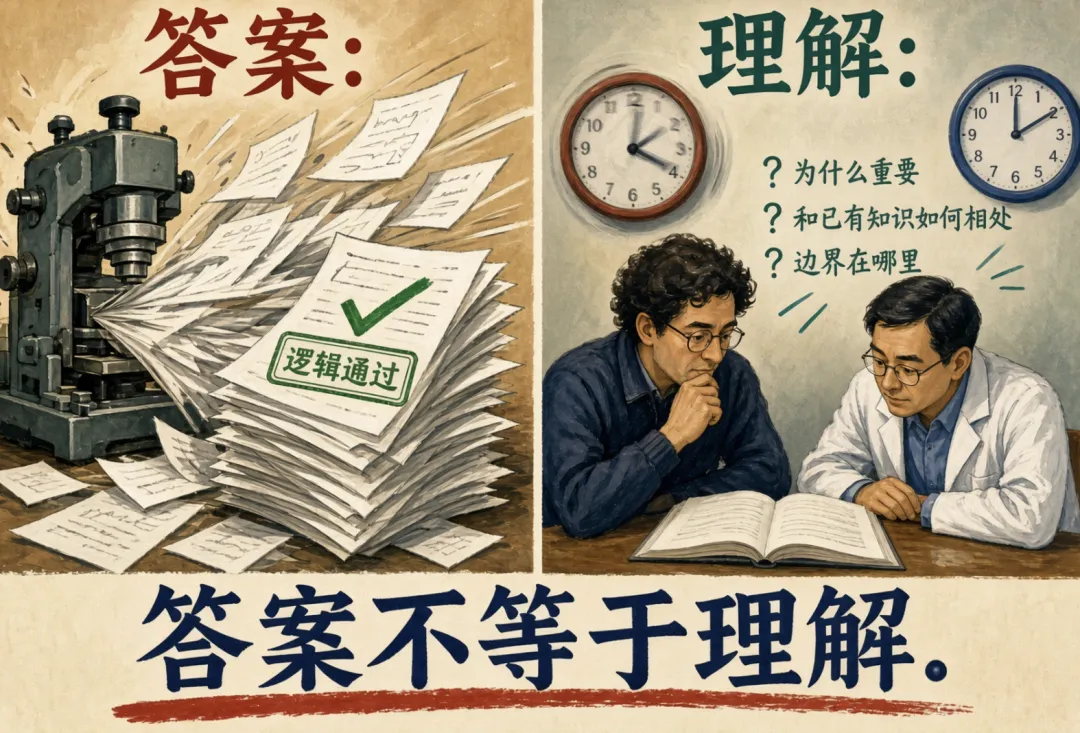
这场争吵的本质,和我们在临床上天天面对的问题是同一个:答案不等于理解。 形式化验证可以逐行检查证明的逻辑,但检查不了"这个结论为什么重要、和已有的知识如何相处、边界在哪里"。机器生成证明的速度,已经把人类理解证明的速度远远甩开——而数学,恰恰是一门靠"理解"运转的科学。
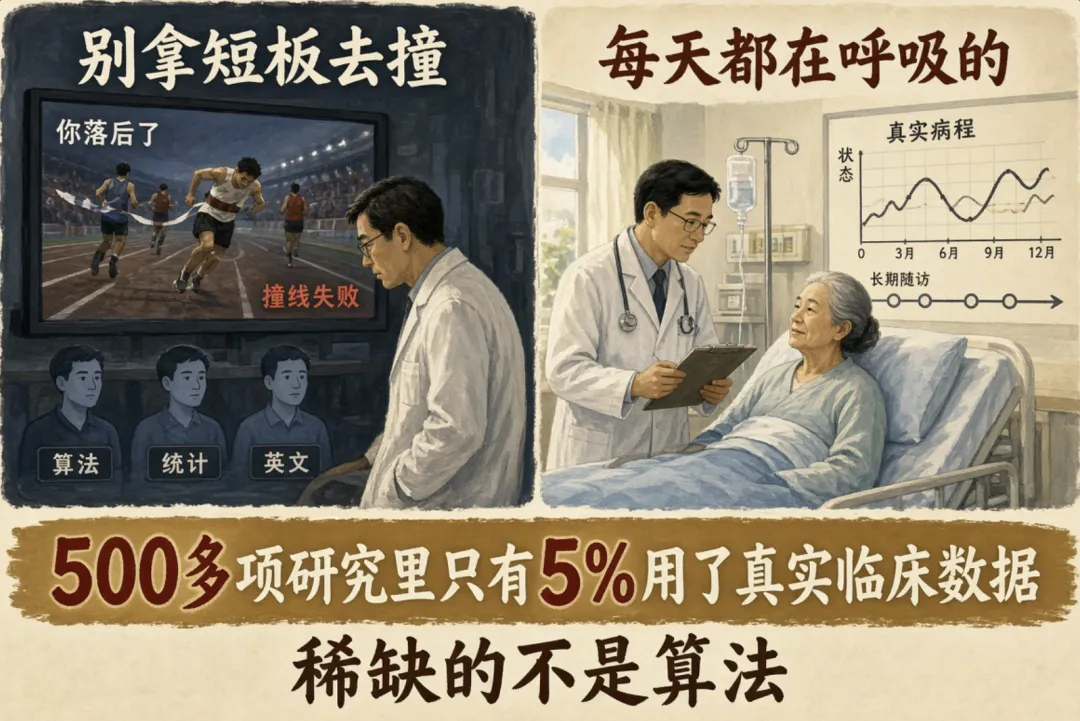
医学呢?同一本年鉴里有个数字,我每次讲都有医生听众倒吸一口气:斯坦福和哈佛的联合团队审查了 500 多项临床 AI 研究,发现只有 5% 使用了真实临床数据,近半数还停留在"考试型试题"阶段。另有 NOHARM 基准测试发现,主流大模型在每 100 个临床案例中,会给出 11.8 到 14.6 条严重有害的建议,其中四分之三是"该做的没做"——漏掉一项关键检查,比开错一剂药更安静,也更危险。
数学家们争的是"谁有权定义数学的进步"。我们要争的是同一件事在医学里的版本:谁有权替病人做判断。 这场争论没有旁观席。
三、2026 年的工具地图:分工比全能重要
这一年我把能叫上名字的医学 AI 几乎试了个遍,先说结论:没有任何一个能包打天下,但组合起来已经覆盖了医生工作的全部环节。
先看"循证"这一侧。这一行的竞争逻辑很有意思——大家都不卷模型参数,改卷"证据源":
阿里健康的"氢离子"拿到了 BMJ 集团 70 本期刊近十年的独家内容授权,7 月又宣布与 JAMA 达成独家合作,底牌是顶刊全文加三百多位临床专家的评审闭环;医学界的 DrSeek 医问答走的是精选文献库加 GRADE 证据自动分级的路线,认证医生免费,主打十秒给出有出处的循证答案;丁香园的"临床决策"则把自家二十六年的家底——四万多份指南、百万级文献、一百亿次医患互动的真实世界数据——全部接了进来,用药风险预警覆盖率 90.7%。
产品 | 出品方 | 上线时间 | 核心定位 | 证据/数据底牌 | 差异化特点 | 入口与费用 |
|---|---|---|---|---|---|---|
氢离子 | 阿里健康 | 2026-01 | 循证医学 AI 助手 | BMJ 集团 70 本期刊近十年独家授权;JAMA 独家合作(2026-07);中华医学会、人卫社、CACA 合作 | 四层循证架构: → 300+ 临床专家评审闭环;主打顶刊全文阅读 | App / PC 端 |
DrSeek 医问答 | 医学界 | 2026-01-15 | 循证临床决策问答 | 精选权威指南、文献、药品说明书库(拒绝互联网非专业信源) | GRADE 自动证据分级;医学知识图谱语义理解;10 秒出循证答案;覆盖急诊、门诊用药校验、查房带教场景 | 医生站 App / 微信小程序;认证医生免费(上线一个月约 6 万用户) |
临床决策 | 丁香园 | 2026-06 亮相 | 临床决策支持 | 4 万+ 指南、百万级期刊文献、8 万+ 药品说明书、4000+ 诊疗路径、7 万+ 病例、1 万+ 合理用药条目;100 亿次医患互动真实世界数据 | 原文循证、句句可溯源;用药风险预警覆盖率 90.7%;孕产妇/儿童/老年人自动标注用药分级; | 丁香园平台 |
这类工具的天花板是版权和资源:它们背后是真的有 BMJ 和 JAMA 的全文,这是任何通用助手都给不了的东西。读顶刊全文、要逐句可溯源的循证答案,用它们。
再看"通用"这一侧。通用 AI 助手没有医学内容的独家授权,强项是另一条赛道:写代码、跑统计、画图表、整理论文、管理文献、把一份数据从 Excel 变成一张可以投期刊的图,再顺手把文献综述的初稿骨架搭好。它还能定时干活——比如每天清晨自动检索你研究方向的新文献,整理好放在你的文件夹里等你上班。
科研的全流程体力活,用这类。
三分钟选型建议
床旁循证问答、查指南、用药校验 → DrSeek(免费)、丁香园临床决策、氢离子(顶刊全文最全);
写病历、文书减负 → 讯飞诊疗助理、京东 AI 诊疗助手、百度有医助手;
科研:检索 + 精读 + 写作 → 京东 AI 科研助手、氢离子/OpenEvidence(要溯源);统计代码、数据分析、制图 → 通用大模型助手;
机构整体采购(医院信息化) → 讯飞、腾讯 MedMate、医渡;
个人文献库 + 通勤听播客 → 联想小天(或通用助手 + 语音生成自建)。
使用心法只有一句话:用垂直工具拿"可信的答案",用通用工具干"可校验的活",并且永远让两个来源互相印证。 两个 AI 犯的错不会一样——这是这个时代给使用者免费赠送的质检员。
四、回到临床:五条破局
绕了一圈,落回我们自己。结合这一年的观察和那本年鉴的数据,有五条具体的建议:
一、重新定义你的核心资产。 不要用下班后的两小时,去和头部机构的专职团队拼代码熟练度、统计花样和英文辞藻——那是拿短板撞人家的长板。AI 医疗领域最稀缺的从来不是算法,而是真实病人、真实病程、长期随访的数据和临床直觉。全行业 500 多项研究里只有 5% 够得着的东西,你每天呼吸的都是。
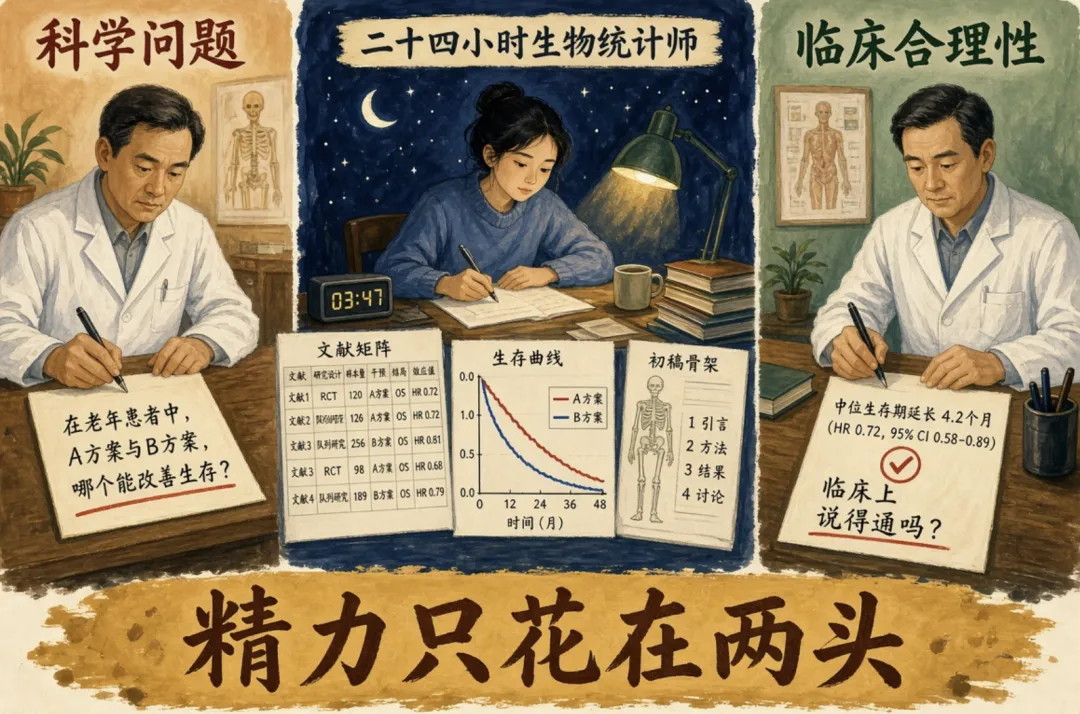
二、把身份从"操作工"切换成"PI"。 文献对比矩阵,变量定义和控制因素;PSM、Cox、RCS 这些统计方法,用自然语言把需求说准,这些目前的大部分AI都能做到这些,可以当你的 24 小时生物统计师;初稿让它按 STROBE 规范搭骨架。精力只花在两头:提出准确的科学问题,和判断结果的临床合理性。
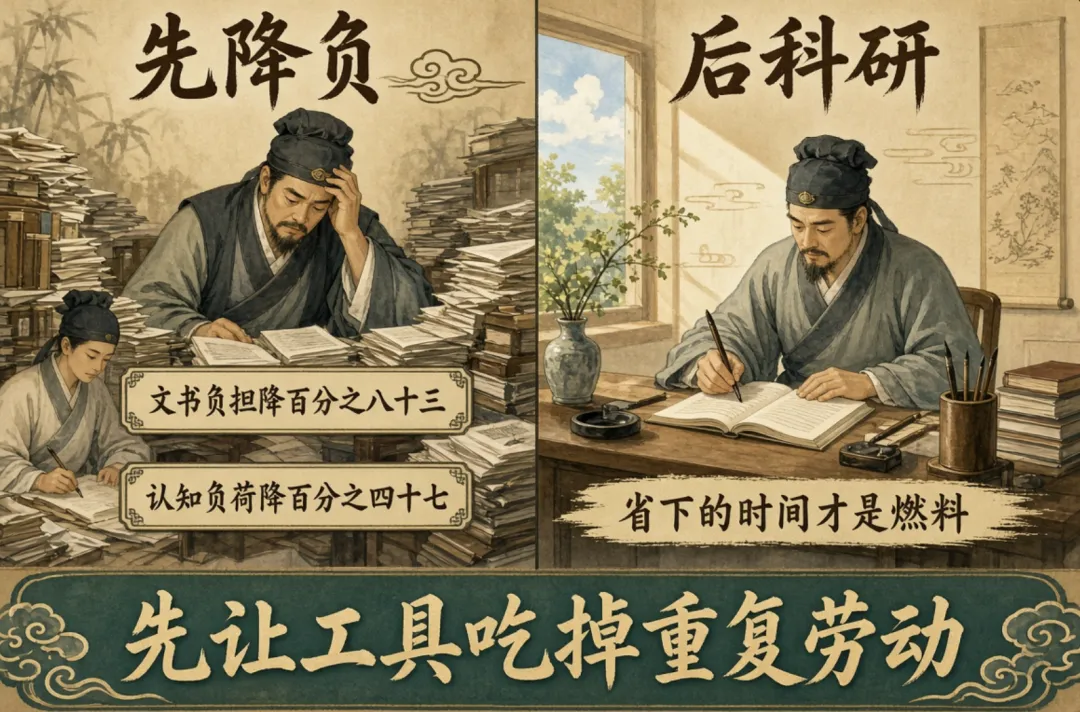
三、先降负,后科研。 环境病历生成(ambient scribe)已经实打实进入了规模化部署——报告里记录的数据是:医生文书负担下降 83%,认知负荷降 47%。先让工具吃掉重复劳动,省下来的整块时间,才是科研真正的燃料。
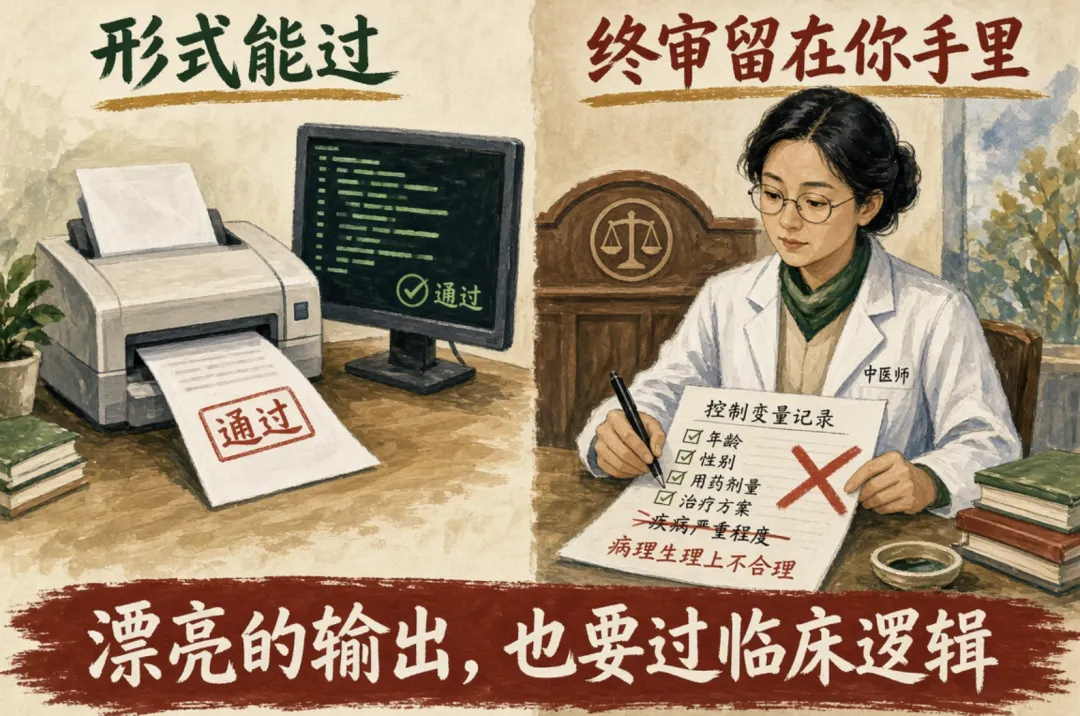
四、永远当终审法官。 AI 能写出语法完美的英文和运行通过的代码,但它判断不了"这个控制变量在病理生理上是否合理"。数学家们和 OpenAI 吵的,就是这个。形式再漂亮的输出,都要过临床逻辑这一关——这不是谨慎,这是你的核心价值所在。
五、从小切口快速闭环。 不要一上来就立志做"高门槛复杂 AI 模型"。从手头的回顾性队列、单中心数据切入,用精准的 PICO 聚焦一个具体的临床决策问题——某个亚组的药物效应差异、某个标志物与长期结局的关系,第一篇的认真思索,胜过十篇的宏伟。
写在最后
AI 的江湖每天都在上演"震惊体"和"末日体"的轮播,而真实的技术曲线在两者之间安静地加速。
当工具的门槛被一点一点抹平,医生的护城河也随之换了位置——它不再是"谁会检索、谁会统计、谁的英语好",这些都在免费化;它变成了"谁手里有真实的临床问题、谁的眼睛能看出结果里的不对劲"。
前者是技能,会被 AI 平权。后者是洞察,反而因为 AI 的存在而更贵。
时代淘汰的不是医生,是不善于使用工具的AI使用者。这句话对 AI 同样适用。
如果有个贾维斯的话,你会怎么使用他呢?
主要数据来源:斯坦福 HAI《AI Index 2026 Annual Report》;文中行业动态来自财新、新华网、中国日报、量子位等公开报道。榜单与产品数据时效敏感,引用前请复核最新版本。