ARTICLE · 1148134
我用"去AI味"工具改了3遍,检测器说:AI味从52%涨到89%
检测器弹出89%的时候,我正在回复老板微信。
他让我把季度总结的"AI味"去掉。我先用ChatGPT写了初稿,丢进检测器一看,52%。不算高,但老板瞄了一眼就说:"这不像你写的。"
他是对的。那段话里有"赋能业务"、"深度参与",还有一句"在复杂多变的市场环境中"——我活了三十多年,从没在任何一个非正式场合说过"复杂多变的市场环境"。
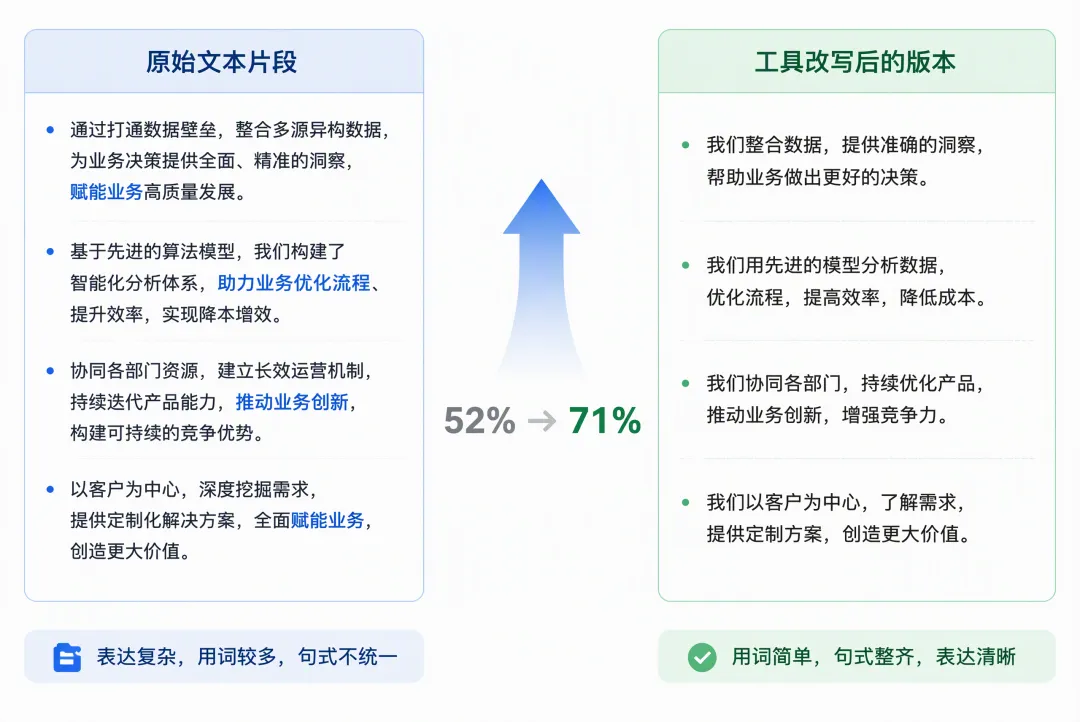
第一遍改写:52%→71%
我找到一款口碑不错的"去AI味"工具,把文本贴进去,选了"自然口语"模式。30秒后它吐出一版新文本。
读起来确实顺了。长句被切短,"赋能"变成了"帮助","深度参与"改成了"一直在做"。我顺手又丢进检测器。
71%。
比原来还高19个点。
我盯着屏幕看了半分钟,以为检测器坏了。刷新,再测,还是71%。同一个检测器,同一个模型版本,同一批文本。数字没变。
问题出在哪?我拿着新旧两版对比,发现了一个规律。工具确实把大词换成了小词,但它同时也做了一件更隐蔽的事:把句子长度统一了。
原文有一句"我们在Q2完成了三个核心目标,整体进度比预期快了12%"——这是真人写的,长短句混在一起。工具把它改成了"Q2完成了三个目标。整体进度比预期快了12%。"两个几乎等长的短句,中间没有任何连接词。
检测器抓的正是这种"均匀"。
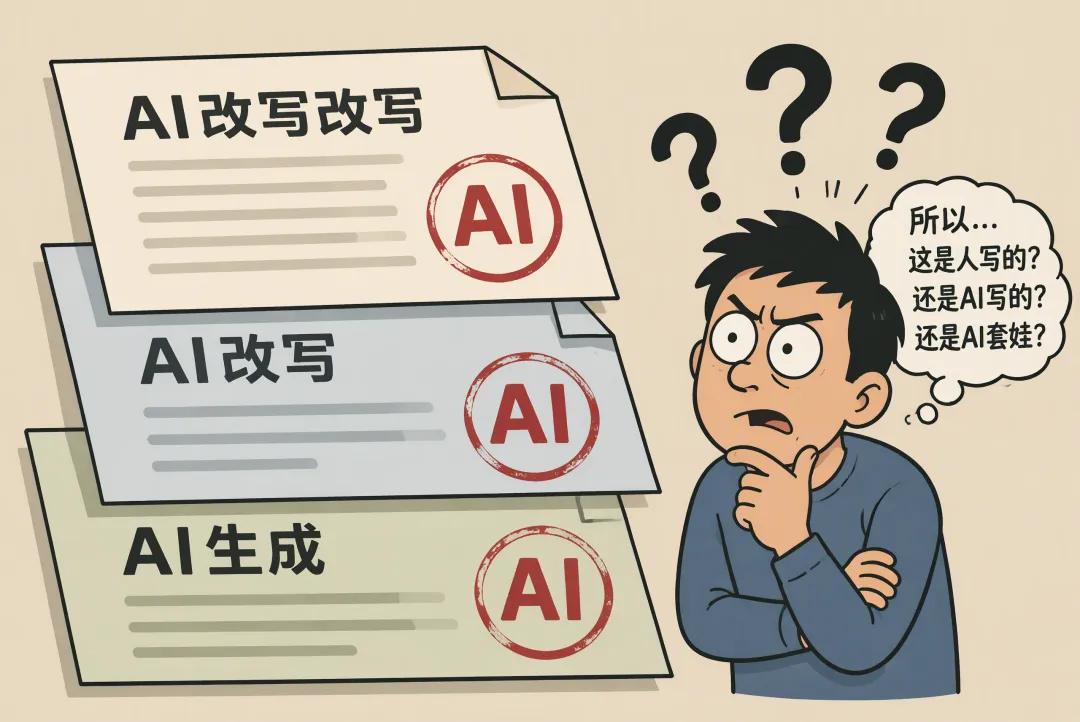
第二遍改写:71%→83%
我不死心,换了另一款工具。这款宣传语是"基于学术级检测算法反向优化",听起来更专业。
它给的建议更激进:删掉所有"首先、其次、最后",插入个人感受,增加口语化词汇。我照着改了一遍,甚至加了一句"说实话我也没想到会这样"——这是工具教的模板句式。
再测:83%。
又涨了12个点。
那一刻我开始怀疑这些工具到底在干什么。不是帮我去掉AI味吗?为什么越改越像AI?
我仔细读了第三版文本,发现问题更深了一层。这款工具为了"自然",大量使用了特定的连接方式:"然后呢"、"其实吧"、"你会发现"——它们也是训练数据里高频出现的"自然表达"。当我把三版文本摆在一起,一个讽刺的画面浮现出来:第一版是AI写的,第二版是AI改写AI,第三版是AI改写AI改写AI。每一遍都在叠加一层新的统计特征,检测器看到的不是"更自然",而是"更密集的AI改写痕迹"。
第三遍:手动调整后的89%
我决定自己上手。在第三版基础上,我加了两处真实细节:一次具体的失误,和一个带数字的成果。
检测器弹出89%时,我正在回复老板微信。他问我改好了没,我说快了。实际上我坐在工位上,对着这个数字发呆。
89%。三版改完,AI味翻了近一倍。
这让我意识到一个反常识的事实:用AI工具去掉AI味,本质上是请了一个更了解检测规则的AI来对抗检测器。它不是在恢复"人味",而是在生产一种"看起来不像AI的AI文本"。这种文本的用词偏好、句式分布、连接词频率,恰好落在检测器定义的另一个"非自然区间"里。
哈佛商学院和纽约大学最近做了一项研究,分析了7462份硕士申请文书。56%的申请者至少有一篇被检测器标记为"高度疑似AI生成"。研究者发现,AI让文书的语法和清晰度明显提升,但招生官一旦怀疑某篇是AI作品,对其评价就会显著降低。更关键的是,检测器误判率并不低——它会把一些人类写作也标记为AI,特别是那些经过反复打磨、句式工整的文本。
换句话说,检测器不是在测"是不是人写的",它在测"文本的统计特征是否偏离某个平均值"。而这个平均值,本身就在漂移。
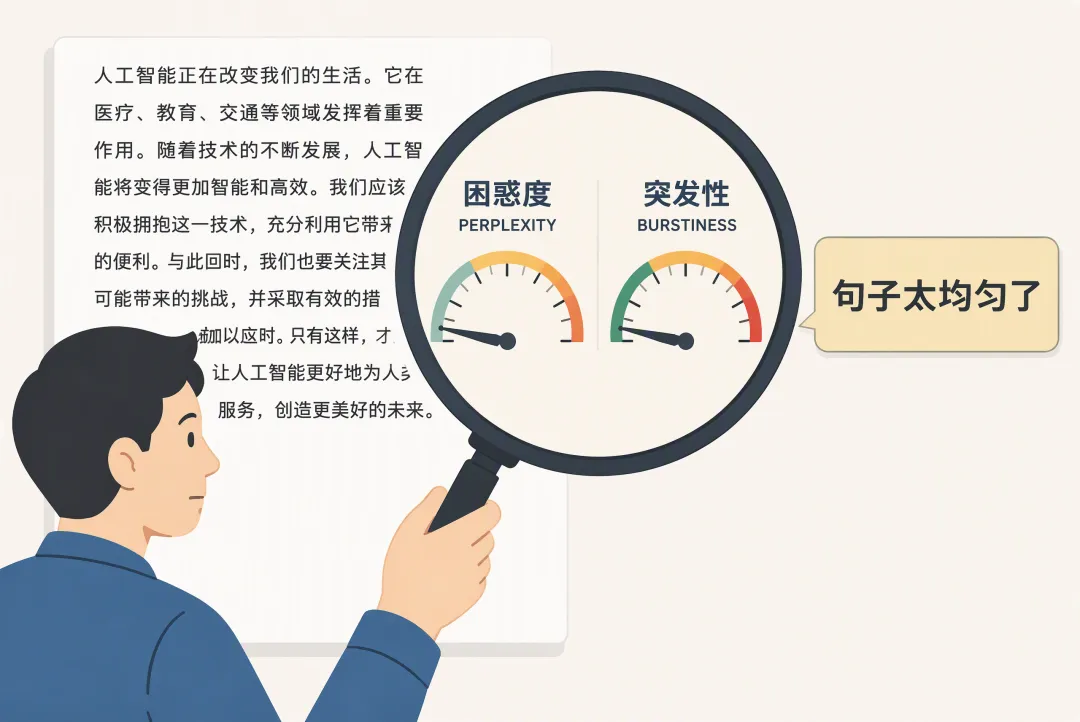
困惑度和突发性:检测器到底在看什么
我花了两个晚上查检测原理,终于搞懂那两个数字是什么意思。
检测器主要算两个指标:困惑度(Perplexity)和突发性(Burstiness)。
困惑度衡量的是"这段话有多出乎意料"。AI生成的句子用词搭配极其标准,困惑度很低。人类写作则充满意外——你可能突然蹦出一个方言词,或者句子写到一半换个说法,逻辑链条里跳了一步。这些在AI眼里都是"困惑",但对读者来说反而是常态。
突发性衡量的是句子长度和结构的波动。你回想一下自己平时打字的状态,是不是长短句混着来?有时候一个长句绕三行,有时候干脆甩两个字的短句。AI的训练目标恰恰相反:生成平稳、连贯、平衡的文本。一段七句话里,句子长度往往非常均匀。
这就是问题所在。那些"去AI味"工具,核心逻辑是把文本"平整化"——统一句式、替换高频词、打散结构。它们以为自己在"去味",实际上是在把文本往AI更擅长的统计模式里推。
2024年10月,国内某顶尖理工大学通报了一起案例:一名博士用AI改写工具对论文进行降重,初次查重率12.7%过关,但在AIGC筛查环节被发现核心章节与多篇文献在论证结构和数据逻辑上高度一致,只是进行了同义词替换和句式重组。最终学位被撤销。
这个故事的讽刺之处在于,他用AI改写的目的恰恰是为了"去掉AI痕迹"。结果痕迹没去掉,反而叠加了一层"被改写的痕迹"。
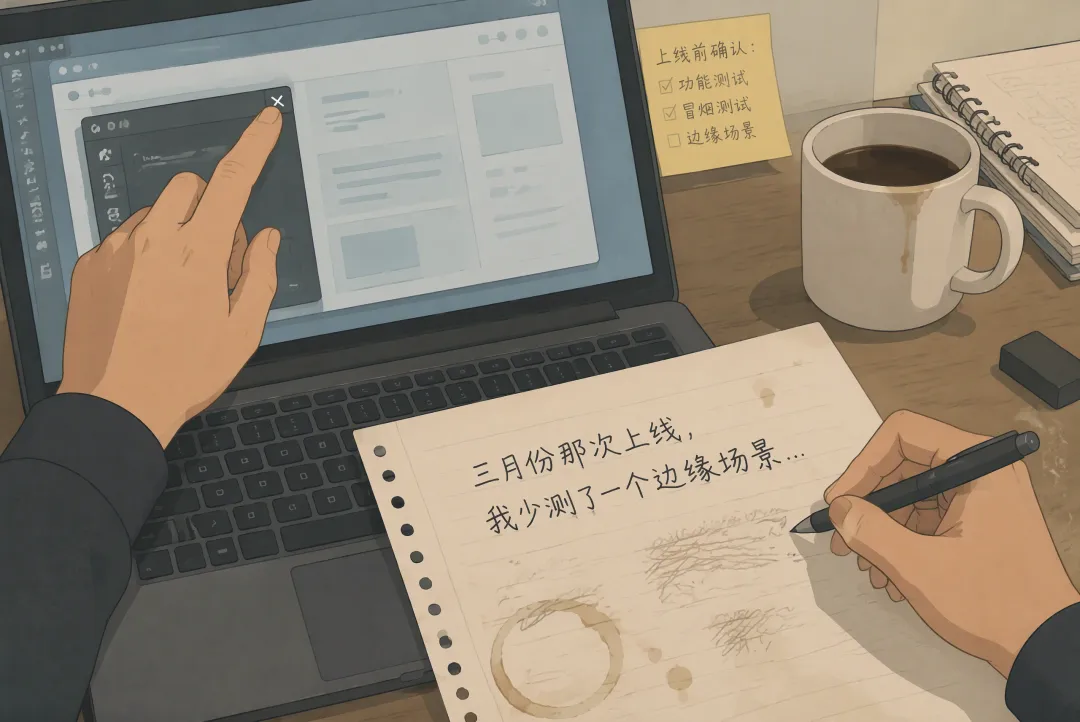
真正的解法:不是"洗"文本,而是注入具体
我最后是怎么降到12%的?
我把所有工具关掉,对着空白文档重新写了一遍。不是改,是重写。
我写了什么?我写了一次真实的失误:"三月份那次上线,我少测了一个边缘场景,导致页面在IE11下直接崩了。"我写了一个带数字的细节:"那个功能上线了17天,收到了4条反馈,其中3条是关于按钮位置太靠右。"我还写了一句没有任何工具会教我的话:"我其实不太确定这个策略能不能持续奏效。"
没有"赋能"。没有"深度参与"。没有"复杂多变的市场环境"。也没有"其实吧"、"你会发现"这类工具推荐的"自然连接词"。
就是一些具体的、有瑕疵的、带个人判断的东西。再测:12%。
检测器不是神。它只是在做统计。当文本里出现了具体的数字、真实的不确定性、个人化的句式波动时,它的"困惑度"就会上升——因为它无法预测下一个词会是什么。而这,恰恰是人类写作的特征。
OpenAI最近宣布要给ChatGPT加上隐形文本水印,叫textGrain。它不是藏在文件里的隐藏字符,而是微调模型选词的偏好。同一个意思,本来可以用A或B两个词,水印开启后模型会按一个只有它自己知道的规律去挑。几百次这样的选择叠加起来,就形成了一段统计模式。
这意味着什么?意味着"AI味"和"AI水印"是两个完全不同的东西。前者是观感上的,可以手动调整;后者是概率分布上的,你改几个词根本动不了它。用AI工具改写AI文本,只能处理前者,而且往往会把后者越埋越深。
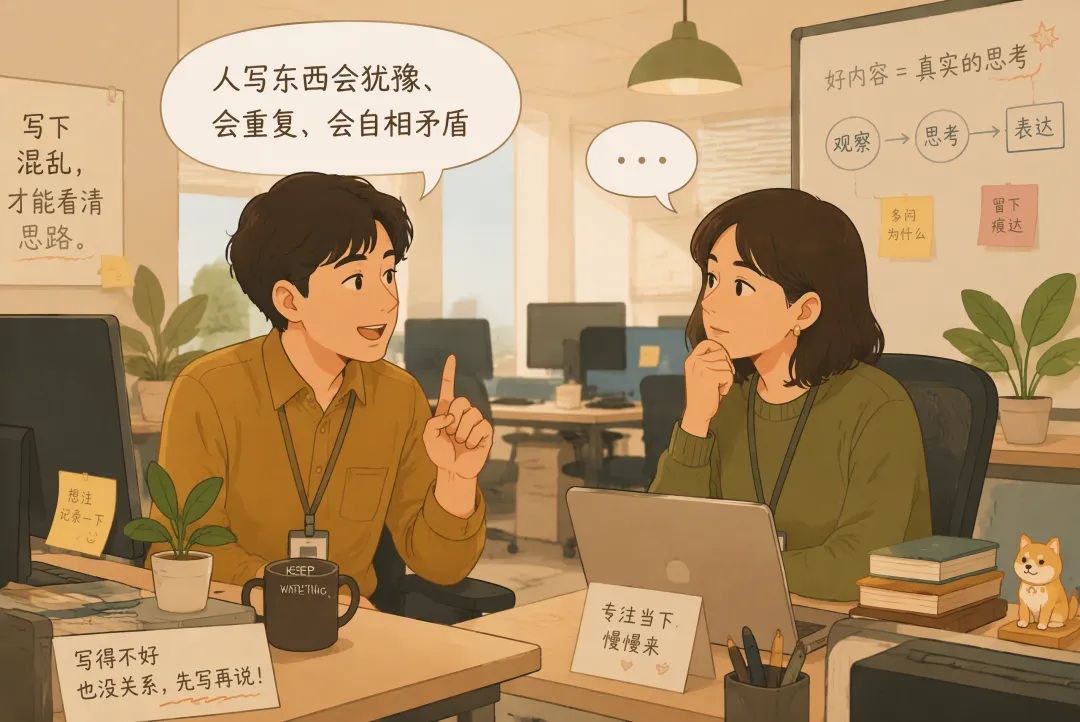
同事说了一句实话
我把这件事讲给隔壁工位的老陈听。他干了八年内容运营,写过的东西比我多十倍。
他说:"你以为检测器是在找AI,其实它在找'没有人的痕迹'。"
我问他什么意思。他说:"人写东西会犹豫、会重复、会自相矛盾。AI不会。你把AI改得越'完美',它越不像人。"
我盯着这段话想了很久。然后我问他,那你觉得我现在这篇,像人写的吗?
他没回答,只是反问了我一句:"你写的时候,有没有哪个地方是故意想让读者觉得'这肯定是真人写的'?"
我愣了一下,说有。
"那就还是有点像。"