ARTICLE · 1156343
不做AI都不好意思说自己是NGS公司?
系列 · 第 2 篇 / 共 2 篇 每一家逐个拆开看:证据摆出来 23 家逐家拆开 + 39 份原始出处 + 35 张原页截图,一次给全 |
第 1 篇讲了什么:把这一批 23 家的公开材料过了一遍,按 AI 自主度分成 L1–L5 五级——能点回论文的 7 家、愿意开源的 2 家、拿到算法证的 1 家;最后给出一张「按 AI 自主度分五级、每级标出证据强度」的主表。这一篇把 23 家逐个拆开,每一家只写三件事:简介、解释、截图。 |
这一篇有点长 · 23 家按 L1–L5 分五段,先挑你想看的 每一层第一个是最硬的证据;每层内部按证据强度排。直接跳: L1 想看「谁真自己训了模型」→ 直跳 L1(6 家) L2 想看「传统 ML 也能发好论文」→ 直跳 L2(4 家) L3 关心「自家产品到底用没用 AI」→ 直跳 L3(7 家) L4 只想知道「谁只接了 DeepSeek」→ 直跳 L4(2 家) 末尾 想看行业底座与海外标杆 → 直跳「行业基础设施 + 海外对照」 |
先铺一张交叉矩阵:技术路线 × 证据渠道,23 家一次落位
行 = 技术路线(它对外主推用了什么);列 = 证据渠道(外人能查到什么程度)。同一格里写的,就是「既走这条路线、又有这种证据」的公司——色越深,这一格里的公司越多。这张矩阵不是排名,排在前面不代表技术更强。
技术路线 \ 证据渠道 | ① | ② | ③ | ④ | ⑤ | ⑥ |
A | 3 华大研究院* · Genos | 1 华大基因 · GeneT | 1 迪安 / 医策 | 1 吉因加 | — | 1 赛陆 · OCellus |
B | 2 华大智造 · LOGO 等 | — | — | — | — | 1 赛纳 · 碱基识别 |
C | 2 金匙 · GenseqAMR | — | — | — | — | 1 真迈 · 碱基识别 |
D | — | — | — | — | — | 1 燃石 · MMcall |
E | — | 1 涌生 · ProtoPilot | — | — | 6 金域 · 域见医言 | — |
F | — | — | — | — | — | 2 圣湘 · DeepSeek |
色越深 = 这一格里公司越多(家) | 0 | 1 | 2 | 3 | 4+ |
口径:只统计公开可溯源材料,检索方法与数据源见第 1 篇「口径」段;数据截至 2026-09-29。这张矩阵不是排名,排在前面不代表技术更强。
L1 · 自研基础模型 / 大模型6 家 —— 模型是自己训的,不是接的
这一层是"自己造模型"的最上面一级:公开材料里能点到名字的基础模型或大模型。但同在这一层,证据强度差得很远——华大研究院、世和、芯像能点回 DOI 并可直接检索,华大基因停在预印本,迪安的硬证据是一张软件注册证,吉因加的四个模型名只在官网,招股书只给了架构表述。
华大研究院(杭州)× 之江实验室 · Genos 人类基因组基座模型 GigaScience 2025-10-22(DOI 10.1093/gigascience/giaf132,PMID 41122975)|MoE 架构,12 亿 / 100 亿两个版本,636 个 T2T 人类基因组|MIT 协议开源,代码挂在两家机构的 GitHub 组织下 谁主导:双方联合发布,归属两家机构,不是华大基因、也不是华大智造 【证据】渠道:同行评议论文 原始出处:https://doi.org/10.1093/gigascience/giaf132 |
▸ 原页截图|华大研究院 × 之江实验室 基因组基础模型,用统一架构处理 DNA 序列的理解与生成,把「读懂基因组」和「写出基因组」放进同一个模型。 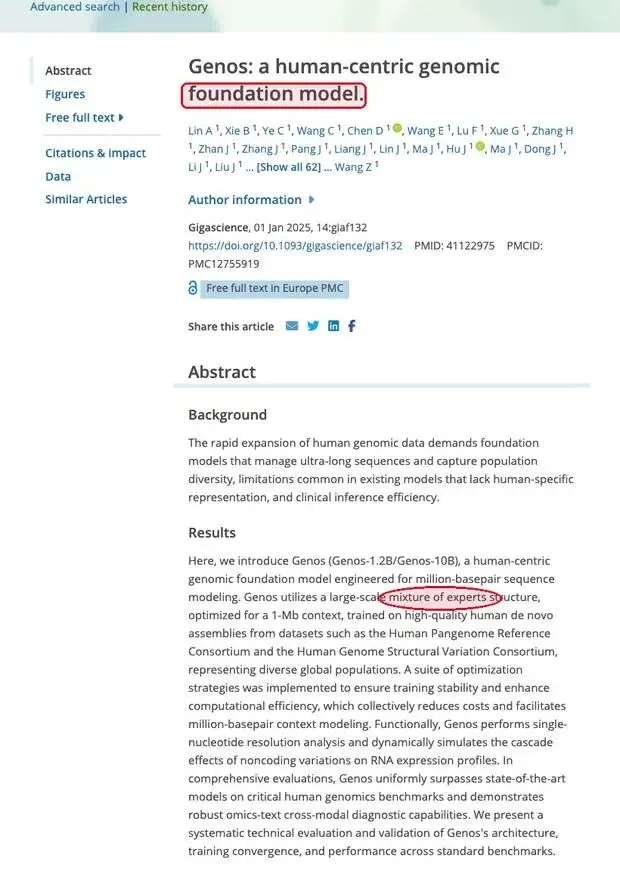 GigaScience 论文页:标题、作者与摘要(欧洲 PMC 收录) |
世和基因 · 序语 / Fragmentia-AI 液体活检 DNA 大语言模型 Cell Reports Medicine 2026-06-12(10.1016/j.xcrm.2026.102866,PMID 42285091)|不靠突变位点、靠 cfDNA 片段结构判断,测序深度只需常规的 0.1%–1% 谁主导:论文署名单位为 Nanjing Geneseeq Technology Inc.(世和) 【证据】渠道:同行评议论文 原始出处:https://doi.org/10.1016/j.xcrm.2026.102866 |
▸ 原页截图|世和基因 cfDNA 语言模型,面向液体活检的基因组变异与甲基化联合建模。 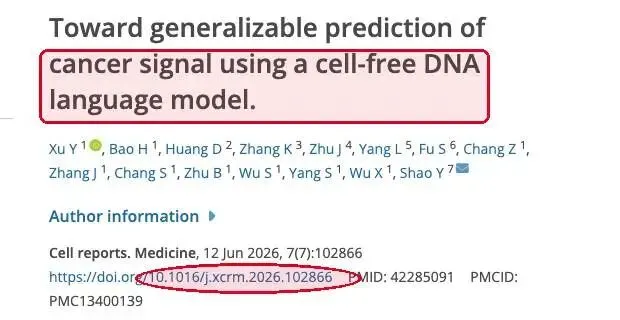 序语:Cell Reports Medicine 论文页(标题即「…cell-free DNA language model」,下方为期刊卷期与 DOI) |
芯像生物(上海) · emGene 把 LLM 直接嵌进测序仪硬件 Integrated Circuits and Systems(SJTU 期刊,非会议)2025-03-18,Vol.2 Iss.2, pp.67-80(10.23919/ICS.2025.3552542)|三级流水线:深度学习做一级碱基识别、机器学习做二级处理、量化压缩后的 LLM 做三级数据解释|端侧 75 token/s、Q30 99.50%(read 比例口径)|公开资料只此一篇,商业化状态未确认,在售平台仍是 MobileSeq / StarSeq100 谁主导:芯像 + 南方科技大学余浩团队。国内首家把 Transformer 类 LLM 装进测序仪边缘端 【证据】渠道:同行评议论文(SJTU 期刊) 原始出处:https://doi.org/10.23919/ICS.2025.3552542https://osrp.sustech.edu.cn/news/1746.html(南方科技大学官方报道) |
▸ 原页截图|芯像生物 把量化压缩后的 大语言模型直接嵌进测序仪边缘端 ,在仪器本地完成序列解读,而不是回传云端。这是国内少见的「LLM 上仪器」写法。 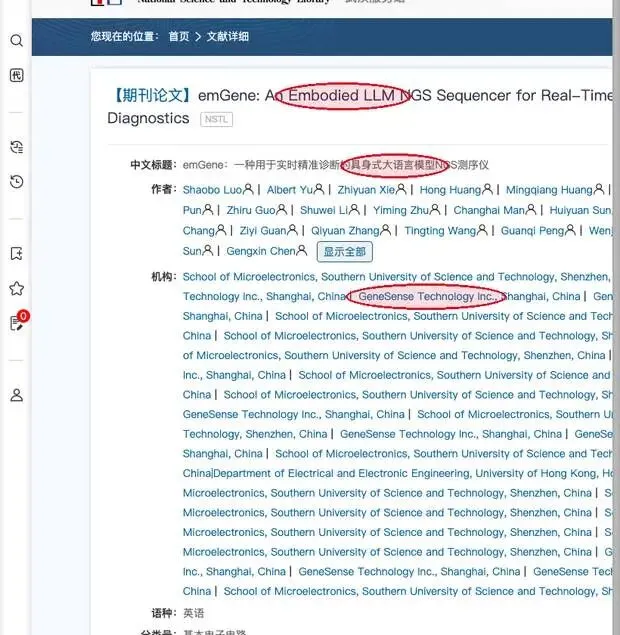 emGene:Integrated Circuits and Systems(SJTU 期刊)2025 论文著录页,作者单位含 GeneSense Technology |
华大基因(300676) · GeneT 罕见遗传病致病变异识别(“多模态”为公司与第三方研报口径,论文原文是 large language model driven approach) 论文挂在 medRxiv(2024-07-18,DOI 10.1101/2024.07.18.24310666),是预印本。论文全名:Genetic Transformer: An Innovative Large Language Model Driven Approach for Rapid and Accurate Identification of Causative Variants in Rare Genetic Diseases;一作单位 BGI Genomics,通讯作者金鑫、赵立见;另配套在线分析平台 iGeneT。论文写的数字:候选变异从平均 418 个缩到 8 个,真实临床召回率从 94.36% 提到 97.85%,单样本分析从 60 分钟到约 3 分钟。公司对外与 ESG 报告里另有一组口径:Top30 位点 99.8%、Top5 94%、F1 99.25%。两组都对,但别混着用——一份是论文,一份是公司口径。 谁主导:公司主导 【证据】渠道:预印本(medRxiv) 原始出处:https://doi.org/10.1101/2024.07.18.24310666 |
▸ 原页截图|华大基因 多模态大模型,用大语言模型直接做遗传病致病变异的识别与分类。 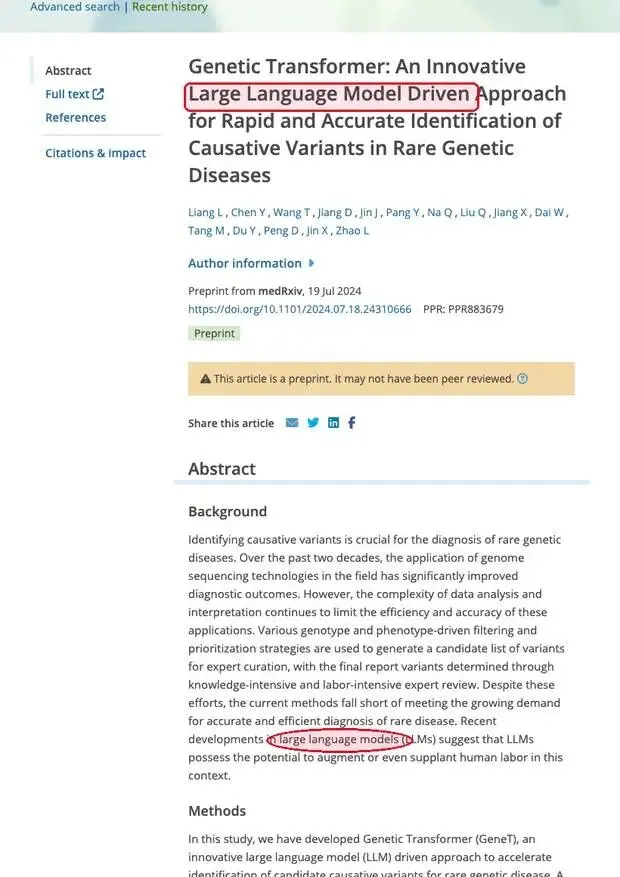 GeneT:预印本页,标题即「Genetic Transformer: An Innovative Large Language Model Driven Approach」 |
看迪安之前,要先把话说清楚:拿证不等于 AI 拿证。
2026-08-31,金匙与微远同日拿到 mNGS 三类证,是行业大事——但那两张证批的是检测试剂盒(血流感染 / 呼吸道病原体核酸检测试剂盒),批的是“这个试剂盒能不能用于临床检测”,不评价里面有没有 AI。把它当成 AI 证据,是这轮最容易犯的错,我自己上一版就差点这么写。
真正称得上“算法被监管看过”的,是软件类注册证——它审的才是算法本身。本轮只有一家:
迪安诊断(300244)· 旗下医策科技 宫颈细胞数字病理图像辅助诊断软件 「宫颈细胞数字病理图像辅助诊断软件」拿到 NMPA 三类注册证(国械注准 20253212728,2025 年 12 月 31 日批准),该赛道目前仅 3 家持证。另有病理大模型「灵眸」(2025 年报口径:9 大器官、57 种肿瘤亚型;2026-08 新华网报道已扩大为 11 大器官、近百种亚型)、MoE 基座「启迪索微」、智能体「迪晓智」(融合华为云盘古)、X-MedExplorer 临床平台与 CML 专科模型。截至 2025 年底累计产出超 600 万份辅助诊断报告。 为什么它算:这是一张软件证,审的就是图像辅助诊断算法本身——和试剂盒证不是一回事。 【证据】渠道:监管审批(NMPA) 原始出处:https://www.nmpa.gov.cn/directory/web/nmpa/zwfw/sdxx/sdxxylqx/qxpjfb/20260105162852135.htmlhttps://m.chinadevelopment.com.cn/?s=index%2farticle%2fid%2f2003839%2f |
▸ 原页截图|迪安诊断 · 医策科技 国械注准 20253212728(批准日期 2025-12-31;NMPA 公示 2026-01-05)。这是 NMPA 三类医疗器械注册证,面向宫颈细胞学筛查的 AI 辅助诊断,属 算法类软件证 ——注意与 mNGS 试剂盒三类证(金匙、微远等)不是一回事。 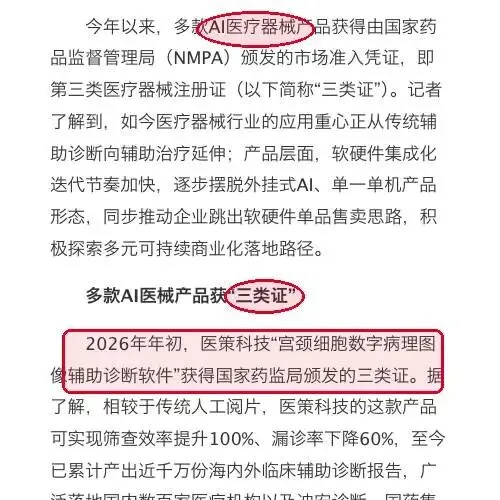 经济参考报报道:医策科技「宫颈细胞数字病理图像辅助诊断软件」获 NMPA 三类证 |
吉因加 基础大模型 + 智能体 AI(招股书架构口径) 2025-12-21 递交港交所招股书(2026-06-21 满六个月失效),表述是“结合基础大模型与智能体 AI”(未逐一列出模型名);2025-11-28 完成 3 亿元 D 轮融资。官网有 4 个模型名:6Dmarker(多组学基座)、GenoVision(多模态)、IG-NeoTri(免疫 / 新抗原)、CellMap(细胞基础模型);另有两款平台:Geneclaw 生信分析智能助手(自然语言交互跑生信分析,公司口径为“国内首个把多组学分析封装成 MCP+Skill 包”的产品)、V-USE 智能 Biomarker 平台(借 6Dmarker 整合多模态组学数据)。但参数规模、训练数据、论文、开源地址——四个字段一个都没找到。 顺带一句:招股书里“中国唯一覆盖全链条的集成化平台”是灼识咨询的口径,不是监管给的认定,别当成行业排名读。 【证据】渠道:招股书 / 年报 原始出处:https://www.stcn.com/article/detail/3556871.html(递表报道)http://www.geneplus.org.cn/(公司官网) |
▸ 原页截图|吉因加 招股书口径:「公司专注于 AI 驱动的多组学技术……结合基础大模型与智能体 AI,已形成从多组学生物标志物及靶点的发现、验证、产品开发到落地的全链条能力」。 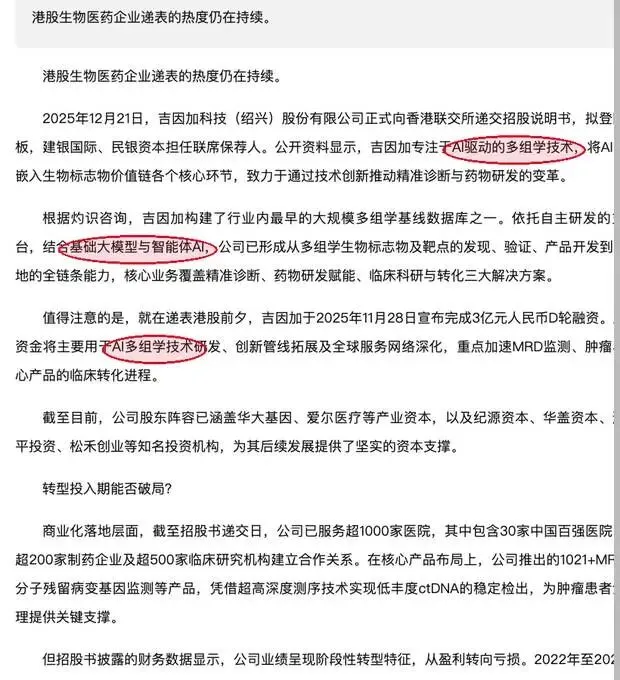 报道引招股书:吉因加专注「AI 驱动的多组学技术」,构建基础大模型与智能体 AI |
L2 · 自研专用模型 / 算法4 家 —— 不是大模型,但方法和论文是自己的
这四家不是大模型,但模型确实是自己训练、自己发论文的,属于深度学习与机器学习的正统做法。写得清楚反而是加分项——回归、碱基识别的边界,它们自己就写明了。
华大智造(688114) · LOGO / Concerto / EvoPlay / PrimeGen 本轮唯一论文跨 4 年连续发布 NAR 2022(10.1093/nar/gkac326,PMID 35536244,与复旦大学合作;两个自注意力层、约 100 万参数)|Nature Machine Intelligence 2022 与 2023(Concerto、EvoPlay)|Nature Biomedical Engineering 2025-07-30(PrimeGen,与泰国朱拉隆功大学合作;论文写明中枢控制器用的是 GPT-4o,不是自研大模型) 谁主导:公司主导。这是本轮唯一论文跨 4 年、连续发布的公司 【证据】渠道:同行评议论文 原始出处:https://doi.org/10.1093/nar/gkac326(LOGO)https://doi.org/10.1038/s42256-022-00518-z(Concerto)https://doi.org/10.1038/s42256-023-00691-9(EvoPlay)https://doi.org/10.1038/s41551-025-01455-z(PrimeGen) |
▸ 原页截图|华大智造(第 1 / 4 张) 四篇分子生物学方向的深度学习论文:LOGO 做蛋白质功能注释,Concerto 做单细胞扰动预测,EvoPlay 做蛋白质适应度预测,PrimeGen 做基因组序列生成。 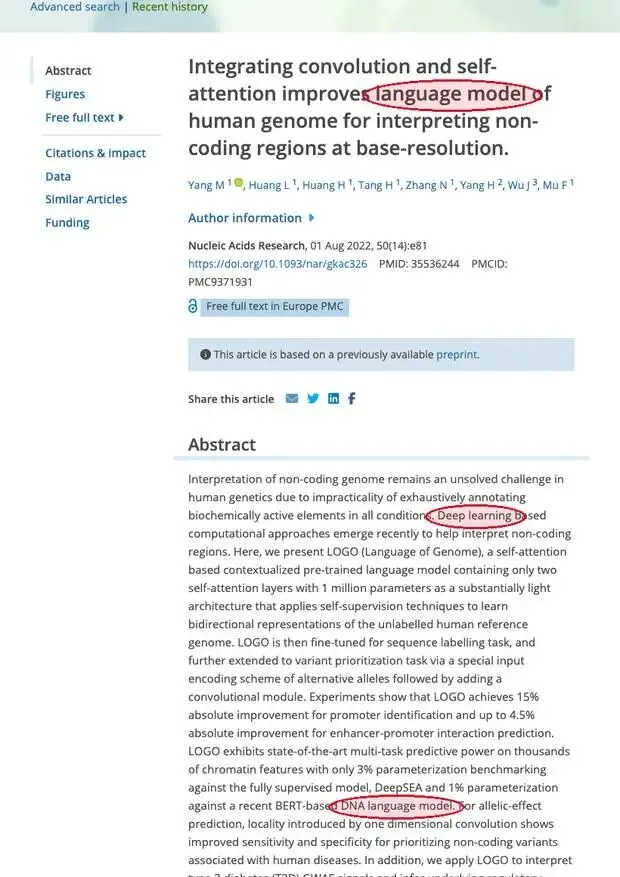 LOGO:Nucleic Acids Research 论文页 |
▸ 原页截图|华大智造(第 2 / 4 张) 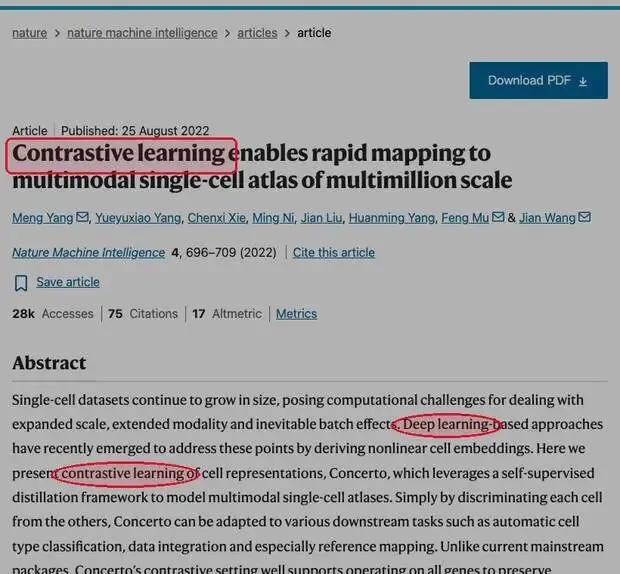 Concerto:Nature Machine Intelligence 论文页 |
▸ 原页截图|华大智造(第 3 / 4 张) 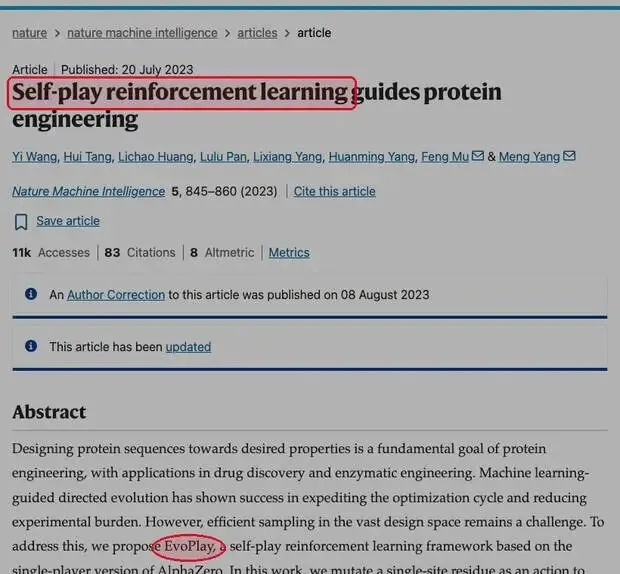 EvoPlay:Nature Machine Intelligence 论文页 |
▸ 原页截图|华大智造(第 4 / 4 张) 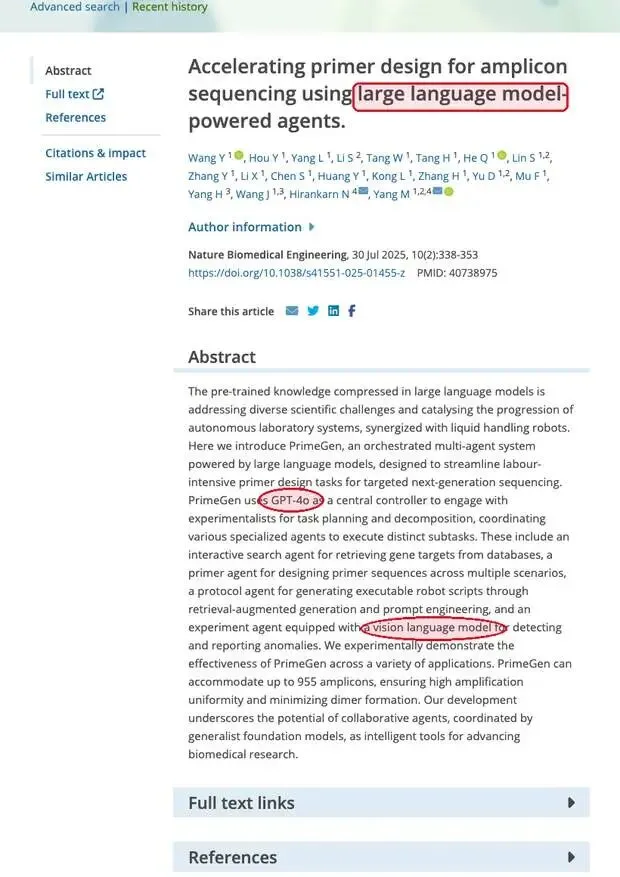 PrimeGen:Nature Biomedical Engineering 论文页 |
齐碳科技 · Bream 纳米孔碱基识别 + 甲基化检测 Frontiers in Genetics 2026-01-14(10.3389/fgene.2026.1743148)|碱基识别准确率 89.38%–91.83%,公司口径与 ONT R9.4 相当|训练数据为拟南芥、水稻、黑腹果蝇|开源深度学习框架 谁主导:中山大学提供方法学,齐碳提供工程化与数据 【证据】渠道:同行评议论文 原始出处:https://doi.org/10.3389/fgene.2026.1743148 |
▸ 原页截图|齐碳科技 把深度学习同时用于碱基识别与甲基化识别,属于纳米孔测序仪上游算法。 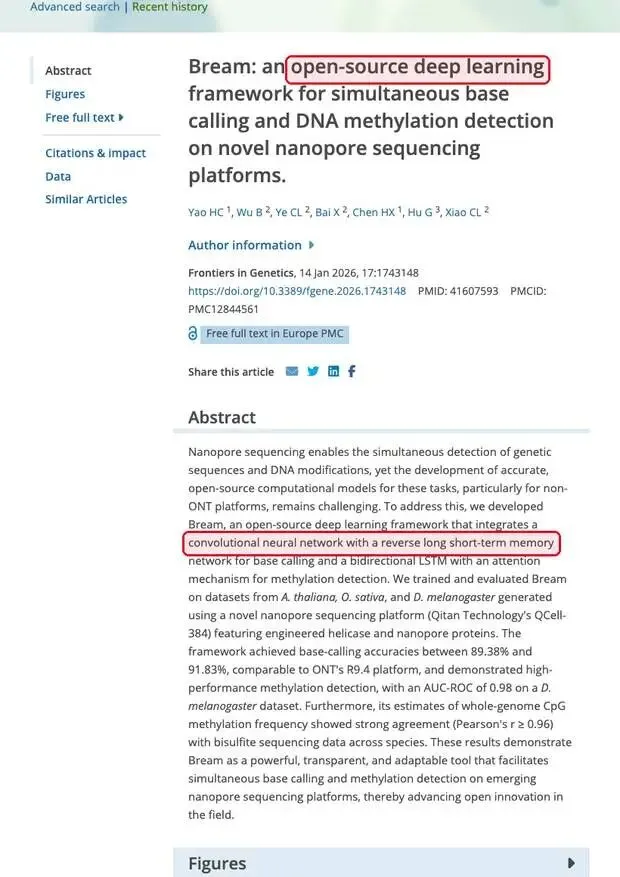 Bream:Frontiers in Genetics 论文页,标题与摘要 |
杰毅生物 × 北京协和 · 全基因组药敏预测模型 机器学习 + 全基因组测序(WGS) Int J Antimicrob Agents 2026-04-15(67 卷 7 期, 107807;DOI 10.1016/j.ijantimicag.2026.107807)|5239 株菌株(2004–2022)、11 种抗生素,AUC 均值 >0.9,平均 CA 0.96|论文训练 9 个机器学习模型|把药敏报告时间从 48–72 小时压到 24–30 小时 谁主导:北京协和杨启文团队 + 杭州杰毅。杰毅同时是阿里云在感染 AI 上的战略合作方 【证据】渠道:同行评议论文 原始出处:https://doi.org/10.1016/j.ijantimicag.2026.107807 |
▸ 原页截图|杰毅生物 × 北京协和 用机器学习从全基因组测序数据预测多层级耐药表型,把 mNGS 的耐药预测做成可落地的算法模块。 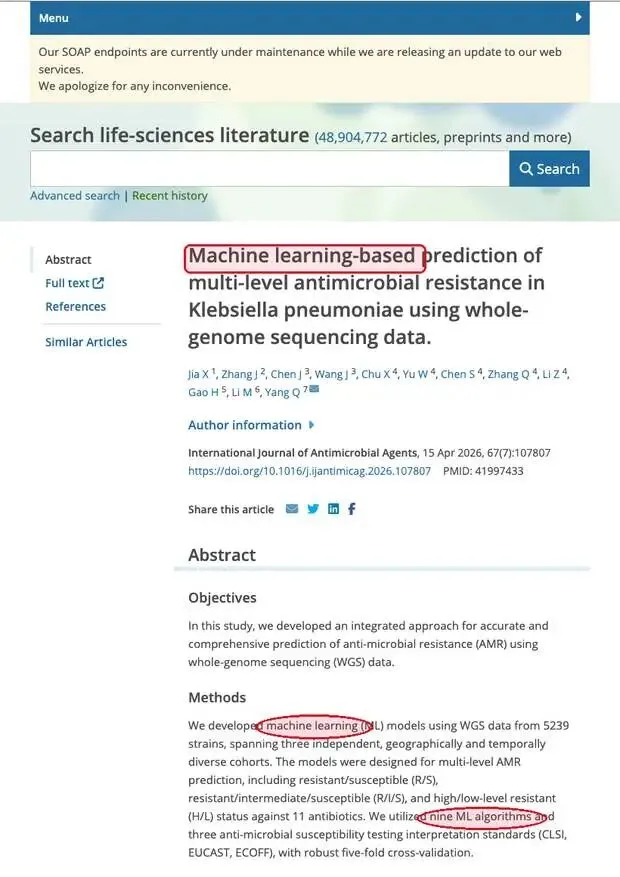 International Journal of Antimicrobial Agents 论文页,标题即「machine learning-based prediction of multi-level antimicrobial resistance」 |
金匙医学 · GenseqAMR 耐药表型预测(mNGS-AST) 以 J Clin Microbiol 2023(10.1128/jcm.01805-22,PMID 37022167,鲍曼不动杆菌)领衔,另有肺炎克雷伯菌(J Antimicrob Chemother 2024)、大肠埃希菌粘菌素(J Infect 2023)、ESKAPEE 五菌(Microbiol Spectr 2025)|方法为 LASSO / 随机森林 / XGBoost|准确率 96.57%–98.36%,报告时间 19.1 小时 vs 培养法 63.3 小时|GenseqAMR 是金匙官网产品时间线里 2021.06 上线的命名产品(早期融资稿曾用名 DeepAMR),累计 9 篇论文、累计影响因子 82.7 谁主导:广东省人民医院 + 金匙。金匙首席医学官饶冠华任共同通讯、金匙员工作共同一作——金匙是模型的共同开发方,不是只供样本的验证方(注意区分:DeepGEM 是广医一院×腾讯 AI Lab 开发、金域做验证方,金匙则是自己模型共同开发方)。邮箱 @genskey.com。另注:它那篇 Clin Chem 2021 是假阳性过滤、走的是阈值规则;专利 CN121747819A 是“基于规则的自动化解读”——这两个都不算 AI,别混进来。官网原话见 [35],上线时间线见 [36],截图如下。 【证据】渠道:同行评议论文 + 官网产品页 原始出处:https://www.genskey.com/h-col-120.html(官网产品页)https://www.genskey.com/h-col-115.html(企业历程)https://doi.org/10.1128/jcm.01805-22(代表论文) |
▸ 原页截图|金匙医学(第 1 / 2 张) 官网产品页原话:「GenseqAMR 分子药敏预测,依托于数万例细菌全基因组测序大数据、 金匙自研机器学习专利技术 」。累计 9 篇同行评议论文、累计影响因子 82.7;金匙首席医学官任共同通讯、金匙员工任共同一作——是 共同开发方 ,不是只供样本的验证方。 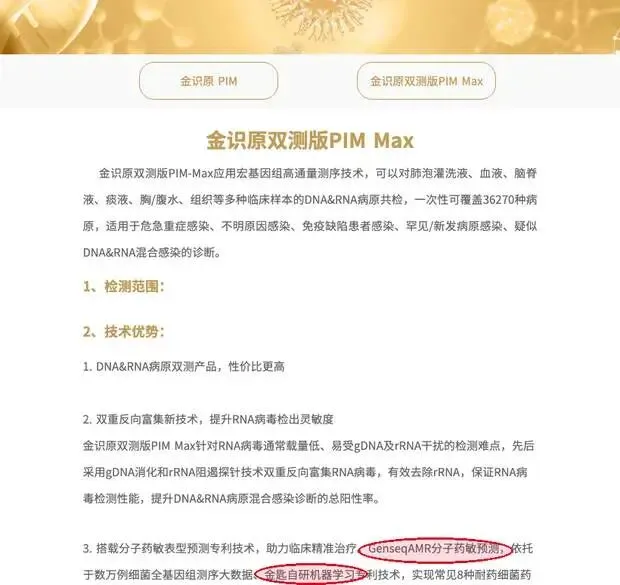 金匙官网产品页:「搭载分子药敏表型预测专利技术……金匙自研机器学习专利技术」 |
▸ 原页截图|金匙医学(第 2 / 2 张) 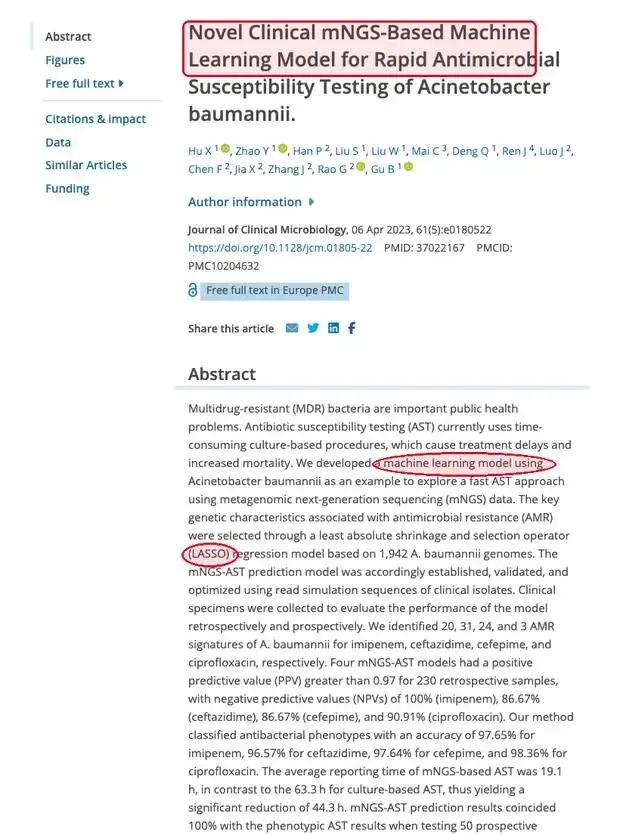 J Clin Microbiol 2023:标题、全部作者、卷期、DOI、摘要 |
证据① 金匙官网产品页|“GenseqAMR 分子药敏预测,依托于数万例细菌全基因组测序大数据、金匙自研机器学习专利技术” https://www.genskey.com/h-col-120.html
证据② 论文权威页(Europe PMC)|J Clin Microbiol 2023, 61(5):e0180522、DOI 10.1128/jcm.01805-22、PMID 37022167 https://europepmc.org/article/MED/37022167
L3 · 自研 AI 应用产品8 家 —— 有产品,底层模型多数没有披露
这一层有自研 AI 产品 / 智能体在外面跑,但多数家的公开材料没有披露底层用的是自家模型还是外部基座。有产品和有 AI,是两件事,这一层最容易混。
涌生智能 · ProtoPilot 实验室自动化智能体 arXiv 2606.31763(v1 2026-06-30)|另有与上海人工智能实验室联合发布的 BioLab Bench 全流程评测体系。定位是干实验闭环里的智能体,不是测序数据解读模型。 谁主导:华大智造(688114)2026 年上半年设立的子公司,与上海人工智能实验室联合发布 【证据】渠道:预印本(arXiv) |
▸ 原页截图|涌生智能 实验室智能体(Lab Agent)方向,让模型自主编排实验流程。华大智造(688114)2026 年上半年设立的子公司,与上海人工智能实验室联合发布。 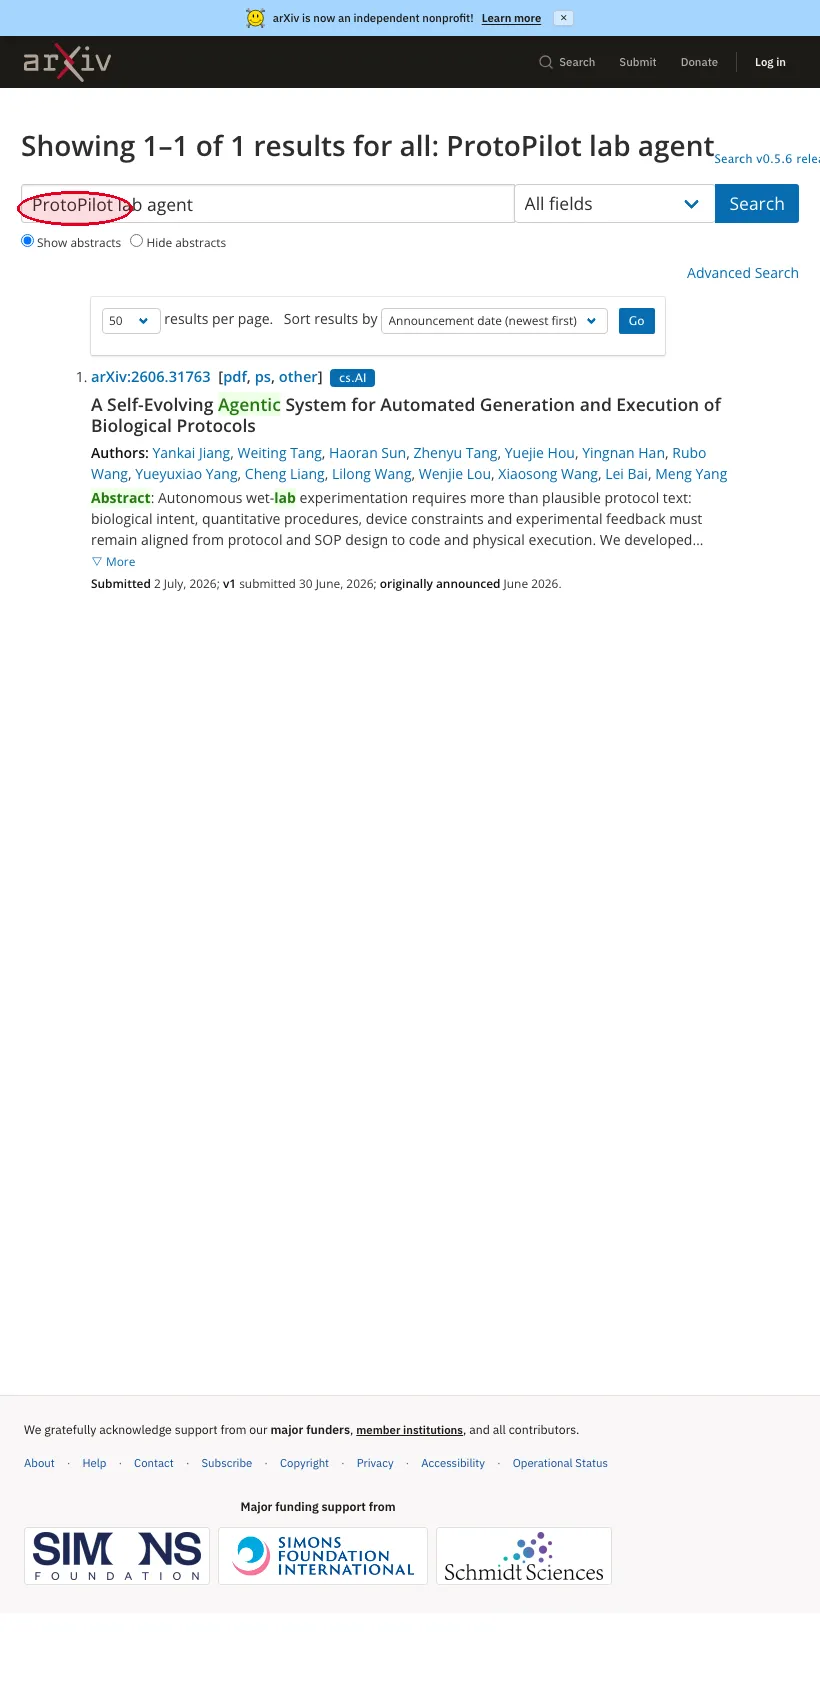 涌生智能 · ProtoPilot · 公开披露页(出处见上方) 原始链接:https://arxiv.org/abs/2606.31763 |
赛陆(Salus BioMed) · OCellus 虚拟细胞模型(本轮唯一“有模型名 + 有预印本”的测序仪厂商) 2026-07-12 在 bioRxiv 挂出署名预印本(9B、基于 Qwen3.5-9B 微调,22 项生物任务平均 72.6%);论文声明代码与权重待正式发表后开放——即未同行评议、未开源。另有自研碱基识别与甲基化算法专利,以及两张测序仪三类证(Salus Pro 国械注准20253220191、Saluseq Nimbo 国械注准20253222564)——后两张批的是测序仪本身,与 AI 无关。 谁主导:公司主导(预印本作者单位为 Shenzhen Salus BioMed) 【证据】渠道:预印本(bioRxiv) 原始出处:https://doi.org/10.64898/2026.07.08.737248 |
▸ 原页截图|赛陆(第 3 / 3 张) 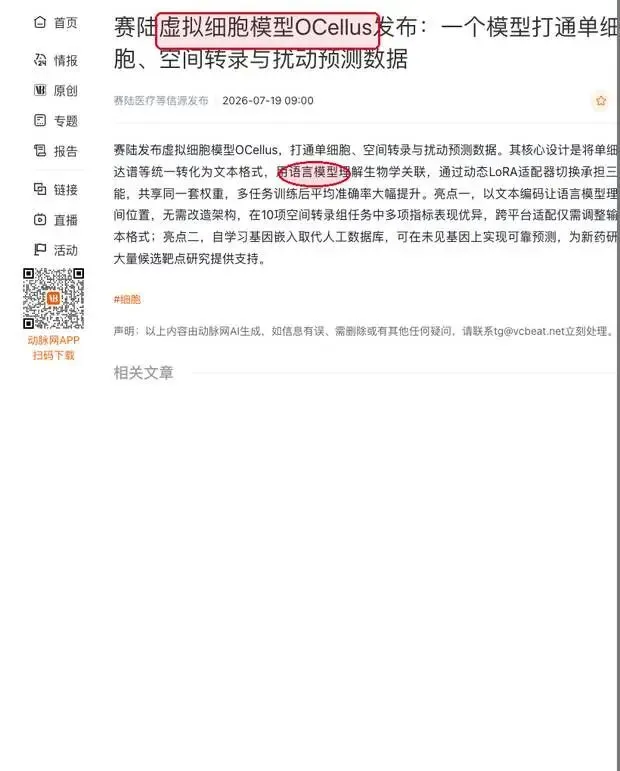 赛陆:虚拟细胞模型 OCellus 发布(打通单细胞、空间转录与扰动预测) |
这些都有真实产品在跑,但 AI 部分查不到论文、专利或可核验的算法细节——只有公司口径。有产品和有 AI 是两件事,这一档最容易混。
公司 | AI 相关产品名 | 能查到的全部事实 |
金域医学 | 域见医言 + 小域医 | 2024-08 发布,公司口径“行业首个医检垂类大模型”。2026-02 访谈:智能体超 60 个、调用 1500 万次;2026 年一季度:超 100 个、超 3000 万次——数字随发布时点跳,引用须标日期。另有与腾讯、广医一院合作的 DeepGEM:论文在《柳叶刀·肿瘤》2024-12-06,但署名单位是广医一院与腾讯;金域 2025-10 才加入做验证,带来 4260 例样本 / 8520 张切片。另有联合华为云开发的宫颈细胞学 AI 辅助诊断模型:基于金域历年 4350 万例宫颈细胞学筛查样本、近 20 万个标注图像块训练,36 秒/例、阳性病变检出率 >99.9%、排阴率 61.9%,筛查效率提高约 4 倍;属联合开发(华为云出技术、金域出数据与病理专家标注),与 DeepGEM 的“金域只做验证”不是一回事。落地是真的,论文不是它的。另:公司 2026 年通过 ISO/IEC 42001 人工智能管理体系认证(口径为“行业首张”);官网称累计调用量已超 4000 万次,未标截止时点。 |
贝瑞基因 | GENOisi 智能体 + BerryChat + Berrylyzer | 2025-04-13 发布 GENOisi™ 智能体(第七届协和母胎医学大会),5 月 26 日智能体云平台上线;是这批里唯一把接入的第三方模型点名的——DeepSeek、千问、Llama、智谱、BiomedGPT、LucaOne 全部写在 2025-02-11 投资者关系记录表里。自研侧是产前变异优先排序系统 Berrylyzer——medRxiv 预印本 2026-04(署名含贝瑞基因,诊断变异首位命中 56.41% / 58.12%、top20 召回 94.02% / 97.42%,优于 Xrare、Exomiser、PhenIX);公司口径另称该自研算法 top5 准确率 99%(2019 年)。 |
诺禾致源 | 诺易 Novi | 2025-02 上线(8 月起通过活动推广),功能是生信绘图、技术交流、图生代码、论文润色、中英互译,免费开放给客户。公告写明“尚未形成收入,且不涉及诊断及检测服务”。一家测序龙头的 AI 落点目前是“帮你画图”,尚未触及诊断环节。 |
桐树基因 | INSIGHT / WiseMSI / AIMedGraph / Phoenix | 2022 年一次性推出四款(公司渠道口径),并说计划为 INSIGHT 报二类证、WiseMSI 报三类证;截至本次检索未见获证记录。注意区分:它 2021 年拿到的是 MSI 检测试剂盒三类证(多重荧光 PCR-毛细管电泳法),那是分子检测产品,不是 AI 产品。 |
予果生物 | PrimEvo + PACEseq(+ 清华合作) | 两个平台都用了机器学习(公司口径符合率 ≥85%)。官网写明“与清华大学深度合作打造微生物垂类大模型”,合作方写清楚了,但模型尚未命名。另有 TB-EASY 舌拭子结核 PCR 试剂盒(国内首款 NMPA 三类证,企业口径)。 |
微远基因 | Solar System / X-Type(体系级口径) | 官网公司简介原话“构建基于基因组学、影像组学与 EMR 的感染性疾病 AI 诊断体系”;研究平台页与 2026 年大会稿明确写“结合 AI 解读大模型”嵌入 MARS 3.0 + Solar System、“借助 AI 赋能病原 NGS 报告解读”;Solar System 内还内置“新发病原预测的 AI 模型”(冠状病毒新物种发现,用大量模拟数据训练验证)。但这些 AI 宣称都停在公司/产品口径:① 没有命名论文模型——微远 120+ 篇 SCI 全是 mNGS 临床验证与病原发现,查不到一篇以自家 AI 模型为对象的论文、无 DOI;② 没有 AI 专用注册证——软件证仅湘械注准 20212210314(二类,审的是病原微生物测序分析,不是 AI 算法),三类证(国械注准 20263401813 等)批的都是试剂盒/测序仪,与 AI 无关。官网原文见 [18],截图如下。 |
证据 微远官网“走进微远”页|“专注基因诊断与感染精准医疗,构建 AI 驱动的感染性疾病诊断体系” https://www.visionmedicals.com/about
▸ 原页截图|金域医学(第 1 / 7 张) 医检大模型与智能体矩阵。金域官网 WAIC 稿口径:截至 2026 年 6 月底的智能体数量与调用量。另:2026 年通过 ISO/IEC 42001 人工智能管理体系认证(公司口径“行业首张”)。 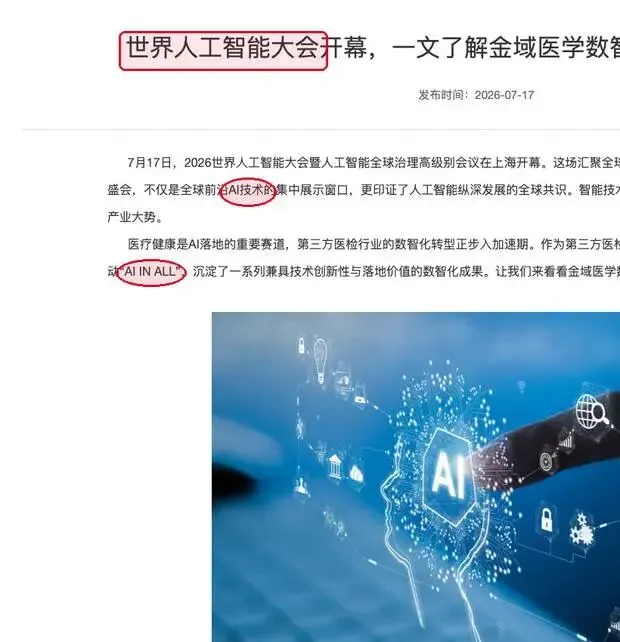 金域官网:世界人工智能大会稿,介绍「域见医言」医检大模型与智能体 原始链接:https://kingmed.com.cn/web/news_x/p_6302.html https://kingmed.com.cn/web/news_x/p_5847.html https://m.kingmed.com.cn/wap/media_x/w_6309.html |
▸ 原页截图|贝瑞基因(第 2 / 7 张) 2025-04-13 发布 GENOisi™ 智能体(第七届协和母胎医学大会),5 月 26 日智能体云平台上线。「产儿一体智能诊疗系统」含遗传咨询智能问答、基因位点智能解读、基因报告智能质控三大功能。BerryChat 以 DeepSeek-R1 为基座、用 Multi-Agent 编排。自研侧另有产前变异优先排序系统 Berrylyzer:medRxiv 预印本 2026-04,署名单位含贝瑞基因,诊断变异首位命中 56.41% / 58.12%、top20 召回 94.02% / 97.42%。 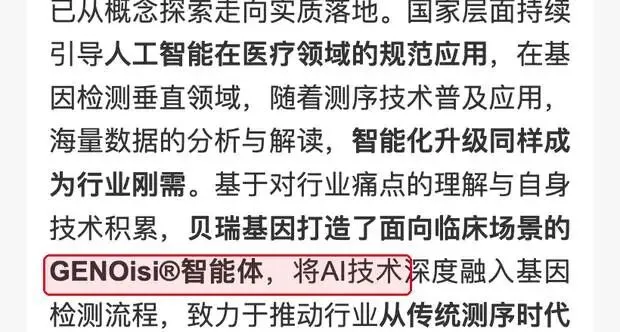 新京报报道:贝瑞基因「GENOisi® 智能体,将 AI 技术深度融入基因检测流程」 原始链接:https://m.bjnews.com.cn/detail/1784082770129478.html https://static.cninfo.com.cn/finalpage/2026-08-24/1225491139.PDF https://doi.org/10.64898/2026.04.02.26349929 |
▸ 原页截图|诺禾致源(第 3 / 7 张) AI 生信智能专家,集生信绘图、技术交流、中英互译、图生代码、论文润色于一体,2025-02 上线,免费开放给客户(2025-02-17 异动公告已确认免费提供给客户;8 月起通过活动推广)。 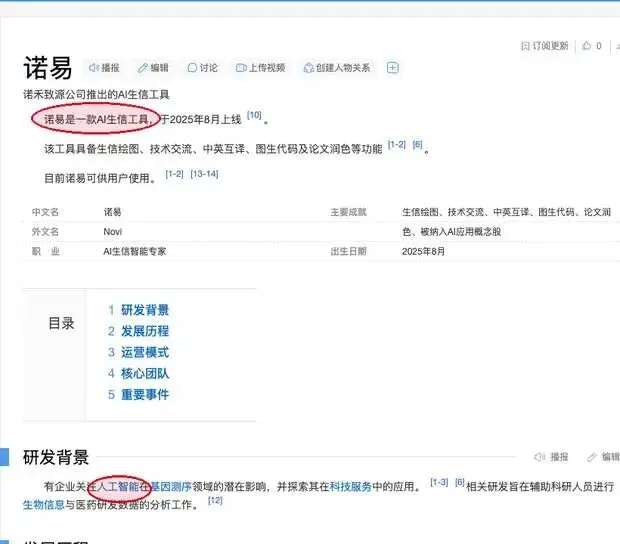 诺易词条:「诺禾致源公司推出的 AI 生信工具」及功能清单 原始链接:https://cn.novogene.com |
▸ 原页截图|桐树基因(第 4 / 7 张) 一口气发布四款 AI 产品,覆盖生信分析、MSI 智能判读、医学知识图谱与报告生成。 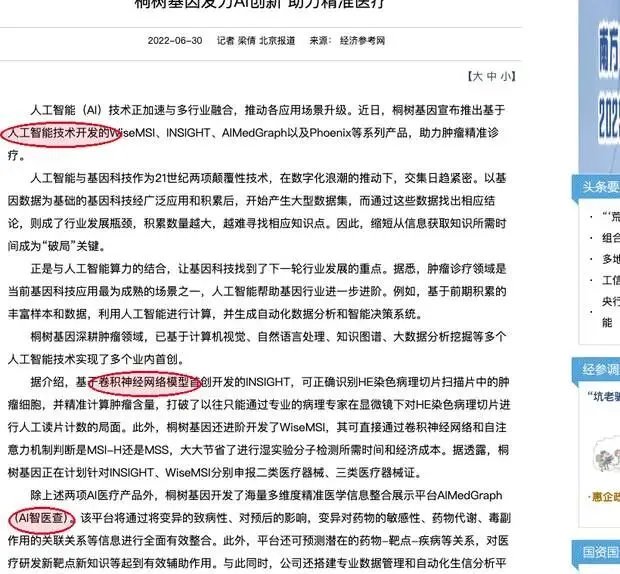 经济参考报报道:桐树基因四款 AI 产品发布 原始链接:https://www.jjckb.cn/2022-06/30/c_1310636104.htm |
▸ 原页截图|予果生物(第 5 / 7 张) 官网定位「沉浸式 AI 驱动微生物检测平台」,融合 AI 与多组学数据做引物设计与病原分析,公告称研发周期缩短逾 80%。公司同时披露正与清华大学共建微生物垂类大模型。 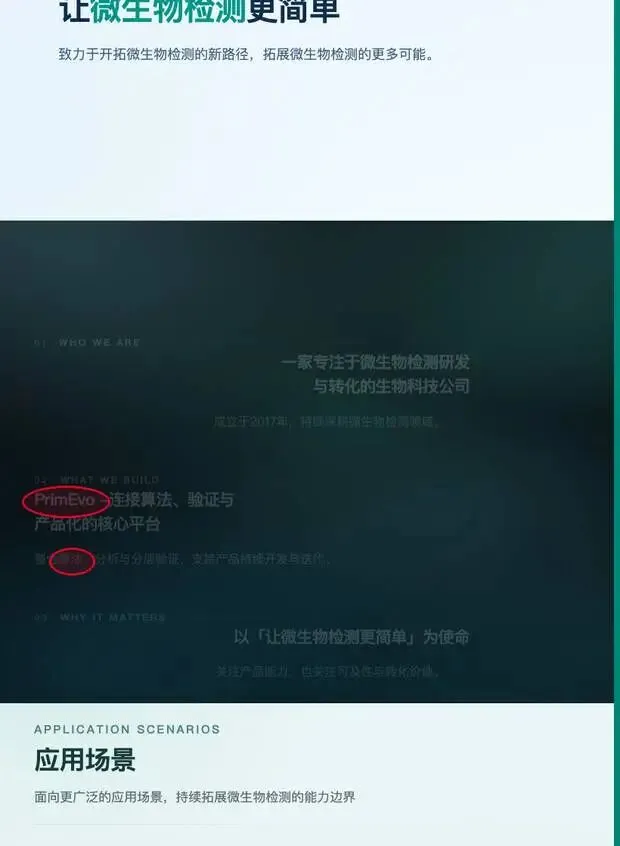 予果官网:「PrimEvo——连接算法、验证与产品化的核心平台」 原始链接:https://www.hugobiotech.com/about https://www.shobserver.com/staticsg/res/html/web/newsDetail.html?id=1045248 |
▸ 原页截图|予果生物(第 6 / 7 张) 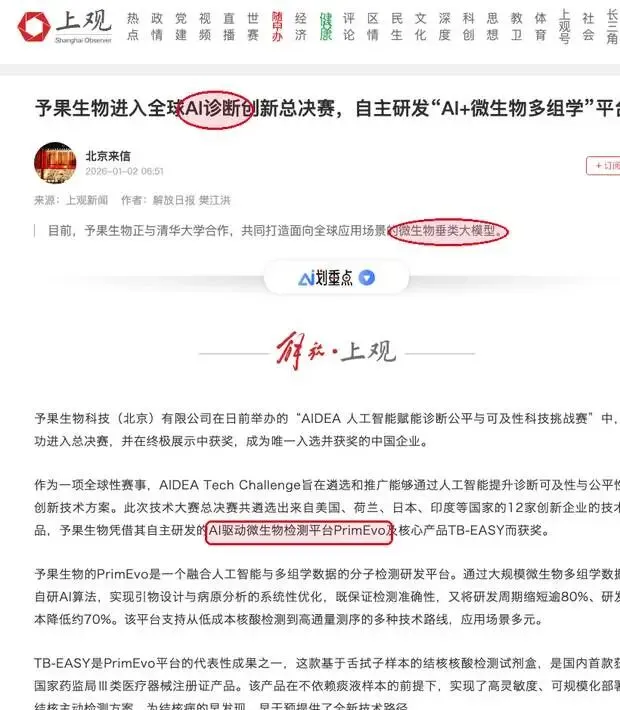 报道:予果「AI 驱动的微生物检测平台 PrimEvo」进入全球 AI 诊断创新总决赛 |
▸ 原页截图|微远基因(第 7 / 7 张) 官网 /about 原话:「构建 AI 驱动 的感染性疾病诊断体系」;产品中心写 MARS 3.0「结合 AI 解读大模型」。但它的三类证(国械注准 20263401813)批的是 试剂盒,与 AI 无关 ,也查不到以自家 AI 模型为对象的论文——所以留在这一档,不往上升。 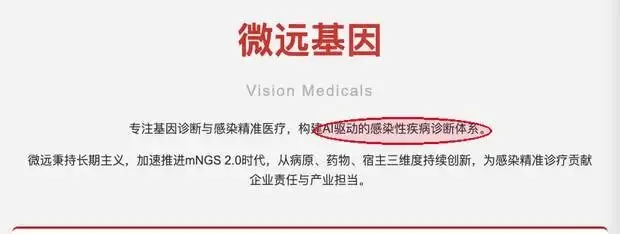 微远官网 /about:「构建 AI 驱动的感染性疾病诊断体系」 原始链接:https://www.visionmedicals.com/product |
L4 · 只接入外部大模型2 家 —— 应用方,不是自研方
这两家是应用方:直接接入外部大模型并做本地化部署。接入是应用策略,自研是模型能力,两件事没有高下。
用别人的模型——圣湘、康为
圣湘生物(688289)在 2025-02-11 / 02-12 两天接续把传染病数智化系统、数智测序系统接入 DeepSeek-R1 并本地化部署;SUREXEVO 系列的“AI”指 AI 进化酶与 AI 样本质控模块,入围工信部人工智能医疗器械揭榜挂帅;2024 年与 IQVIA 合作的甲流预测模型是“规则引擎 + 机器学习”,未见论文。康为世纪(688426)则只在 2026 年中报里提到借鉴 DeepSeek 优化数字化立体营销体系、建设本地化产品知识库;中报研发项目表另载:云平台 3.0「引入 AI 工具,实现自然语言对话进行数据分析和绘图」。两家都是应用方,不是自研方——两条不同的路,没有高下。
【证据】本组渠道(圣湘、康为):公司公告 / 中报。圣湘在 2025-02-11 / 02-12 接续把传染病数智化系统、数智测序系统接入 DeepSeek-R1 并本地化部署;康为仅在 2026 年中报提到借鉴 DeepSeek 优化数字化立体营销体系、建设本地化产品知识库,并在研发项目表载明云平台 3.0 引入 AI 工具。两家均为应用方,非自研方。原页截图见下方。 |
▸ 原页截图|圣湘生物(第 1 / 2 张) 圣湘在 2025-02-11 / 02-12 接续把传染病数智化系统、数智测序系统接入 DeepSeek-R1 并本地化部署;康为则在中报里提到借鉴 DeepSeek 优化数字化立体营销体系、强化数据搜索整合能力、建设本地化产品知识库。 两家都是应用方,不是自研方——两条不同的路,没有高下。 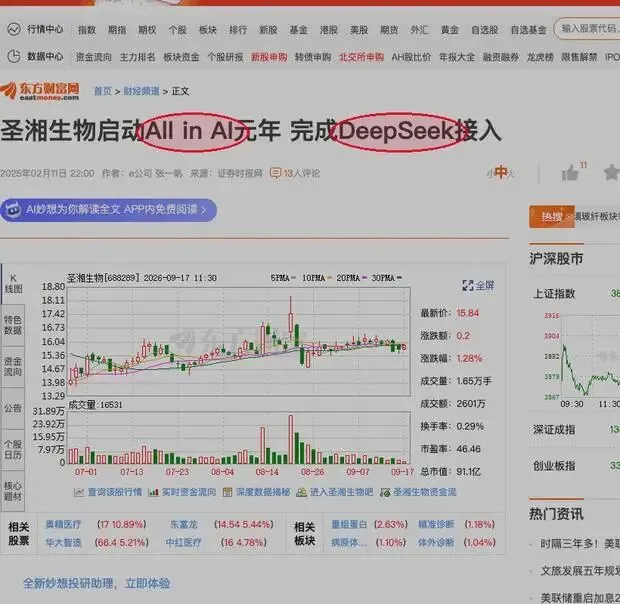 圣湘生物 2025-02-11 / 02-12 接续完成两个系统的 DeepSeek 接入 原始链接:https://4g.stockstar.com/detail/RB2026090100020843 |
▸ 原页截图|康为世纪(第 2 / 2 张) 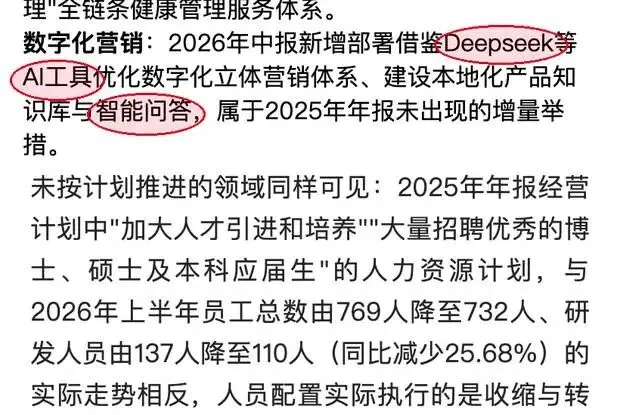 康为世纪 2026 中报:「新增部署借鉴 Deepseek 等 AI 工具优化数字化立体营销体系、建设本地化产品知识库与智能问答」 |
L5 · 工程件 / 停在算法层3 家 —— 有技术动作,但没走出产品与论文
这里得分开:一类是测序仪里用神经网络做碱基识别——那是工程标配,决定仪器能不能用,不等于有没有 AI 能力;另一类是本次检索真的没查到公开 AI 动作。
(1)有真算法,但没有说成大模型——真迈、赛纳
真迈官网写着“基于机器学习的碱基识别算法”,旗舰机 SURFSeq Q 的产品页把“Q40 ≥90%”归因于“创新测序化学 + AI 碱基识别算法”,并公开了 3 件碱基识别模型专利——CN120220825A「自动生成碱基识别模型的系统和方法」(2025-03-03 申请 / 2025-06-27 公开,摘要写明用训练集多轮迭代、验证集评估获得碱基识别模型)、CN118429965A、CN118942549A;赛纳把“高精度深度学习碱基识别算法”列进核心技术。碱基识别用神经网络属于工程标配——决定仪器能不能用,不是有没有 AI 能力。两家都只说到「碱基识别算法」这一层,没有说成发布大模型——写法是对的。
【证据】本组渠道(真迈、赛纳):官网 / 专利 / 招股书 / 报道。两家把机器学习用于碱基识别这类「仪器能不能用」的工程环节——是工程标配,不等于发布了大模型。原页截图见下方。 |
▸ 原页截图|真迈(第 1 / 3 张) 两家把机器学习用在碱基识别这类「仪器能不能用」的工程环节。赛陆另在 2026-07 挂出虚拟细胞模型 OCellus 的 bioRxiv 预印本(9B、基于 Qwen3.5-9B 微调、22 项任务平均 72.6%;声明代码与权重待正式发表后开放),未同行评议、未开源。这是工程标配,不等于发布了大模型——他们的写法本身没问题,问题是外界容易把它当成「有 AI 能力」。 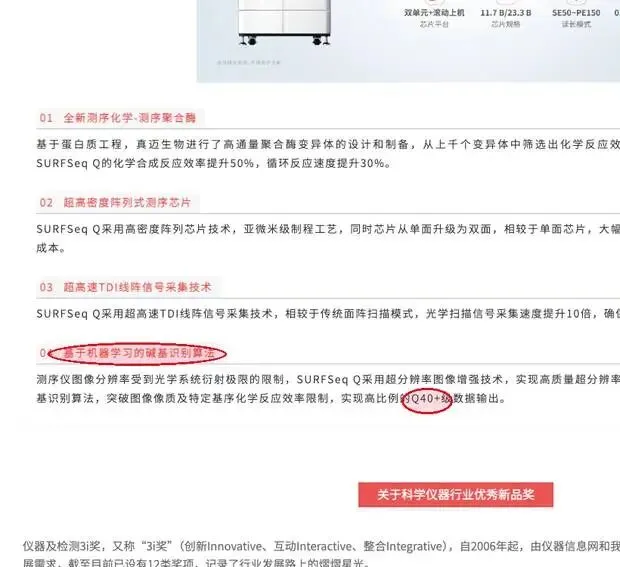 真迈官网 SURFSeq Q 页第 04 条:「基于机器学习的碱基识别算法」 原始链接:https://www.genemind.com/news_view.aspx?nid=2&typeid=4&id=909 https://www.genemind.com/yiqipt_view.aspx?nid=3&typeid=10&id=208 https://www.cygnusbio.com/hplusj/view.php?aid=208 https://www.vbdata.cn/intelDetail/1052847 https://doi.org/10.64898/2026.07.08.737248 |
▸ 原页截图|赛纳(第 2 / 3 张) 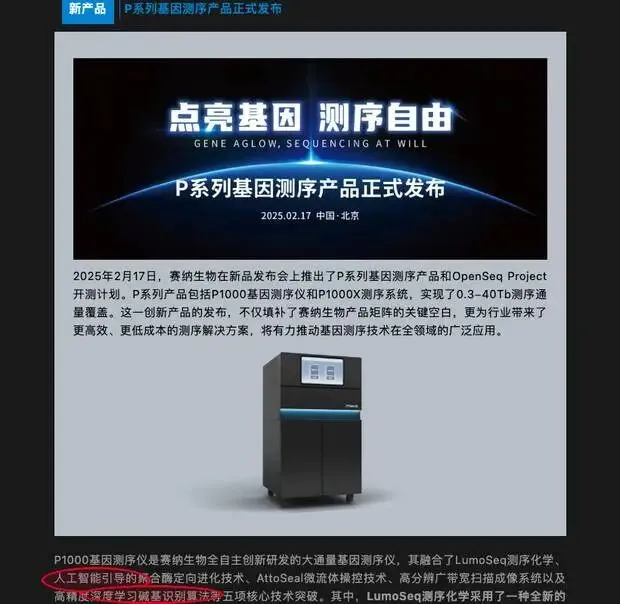 赛纳 P 系列发布页:核心技术含「高精度深度学习碱基识别算法」 |
(2)有算法,但未见命名模型——燃石
燃石医学有 MMcall、ELSA-seq 这类算法,也有一件美国授权专利(US 12460202 B2,2025-11-04 授权)——但那件专利保护的是核酸建库方法、与 AI 无关;它同时是 DeepGEM 那篇《柳叶刀·肿瘤》的共同署名单位,但未见其发布命名大模型。查不到就是查不到,不硬凑,也不拿不相干的专利凑。
【证据】本组渠道(燃石):未见公开披露。燃石有 MMcall、ELSA-seq 算法与美国专利(属扎实算法积累),但未见其发布命名大模型——「没查到」即结论,不作伪证。口径说明见本篇末尾 Part D。 |
▸ 原页截图|燃石医学 燃石医学有 MMcall、ELSA-seq 这类算法(在业内属扎实的算法积累),也有一件美国授权专利 US 12460202 B2(2025-11-04 授权)——但那件专利保护的是核酸建库方法、与 AI 无关,不计入 AI 证据,但 未见其发布命名大模型 。查不到就是查不到,不硬凑——「没查到」即结论,不作伪证。 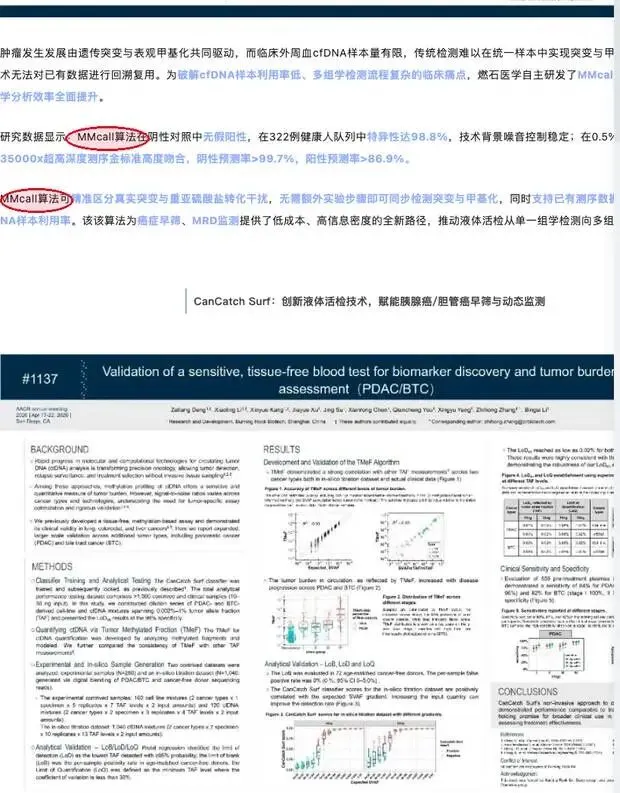 燃石医学:MMcall 算法(特异性 98.8%、阴性预测率 >99.7%),属算法而非命名大模型 原始链接:https://www.pharnexcloud.com/zixun/shiye/qy_298273 |
行业基础设施不做测序,但在给这行造底座
这几家不进主表——它们不是 NGS 公司,但国内 NGS 公司用的很多模型能力来自这里。不提它们,这张图就是不全的。百图生科虽是 AI for Science 公司,但自身不做测序、也不对外提供 NGS 服务,故不计入 23 家主体;阿里云、复旦同理。
百图生科 BioMap · xTrimo V4 2680 亿参数(268B) 公司官网口径“全球首个 268B 生命科学基础模型”,MoE 架构,覆盖蛋白 / DNA / RNA 等七类模态,20+ 领域 300+ 项 SOTA。产品是 BioMap OS 干湿闭环发现系统,算法家族含 TrinityDNA、ProteinReasoner、ProteinNext、scFoundation。2025-12 获 Arc 虚拟细胞挑战赛冠军。创始人为李彦宏,CEO 刘维。本轮参数最大的一个,但主战场在药物与蛋白发现。 谁主导:公司主导 · https://www.biomap.com/ 【证据】渠道:官网 / 发布会 原始出处:https://www.biomap.com/(官网)https://bydrug.pharmcube.com/news/detail/d1d7ecd86274f3a39ae0f16667b0aeda(发布报道) |
▸ 原页截图|百图生科 生命科学基础大模型,公开口径为全球首个参数规模达 2680 亿的生命科学基础大模型,覆盖蛋白、DNA、RNA 等模态。 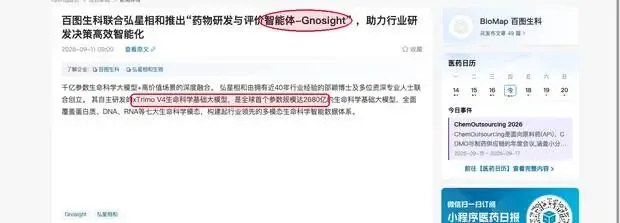 xTrimo V4:「全球首个参数规模达 2680 亿的生命科学基础大模型」 |
阿里云飞天实验室 · LucaOne 首个联合 DNA/RNA/蛋白的生物基础模型 Nature Machine Intelligence 2025-06-18(10.1038/s42256-025-01044-4)|改进 Transformer-Encoder(pre-layer norm + RoPE),训练集覆盖 169,861 个物种的12 亿条核酸 + 6 亿条蛋白序列|模型、训练与推理代码全面开源(Apache-2.0)。同团队还有 LucaProt(Cell 2024,RNA 病毒发现)。贝瑞基因的接入清单里点名了它。 谁主导:阿里云飞天实验室 + 中山大学施莽团队 【证据】渠道:同行评议论文(Nature Machine Intelligence) 原始出处:https://doi.org/10.1038/s42256-025-01044-4 |
▸ 原页截图|阿里云 · 复旦 统一的核酸与蛋白语言基础模型,把 DNA / RNA / 蛋白放进同一语义空间。 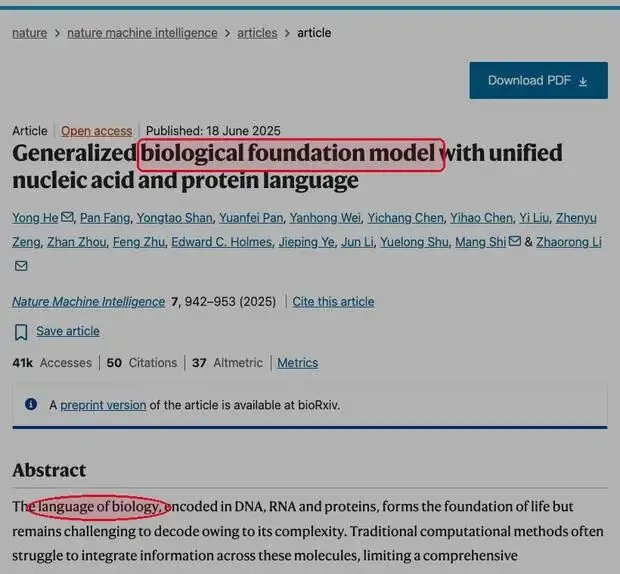 LucaOne:「Generalized biological foundation model with unified nucleic acid and protein language」 |
复旦大学 × 百图生科 · EnTao-GPM 胚系致病突变预测 arXiv 2507.21706(2025-07-29)|跨物种定向预训练(人、猪、小鼠),在 ClinVar、HGMD 上微调,结合 DNA 序列表征与 LLM 统计解释。另有 MAIGGT(Advanced Science 2025-08-01,10.1002/advs.202502833,PMID 40439693)整合病理切片微环境与电子病历预筛 BRCA1/2 突变,三个独立队列 AUC 0.925 / 0.845 / 0.833。 谁主导:复旦大学 + 百图生科(论文预印本,尚未同行评议) 【证据】渠道:预印本(arXiv 2507.21706) 原始出处:https://arxiv.org/abs/2507.21706 |
▸ 原页截图|复旦大学 × 百图生科 基于 xTrimoDNA 训练,聚焦种系致病突变预测;可用 VCF 标准格式输入、适配轻量级部署,面向遗传病诊断场景。 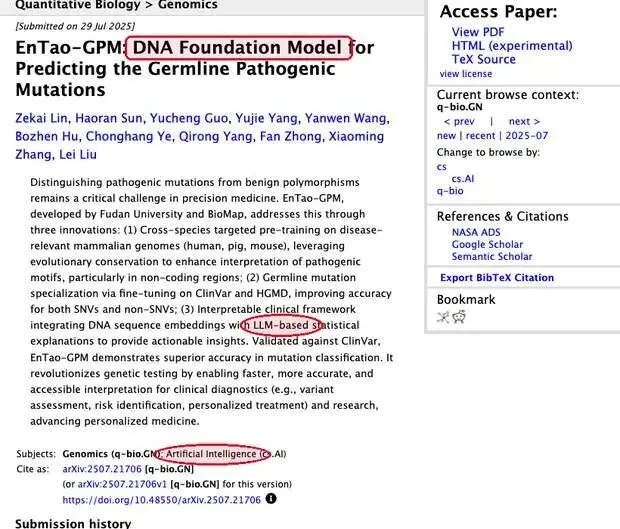 EnTao-GPM:arXiv 论文页,作者单位含复旦大学与 BioMap Research |
海外对照两个标杆 + 三家测序仪巨头
放这两组不是为了“国外月亮圆”,是给一个尺度:什么叫把话说全。这里只作对照,不计入国内 23 家。
DeepMind · AlphaGenome 调控变异效应预测 Nature 649: 1206-1218,2026-01-28(10.1038/s41586-025-10014-0)|输入 100 万碱基,同时预测数千条功能基因组轨迹;原文表述是 26 项变异效应评估中 25 项达到或超过现有最强外部模型|时间线:2025-06-25 先上 bioRxiv(10.1101/2025.06.25.661532)并开放 API,2026-01-28 正式发表|发表后代码与模型权重全部开源,3000+ 科学家在用、日均超 100 万次 API 调用。 谁主导:Google DeepMind 【证据】渠道:同行评议论文(Nature) 原始出处:https://doi.org/10.1038/s41586-025-10014-0 |
▸ 原页截图|Google DeepMind 一次前向计算同时给出数千条调控轨迹的预测,面向调控变异效应预测。 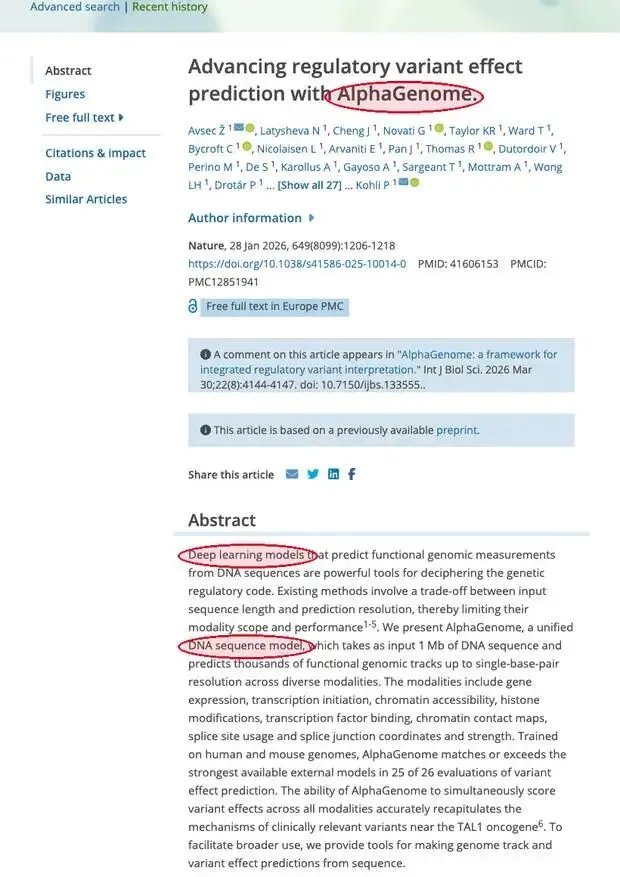 AlphaGenome:Nature 论文页「Advancing regulatory variant effect prediction」 |
Arc Institute × NVIDIA · Evo 2 基因组基础模型 Nature 2026-03-04(10.1038/s41586-026-10176-5)|400 亿参数,9.3 万亿核苷酸,12.8 万个基因组,StripedHyena 2 架构、100 万 token 上下文,7B 与 40B 双版本|BRCA1 变异分类 AUPRC 0.88 / AUROC 0.95;已设计出 16 个功能性合成噬菌体|代码 + 权重 + OpenGenome2 数据集全部开源。2025-02 先开源预印本,一年多后才上正刊。 谁主导:Arc Institute + NVIDIA 【证据】渠道:同行评议论文(Nature) 原始出处:https://doi.org/10.1038/s41586-026-10176-5 |
▸ 原页截图|Arc Institute × NVIDIA 跨全部生命域的基因组语言模型,支持零样本变异效应预测。 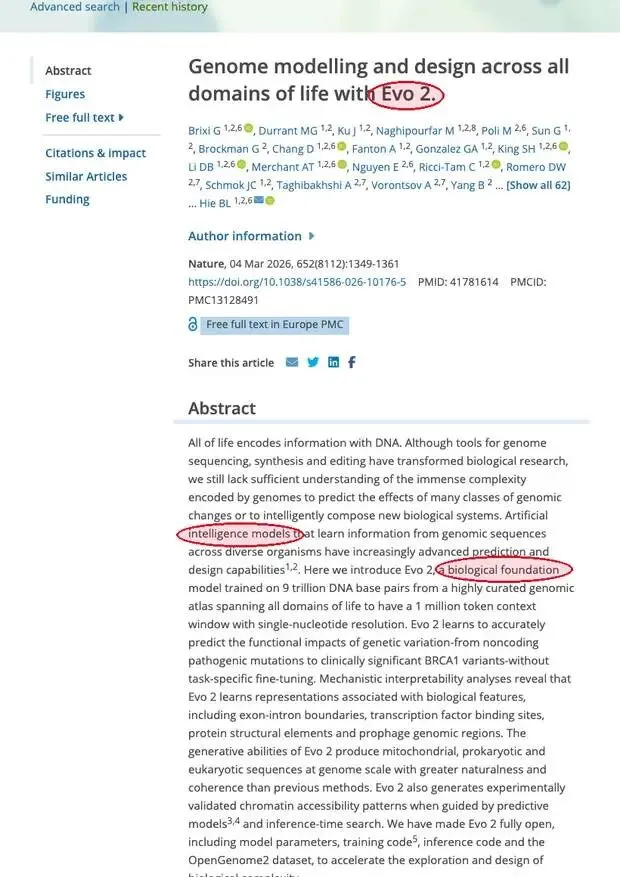 Evo 2:Nature 论文页「Genome modeling and design across all domains of life」 |
测序仪三巨头:Illumina / ONT / PacBio
Illumina 的 SpliceAI(2019)、PrimateAI-3D(Science 2023)、PromoterAI(Science 2025)都发在顶刊;三个工具联用,对英国 10 万基因组项目里可解病例“能解释约一半”。ONT 的 Dorado v5.2 是 Transformer + CTC 的 basecaller;PacBio 的 DeepConsensus 是与 Google 合作的 transformer 模型,把 HiFi 错误降了约 42%。三家都有真 AI,也都不开“大模型发布会”——这反过来说明:测序仪上的 AI 是工程件,不是卖点。
▸ 原页截图|Illumina / Oxford Nanopore / PacBio(第 1 / 2 张) 三家测序上游巨头各自的 AI 组件,均可在官网与论文中查到:PrimateAI-3D 做变异致病性预测,Dorado 做纳米孔碱基识别,DeepConsensus 做一致性序列提升。 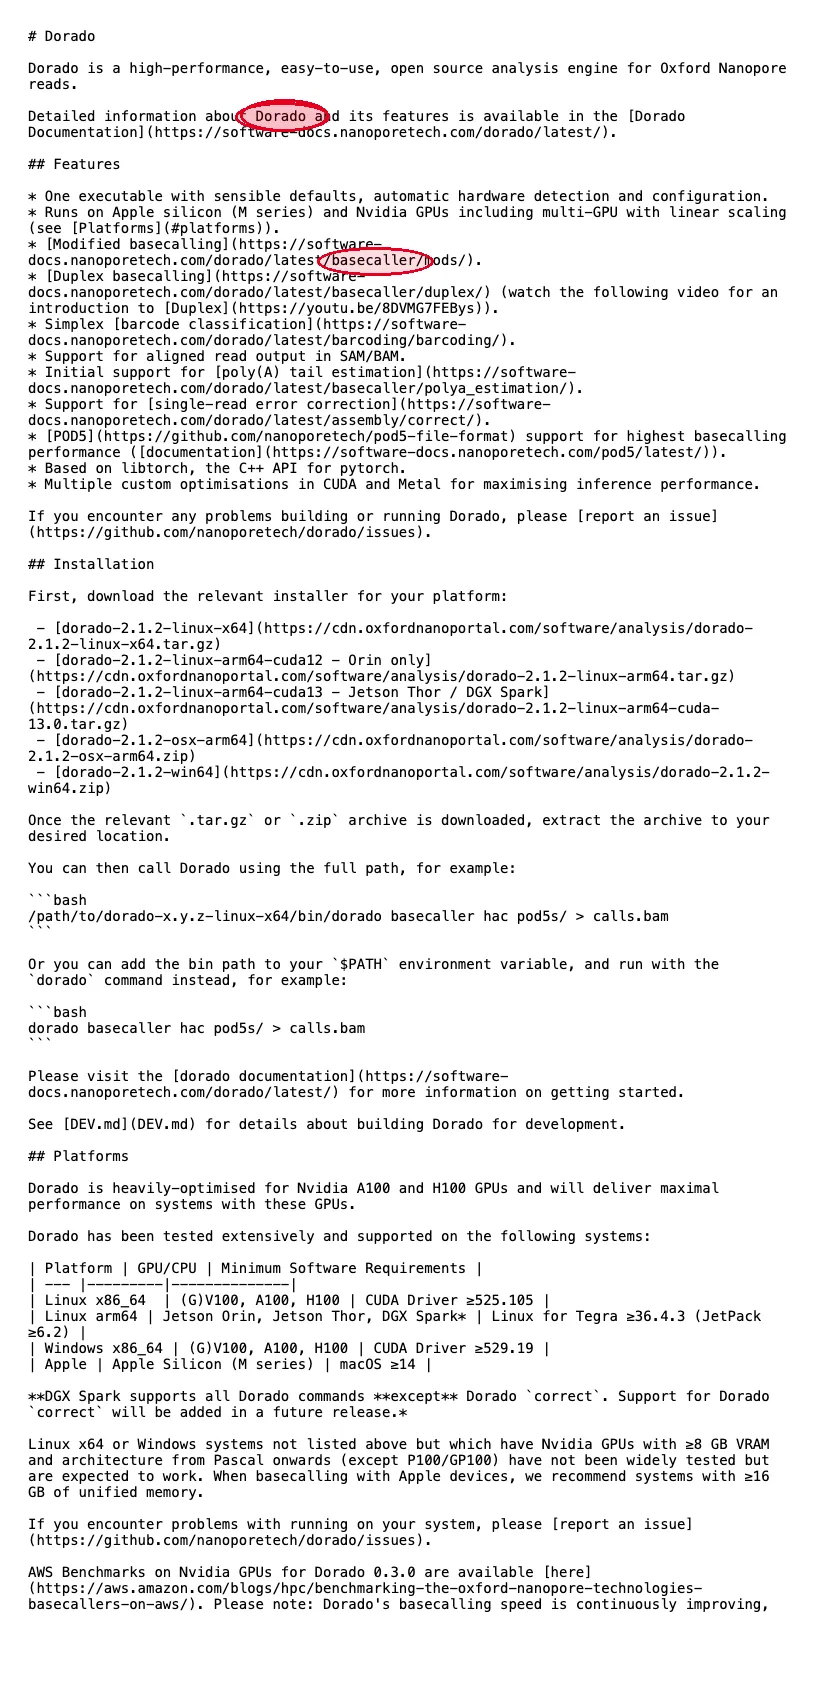 Illumina / Oxford Nanopore / PacBio · PrimateAI-3D / Dorado / DeepConsensus · 公开披露页(出处见上方) 原始链接:https://www.illumina.com https://github.com/nanoporetech/dorado https://github.com/google/deepconsensus |
▸ 原页截图|Illumina / Oxford Nanopore / PacBio(第 2 / 2 张) 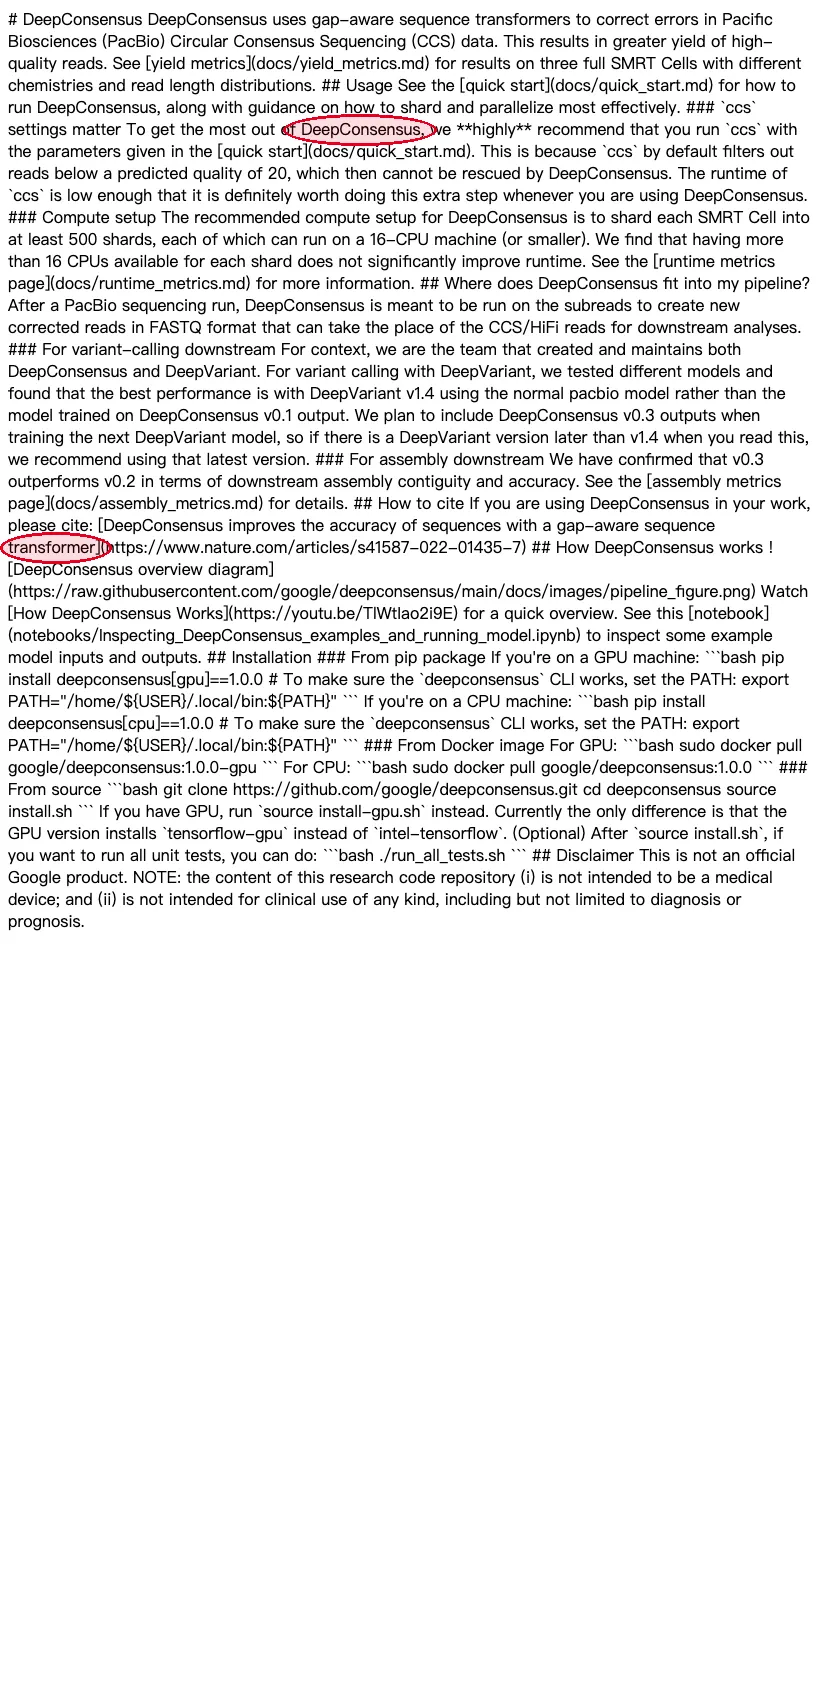 Illumina / Oxford Nanopore / PacBio · PrimateAI-3D / Dorado / DeepConsensus · 公开披露页(出处见上方) |
注:Illumina 官网为 JS 渲染页面,本次未能稳定截取含 PrimateAI-3D 原文的截图;其 AI 组件(SpliceAI、PrimateAI-3D、PromoterAI)均见顶刊论文,以正文为准。
23 家就摆在这里。下面把 39 份原始出处与 35 张原页截图一次公开,你可以自己点回去核。
Part D · 39 份原始出处与 35 张原页截图 每一句 AI 宣称,都能点回原文;每一条出处,都留了原页截图 |
📚 这一篇是工具书 · 收藏起来随时翻 四种读者怎么用这张索引——它能反复翻,不是读一次就走。 销售 / BD 客户问「凭什么这么说」→ 翻到对应公司 → 甩 DOI + 原页截图 投资人 / 分析师 对比两家 AI 水平 → 翻到对应公司 → 看 L 等级 + 出处档位 媒体 / 自媒体 想转载引用 → 翻到底部 → 看口径与免责说明 公司 PR / 同行 看到与事实不符 → 翻到底部 → 联系作者订正 网页版 vs 公众号版:本篇在浏览器打开是完整版(含 35 张原页截图);复制到公众号时截图无法显示,请按需另存 PNG 或跳网页版。 |
这是「NGS 公司 AI 家底」系列的配套材料。文中每一家公司的 AI 主张,这里都给出原始出处与证据截图——谁在哪说的、说在哪个渠道,一屏看全。
用法:被问到「你凭什么这么说」时,直接翻到对应那家,把链接和截图甩出去。截图可另存为 PNG 插入公众号正文(微信编辑器不接受粘贴 base64 图)。
红框 / 红圈怎么用:每张证据图里,被红色框起来的就是该公司的 AI 相关表述原文——可能是模型名、算法名,也可能是「人工智能」「大模型」「机器学习」这类字样。懒得读整页时,只看红框即可。 |
这一篇只做一件事:把「谁说的」和「说的原文」对上。从上到下只是可核查程度,不是排名——排在前面的不代表技术更强,只代表证据更容易被外人查到。 |
证据索引(系列配套 · 原始出处与截图)
以下为本篇每家公司 AI 主张的原始链接与证据截图,按第 1 篇的「交叉矩阵」与本篇逐家卡片中的定位逐一对应。截图仅在本 HTML / 浏览器版可见;若要发布到微信公众号,请另存为 PNG 再插入正文(微信编辑器不接受 base64 粘贴)。
第 1 篇讲了什么:第 1 篇给了分类与结论——这一批 23 家按 AI 自主度分五级,能点回论文的 7 家。本篇把 23 家逐个拆开,末尾再把所有原始出处、口径与 35 张原页截图一次公开,你可以自己点回去核。 |
出处按渠道分七档(与第 1 篇的「硬 / 中 / 软」是两个口径)
档 1 同行评议论文 · 深度学习 | 5 家|方法为深度学习 / 大模型,有 DOI 可直接点回 |
档 2 同行评议论文 · 传统机器学习 | 2 家|方法是 LASSO / 随机森林 / XGBoost,不是大模型,别混为一谈 |
档 3 预印本 / 会议摘要 | 3 家|已挂预印本但尚未见正式同行评议版本(含赛陆 OCellus) |
档 4 监管审批 | 1 家|这一档最硬:论文证明方法说得通,注册证证明监管看过、允许进医院收费 |
档 5 招股书 / 年报 | 1 家|写在监管文件里,责任最重,也最粗颗粒 |
档 6 官网 / 发布会 | 6 家|公司自己公开讲的,有产品名、有上线时间,但无论文、无注册证 |
档 7 工程件 / 未见 | 5 家|这一档要分开看:有真算法但未称大模型、用别人的模型、有算法却没成模型——三种情况完全不同 |
合计 23 家。档位标的是「这张卡片主推的主张来自哪个渠道」;第 1 篇主表的硬 / 中 / 软标的是「这家公司能点回的最硬那份证据」。两套口径不同,别混。
说明 本系列信息均来自公开渠道:官网、发布会、论文、专利、招股书、监管公示。所有“首个”“第一”类表述均为企业口径;未能核实处已标注“本次检索未见”。自主度分级与披露渠道分类,均仅为公开材料形态描述,不构成对公司技术水平的评价或投资建议。如与事实不符,欢迎提供依据,我会订正。 参考文献 · 全部为公开出处,可自行核对 |
公众号正文的链接不能直接点击,复制整条到浏览器打开即可。未能提供链接的条目,是本次检索未找到稳定可引用的原始页面,故只写出处名称——宁缺勿错。 注:本表「三类证」仅 [15] 迪安·医策为算法类软件注册证(审算法本身,属 AI 证据);[16][17][23][24][25] 为检测试剂盒 / 测序仪产品注册证,只证明产品获批进入临床,其审批页记载产品名称与适用范围、不含 AI 表述,不代表该公司具备 AI 能力。 [1] Genos(杭州华大研究院 × 之江实验室) | GigaScience,2025-10-22 [2] LOGO(华大智造 × 复旦) | Nucleic Acids Research 50(14):e81,2022 [3] Concerto(华大智造) | Nature Machine Intelligence,2022 [4] EvoPlay(华大智造) | Nature Machine Intelligence,2023 [5] PrimeGen(华大智造 × 朱拉隆功大学) | Nature Biomedical Engineering,2025-07-30 [6] Bream(齐碳科技) | Frontiers in Genetics,2026-01-14 [7] 序语 / Fragmentia-AI(世和基因) | Cell Reports Medicine,2026-06-12 [8] emGene(芯像生物 × 南方科技大学) | IEEE Integrated Circuits and Systems,2025-03-18 [9] 杰毅生物 × 北京协和 · 全基因组药敏预测(机器学习) | Int J Antimicrob Agents 2026-04-15(67 卷 7 期, 107807) [10] GenseqAMR · 鲍曼不动杆菌(金匙医学) | J Clin Microbiol,2023 [11] GenseqAMR · 肺炎克雷伯菌(金匙医学) | J Antimicrob Chemother,2024 [12] mNGS 假阳性过滤(金匙医学,阈值规则非 AI) | Clinical Chemistry,2021 [13] GeneT(华大基因) | medRxiv 预印本,2024-07-18 [14] ProtoPilot(华大智造子公司涌生智能 × 上海人工智能实验室) | arXiv 2606.31763,v1 2026-06-30 [15] 迪安 · 医策科技宫颈细胞病理软件三类证 | NMPA 送达信息:批准日期 2025-12-31(公示 2026-01-05) [16] 金匙医学 mNGS 三类证(试剂盒证·产品注册证,与 AI 无关) | 国械注准 20263401810,2026-08-31 [17] 微远基因 mNGS 三类证(试剂盒证·产品注册证,与 AI 无关) | 国械注准 20263401813,2026-08-31 [18] 微远基因官网 · AI 表述 | 公司简介“构建基于基因组学、影像组学与 EMR 的感染性疾病 AI 诊断体系”;“走进微远”页“构建 AI 驱动的感染性疾病诊断体系” [19] 吉因加招股书 | 港交所披露易,2025-12-21 递交(2026-06-21 失效) [20] 金域「域见医言」口径 | 《羊城晚报》梁耀铭专访,2026-02-27 [21] DeepGEM(广医一院 × 腾讯 AI Lab) | Lancet Oncology,2024-12-06 [22] 贝瑞基因 GENOisi 接入模型清单 | 投资者关系活动记录表,2025-02-11 [23] 赛陆 Salus Pro 测序仪三类证(产品注册证,与 AI 无关) | 国械注准 20253220191,2025-01-20 [24] 赛陆 Saluseq Nimbo 测序仪三类证(产品注册证,与 AI 无关) | 国械注准 20253222564,2025-12-12 [25] 圣湘 SansureSeq 1000 测序仪三类证(产品注册证,与 AI 无关) | 国械注准 20253220239 [26] xTrimo V4(百图生科) | 公司官网(口径:全球首个 268B 生命科学基础模型) [27] LucaOne(阿里云飞天实验室) | Nature Machine Intelligence,2025-06-18 [28] EnTao-GPM(复旦 × 百图生科) | arXiv 2507.21706,2025-07-29(预印本) [29] MAIGGT(复旦等) | Advanced Science,2025-08-01 [30] AlphaGenome(DeepMind) | Nature 649: 1206-1218,2026-01-28 [31] AlphaGenome 预印本 | bioRxiv,2025-06-25 [32] Evo 2(Arc Institute × NVIDIA) | Nature,2026-03-04 [33] PrimateAI-3D / Dorado / DeepConsensus | Illumina、Oxford Nanopore、PacBio 各自官网与论文 [34] 圣湘接入 DeepSeek / 康为世纪 AI 用途 | 公司公告与中报披露 [35] 金匙医学官网 · GenseqAMR 产品页 | “GenseqAMR 分子药敏预测,依托于数万例细菌全基因组测序大数据、金匙自研机器学习专利技术” [36] 金匙医学官网 · 企业历程 | “2021.06 GenseqAMR 上线;2022.11 GenseqAMR 3.0 正式上线” [37] 赛陆医疗 · OCellus 虚拟细胞模型 | bioRxiv 预印本,2026-07-12(9B,基于 Qwen3.5-9B 微调;未同行评议、未开源) [38] 贝瑞基因 · Berrylyzer 产前变异优先排序系统 | medRxiv 预印本,2026-04(作者单位含 Berry Genomics Corporation) [39] 金域医学 · ISO/IEC 42001 人工智能管理体系认证(公司口径:行业首张) | 公司官网 |
说明
① 本索引只做「谁在什么渠道说了什么」的事实归集,不评价各家技术水平高低,也不构成任何投资建议。
② 文中所有「首个」「第一」均为企业自身口径,本索引照录,未作背书。
③ 渠道分类仅代表信息的可核查程度,不代表能力排序。同一家可能同时出现在多个渠道,此处只取其最强证据所在档。
④ 部分截图取自公开网页,版权归原作者所有;如需引用请以原文链接为准。
⑤ 截图中的红框 / 红圈为本索引自行添加,仅用于标出 AI 相关原文的位置,未对原页面内容作任何改动。
怎么用这篇索引(FAQ) Q1 · 我是销售,客户说「我们也有 AI」怎么反驳? 定位客户对应公司的 L 等级(第 2 篇主表)→ 翻到本篇对应出处 → 看「档」:档 1/2 同行评议 > 档 4 监管 > 档 5/6 公司口径。若对方只给通稿,告诉他「这是档 6,要档 1/2 才算硬」,把 DOI 或 NMPA 链接甩过去。 Q2 · 我是投资人,想对比两家 AI 水平 先比 L 等级,再比「档」——L1 至少要有档 1 出处,L2 至少档 1/2。看开源(Genos 开源=有底气)、看 AI 证(仅档 4 第 1 条算算法监管认定)。L3 等级「产品在跑但 AI 不明」,是尽调最该盯的一层。 Q3 · 我是媒体,想转载引用 注明「基因小学生公众号 · 39 条出处全公开版」;DOI 与 URL 直接复制、不要改动;注明检索截止 2026-09-29;保留免责声明——这是合规性的核心。 Q4 · 我是公司 PR,想订正 找到对应 L 等级与条目 → 提供原始 DOI / 注册证号 / 官网链接 → 公众号对话框回「订正」→ 作者核实后会在本篇更新并标注更新日期。 |
本篇信息均来自公开渠道:官网、发布会、论文、专利、招股书、监管公示。所有“首个”“第一”类表述均为企业口径;未能核实处已标注“本次检索未见”。 自主度分级与披露渠道分类,均仅为公开材料形态描述,不构成对公司技术水平的评价或投资建议。 如与事实不符,欢迎提供依据,我会订正。完整口径与检索方法见本篇 Part D。 |
这是「NGS 公司 AI 家底」系列的第 2 篇(共 2 篇)。 全系列: ① 很多 NGS 企业都开始讲 AI,大家对 AI 的使用程度天差地别 ② 每一家逐个拆开看:39 份原始出处与 35 张原页截图全公开 |