ARTICLE · 1159894
BOM顶层成品怎么找,AI写了5种公式,最短78个字符
BOM顶层成品怎么找,AI写了5种公式,最短78个字符
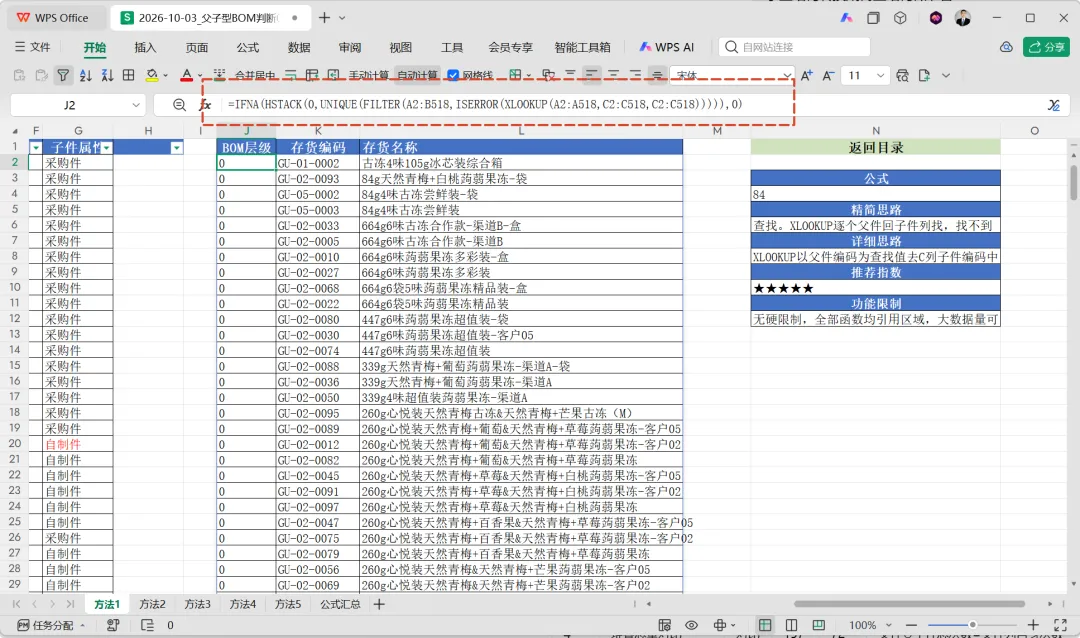
做生产计划的人,谁都绕不开BOM。 领导丢来一张517行的父子型物料清单:107个产品、181种子件,父子和子件混在一张表里。现在要从里面挑出92个"纯成品"——只当父件、从不被别人拿去当子件用的顶层物料。这些顶层货是排产的第一环,挑不出来,后面的层级展开全是空中楼阁。眼睛从第1行盯到第517行,盯到怀疑人生。 我让AI来干这个活。它先照着我的口播思路写了一种,又自己续了4种,5种公式算出来的92个结果全部对上,最短的只有78个字符。 这张表是父子型结构:每一行是一对父子关系,A列父件编码、C列子件编码。同一个成品会拆成好多行,一个子件又可能是另一个成品的父件,层层套娃。 所谓0层(顶层)成品,判断规则一句话: 反过来讲,昨天判断自制件、采购件的逻辑是"子件出现在父件列→自制",今天完全反过来:拿父件编码去子件列找,找不到的才是顶层。两套公式是同一个思路的镜像,学会了能互相借用。 这个场景放哪个行业都成立:食品厂的礼盒套件、机加工厂的部件总成、电子厂的成品机,只要BOM是父子型长表,顶层判断都是第一步。 这是我自己在视频里的原始思路:拿每个父件编码去子件列找一遍,找得到,说明它被别的成品当子件引用了,不是顶层;找不到(报错),说明它只出现在父件列,就是0层。 公式:筛出0层成品清单 =IFNA(HSTACK(0,UNIQUE(FILTER(A2:B518,ISERROR(XLOOKUP(A2:A518,C2:C518,C2:C518))))),0) XLOOKUP(A2:A518,C2:C518,C2:C518) :以107个父件编码为查找值,去C列子件编码里找,找到返回编码,找不到返回#N/A ISERROR :把"找不到"转成TRUE——错误了才是真顶层 FILTER(A2:B518,……) :按条件筛出A、B两列(编码+名称一起带走,一步到位) UNIQUE :去重。一个成品拆多行,一对多必须去 HSTACK(0,……) :最左边拼一列0,BOM层级直接标好 IFNA :万一没有0层(极端情况),返回0兜底,不让整片报错 92个0层成品一次溢出,编码、名称、层级三列齐全。 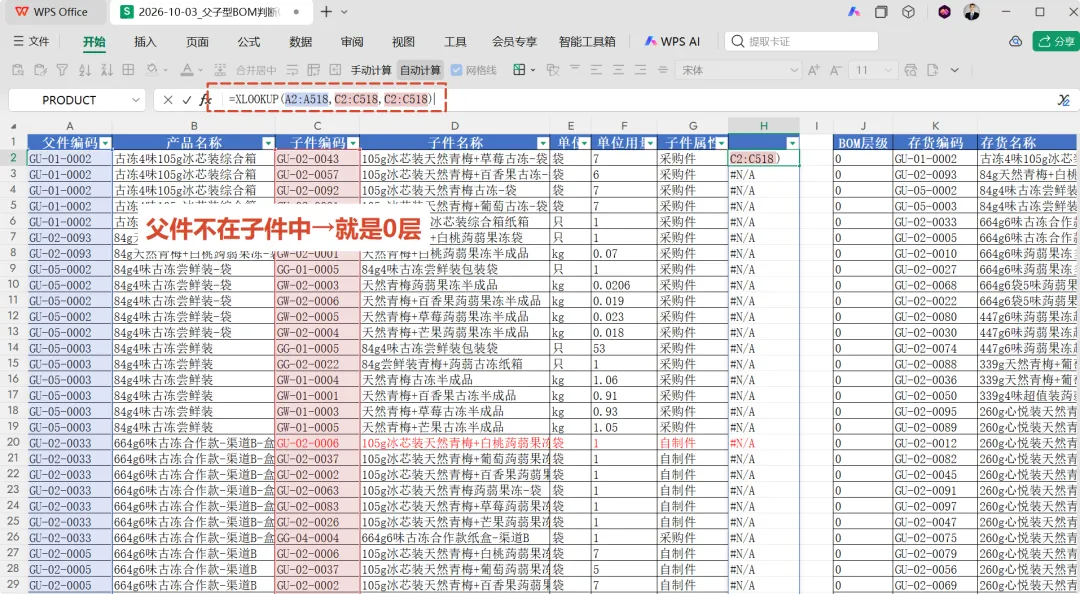
AI自己续的第一种,思路更直接:别一个个找了,直接数数——每个父件在子件列出现的次数是0,就说明从来没人引用它,它就是顶层。 公式:计数判断0层 =LET(a,A2:A518,IFNA(HSTACK(0,UNIQUE(FILTER(A2:B518,COUNTIF(C2:C518,a)=0))),0)) COUNTIF(C2:C518,a) :逐个父件在子件列计数,0次=从未被引用 FILTER(A2:B518,……) :筛出计数为0的行,A2:B两列连名称一起筛 UNIQUE+HSTACK(0,……) :去重、补层级,收尾逻辑和方法1一样 比方法1短6个字符,速度评估98分排第一。条件区里a单独拎成一个变量,专门喂给COUNTIF——这个细节踩过坑,后面避坑清单细说。 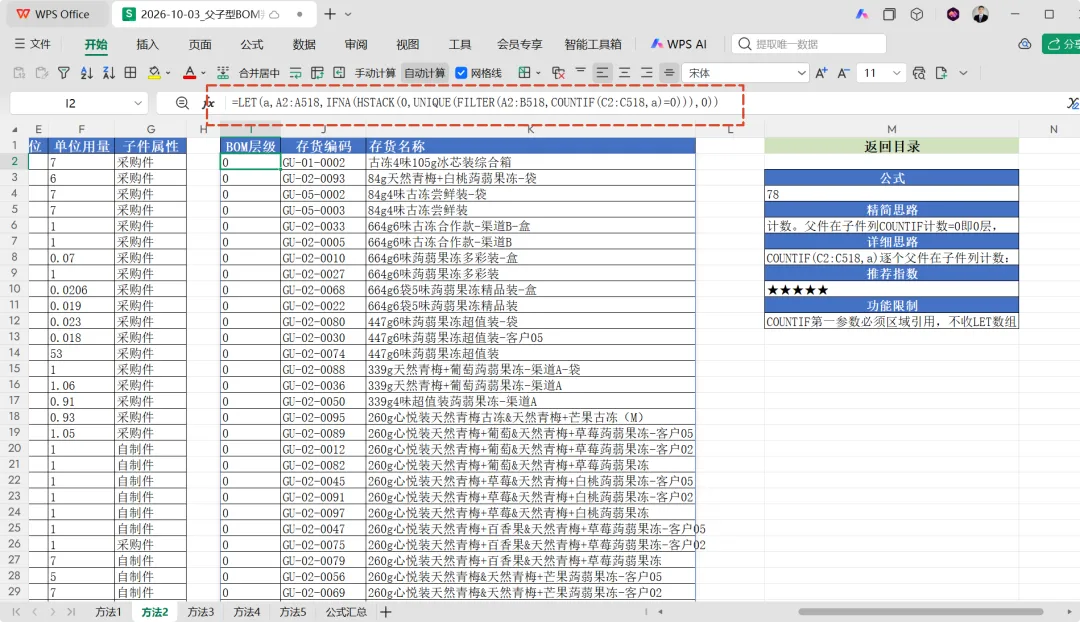
前面两种都是"一次算完"的数组思维,这一种换了个打法:让AI像人一样,一个一个检查、合格的往清单上追加一行。 公式:REDUCE逐个判断压栈 =LET(a,A2:A518,c,C2:C518,IFERROR(DROP(REDUCE("",UNIQUE(a),LAMBDA(q,x,IF(ISNUMBER(XMATCH(x,c)),q,VSTACK(q,HSTACK(0,x,XLOOKUP(x,a,B2:B518)))))),1),0)) UNIQUE(a) :先把107个父件去重,得到待检查名单 REDUCE("",……,LAMBDA(q,x,……)) :从空值开始,逐个父件迭代 ISNUMBER(XMATCH(x,c)) :在子件列找得到→跳过;找不到→进入压栈 VSTACK(q,HSTACK(0,x,XLOOKUP(x,a,B2:B518))) :把层级0、编码、名称拼成一行,追加到已有清单底下 DROP(……,1) :掐掉最开头的空初始化行 它的价值不在快,而在"逐行追加"的骨架:以后要在判断之外再加条件、加备注,改LAMBDA内部就行,不用重排整个公式结构。 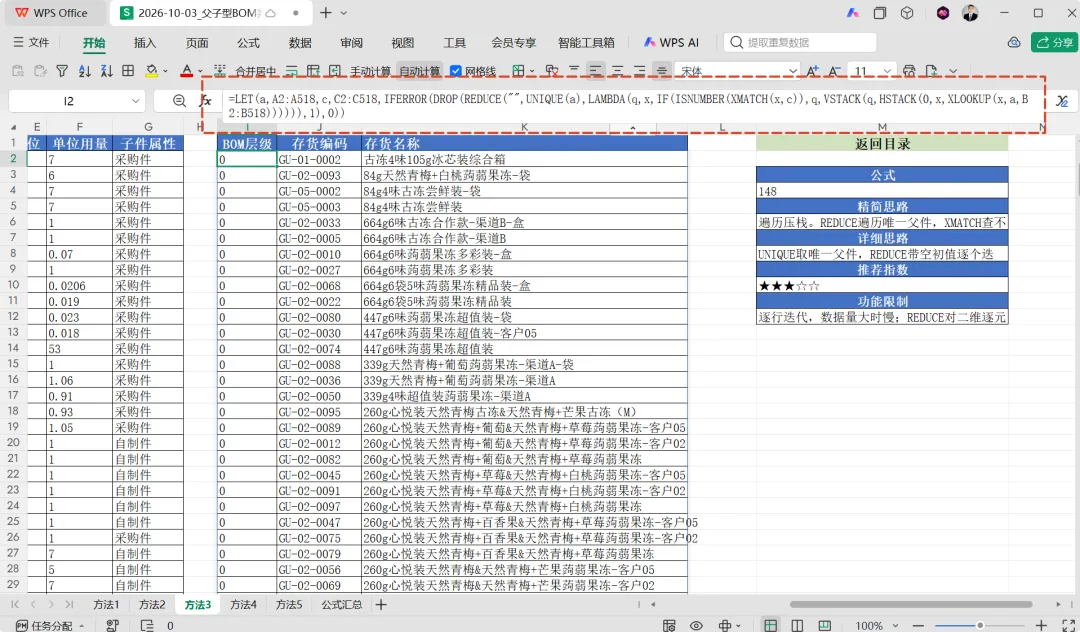
这是个反向思路:把父件列和子件列摞成一个大堆,数每个编码在总堆里出现的总次数。总次数等于它在父件列自己出现的次数,说明多出来的次数是0——没人把它当子件,0层。 公式:总次数对账 =LET(a,A2:A518,s,VSTACK(a,C2:C518),u,UNIQUE(a),f,FILTER(u,MAP(u,LAMBDA(x,SUMPRODUCT(--(s=x))=SUMPRODUCT(--(a=x))))),IFNA(HSTACK(0,f,XLOOKUP(f,a,B2:B518)),0)) VSTACK(a,C2:C518) :父件列+子件列摞成总序列s SUMPRODUCT(--(s=x)) :该编码在总堆里的出现次数 SUMPRODUCT(--(a=x)) :它在父件列自己的次数 两者相等 :子件列贡献0次→0层,FILTER筛出这批 这个思路昨天判断自制件时用过,今天方向反转。它的好处是纯计数、不依赖查找函数;代价是SUMPRODUCT逐个对全表扫描,行数上万就慢了。 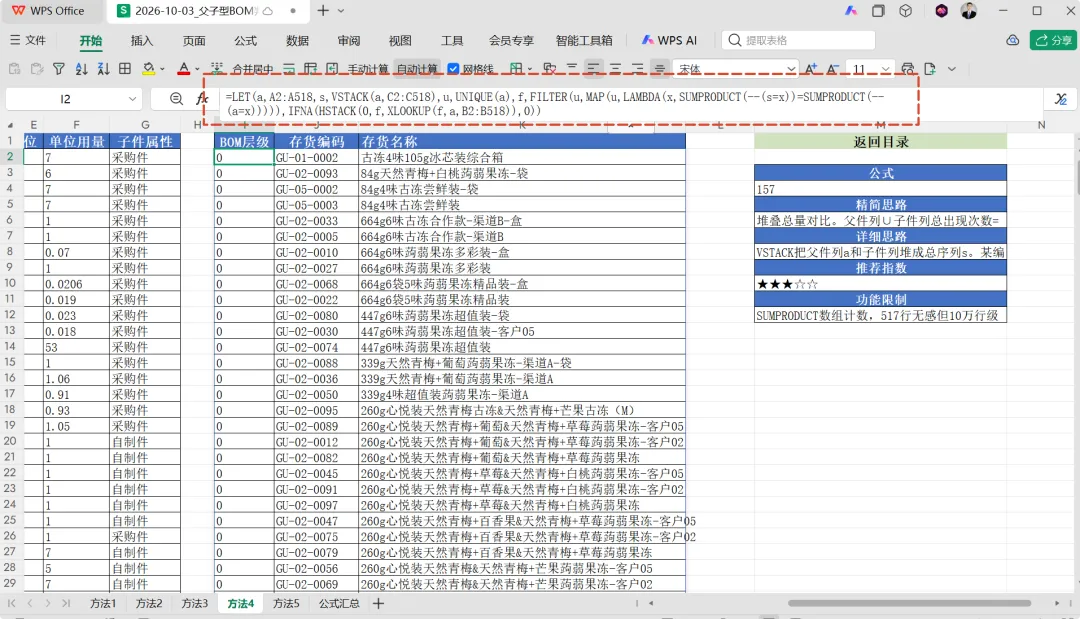
最野的一种:把整个子件列合并成一根长字符串,拿父件编码去里面搜。 公式:长字符串搜码 =LET(c,","&TEXTJOIN(",",,C2:C518)&",",IFNA(HSTACK(0,UNIQUE(FILTER(A2:B518,ISERROR(SEARCH(","&A2:A518&",",c))))),0)) TEXTJOIN(",",,C2:C518) :181个子件编码合并成"GU-01-0002,GW-01-0001,……"的长串 前后补逗号 :父件编码也包上逗号再搜,",GU-01-0002,"带定界去匹配,防止GU-01-0002误命中GU-01-00022 ISERROR(SEARCH(……)) :搜不到=0层 写起来最短的想法之一,但天花板明显:TEXTJOIN的结果超过32767个字符就报错,按8位编码算,约1800行就触顶。小表玩玩可以,生产环境的BOM别托付给它。 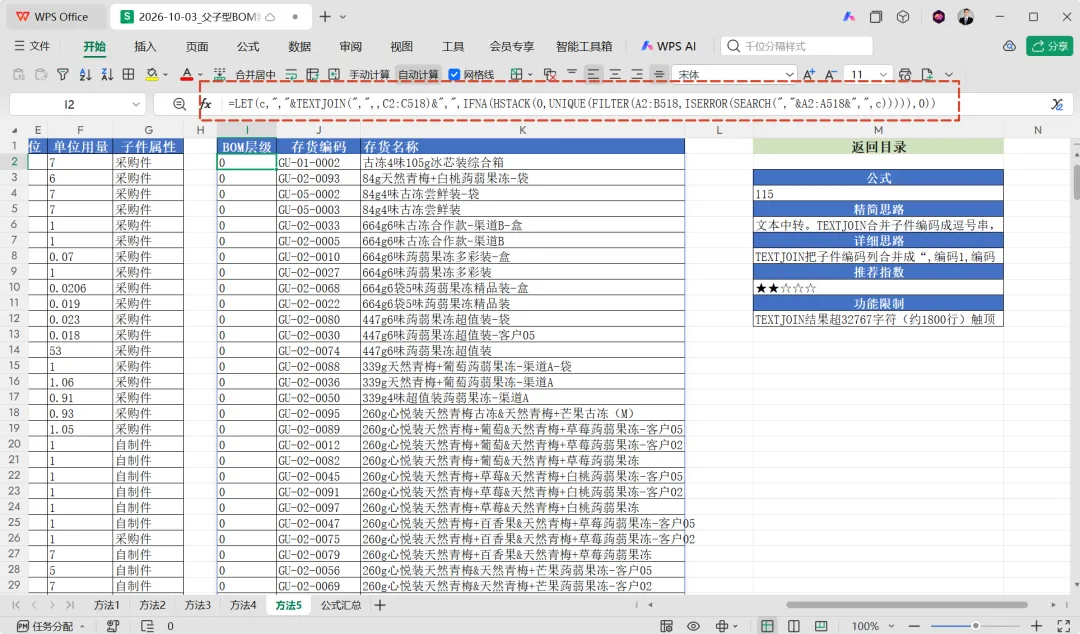
5种方法92个结果全部一致(Python交叉验证过)。短的未必适合你:要一步带出名称,方法1、2最省心;要留一个能继续加条件的骨架,方法3;纯数组思维强迫症,方法4;方法5看看就好。 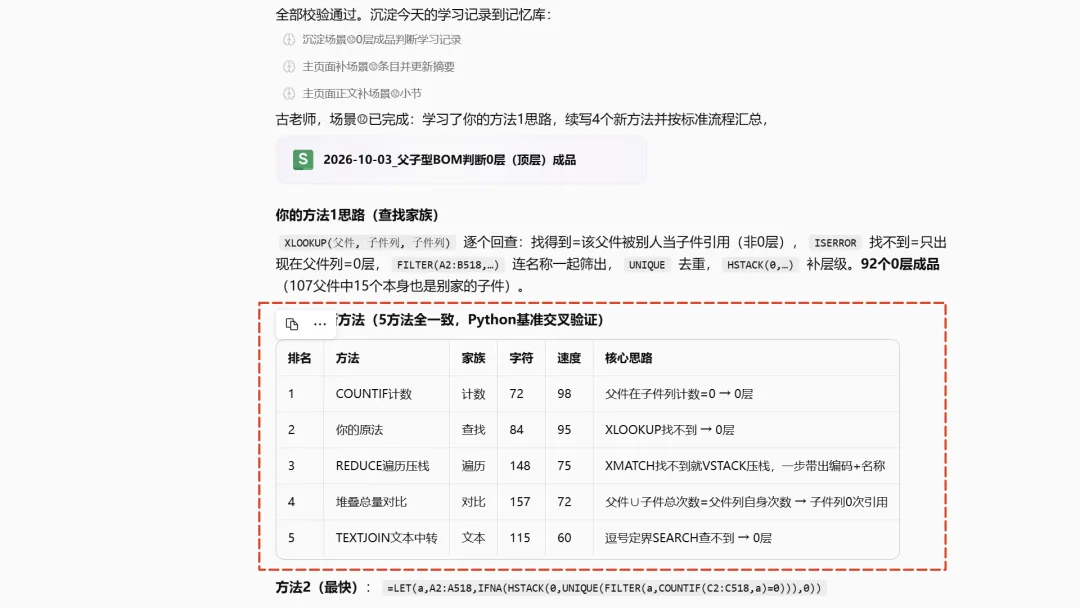
FILTER的数据区必须带上名称列(A2:B518),只筛编码列,名称就丢了——今天实测撞上的第一个BUG COUNTIF第一参数只认区域引用,喂LET数组直接#VALUE!,数组计数改用SUMPRODUCT(--(s=x)) 编码前后有空格,查找、计数全部失灵 ,录入端先规范 TEXTJOIN长串搜码,编码自带逗号会把定界符搞乱,先查编码规范 修改溢出公式前,先清空旧溢出区再写,否则新公式被旧结果挡住 父子型转树型,第一步就是这份0层清单 ,根节点定准了,后面的层级展开才不歪 以前挑顶层成品,靠筛选、靠肉眼、靠"老师傅的感觉",一个500行的BOM核半天,还不敢保证全。现在一句78个字符的公式,92个顶层成品一键溢出,还附带名称和层级。 这是「AI写表格公式」项目第13天:每天一个PMC高频场景,AI写多解法,我验收、实测、沉淀,最后封装成可复用的公式方法库。昨天判断自制件,今天判断0层,明天把根节点铺进树型结构——父子型转树型的完整链路正在一点点打通。 想要完整公式清单的,评论区扣「公式」。
文章里出现的技术名词,一句话说清楚: 0层(顶层)成品:BOM里只当"父件"、从不被别人当子件用的物料,就是最终出货的成品。 父子型结构:BOM的一种存法,每行记一对父子关系,同一个产品拆成多行,层层套娃。 动态数组公式:写一个公式,结果自动往下、往右溢出一片区域,不用拖填充。 XLOOKUP:查找函数,拿一个值去另一列里找,找到了返回对应结果,找不到报#N/A。 FILTER:筛选函数,按条件把表格里满足条件的行整行抽出来。 UNIQUE:去重函数,把重复的值压成一个。 HSTACK:横向拼接函数,把几列并排拼成一张宽表。 COUNTIF:条件计数函数,统计某个值在一片区域里出现了几次。 REDUCE:循环累加函数,把一组值逐个代入计算,像流水线一样逐件加工。 TEXTJOIN:合并文本函数,把一列文字用分隔符串成一根长字符串。
#AI写表格公式#动态数组#PMC#BOM#WPS表格 本文由 AI 辅助创作 工具:灵犀专业版 模型:GLM-5.3-Flash 超高
一、先说清楚:什么叫0层
父件不在子件列出现过,它就是0层。
二、方法1:查找家族(古老师原法,84字符)
无硬限制,
全部函数均引用区域,大数据量可用
;
编码需严格一致
,编码前后的空格会让查找失灵。
三、方法2:计数家族(78字符,最快)
COUNTIF的第一参数必须是区域引用
,喂不进LET定义的数组;这里C2:C518是区域,恰好合法。
四、方法3:遍历压栈家族(148字符)
逐行迭代,数据量大了偏慢,500行以内无感,
几万行建议回到方法1、2
。
五、方法4:堆叠总量对比家族(157字符)
计数全用SUMPRODUCT替代COUNTIF,原因是COUNTIF不收LET数组——
同一个坑在两个方法里都撞上了
。
六、方法5:文本中转家族(115字符)
仅小表可用
;
编码本身含逗号的
(比如编码里带规格),定界符会失效,慎用。
七、5种方法怎么选
排名 | 方法 | 家族 | 字符 | 速度分 | 核心思路 |
1 | COUNTIF计数 | 计数 | 78 | 98 | 父件在子件列计数=0→0层 |
2 | XLOOKUP查找 | 查找 | 84 | 95 | 查不到→0层 |
3 | REDUCE压栈 | 遍历 | 148 | 75 | 查不到逐行追加 |
4 | 堆叠总量对比 | 对比 | 157 | 72 | 总次数=父件列次数→0层 |
5 | TEXTJOIN中转 | 文本 | 115 | 60 | 长字符串搜不到→0层 |
0层判断首选COUNTIF=0
;一步带名称用FILTER两列版;过程式拼接用REDUCE压栈。