ARTICLE · 1164538
用 Dify 搭一个能读本地文档的问答机器人:Chatflow 五节点全拆解!
── ✦ AI&具身智能观察 ✦ ──
Dify(Defy)是一个可以本地部署的开源 LLM 应用开发平台。它的 Chatflow 模式把大模型、知识检索、记忆等能力拖成节点连线,不用写一行代码就能搭出一个带上下文的问答机器人。这篇笔记跟着视频走一遍:从一个空白 Chatflow 开始,搭出一个能读本地产品文档、带引用片段回答用户问题的知识库问答工作流。
一、整体链路:五个节点串起一次问答
一个最小可用的知识库问答工作流,节点顺序是固定的:
开始节点(接收用户问题)→ LLM 提取关键字(把口语化问题压缩成检索词)→ 知识检索节点(拿关键字去向量库里召回相关片段)→ LLM 回答问题(把召回片段拼进提示词,让大模型基于资料作答)→ 直接回复节点(把答案返回给前端)。
为什么中间要加一个"提取关键字"的 LLM?因为用户问的是"这个产品能不能远程控制灯光?",直接拿去向量库里搜,长句里的冗余词会干扰召回质量。先让一个小模型把问题压成"智能家居 远程控制 灯光"这种关键词串,检索会准得多。
二、开始节点:Dify 自动注入的八个系统变量
新建 Chatflow 时,画布上自动带一个"开始"节点和一个"直接回复"节点。点开开始节点右侧的"输入字段",能看到 Dify 已经预定义了一组系统变量:
sys.query(用户本次输入的问题)、sys.files(用户上传的文件)、sys.dialogue_count(对话轮次计数)、sys.conversation_id(对话 ID)、sys.user_id(用户 ID)、sys.app_id(应用 ID)、sys.workflow_id、sys.workflow_run_id。
实际做知识库问答时,真正要用到的只有 sys.query——也就是用户这一轮问了什么。其余变量是给做多轮对话、用户身份识别、运行日志排查时备用的,不用提前删,留着不碍事。
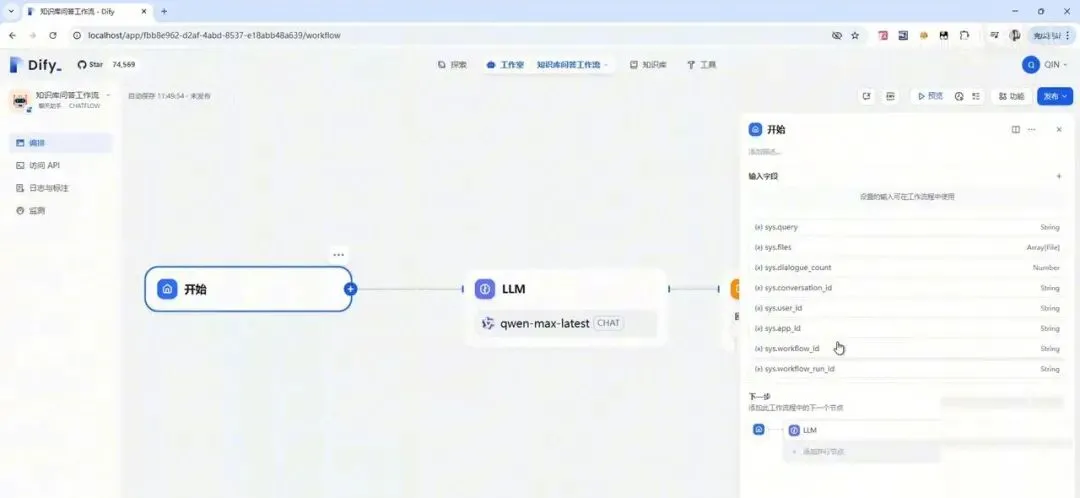
开始节点自动注入的八个系统变量
三、第一个 LLM:把用户问题压成检索关键字
从开始节点拉一条线出来,接一个 LLM 节点,命名为"提取关键内容"。这个节点的任务不是回答用户,而是把用户问题改写成适合向量检索的关键词串。
系统提示词分两段写:
## 任务:请你将用户给定的问题进行提取关键内容,用于进行检索知识库内容。## 输出:输出多个关键字或者关键句,关键字或者关键句之间使用空格隔开,无需其他多余的文本。
USER 消息里直接引用 开始 / sys.query。关键是必须在提示词里写明"无需其他多余文本"——大模型默认喜欢写"根据您的问题,我提取的关键字如下:……",这串废话如果直接喂给检索节点,会严重干扰召回。
这个节点的"记忆"开关建议打开。因为多轮对话里用户可能说"那它的价格呢?",不带上文它不知道"它"指什么。打开记忆后,Dify 会自动按 系统提示词 → 历史对话 → 本轮用户问题 的顺序拼成一个提示词列表喂给大模型。
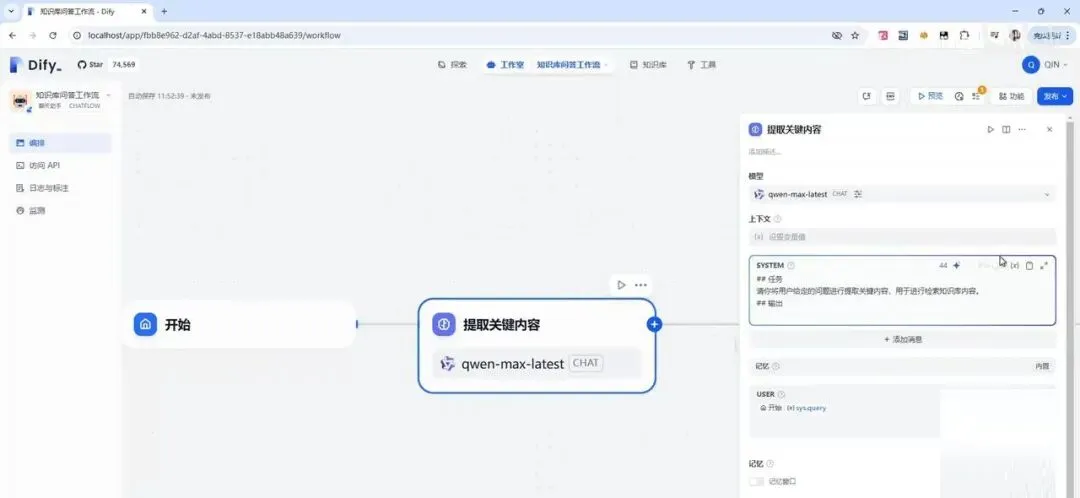
提取关键字 LLM 的提示词与记忆开关
四、知识检索节点:关键字从哪儿来、召回什么回去
在"提取关键内容"后面接一个"知识检索"节点。这个节点要配两件事:
第一,查询变量选什么。点开"查询变量"下拉,不要选 sys.query,要选上一步 LLM 输出的 text String(也就是"提取关键内容"节点产出的那段关键字)。这样向量库收到的是干净的检索词,而不是用户的原始口语问题。
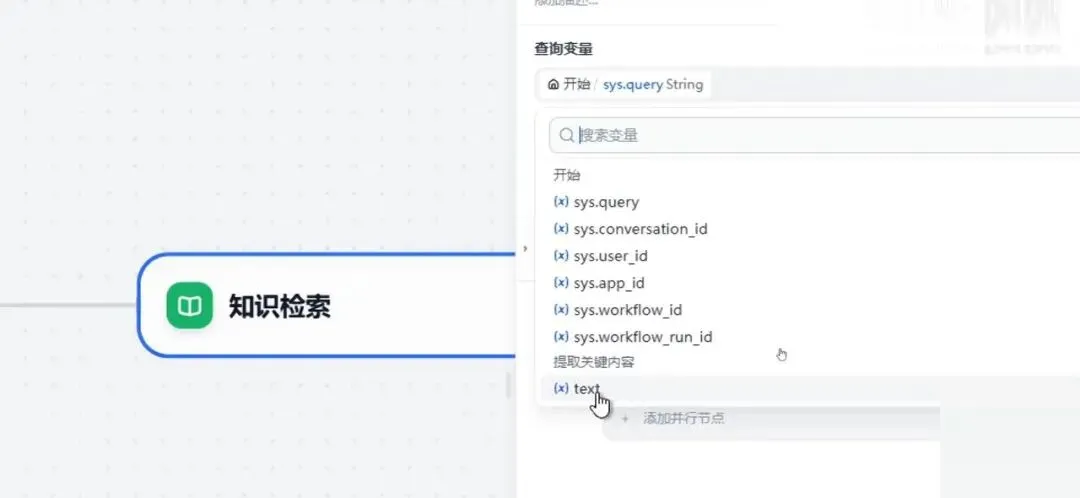
查询变量选上一步 LLM 的 text 输出
第二,绑定知识库。在"知识库"一栏把提前上传好的产品文档选进来。视频里用的是一份《产品文档:智能家居控制系统.pdf》。配好后,节点右侧的"输出变量"会列出这个节点往下游传什么:result(召回片段数组)、content、title、metadata。
节点底部还有"失败时重试"和"异常处理"。异常处理选"无"会让整个工作流直接中断;选"默认值"会在报错时吐一个占位结果;选"异常分支"可以另接一个"直接回复"节点,给用户一句友好的兜底提示。
五、第二个 LLM:带着检索片段回答问题
知识检索后面再接一个 LLM 节点,命名为"回答问题"。这个节点是 RAG 真正生效的地方——必须把上一步检索到的片段接进"上下文",选知识检索输出的 result(Array[Object])。不接上下文,这个节点就退化成一个普通聊天机器人,根本不知道你公司文档里写了什么。
系统提示词按角色、背景、任务三段写:
## 角色:你是一个专业的客服,擅长根据知识库内容进行回答用户的问题。## 背景:严格根据知识库内容回答用户问题,对于用户理解私有文档十分重要。## 任务:严格根据知识库的内容进行回答。## 知识库:{{#上下文#}}
最后那行 {{#上下文#}} 是关键——输入 / 或 Shift+花括号可以调出变量选择器,把"上下文"插进来。运行时 Dify 会自动把检索到的片段原文填到这个位置。
这个节点也要开记忆。但有一个坑:开了记忆之后,USER 消息里必须显式引用 sys.query,否则 Dify 会直接报错"user message 中必须包含用户的 query"——它需要知道本轮用户问了什么,才能把历史对话和当前问题拼起来。记忆窗口设成多少条,决定了模型能往前看多少轮历史。
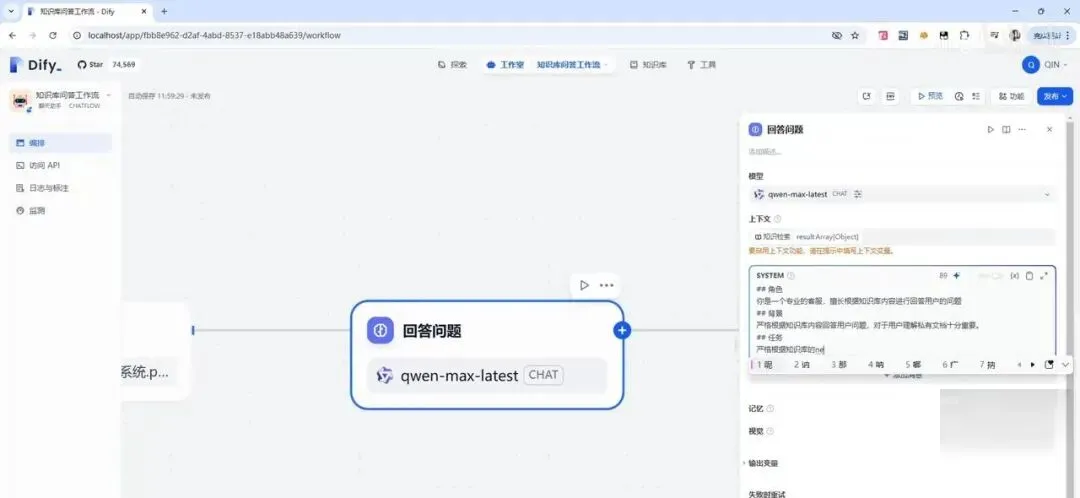
回答问题 LLM:上下文选知识检索 result,提示词三段式
六、试运行:逐节点看输入输出日志
所有节点连好后点右上角"发布",再点"预览",输入"产品的概述是什么?"就能跑起来。每个节点执行完会变绿,点节点能看到它这一步吃了什么、吐了什么。
最值得看的是知识检索节点的输出。它是一个 JSON 数组,每一项里有 content(召回的文档原文片段)、title(来源文档名)、metadata(数据集 ID、文档名等),以及一个 score 相似度分数。片段是按分数从高到低排的,视频里能看到 0.49、0.28 这样的分数依次往下。
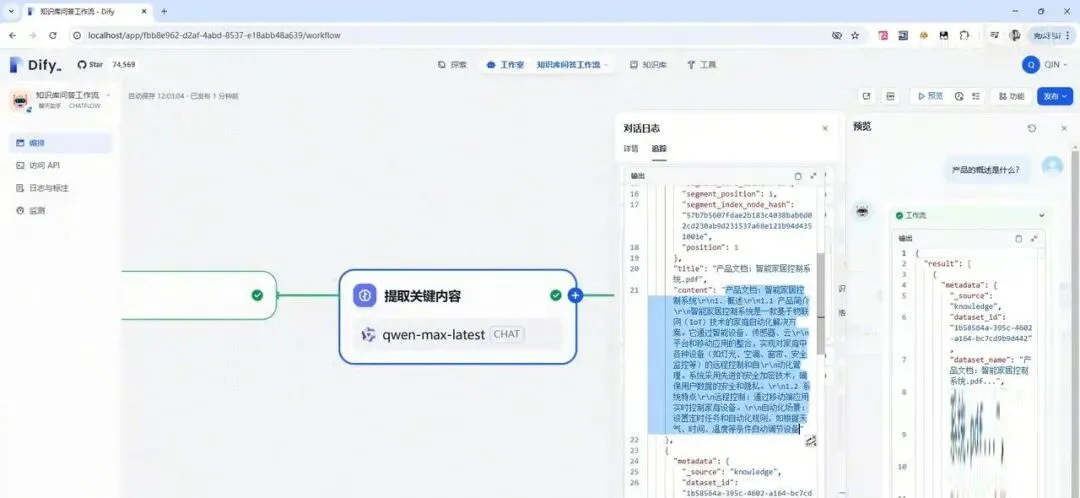
知识检索输出:content、title、metadata、score 全部可见
七、召回质量调优:Score 阈值、Top K、Rerank
默认召回可能会把一些不太相关的片段也拉进来(比如那个 0.28 分的)。回到知识检索节点,点开"召回设置",有三个开关很实用:
Score 阈值:开了之后,相似度低于阈值的片段直接丢弃。视频里设的是 0.3——重跑一次后,原来那个 0.28 分的片段就消失了。Top K:只取和用户问题最相似的前 N 个片段。设 4,就是不管召回多少个,最后只喂给大模型分数最高的 4 段。Rerank 模型:选一个 gte-rerank 重排模型。它会拿原始关键字和召回片段再做一次交叉编码,重新算一遍相似度排序,比单纯靠向量距离更准。
Rerank 的权重是两路混合:一路是向量语义距离(意思相近程度),一路是 BM25 关键词匹配(字面重合程度)。两路一起算,比单路召回更稳。
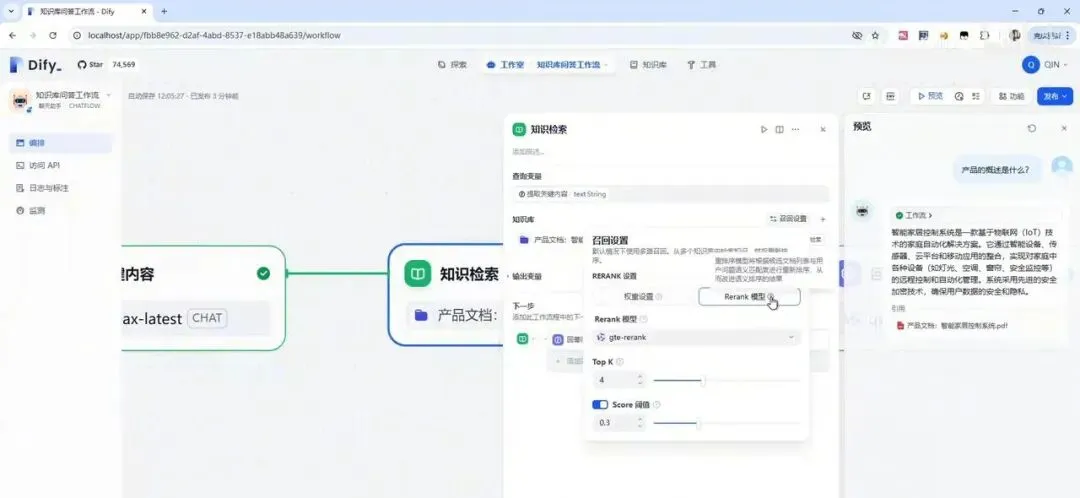
Rerank 设置:gte-rerank 模型 + Top K=4 + Score 阈值 0.3
八、一个容易忽略的细节:温度调低
每次重跑,"提取关键内容"节点生成的关键字都不一样——这次召回 2 个片段,下次可能召回 5 个,回答效果忽好忽坏。原因是大模型有温度参数,温度越高输出越随机。
把提取关键字那个 LLM 节点的温度调低,同样的问题它每次输出的关键字就基本一致了,召回结果也就稳定下来。这是做生产级知识库问答时一个很实用的小优化——负责"提取"的小模型要低温度,负责"生成回答"的大模型反而可以保留一点温度让表达更自然。
全部调完后点"更新发布",跳到运行界面,再问一次"产品概述",就能看到完整的节点耗时:开始节点 12.8s、提取关键字 88 tokens 4.06s、知识检索 312ms、回答问题 651 tokens 2.28s。右侧回答区下方会带一个"引用"角标,点开能看到这次回答到底用了文档里哪一段——这就是 RAG 相比直接问大模型最实在的价值:每个答案都能溯源到原始文档片段。
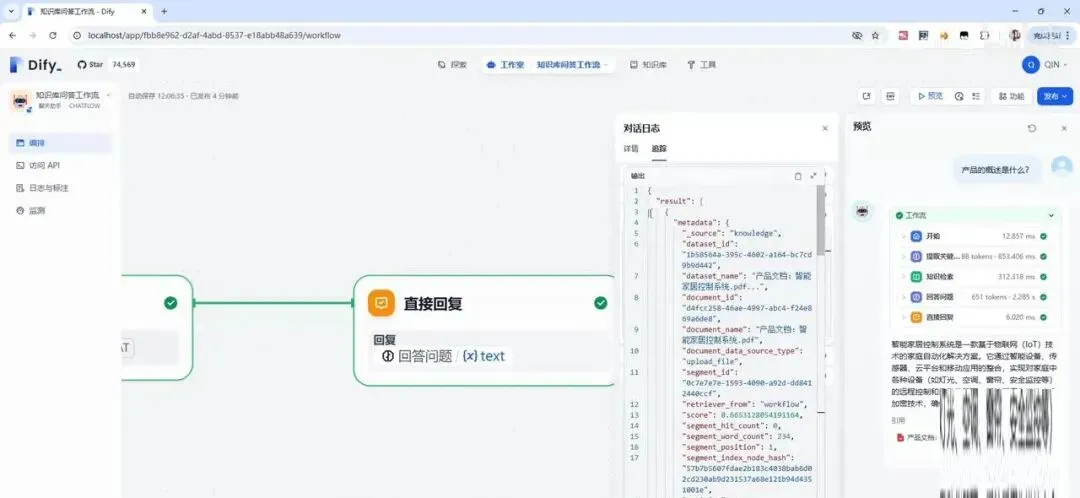
发布后运行:各节点耗时与引用片段一目了然