ARTICLE · 1165990
榜单里的 AI-Researcher,可能不是你以为的那个工具
我一看就明白她为什么这么想。那份榜单里,第 9 名写着:AI-Researcher,5,700 Stars,定位“文献研究、实验与报告生成”;正文还专门说它“相对轻量”,核心流程是“主题 → 子问题 → 分别研究 → 汇总报告”,适合做文献综述的第一轮整理。
问题出在一个容易被忽略的地方:这份榜单从头到尾,没有给出任何一个仓库链接。
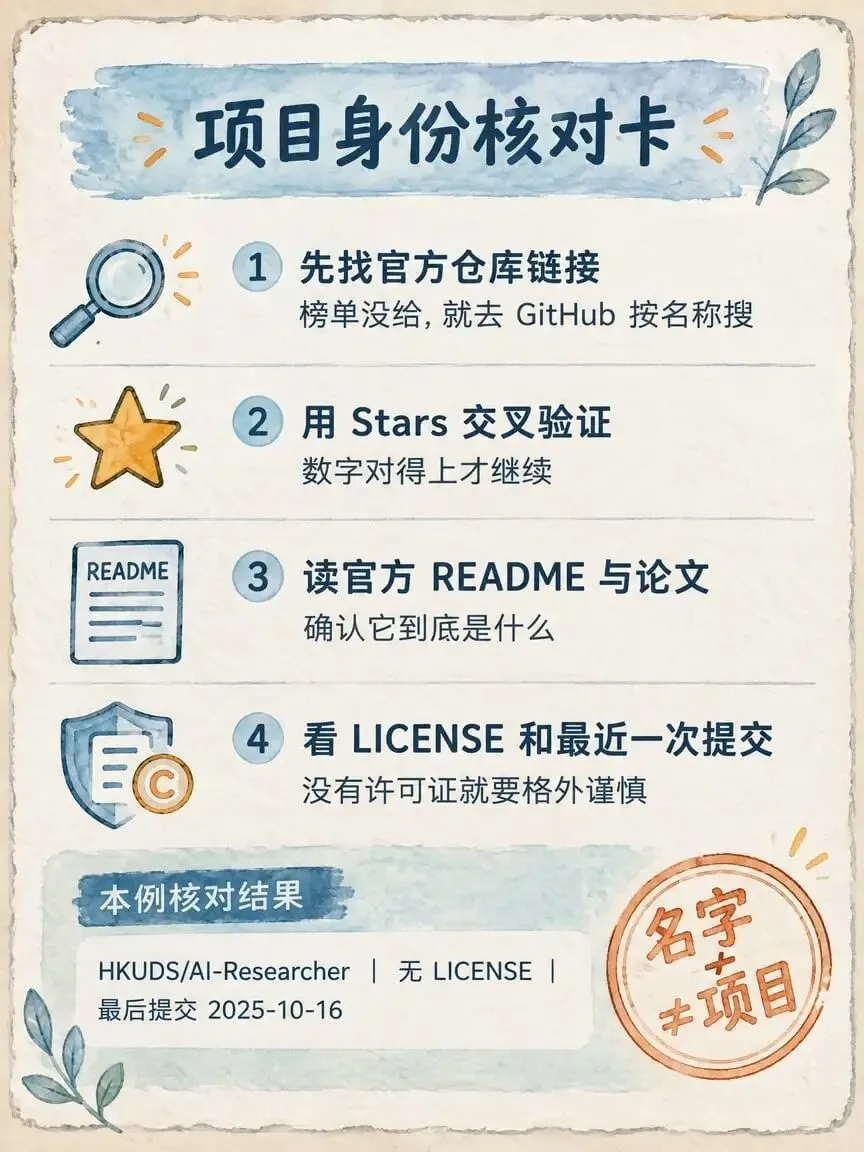
所以这一篇,我先不急着讲“它能做什么”,而是先带你做一件更基本功、也更容易被跳过的事——在把一个名字当成一个项目之前,先核对它的身份。
第一件事:用“名称 + Stars”把它锁定
榜单只留下两个可验证的锚点:名字(AI-Researcher)和星数(5,700)。把这两个放进 GitHub 一对照,答案其实很干净——名字叫 AI-Researcher、星数在 5,700 上下的仓库,只有一个:HKUDS/AI-Researcher。其余同名仓库,最高的也就 900 多星,对不上。
那它是榜单正文里那个“轻量文献工具”吗?恰恰相反。
它不是一个“文献 Notebook”,而是一套自主科研系统
HKUDS 是香港大学数据智能实验室(黄超团队)。这个项目的官方论文叫《AI-Researcher: Autonomous Scientific Innovation》(arXiv:2505.18705),已被 NeurIPS 2025 接收为 Spotlight 论文;仓库自述的目标,是“完全自动化的科研生命周期”,并另外提供了一个在线生产版(novix.science/chat)。
换句话说,榜单里那个“轻量、适合文献第一步”的印象,和它的真实体量并不相符。它想做的不是“帮你读文献”,而是从文献一路做到论文。
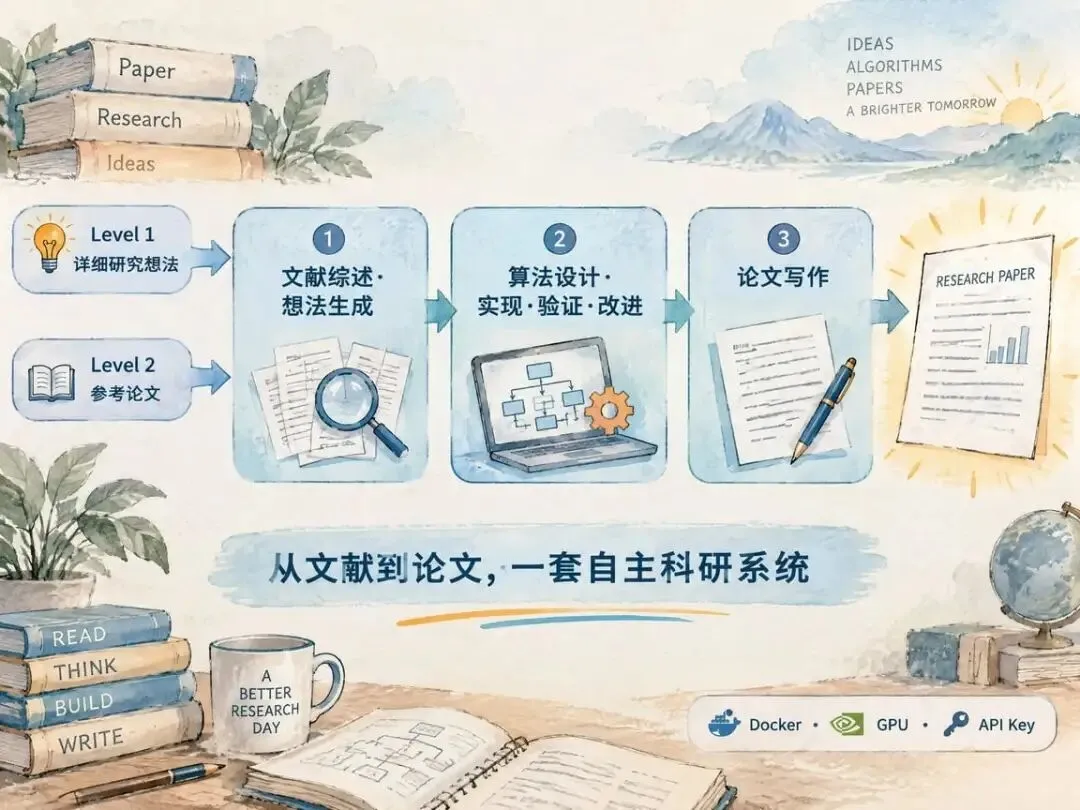
它的主流程:三个阶段、两种入口
入口有两种:Level 1 是你给出详细的研究想法,它照着实现;Level 2 是你只丢几篇参考论文,让它自己想出一个新想法并实现。听起来很省心——但真正的门槛,藏在下一步。
它是真的会“动手”:Docker、GPU、API 一个不少
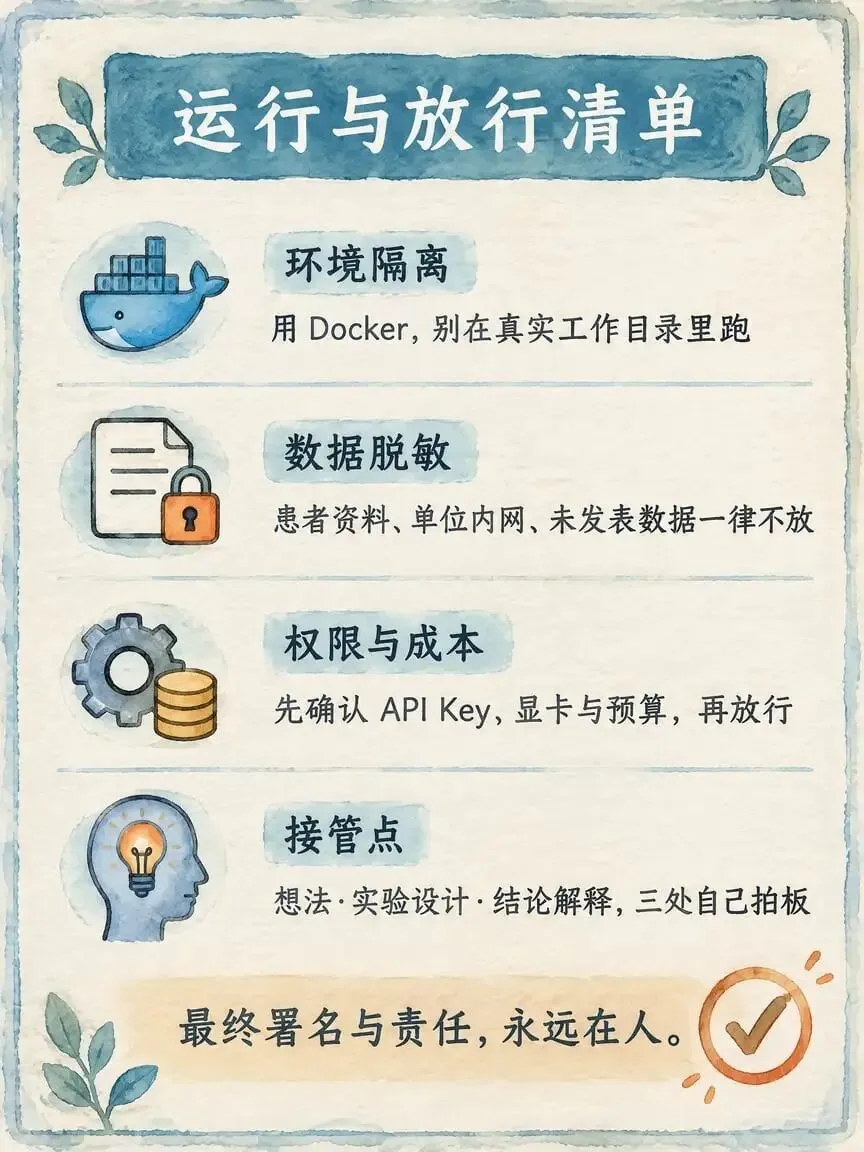
这是这篇最需要你警觉的地方。它不是“在聊天框里写字”,而是在容器里真实地装依赖、写代码、跑实验。官方用 Docker 提供交互式运行环境(基础镜像 tjbtech1/airesearcher);环境变量模板里必须填 OpenRouter API Key、GitHub AI Token,模型通过 LiteLLM 指定,还要指定 GPU(例如 device=0),运行平台为 linux/amd64。
翻译成大白话:想跑它,你得有模型 API、有显卡、会配容器。它的产物里,有实验代码、有指标、有图表,还有一份完整论文稿——这些都是会落到你磁盘上的真实文件。 对它,要按“跑一条流水线”来准备隔离环境,而不是按“开一个网页”来用。
那几个漂亮说法,该怎么读
论文里写得很漂亮:fully autonomous(完全自主)、“minimal human intervention”、生成的论文“approach human-level quality”(接近人类水平)。这些都要加限定:
顺便交代我自己的边界:我没有在本机真实跑过它,所以这篇里不会出现“亲测”。 下面所有结论,都来自官方仓库、论文和文件本身。
两个最容易被忽略的硬边界
第一,它没有开源许可证。 仓库根目录里没有 LICENSE 文件(GitHub 接口里 license 字段为空;2025 年 9 月还有用户在 issue 里专门问 “license?”)。“开源仓库”不等于“有授权许可证”——没有明确许可证时,默认是保留所有权利,商用、二次开发、再分发都要格外谨慎。
第二,热度高,但代码已经停更近一年。 它最后一次代码提交是 2025-10-16,到 2026-09-30 已近一年没有更新;可星数还在往上走(榜单 5,700 → 现在 5,769)。热度不等于维护。 选工具时,看最近一次提交,比看 Stars 更接近真相。
给你两张卡(可保存)
① 项目身份核对卡——四步锁一个项目:
② 运行与放行清单:
最后
回到开头那位读者的困惑。这次“货不对版”,其实不是她看错了,而是一份只给名字和 Stars 的榜单,天然装不下“它到底是谁”这件事。
从第 1 篇的审稿返修,到这一篇的身份辨析,这个系列想交给你的,从来不是“装哪个工具”,而是一套能反复用、不依赖榜单的习惯:名字对得上、Stars 对得上、许可证和更新时间看清楚,接管点握在自己手里——再决定把哪一步交给 AI。
下一个工具来临时,愿你手里已经有这把尺子。
关于核桃学姐
核桃学姐|985 院校医学博士,曾担任核心期刊编辑。
从临床一线到学术研究,从审稿人到 AI 实践者,我深知医护科研的每一个痛点:时间紧、基础弱、资源少。
通过系统学习和实践 AI 工具,我不仅将自己的科研效率提升了 10 倍,也帮助多位医护同行突破了论文发表的瓶颈。
我的使命:让每一位医护工作者都能掌握 AI 这个“科研利器”,把宝贵的时间和精力投入到真正有价值的临床工作和患者照护中。
关注 「你的 AI 科研搭子」,下一期马上就来。