ARTICLE · 1166750
《大厂都在谈安全:5 个开源 AI 红队工具先看为敬》
这周两家大厂一个踩刹车一个踩油门,吵的都是安全。那我们动手的人呢?别光看热闹——安全这事,迟早落到每个人头上:你的 agent 上线前,有没有人试过"骗"它?我把 GitHub 上 5 个 AI 红队/安全评估工具的原页面一个个点开了,star 数、项目描述、README 关键说法全部核验,截图附在每节后面。先说结论:安全评估这事,已经有现成工具链了,不用从零造轮子。
1. promptfoo —— 25,912 star,prompt 和 agent 的"挨打"测试台
项目原话:"Test your prompts, agents, and RAGs. Red teaming/pentesting/vulnerability scanning for AI." 红队、渗透测试、漏洞扫描一条龙,专门冲着 AI 来的。我今天(10-12)还看到它在推代码,2.5 万 star 不是摆设。适合:你的 prompt 或 agent 上线前,先让它自己"挨打"一轮,看看什么提示词能把它骗出墙。
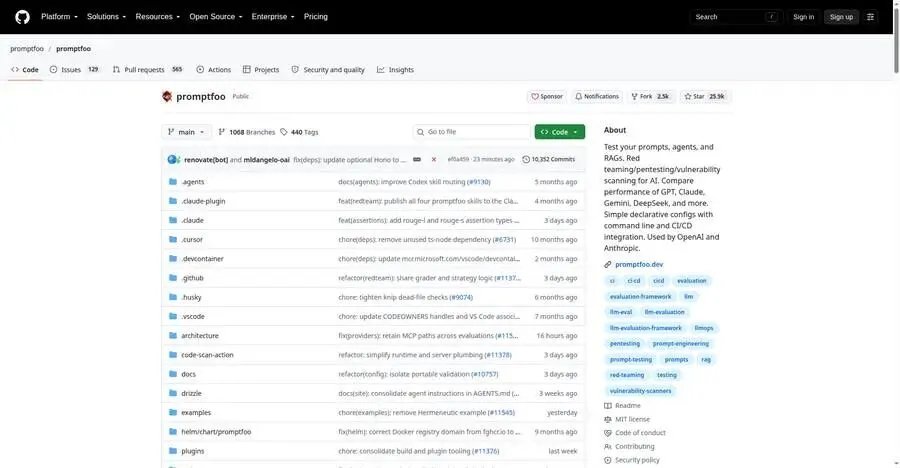
GitHub 原页面实拍:promptfoo/promptfoo(25,912 star,核验于 2026-10-12)
2. DeepEval —— 18,755 star,LLM 评估框架,Apache-2.0 协议
原话:"The LLM Evaluation Framework"。给模型输出打分、做回归测试,CI 里就能跑 eval。10-10 刚有推送,维护活跃。适合:每次换模型、改 prompt,先跑一遍 eval 再上线,别靠肉眼抽查。
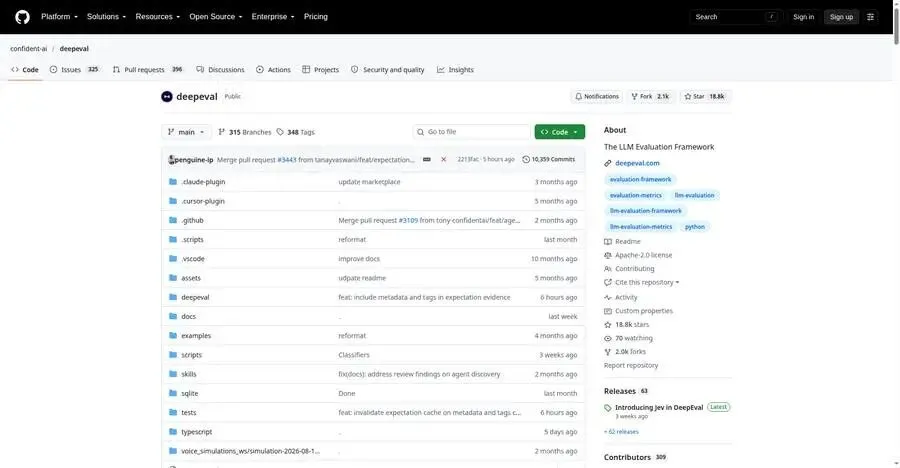
GitHub 原页面实拍:Confident-AI/deepeval(18,755 star,核验于 2026-10-12)
3. Phoenix —— 11,798 star,AI 可观测性 + 评估
原话:"AI Observability & Evaluation"。Arize 出的,trace、找幻觉、抓异常调用,10-12 还在推代码。适合:agent 上线之后的行为审计——用户到底问了什么、模型到底回了什么,全链路留痕。
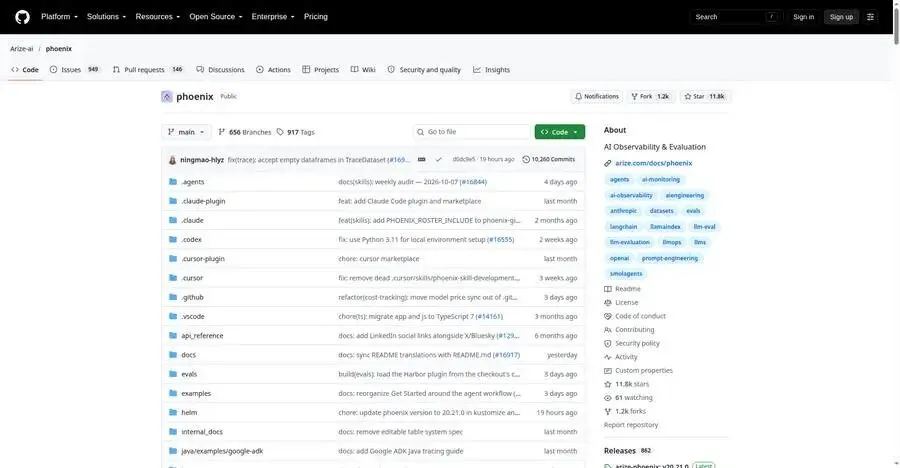
GitHub 原页面实拍:Arize-ai/phoenix(11,798 star,核验于 2026-10-12)
4. Garak —— 9,530 star,英伟达出的 LLM 漏洞扫描器
原话:"the LLM vulnerability scanner"。英伟达官方出品,系统性地扫模型的越狱、提示注入、数据泄露面,10-10 有推送。适合:想对自家模型做一次"体检",看看攻击面到底有多大。
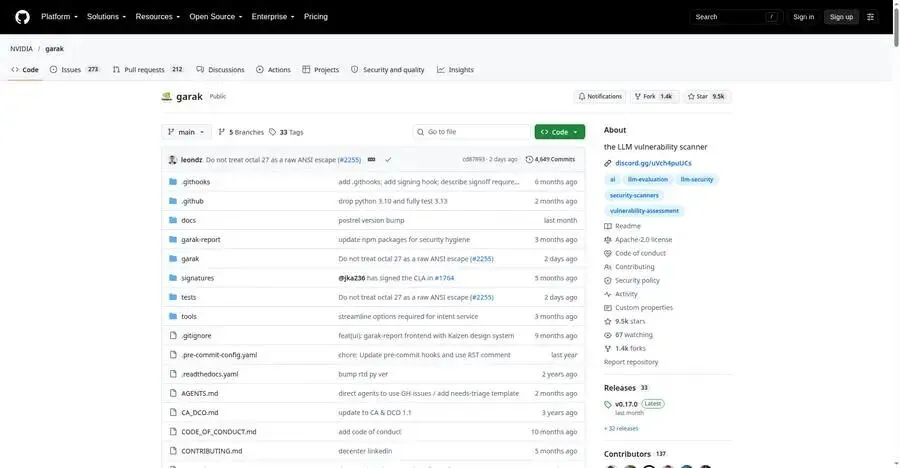
GitHub 原页面实拍:NVIDIA/garak(9,530 star,核验于 2026-10-12)
5. PyRIT —— 4,604 star,微软的 AI 风险识别框架
原话:"The Python Risk Identification Tool for generative AI (PyRIT), open source framework for proactively identifying risks in generative AI systems"。主动找生成式 AI 系统的风险,自动化攻击模拟,10-12 有推送。star 最少,但微软背书,文档扎实。适合:想系统化地做"攻击自己"的团队。
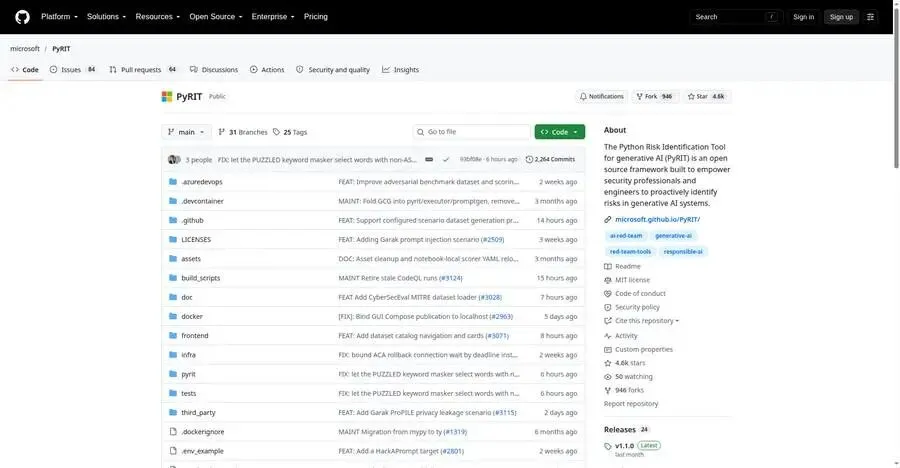
GitHub 原页面实拍:microsoft/pyrit(4,604 star,核验于 2026-10-12)
顺手排个雷:protectai/llm-guard,3,218 star,看着挺像那么回事,但 2026-07-08 已经归档了——别往新项目里引,README 自己都写了归档。一手核验的意义就在这:star 数会骗人,归档状态不会。
你发现没有,这 5 个连起来正好是一条链:上线前红队(promptfoo、PyRIT、Garak)→ 持续评估(DeepEval)→ 线上观测(Phoenix)。我的建议:这周挑一个跟你现状最贴的,跑一遍你自己的 agent——被自己的工具"打"一顿,比被客户打一顿便宜得多。
注:star 数、项目描述、README 关键说法与归档状态均核验于 GitHub 原页面(api.github.com 一手,2026-10-12),截图为原页面实拍,本文发出时数据可能已有变化,仅供参考。
📬 关注「Ai践行技术派」,每天早上 8 点,三篇 AI 工程实战:热点拆解、工具盘点、观点方法论。不聊概念,只聊动手。
💬 你们 agent 上线前做红队测试吗?用的什么工具?留言区分享下。